Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of de directory te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen de mappen te wijzigen.
Azure NetApp Files
Microsoft Fabric
Azure AI Zoeken
Microsoft Foundry
Azure Machine Learning
Oplossingsideeën
In dit artikel wordt een oplossingsidee beschreven. Uw cloudarchitect kan deze richtlijnen gebruiken om de belangrijkste onderdelen te visualiseren voor een typische implementatie van deze architectuur. Gebruik dit artikel als uitgangspunt om een goed ontworpen oplossing te ontwerpen die overeenkomt met de specifieke vereisten van uw workload.
In dit oplossingsidee wordt beschreven hoe de Azure NetApp Files Object REST API organisaties helpt bij het gebruik van bestaande ondernemingsbestandsgegevens voor analyse en AI zonder deze eerst naar een afzonderlijk objectarchief te kopiëren. Amazon S3-compatibele toepassingen kunnen documentzoekopdrachten en ai-ondersteunde analyses ondersteunen, terwijl bestaande NFS- en SMB-werkstromen die gegevens blijven benaderen. Door een aparte kopie van de brongegevens te vermijden, kunt u de tijd verkorten die nodig is om analyseworkloads in gebruik te nemen, dubbele opslagkosten verlagen en de synchronisatiepijplijnen wegnemen die teams anders zouden bouwen, bewaken en oplossen. Minder brongegevensopslagplaatsen betekenen ook minder kopieën om te beheren en te beveiligen. Deze benadering biedt ondersteuning voor incrementele modernisering zonder dat organisaties hun bestaande op bestanden gebaseerde toepassingen hoeven te vervangen.
Architecture
Deze architectuur is gericht op Microsoft Fabric integratie met Azure NetApp Files via de Object REST API. In het diagram wordt ook Azure Databricks weergegeven als een alternatieve consument van analysedata van dezelfde Azure NetApp Files-gegevens. U hoeft beide platforms niet te implementeren. Bestaande toepassingen blijven de gegevens benaderen via NFS of SMB, afhankelijk van de volumeconfiguratie en de vereisten van de client.
Azure Databricks-compute heeft toegang tot het Azure NetApp Files Object REST API-eindpunt via S3-compatibele aanvragen met behulp van de Hadoop S3A-connector. Dit alternatieve analysepad maakt geen gebruik van de on-premises gegevensgateway of Microsoft OneLake.
De achterliggende AI-diensten in het diagram dienen ter illustratie. Hun ingestie-integratie wordt niet weergegeven.
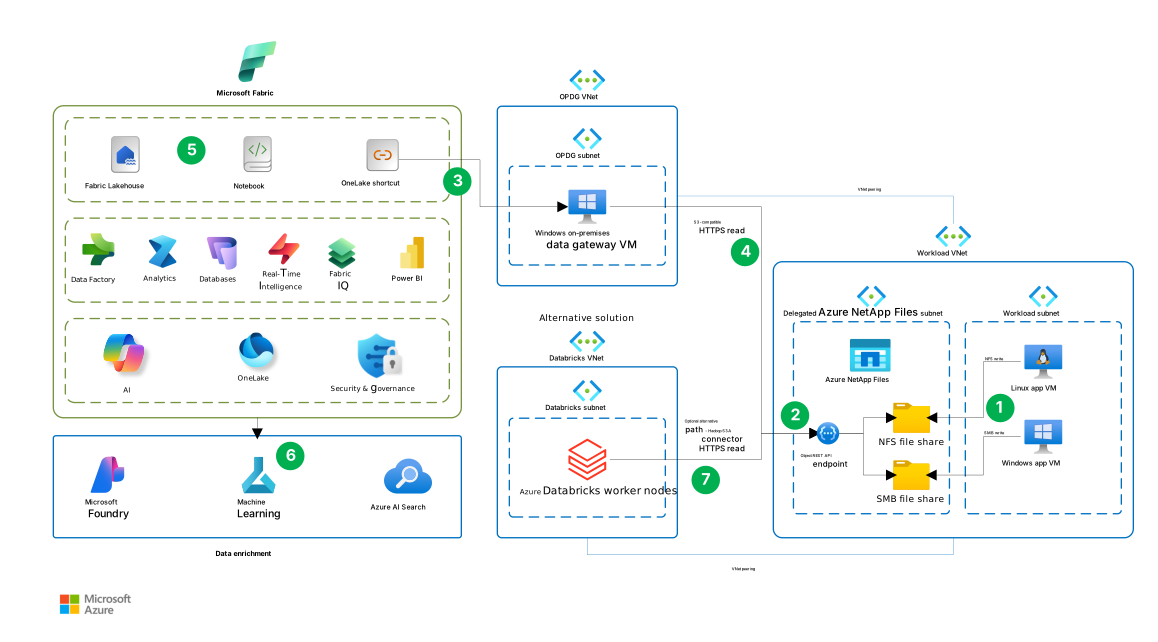
Een Visio-bestand van deze architectuur downloaden.
Gegevensstroom
In de volgende genummerde interacties wordt het architectuurdiagram beschreven. Stap 1 tot en met 5 beschrijven het primaire Microsoft Fabric-pad. Stap 6 is optionele downstreamgegevensverrijking. Stap 7 is een alternatief analysepad, niet een vervolg van de Fabric stroom. De pijlen met het label HTTPS read tonen aanvragen voor het eindpunt van de Object REST API; de aangevraagde gegevens worden geretourneerd aan de consument.
Toepassingen schrijven bestandsgegevens. In het subnet Workload schrijft de virtuele Linux-toepassing naar de NFS-bestandsshare en schrijft de Windows toepassings-VM naar de SMB-bestandsshare. Azure NetApp Files host beide shares in het gedelegeerde subnet.
Met de OBJECT REST API worden de bestandsgegevens beschikbaar gesteld. Het eindpunt in het gedelegeerde ANF-subnet biedt S3-compatibele toegang tot geconfigureerde mappen op de Azure NetApp Files volumes. De verbindingen van het eindpunt naar de NFS- en SMB-shares vertegenwoordigen de toegang tot de bestaande gegevens, niet een kopie in een afzonderlijk objectarchief.
Fabric heeft via een OneLake-snelkoppeling toegang tot de gegevens. De snelkoppeling verwijst naar de Azure NetApp Files gegevens via een verbinding die gebruikmaakt van de Windows on-premises gegevensgateway-VM in het OPDG-subnet (on-premises gegevensgateway). De OneLake-snelkoppeling is verbonden met deze gateway.
De gateway leest uit de Object REST API. De gateway gebruikt de peering tussen het OPDG-VNet en het workload-VNet om het eindpunt te bereiken. Het S3-compatibele HTTPS-leespad verbindt de gateway met het eindpunt, dat de bestandsgegevens waarnaar wordt verwezen benadert voor Fabric. Zie OneLake verbinden met een Azure NetApp Files volume voor de verbindingsvereisten.
Fabric verwerkt en analyseert de gegevens. Ondersteunde Fabric-werkbelastingen gebruiken de gegevens via de snelkoppeling. Notebooks lezen bijvoorbeeld de bestanden waarnaar wordt verwezen en schrijven afgeleide resultaten naar Lakehouse-tabellen voor analyse en Power BI rapportage. In het vak Fabric in het diagram ziet u deze verwerkings- en analysemogelijkheden.
Optionele downstreamservices verrijken de gegevens. De pijl onder Fabric leidt naar de groep Gegevensverrijking, die Microsoft Foundry, Azure Machine Learning en Azure AI Zoeken bevat. Deze stap is optionele verdere verwerking. In het diagram wordt niet de gegevensinname of orkestratie weergegeven die nodig is om deze services te verbinden. De OneLake-snelkoppeling brengt deze integraties niet tot stand.
Als alternatief leest Azure Databricks de bestandsgegevens rechtstreeks. Werkknooppunten in het Databricks-subnet gebruiken de Hadoop S3A-connector om HTTPS-leesaanvragen naar hetzelfde Object REST API-eindpunt te verzenden via de gekoppelde virtuele netwerken. Dit pad vervangt het Fabric toegangs- en verwerkingspad in stap 3 tot en met 5. Het gaat niet via de on-premises gegevensgateway of OneLake.
Kies de locatie van de snelkoppeling op basis van hoe u de gegevens wilt benaderen:
- Bestaande compatibele Delta-tabellen. Maak een snelkoppeling naar een tabel in de sectie Tabellen van Lakehouse, gericht op de volledige Delta-tabel, inclusief het transactielogboek. Fabric herkent de doelbron als een tabel die u kunt opvragen via Spark en het SQL-analyse-eindpunt, terwijl de brongegevens op Azure NetApp Files blijven staan.
- Bestanden voor directe toegang of verwerking. Maak snelkoppelingen in de sectie Bestanden van het lakehouse. Compatibele workloads kunnen losse Parquet-, CSV- en JSON-bestanden lezen, naast documenten, zonder de bronbestanden eerst naar OneLake te kopiëren. Wanneer downstreamanalyse lakehouse-tabellen vereist, transformeren of laadt u de brongegevens in afgeleide Delta-tabellen in OneLake.
Zelfstandige Parquet-bestanden zijn niet automatisch Delta-tabellen. Een snelkoppeling in Bestanden zorgt er niet automatisch voor dat het doel als een tabel wordt geregistreerd. Zie voor meer informatie Waar u snelkoppelingen in een lakehouse kunt plaatsen.
Components
De volgende onderdelen ondersteunen de Fabric gerichte architectuur en het optionele Azure Databricks alternatief.
Azure NetApp Files is een volledig beheerde bestandsopslagservice die is gebouwd op NetApp-technologie. In deze architectuur wordt de bedrijfsdataset opgeslagen en wordt NFS-, SMB- en S3-compatibele objecttoegang geboden via de Object REST API. Het biedt ook snapshot- en replicatiemogelijkheden.
Azure NetApp Files Object REST API maakt bestaande bestandsgegevens beschikbaar via een S3-compatibele interface. In deze architectuur maakt dit het mogelijk voor compatibele analyse- en AI-toepassingen om toegang te krijgen tot de gegevens zonder eerst een aparte kopie in objectopslag te maken. De interface ondersteunt een beperkt aantal Amazon S3-bewerkingen. Controleer of de ondersteunde bewerkingen voldoen aan de vereisten van uw toepassing voordat u deze integratie kiest.
Microsoft Fabric is een analyseplatform waarmee gegevensverplaatsing, gegevensverwerking, gegevensinname, transformatie, stroomverwerking via Real-Time Intelligence en rapportbouw wordt gecombineerd. In deze architectuur biedt het het analyseplatform voor het verwerken en analyseren van gegevens uit Azure NetApp Files via OneLake-snelkoppelingen.
OneLake is het uniforme logische datameer voor Fabric. In deze architectuur maken OneLake-snelkoppelingen de gegevens in Azure NetApp Files waarnaar wordt verwezen beschikbaar voor ondersteunde Fabric-workloads.
Azure Virtual Network biedt privéconnectiviteit tussen de Azure resources in deze architectuur. Met peering tussen virtuele netwerken kunnen de gateway-virtuele machine en optionele Azure Databricks-rekenresources het API-eindpunt van de Azure NetApp Files Object REST API bereiken.
Een lokale gegevensgateway verbindt OneLake-snelkoppelingen met het Azure NetApp Files-bucket-eindpunt. Ondanks de naam wordt de gateway in deze architectuur uitgevoerd in de standaardmodus op een Azure virtuele machine met een ondersteund Windows besturingssysteem. Kies een installatiekopie die voldoet aan de vereisten voor de installatie van de gateway. Server Core-installaties en Windows-containers worden niet ondersteund. De gateway initieert uitgaande verbindingen via Azure Relay om te communiceren met Fabric. Er zijn geen binnenkomende verbindingen van Fabric vereist. Configureer uw firewall of proxy om de uitgaande eindpunten toe te staan die worden beschreven in Communicatie-instellingen aanpassen voor de on-premises gegevensgateway.
Azure Databricks is een optioneel alternatief analyseplatform voor data engineering- en machine learning-workloads. De Spark-taken maken gebruik van de Hadoop S3A-connector die is geconfigureerd voor het Object REST API-eindpunt voor toegang tot de Azure NetApp Files gegevensset in plaats van het Fabric integratiepad te gebruiken.
Alternatives
Deze architectuur bevat meerdere onderdelen die u kunt vervangen door andere Azure-services of -benaderingen, afhankelijk van de functionele en niet-functionele vereisten van uw workload. Bekijk de volgende alternatieven en hun compromissen.
Storage
Houd rekening met de protocolvereisten en de gemeten prestaties van de toepassingen wanneer u kiest tussen Azure Blob Storage en Azure NetApp Files:
Kies Blob Storage als cliënten de Blob Storage REST API of NFS 3.0 kunnen gebruiken en geen SMB of NFS 4.1 nodig hebben. Beide interfaces hebben toegang tot dezelfde gegevens. Het Blob Storage-NFS 3.0-toegangspad is geoptimaliseerd voor leesintensieve, sequentiële workloads met hoge doorvoer, waarbij doorvoer belangrijker is dan een lage latentie.
Kies Azure NetApp Files wanneer toepassingen en analyseworkloads toegang moeten hebben tot dezelfde bestanden via SMB of NFS 4.1 en de S3-compatibele Object REST API, of wanneer bestandstoepassingen willekeurige I/O met lage latentie vereisen. Voor gegevens die al op Azure NetApp Files staan, voegt de Object REST API analytische toegang toe zonder brontoepassingen of -gegevens te migreren.
Voor beide opties meet u end-to-end latentie en doorvoer onder gelijktijdige belasting van de brontoepassing en analyticsbelasting. NFS- of SMB-prestaties zijn geen maatstaf voor de prestaties van Object REST API of Fabric, dus test het beoogde toegangspad aan de hand van de vereisten van de workload. Vergelijk de totale kosten, inclusief wijzigingen in toepassingen, migratie en eventuele lopende duplicatie en synchronisatie. Zie Azure-opslagservices vergelijken voor een vergelijking van protocollen en werkbelastingen.
Integration
Azure Databricks taken kunnen de Hadoop S3A-connector gebruiken om Azure NetApp Files gegevens te lezen via de Object REST API, zonder OneLake of de on-premises gegevensgateway. Configureer tls-vertrouwensrelatie en veilig opgeslagen referenties en valideer vereiste schrijfbewerkingen voordat u op write-back vertrouwt. Als u initialisatiescripts nodig hebt, gebruikt u clustergebonden scripts die zijn opgeslagen in Unity Catalog-volumes op ondersteunde rekenresources, conform de huidige Azure Databricks richtlijnen voor init-scripts.
Scenariodetails
Gebruik dit patroon wanneer dezelfde gegevensset toepassingen moet ondersteunen die een gekoppeld bestandssysteem verwachten en analyse- of AI-services die een S3-compatibele objectinterface verwachten.
Toepassingen die worden uitgevoerd op virtuele machines of in containers, kunnen Azure NetApp Files blijven gebruiken via NFS of SMB. Ze kunnen bijvoorbeeld bestaande code voor bestandstoegang, gekoppelde shares en mapstructuren gebruiken. Met de Azure NetApp Files Object REST API wordt de hoofdmap of een submap van een volume gekoppeld aan een S3-compatibele bucket, zodat compatibele object-clients toegang hebben tot dezelfde onderliggende bestanden.
Deze benadering is handig als u analyse- of AI-mogelijkheden wilt toevoegen aan bestaande op bestanden gebaseerde workloads zonder dat u de brontoepassingen hoeft te wijzigen voor het gebruik van objectopslag. Downstreamwerkstromen kunnen nog steeds afgeleide gegevens maken, zoals getransformeerde gegevenssets, indexen, insluitingen en caches, indien nodig.
Wanneer bestandsclients en objectclients dezelfde gegevens openen, moet u rekening houden met verschillen in identiteit, machtigingen, vergrendeling en vereisten voor toepassingsconsistentie. Definieer hoe producenten aangeven dat een bestand of batch is voltooid voordat objectgebruikers dit verwerken. Producenten moeten klaar zijn met schrijven en de bestanden sluiten voordat ze aangeven dat ze gereed zijn, en deze bestanden ongewijzigd laten terwijl consumenten ze verwerken. Test deze handoff voor onderbroken schrijf- en verwerkingsbewerkingen.
De identiteits- en autorisatiemodellen verschillen ook tussen toegangsmethoden. Oorspronkelijke bestandsmachtigingen per gebruiker worden niet automatisch overgenomen in Fabric. Configureer de Fabric-machtigingen voor de beoogde afnemers en zorg ervoor dat de identiteit die door de Object REST API wordt gebruikt alleen toegang heeft tot de vereiste brongegevens. Zie Securityvoor meer informatie.
Wijs directory's toe aan afzonderlijke buckets wanneer gebruikers verschillende toegangsniveaus nodig hebben. Gegevensclassificatie, bewaartermijnen, autorisatie in downstreamprocessen en beheer van afgeleide gegevens blijven de verantwoordelijkheid van de workload. Zie Een bucket maken voor meer informatie.
Potentiële gebruikscases
Deze architectuur is geschikt voor workloads die gestructureerde of ongestructureerde gegevens moeten analyseren die al zijn opgeslagen in Azure NetApp Files. De volgende voorbeelden laten zien op welke verschillende manieren Fabric die gegevens kan gebruiken.
Documentverwerking
Toepassingen kunnen documenten, afbeeldingen of andere ongestructureerde bestanden opslaan op Azure NetApp Files met behulp van NFS of SMB. Een Fabric-notebook kan voltooide bestanden uitlezen met behulp van een OneLake-snelkoppeling en hun inhoud naar een documentverwerkingsservice, zoals Azure Document Intelligence, sturen om er gegevens uit te extraheren. Sla de resulterende gestructureerde gegevens op in Lakehouse-tabellen voor validatie, analyse en rapportage.
Zie Document Intelligence-integratie via SynapseML voor hulp bij integratie.
Gegevensanalyse
Toepassingen kunnen gestructureerde gegevens, zoals CSV- of Parquet-bestanden, schrijven naar een Azure NetApp Files share. Fabric-notebooks kunnen voltooide bestanden lezen met behulp van de OneLake-snelkoppeling, deze combineren met andere lakehouse-gegevens en afgeleide resultaten wegschrijven naar lakehouse-tabellen.
Dit patroon kan ondersteuning bieden voor scenario's zoals engineering en kwaliteitsanalyse, sensorgegevensanalyse en operationele rapportage zonder dat de brontoepassingen hoeven te wijzigen hoe ze hun bestanden opslaan.
Maak voor bestaande compatibele Delta-datasets een OneLake-snelkoppeling in de sectie Tabellen van het lakehouse die verwijst naar de volledige Delta-tabel, inclusief het transactielogboek. Fabric kan vervolgens het doel als een tabel herkennen en de brongegevens kunnen op Azure NetApp Files blijven staan. Zie Waar u snelkoppelingen in een lakehouse kunt plaatsen voor meer informatie.
AI-zoeken en -opvraging
Documenten die zijn opgeslagen op Azure NetApp Files kunnen ook fungeren als broninhoud voor AI-workloads. Een verwerkingsworkflow kan bijvoorbeeld documenten lezen via de OneLake-snelkoppeling en deze gebruiken om een Azure AI Zoeken-index te maken voor retrieval-augmented generation (RAG).
De zoekindex en eventuele embeddings zijn afgeleide gegevens en worden afzonderlijk van de bronbestanden opgeslagen. Ontwerp de werkstroom om geïndexeerde inhoud gesynchroniseerd te houden met bronupdates, naamswijzigingen en verwijderingen. Dwing ook de juiste toegangscontroles af bij het ophalen van geïndexeerde inhoud, omdat de oorspronkelijke SMB- en NFS-machtigingen niet automatisch worden omgezet in zoekmachtigingen per gebruiker.
Hetzelfde patroon kan worden uitgebreid naar andere AI-workloads. Fabric notebooks kunnen bijvoorbeeld gegevenssets uit bronbestanden voorbereiden en de voorbereide gegevens opslaan in OneLake voor gebruik door Azure Machine Learning. Zie OneLake integreren met Azure Machine Learning voor integratieopties en -beperkingen.
Considerations
Met deze overwegingen worden de pijlers van het Azure Well-Architected Framework geïmplementeerd. Dit is een set richtlijnen die u kunt gebruiken om de kwaliteit van een workload te verbeteren. Zie Well-Architected Framework voor meer informatie. Raadpleeg Well-Architected Framework-aanbevelingen voor Azure NetApp Files voor verdere richtlijnen.
Reliability
Betrouwbaarheid zorgt ervoor dat uw toepassing kan voldoen aan de toezeggingen die u aan uw klanten hebt gedaan. Zie Ontwerp controlelijst voor betrouwbaarheid voor meer informatie.
Azure NetApp Files draait op een fouttolerante bare-metal infrastructuur aangedreven door ONTAP en biedt een SLA met hoge beschikbaarheid. Voor extra beveiliging tegen beschikbaarheidszone- of regionale storingen kunt u eventueel replicatie tussen zones of regio's configureren. Deze replicatie is asynchroon en vereist een door de klant geïnitieerde failover naar het doelvolume. Kies de replicatieoptie en plan volgens de hersteldoelstellingen van uw workload. Zie Azure NetApp Files betrouwbaarheid voor meer informatie.
Als u één gegevensset deelt, is de beschikbaarheid van opslag ook een gemeenschappelijke afhankelijkheid voor bestandstoepassingen en analyses. Deze opslagmogelijkheden bieden geen end-to-end beschikbaarheid voor de gateway, de indexeringspijplijn of toepassingen die hiervan gebruikmaken. Hersteldoelstellingen afstemmen op de volledige workload, inclusief de gateway, downstreamverwerking en afgeleide gegevens.
Een virtuele machine met één gateway is een single point of failure voor het Fabric-integratiepad. Voor bedrijfskritieke workloads implementeert u ten minste twee gatewayleden op afzonderlijke virtuele machines in een gatewaycluster. Zorg ervoor dat elk lid het eindpunt van de Object REST API kan bereiken en de vereiste uitgaande verbindingen tot stand kan brengen. Test het gedrag van de workload wanneer een gatewaylid niet meer beschikbaar is.
- Bestands- en volumeherstel wordt ondersteund via ruimte-efficiënte momentopnamen van een bepaald tijdstip. Teams kunnen een afzonderlijk bestand herstellen, een volledig volume terugzetten of een nieuw volume maken vanaf een herstelpunt na onbedoelde verwijdering, beschadiging of een mislukt analyseproces. Zie Azure NetApp Files gegevensbeveiliging op basis van momentopnamen voor de beschikbare herstelbewerkingen.
Security
Beveiliging biedt garanties tegen opzettelijke aanvallen en misbruik van uw waardevolle gegevens en systemen. Zie Ontwerpcontrolelijst voor beveiliging voor meer informatie.
Het onderhouden van minder brongegevenskopieën kan het aantal opslagplaatsen verminderen dat moet worden beveiligd. Azure NetApp Files versleutelt data-at-rest en de Object REST API maakt gebruik van TLS om gegevens in transit te beveiligen. Machtigingen voor bestandstoegang zijn afhankelijk van het protocol:
SMB- en NFS-clients blijven hun bestaande verificatie- en autorisatiemodellen gebruiken. Bestaande NTFS-toegangsbeheerlijsten (ACL's), NFS-machtigingen en regels voor identiteitstoewijzing blijven van kracht voor deze clients.
Object REST API-clients authenticeren zich met behulp van een S3-toegangssleutel. Bucketmachtigingen bepalen of de client alleen-leestoegang of lees- en schrijftoegang heeft binnen de toegewezen map. Objectaanvragen bevatten niet de identiteit van de afzonderlijke SMB-, NFS- of downstreamgebruiker. Azure NetApp Files voert elke objectbewerking uit als de geconfigureerde geïmpersoneerde bestandssysteemidentiteit van de bucket. Bestaande bestandsmachtigingen en ACL's worden alleen geëvalueerd op basis van die identiteit.
De nagebootste bestandssysteemidentiteit is een gebruikers-ID (UID) en groeps-ID (GID) voor NFS-volumes, of een gebruikersaccount voor SMB-volumes. Dual-protocolvolumes gebruiken het identiteitstype dat overeenkomt met hun geconfigureerde beveiligingsstijl. Deze identiteit bepaalt machtigingen voor bestandstoegang. De S3-toegangssleutel authenticeert de objectclient. Zie Object REST API-beveiliging en -machtigingen voor meer informatie.
Een OneLake S3-compatibele snelkoppeling verifieert zich bij de bucket met behulp van een toegangssleutel-id en een geheime toegangssleutel. Bron-NTFS-ACL's, NFS-machtigingen en afzonderlijke identiteiten van bestandseigenaars worden niet gekopieerd of toegewezen aan OneLake. Fabric gebruikers worden geautoriseerd via OneLake en Fabric machtigingen. Ze hebben alleen toegang tot de inhoud die via de snelkoppeling toegankelijk is via de bucket en de nagebootste identiteit, maar OneLake dwingt de oorspronkelijke bestandsmachtigingen per gebruiker niet af. Op Microsoft Entra gebaseerde OAuth, service-principals en RoleArn worden niet ondersteund voor dit type snelkoppeling.
Een gebruiker van Fabric kan bijvoorbeeld een document via de snelkoppeling lezen, zelfs als het persoonlijke SMB-account van die gebruiker het niet rechtstreeks kan lezen, als de Fabric-machtigingen toegang verlenen en de geïmpersoneerde identiteit van de bucket het document kan lezen. Controleer voordat u een map toegankelijk maakt of de beoogde doelgroep binnen Fabric toegang mag hebben tot de inhoud ervan.
Configureer de nagebootste identiteit van de bucket met alleen de bronmachtigingen die de workload nodig heeft. Beperk de toegang tot de snelkoppeling en het lakehouse. Gebruik de Azure Key Vault-gebaseerde certificaatwerkstroom en opslag van aanmeldingsgegevens om TLS-certificaten en S3-toegangssleutels te beheren. Definieer en test een rotatieprocedure die certificaat- en wijzigingen in inloggegevens coördineert met updates voor Fabric-verbindingen en andere consumenten. Het genereren van nieuwe bucketreferenties maakt het bestaande paar onmiddellijk ongeldig, dus houd rekening met een onderbreking terwijl u afnemers bijwerkt en controleer de toegang na de rotatie.
Als u een zelfondertekend TLS-certificaat gebruikt, moet u ervoor zorgen dat elke gateway-host dit vertrouwt. Zie Vereisten voor de OneLake-gateway voor meer informatie.
Beveiliging en naleving zijn afhankelijk van de configuratie van opslag-, toegangs- en downstreamservices. Neem downstreamverwerking en afgeleide gegevens op in uw governance- en nalevingsbereik. Vereisten zoals AVG en HIPAA gelden, indien van toepassing, voor de volledige werklast. Zie Object REST API-beveiliging en -machtigingen en een met Amazon S3 compatibele snelkoppeling maken in OneLake voor meer informatie.
Kostenoptimalisatie
Kostenoptimalisatie richt zich op manieren om onnodige uitgaven te verminderen en operationele efficiëntie te verbeteren. Zie controlelijst ontwerpbeoordeling voor kostenoptimalisatievoor meer informatie.
Het vermijden van een afzonderlijke brongegevenskopie kan dubbele opslag- en synchronisatiekosten verminderen. U kunt deze besparingen afwegen tegen Azure NetApp Files capaciteits- en prestatiekosten, gateway-rekenkracht, Fabric capaciteit en downstreamverwerking en -opslag.
Deze voorbeeld prijsraming omvat een 1 TiB Azure NetApp Files Standard-capaciteitspool, een Windows D8s_v5 virtuele machine voor de on-premises gegevensgateway, twee 128-GiB P10 beheerde schijven, een NAT-gateway met een openbaar IP-adres en uitgaande gegevensverwerking, Fabric F2-capaciteit en 100 GB systeemeigen OneLake-opslag.
De configuratie van één gateway is niet hoog beschikbaar. Optionele AI Search, embeddingservices en Azure Databricks-kosten worden uitgesloten. Pas de resources aan op de capaciteits-, netwerk- en beschikbaarheidsvereisten van uw workload.
Koele toegang: Verplaats inactieve gegevensblokken, inclusief snapshotgegevens, naar goedkopere opslag met behoud van bestands- en objecttoegang. Evalueer de opvraagkosten, latentie en serviceniveauspecifieke wijzigingen in de doorvoer op basis van het toegangspatroon van de workload.
Serviceniveaus en de juiste grootte: Kies een Azure NetApp Files serviceniveau dat overeenkomt met de capaciteits- en doorvoervereisten van de gegevensset. Met het Flexible serviceniveau kunt u de poolcapaciteit en doorvoer onafhankelijk toewijzen. Controleer de capaciteit en doorvoersnelheid van de factureerbare pool naarmate de vraag verandert om aanhoudende overprovisionering te voorkomen.
Operationele uitmuntendheid
Operational Excellence behandelt de operationele processen die een toepassing implementeren en deze in productie houden. Voor meer informatie, zie Controlelijst voor ontwerpevaluatie voor Operational Excellence.
OneLake-snelkoppelingen verminderen de operationele complexiteit door een pijplijn te vermijden die een afzonderlijke kopie van brongegevens voor analyse onderhoudt. Zonder een afzonderlijke kopieerpijplijn hoeven teams geen kopieertaken te plannen, te herstellen van overdrachtsfouten of bron- en gekopieerde gegevens af te stemmen als onderdeel van routinebewerkingen.
Teams voor bronapplicaties en analyse moeten wijzigingen en reactie op incidenten coördineren voor de gedeelde Azure NetApp Files-gegevensset. Bepaal het eigendom voor bewaking, verwerkingsfouten en Object REST API-referentie- en certificaatbeheer.
Bewaak opslag, gateway en Fabric prestaties om beperkingen te identificeren en capaciteit of doorvoer aan te passen:
Gebruik Azure Monitor om lees- en schrijfdoorvoer van volumes, lees- en schrijf-IOPS, andere IOPS, gemiddelde lees- en schrijflatentie, capaciteitsverbruik en de indicator dat de doorvoerlimiet is bereikt bij te houden. Waarschuwing over aanhoudende latentieverhogingen, herhaalde QoS-beperkingen en capaciteitsdrempels in plaats van geïsoleerde pieken; Azure NetApp Files metrische gegevens worden geaggregeerd met intervallen en opslaglatentie omvat niet alle client-side REST-componenten.
Correleert metrische opslaggegevens met metingen aan de clientzijde, zoals percentielen voor aanvraaglatentie, objectgrootte, gelijktijdigheid, nieuwe pogingen, HTTP-statuscodes, CPU, geheugen en netwerkdoorvoer. Hierdoor wordt een limiet voor volumedoorvoer onderscheiden van een te klein gedimensioneerde rekenclient, inefficiënte SDK-instellingen, overhead van kleine objecten of netwerkafstand.
Bewaak de CPU, het geheugen, de beschikbare schijfruimte en de netwerkdoorvoer van elke virtuele gatewaymachine naast gatewayfouten en voltooiingstijden van de werkbelasting. Configureer waarschuwingen voor langdurige resourcedruk en lage schijfruimte met behulp van drempelwaarden die zijn vastgesteld tijdens representatieve workloadtests. Gebruik diagnostische logboeken voor gateways bij het oplossen van fouten of trage toegang. Bewaak de virtuele machine en het netwerk afzonderlijk omdat de diagnostische gegevens van de gateway geen volledige infrastructuurdekking bieden.
Bewaak Fabric capaciteitsgebruik en beperking met de app Fabric Capacity Metrics. Configureer meldingen over capaciteitsgebruik voor de verantwoordelijke beheerders. Correlleer capaciteitsgebruik met gateway- en opslagmetingen om te bepalen of vertragingen afkomstig zijn van brontoegang of Fabric-verwerking voordat de capaciteit wordt gewijzigd.
Prestatie-efficiëntie
Prestatie-efficiëntie verwijst naar de mogelijkheid van uw workload om efficiënt te voldoen aan de behoeften van de gebruiker. Zie controlelijst ontwerpbeoordeling voor prestatie-efficiëntievoor meer informatie.
Azure NetApp Files kan zowel latentiegevoelige NFS- als SMB-toepassingen en S3-compatibele analyses of AI-consumenten ondersteunen met behulp van dezelfde gegevensset. Door de brongegevens op één volume te bewaren, kan de kopieerfase worden verwijderd die het indexeren, trainen of batchverwerking zou vertragen en client-, netwerk- en doelopslagbandbreedte zou verbruiken.
De opslaglatentie van minder dan een milliseconde op ondersteunde Azure NetApp Files-serviceniveaus is het meest direct relevant voor NFS- en SMB-workloads. Het garandeert geen end-to-end latentie voor HTTPS Object REST API-aanvragen. Benchmark het S3-compatibele toegangspad met representatieve objecten en gelijktijdigheid voordat u een latentiedoelstelling instelt.
Opslagdimensionering: Dimensioneer de doorvoer voor de gecombineerde vraag van bestandstoepassingen en objectgebruikers. Automatische QoS koppelt volumedoorvoer aan volumequotum. Met handmatige QoS zijn afzonderlijke toewijzingen mogelijk binnen het doorvoerbudget van de pool. Benchmark representatieve workloads voordat u de prestaties aanpast.
Dimensionering van de gateway: Dimensioneer de virtuele gatewaymachines op basis van de gezamenlijke belasting van workloads die via OneLake-snelkoppelingen toegang hebben tot Azure NetApp Files. Gebruik richtlijnen voor de dimensionering en schaling van gateways als uitgangspunt. Valideer de grootte met representatieve gegevensvolumes en gelijktijdige toegang via de sneltoetsen. Meet de CPU, het geheugen en de netwerkdoorvoer van de gateway samen met de voltooiingstijden van workloads om te bepalen of u de resources voor de virtuele machine moet uitbreiden of gatewayleden moet toevoegen.
Fabric-capaciteit dimensioneren: Dimensioneer de Fabric-capaciteit voor de gecombineerde verwerkings- en rapportageworkload, inclusief Power BI. Volg de richtlijnen in de handleiding Fabric capaciteitsplanning om de initiële capaciteit te schatten, te testen met een representatieve testfase en capaciteit aan te passen op basis van gemeten gebruik en beperking.
Plaats rekenkracht dicht bij het volume, dimensioneer het clientnetwerk op de juiste manier en test met de echte workload. Verhoog parallelle uitvoering en gebruik voldoende grote verzoeken voor sequentiële analyses, maar beperk gelijktijdigheid wanneer latentie of fouten toenemen. Voor NFS of SMB controleert u de koppelings-, protocol- en toepassingsinstellingen. Controleer voor REST of de client de vereiste API-bewerkingen ondersteunt en test het hergebruik van verbindingen, uploadgedrag, opnieuw proberen en het weergeven van objecten.
Valideer end-to-end doorvoer en latentie onder gelijktijdige belasting en breng de analysevraag in balans met de prestatievereisten van de brontoepassing.
Contributors
Microsoft onderhoudt dit artikel. De volgende inzenders hebben dit artikel geschreven.
Hoofdauteurs:
- Dan Jackson | Cloud Solutions Architect, NetApp
- Anthony Mashford | Cloud Solutions Architect, NetApp
- Daniel Söderholm | Senior Solution Engineer, Cloud + AI Platforms, Microsoft
Andere Inzenders:
- Heather Grandy | Senior oplossingsengineer, Dataplatforms, Microsoft
Als u niet-openbare LinkedIn-profielen wilt zien, meldt u zich aan bij LinkedIn.
Volgende stappen
- Inleiding tot de Object-REST API voor Azure NetApp Files
- OneLake verbinden met een Azure NetApp Files volume
- Init-scripts in Azure Databricks
- OneLake integreren met Azure Machine Learning