Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of de directory te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen de mappen te wijzigen.
Important
Deze functie bevindt zich in de bètaversie.
Managed agent-sessies geven je agents een duurzame, framework-onafhankelijke opslag voor sessiestatus: de status die een agent of framework voor één interactie behoudt. Meestal is dit de gespreksgeschiedenis, de geordende transcriptie van berichten, tool-calls en resultaten die een agent aan het begin van een beurt leest en eraan toevoegt terwijl deze loopt. Het kan ook elke andere toestand zijn die een framework voor de interactie bewaart, zoals een LangGraph-graaf. Azure Databricks slaat het op in Lakebase en beheert de opslag voor je, dus je bouwt of bedient de database niet.
Note
Tijdens de preview word je gefactureerd voor de onderliggende Lakebase-instantie die je sessies opslaat. Er zijn geen extra kosten van toepassing op de managed agent sessies zelf. De prijzen kunnen veranderen naarmate de preview vordert.
Gebruik beheerde sessies wanneer je wilt:
- Houd de gespreksgeschiedenis van een agent in stand zodat deze herstarts overleeft en later kan worden hervat.
- Reconstrueer de volledige context (inclusief toolcalls en redenering) bij een vervolgbericht.
- Bekijk, hervat en splits eerdere gesprekken af in je eigen gebruikersinterface.
Beheerde sessies houden de status van één interactie vast (kortetermijn, in-sessie toestand). Voor duurzaam, langetermijngeheugen dat gedurende gesprekken blijft bestaan, gebruik managed agent memory.
Requirements
- Installeer Python 3.10 of hoger, om de AgentKit SDK te gebruiken. AgentKit SDK is de Databricks Python-client voor agent-API's die in de onderstaande voorbeelden worden gebruikt. Je kunt de REST API ook direct aanroepen vanuit elke taal, zonder Python-vereiste.
Hoe beheerde sessies werken
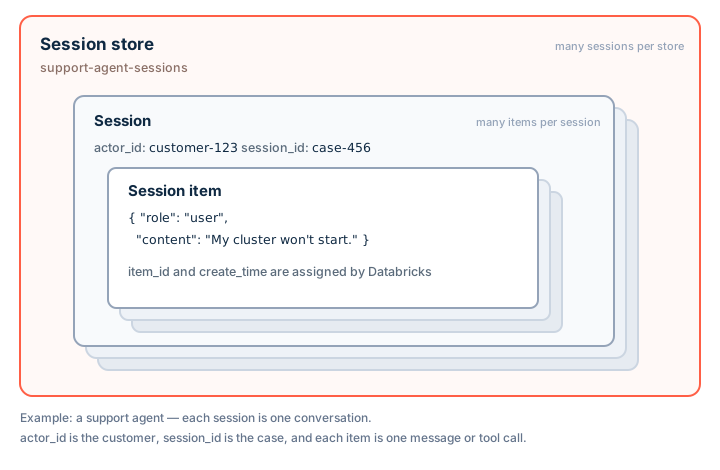
Beheerde sessies bestaan uit drie niveaus:
- Een sessieopslag is de container binnen de werkruimtescope waarin de sessies van een agent worden opgeslagen. Door een store te maken, wordt de onderliggende Lakebase-opslag automatisch ingericht. Je kiest een
session_store_namedie uniek is binnen de werkruimte. - Een sessie is één duurzame interactie (meestal een gespreksdraad) binnen een winkel. Een sessie wordt geïdentificeerd door:
-
actor_id(vereist): van wie de sessie is, zoals een eindgebruiker of een andere agent. Het groepeert alle sessies van één onderwerp zodat je ze samen kunt vermelden en filteren. Wanneer je een per-gebruiker app bouwt, stelactor_iddan in op de gebruikers-ID (bijvoorbeeld de geverifieerde eindgebruikersidentiteit van je app-authenticatie) zodat de sessies van elke gebruiker gegroepeerd blijven. Stel het in vanuit de context van de vertrouwde applicatie, nooit op een door het model of de gebruiker aangegeven waarde. -
session_id(optioneel): een door de beller gekozen ID voor de interactie. De dienst genereert er een als je hem weglaat. -
parent_session_id(optioneel): koppelt een sessie aan de sessie waarvan deze is afgesplitst, om vertakte gesprekken weer te geven.
-
- Een sessie-item is één vermelding in de geordende geschiedenis van een sessie. Elk item bevat een ondoorzichtige, JSON-compatibele
datawaarde, zoals een bericht, toolcall, toolresultaat of redeneerblok. Azure Databricks wijst elk item eenitem_iden eencreate_timetoe en inspecteert of valideert de inhoud niet. Items zijn onveranderlijk nadat ze zijn toegevoegd.
De service onderhoudt een deterministische volgorde voor de items van een sessie en autoriseert elke bewerking tegen de sessieopslag.
Get started
Deze voorbeelden richten beheerde sessies op voor een supportmedewerker: ze maken een sessieopslag aan, starten een sessie voor één gesprek, voegen de beurten van het gesprek toe en lezen de geschiedenis voor op een later verzoek. Kies de klant die bij jouw project past.
AgentKit SDK
De AgentKit SDK is de Databricks Python-client voor agent-API's, verspreid in het databricks-agentbricks pakket. Het authenticeert met de SDK van Databricks WorkspaceClient.
Installeer de AgentKit SDK:
pip install databricks-agentbricksMaak een sessieopslag aan en begin dan een sessie voor één gesprek.
actor_idis van wie het gesprek is; de optionelesession_ididentificeert dit gesprek op unieke wijze:from databricks.sdk import WorkspaceClient from databricks_agentkit import AgentKitClient client = AgentKitClient(WorkspaceClient()) session_store = client.session_stores.create("support-agent-sessions") session = session_store.add(actor_id="customer-123", session_id="case-456")Voeg de wendingen van het gesprek toe terwijl de agent rent. Elk item is een willekeurige JSON-compatibele waarde:
session.append_items(
    [
        {"type": "message", "role": "user", "content": "I need help with my cluster."},
        {"type": "message", "role": "assistant", "content": "Let's take a look."},
    ]
)
Op een vervolgverzoek laad je de sessie opnieuw en lees je de volledige geschiedenis om de context opnieuw op te bouwen:
session = session_store.get("case-456")
# Request chronological order; list_items defaults to newest-first and auto-pages.
history = [item.data for item in session.list_items(order_by="create_time asc")]
REST API
De clients roepen de REST API aan onder /api/2.0/agents/session-stores. Roep het rechtstreeks aan in andere talen dan Python.
Genereer een OAuth-token met de Databricks CLI:
databricks auth login --host ${DATABRICKS_HOST}
export DATABRICKS_TOKEN=$(databricks auth token | jq -r .access_token)
Maak een sessiewinkel voor je agent:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores?session_store_name=support-agent-sessions" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"description": "Support agent conversation history"}'
Begin een sessie voor één gesprek.
actor_idis aan wie het toebehoort;session_ididentificeert dit gesprek op unieke wijze:curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores/support-agent-sessions/sessions?session_id=case-456" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \ -d '{"actor_id": "customer-123"}'Voeg een gespreksbeurt toe terwijl de agent luidt:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores/support-agent-sessions/sessions/case-456/items:append" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"items": [{"data": {"type": "message", "role": "user", "content": "I need help with my cluster."}}]}'
Lees de geschiedenis terug in chronologische volgorde om de context opnieuw op te bouwen:
curl -G "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores/support-agent-sessions/sessions/case-456/items" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" --data-urlencode "order_by=create_time asc"
De clients ondersteunen ook het verwijderen van het meest recente item, het wissen van de items van een sessie en het afsplitsen van een gesprek tot een zelfstandige kopie (eventueel tot en met een specifiek item). Voor het verwijderen van een sessie met onderliggende sessies is een force-optie vereist om de verwijdering naar deze sessies te laten cascaderen (bijvoorbeeld session.delete(force=True)).
Ondersteun de sessie van een agent-framework met beheerde sessies
Agent-frameworks zoals de OpenAI Agents SDK en de Claude Agent SDK lezen de gespreksgeschiedenis aan het begin van een run en voegen nieuwe items toe aan het einde. De sessieopslag sluit direct aan op dat patroon:
| Werking van het framework | Aanroep van sessieopslag |
|---|---|
| Lees geschiedenis |
list_items In chronologische volgorde (order_by="create_time asc") |
| Voeg beurt items toe |
append De nieuwe items |
| Maak het laatste item ongedaan |
pop Het meest recente item |
| Maak de draad leeg |
clear De onderdelen van de sessie |
Reikwijdte en toegang
Beheerde sessies slaan de items van een sessie op als ondoorzichtige, JSON-compatibele waarden: de service blijft behouden en geeft terug wat je agent of framework toevoegt, zonder het te interpreteren. Het voegt geen uitvoeringscontrolemiddelen toe zoals runs, checkpoints of goedkeuringen als eersteklas concepten, hoewel een framework dat zo'n toestand serialiseert deze als items kan behouden.
Sessieopslagruimten zijn gebonden aan de werkruimte en toegang wordt geautoriseerd op het niveau van de opslagruimte. De actor_id en-velden metadata ondersteunen alleen groeperen en filteren; ze verlenen of beperken geen toegang. Stel de actor_id in vanuit een vertrouwde toepassingscontext in plaats van een door het model of de gebruiker opgegeven waarde.
Om een andere principal, zoals de serviceprincipal van uw agent, een store te laten gebruiken, verleen deze toegang via de grant-permission-operatie van de store (session_store.grant_permission(principal_id) in de AgentKit SDK).
Managed sessions en managed memory zijn onafhankelijk. Het verwijderen van een sessie of sessieopslag verwijdert geen geheugen dat in een geheugenopslag is behouden.