Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of de directory te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen de mappen te wijzigen.
De levenscyclus van de AI-toepassing vereist robuuste evaluatieframeworks om ervoor te zorgen dat AI-systemen nauwkeurige, relevante en betrouwbare uitvoer leveren. Zonder strenge evaluatie lopen AI-systemen risico's om reacties te genereren die onjuist, inconsistent, slecht geaard of mogelijk schadelijk zijn. Met waarneembaarheid kunnen teams zowel de kwaliteit als de veiligheid van AI-uitvoer in de hele ontwikkelingslevenscyclus meten en verbeteren, van modelselectie tot productiebewaking.
Wat is waarneembaarheid?
AI-waarneembaarheid verwijst naar de mogelijkheid om AI-systemen gedurende hun levenscyclus te bewaken, te begrijpen en problemen op te lossen. U kunt geautomatiseerde kwaliteitspoorten traceren, evalueren, integreren in CI/CD-pijplijnen en signalen verzamelen, zoals metrische evaluatiegegevens, logboeken, traceringen en modeluitvoer om inzicht te krijgen in prestaties, kwaliteit, veiligheid en operationele status.
Belangrijkste waarneembaarheidsmogelijkheden
Microsoft Foundry biedt drie kernmogelijkheden die samenwerken om een uitgebreide waarneembaarheid te bieden in de levenscyclus van de AI-toepassing:
Evaluatie
Evaluatie meet de kwaliteit, veiligheid en betrouwbaarheid van model- en agentuitvoer tijdens de ontwikkeling en productie. U kunt bestaande gegevenssets evalueren, antwoorden genereren op basis van testinvoer, productietraceringen evalueren of gesprekken simuleren. Microsoft Foundry biedt ingebouwde evaluators, waaronder metrische gegevens voor algemene doeleinden (coherentie, vloeiendheid), RAG-specifieke metrische gegevens (aard, relevantie), veiligheid en beveiliging (haat/oneerlijkheid, geweld, beschermd materiaal) en agentspecifieke metrische gegevens (nauwkeurigheid van toolaanroepen, voltooiing van taken), onder andere. U kunt ook aangepaste evaluators bouwen die zijn afgestemd op uw domeinspecifieke vereisten.
Zie Evaluatie in Microsoft Foundry als u een evaluatiewerkstroom wilt kiezen. Zie de ingebouwde naslaginformatie voor evaluators voor een volledige lijst met beschikbare metrische gegevens.
Bewaking
Productiebewaking zorgt ervoor dat uw geïmplementeerde AI-toepassingen de kwaliteit en prestaties in de praktijk handhaven. Geïntegreerd met Azure Monitor Application Insights, levert Microsoft Foundry realtime dashboards voor het bijhouden van operationele metrische gegevens, tokenverbruik, latentie, foutpercentages en kwaliteitsscores. U kunt waarschuwingen instellen wanneer de drempelwaarden voor de kwaliteit van uitvoer mislukken of schadelijke inhoud produceren, waardoor een snelle oplossing voor problemen mogelijk is.
Zie het dashboard voor agents bewaken voor meer informatie over het instellen van productiebewaking.
Tracering
Gedistribueerde tracering legt de uitvoeringsstroom van AI-toepassingen vast en biedt inzicht in LLM-aanroepen, aanroepen van hulpprogramma's, beslissingen over agents en afhankelijkheden tussen services. Tracering is gebaseerd op OpenTelemetry-standaarden en geïntegreerd met Azure Monitor Application Insights, maakt het opsporen van fouten in complexe agentgedrag mogelijk, het identificeren van knelpunten in prestaties en het begrijpen van redeneringsketens in meerdere stappen. Microsoft Foundry ondersteunt tracering voor populaire frameworks, waaronder LangChain, LangGraph, de OpenAI Agents SDK en het Microsoft Agent Framework.
Zie Traceringsagentoverzicht voor hulp bij het implementeren van tracering.
Wat zijn evaluators?
Evaluators zijn scoremethoden die specifieke kwaliteits-, veiligheids- en betrouwbaarheidskenmerken in model- of agentuitvoer meten. Sommige evaluators gebruiken deterministische berekeningen, terwijl AI-ondersteunde evaluators een beoordelingsmodel gebruiken om reacties te beoordelen en uitleg te geven.
Zie Evaluatie in Microsoft Foundry voor hulp bij het kiezen van een evaluatiebenadering. Zie de ingebouwde evaluatorverwijzing voor een volledige lijst met ingebouwde evaluators.
Evaluators integreren in elke fase van de AI-levenscyclus om betrouwbaarheid, veiligheid en effectiviteit te garanderen.
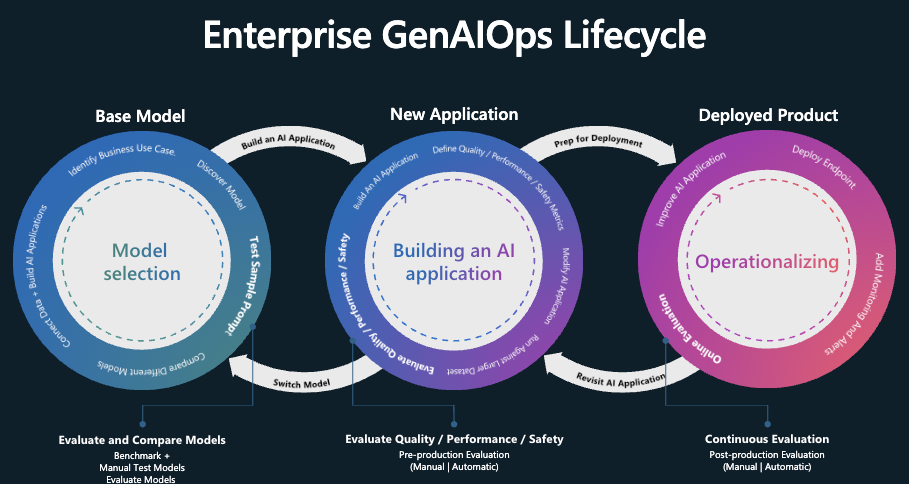
De drie fasen van evaluatie van de levenscyclus van AI-toepassingen
Selectie van basismodel
Selecteer het juiste basismodel door kwaliteit, taakprestaties, ethische overwegingen en veiligheidsprofielen in verschillende modellen te vergelijken.
Tools beschikbaar: Microsoft Foundry-benchmark voor het vergelijken van modellen op openbare gegevenssets of uw eigen gegevens, en de Azure AI Evaluation SDK voor testing van specifieke modeleindpunten.
Evaluatie van preproductie
Voordat de implementatie wordt uitgevoerd, zorgt een grondige test ervoor dat uw AI-agent of -toepassing gereed is voor productie. In deze fase worden de prestaties gevalideerd via evaluatiedatasets, randgevallen geïdentificeerd, robuustheid geëvalueerd en worden belangrijke metrische gegevens gemeten, waaronder naleving van de taak, grondigheid, relevantie en veiligheid. Zie Foundry Agent Service voor het bouwen van productieklare agents met meertrapsgesprekken, het aanroepen van tools en statusbeheer.
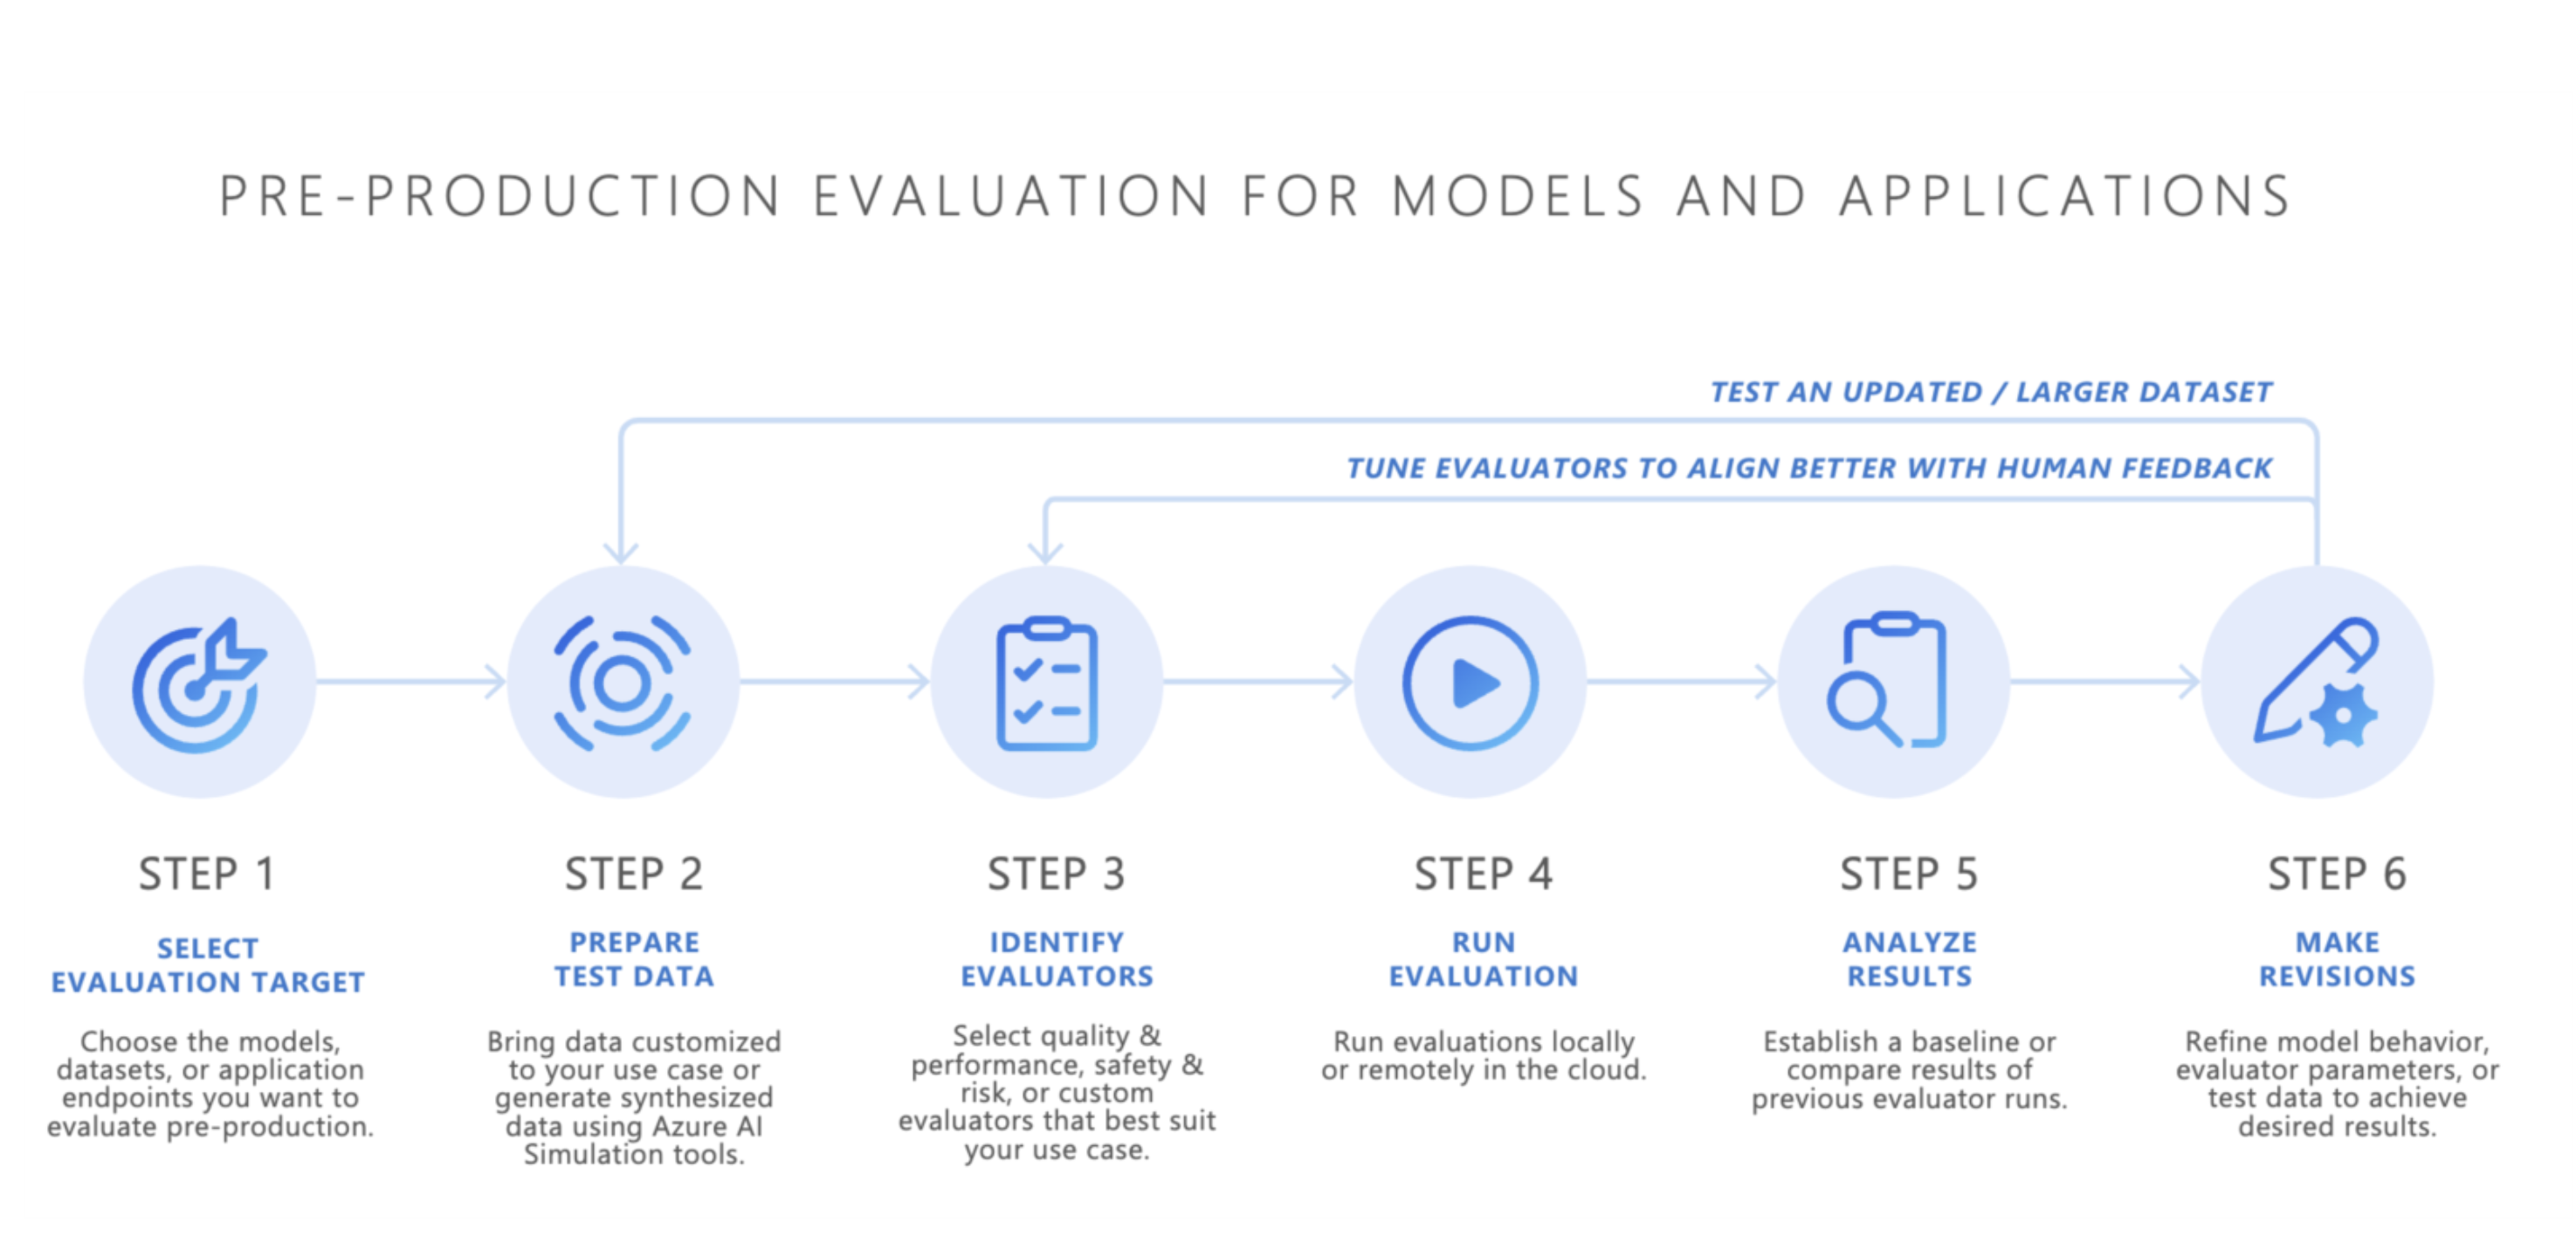
Evaluatiehulpmiddelen en -benaderingen:
Bring Your Own Data: Evalueer AI-toepassingen met uw eigen gegevens met kwaliteit, veiligheid of aangepaste evaluators. Gebruik de evaluatiewizard van de Foundry-portal of Foundry SDK en bekijk de resultaten in de Foundry-portal.
AI red teaming agent: The AI red teaming agent simuleert complexe aanvallen met behulp van het PyRIT-framework van Microsoft om beveiligingsproblemen vóór de implementatie te identificeren. Het meest geschikt voor human-in-the-loop-processen.
Toezicht na de productie
Na de implementatie zorgt continue bewaking ervoor dat uw AI-toepassing de kwaliteit in de praktijk behoudt:
- Operationele metrische gegevens: Regelmatige meting van de belangrijkste operationele metrische gegevens van de AI-agent
- Continue evaluatie: Kwaliteits- en veiligheidsevaluatie van productieverkeer met een steekproefpercentage
- Geplande evaluatie: Geplande kwaliteits- en veiligheidsevaluatie met behulp van testgegevenssets om systeemdrift te detecteren
- Geplande red teaming: geplande adversariale testen om veiligheidsproblemen en kwetsbaarheden in de beveiliging te onderzoeken
- Azure Monitor waarschuwingen: meldingen wanneer uitvoer drempelwaarden voor kwaliteit niet overschrijdt of schadelijke inhoud produceert
Geïntegreerd met Azure Monitor Application Insights biedt het dashboard Foundry Waarneembaarheid realtime inzicht in metrische gegevens over prestaties, veiligheid en kwaliteit, waardoor een snelle oplossing van problemen en het onderhouden van gebruikersvertrouwen mogelijk is.
Snelle verwijzing voor evaluatie
| Purpose | Proces | Parameters, richtlijnen en voorbeelden |
|---|---|---|
| Hoe tracering in te stellen? | Gedistribueerde tracering configureren |
Traceringsoverzicht Traceren met Agents SDK |
| Waarvoor evalueert u? | Relevante evaluatie-instrumenten identificeren of bouwen |
Ingebouwde evaluatoren Aangepaste Evaluators Python SDK-voorbeelden C# SDK-voorbeelden |
| Welke gegevens moet u gebruiken? | Relevante gegevensset uploaden of genereren | Gegevensbron selecteren |
| Hoe kan ik evaluaties uitvoeren? | Een evaluatiewerkstroom kiezen en uitvoeren |
Evaluatieoverzicht Foundry-portal Foundry SDK |
| Hoe heeft mijn model/AI-toepassing uitgevoerd? | Resultaten analyseren |
Evaluatieresultaten weergeven Clusteranalyse |
| Hoe kan ik verbeteren? | Resultaten analyseren en agents optimaliseren | Evaluatiefouten analyseren met clusteranalyse. Optimaliseer agents en evalueer opnieuw. Evaluatieresultaten bekijken. |
Ondersteuning voor regio's, frequentielimieten en ondersteuning voor virtuele netwerken
Als u wilt weten welke regio's ondersteuning bieden voor ai-ondersteunde evaluators, de frequentielimieten die van toepassing zijn op evaluatieuitvoeringen en hoe u ondersteuning voor virtuele netwerken configureert voor netwerkisolatie, raadpleegt u regioondersteuning, frequentielimieten en ondersteuning voor virtuele netwerken voor evaluatie.
Prijzen
Observability-functies, zoals risico- en veiligheidsevaluaties en evaluaties in de agentplayground, worden op basis van verbruik in rekening gebracht zoals vermeld op de Azure-prijzenpagina.
Belangrijk
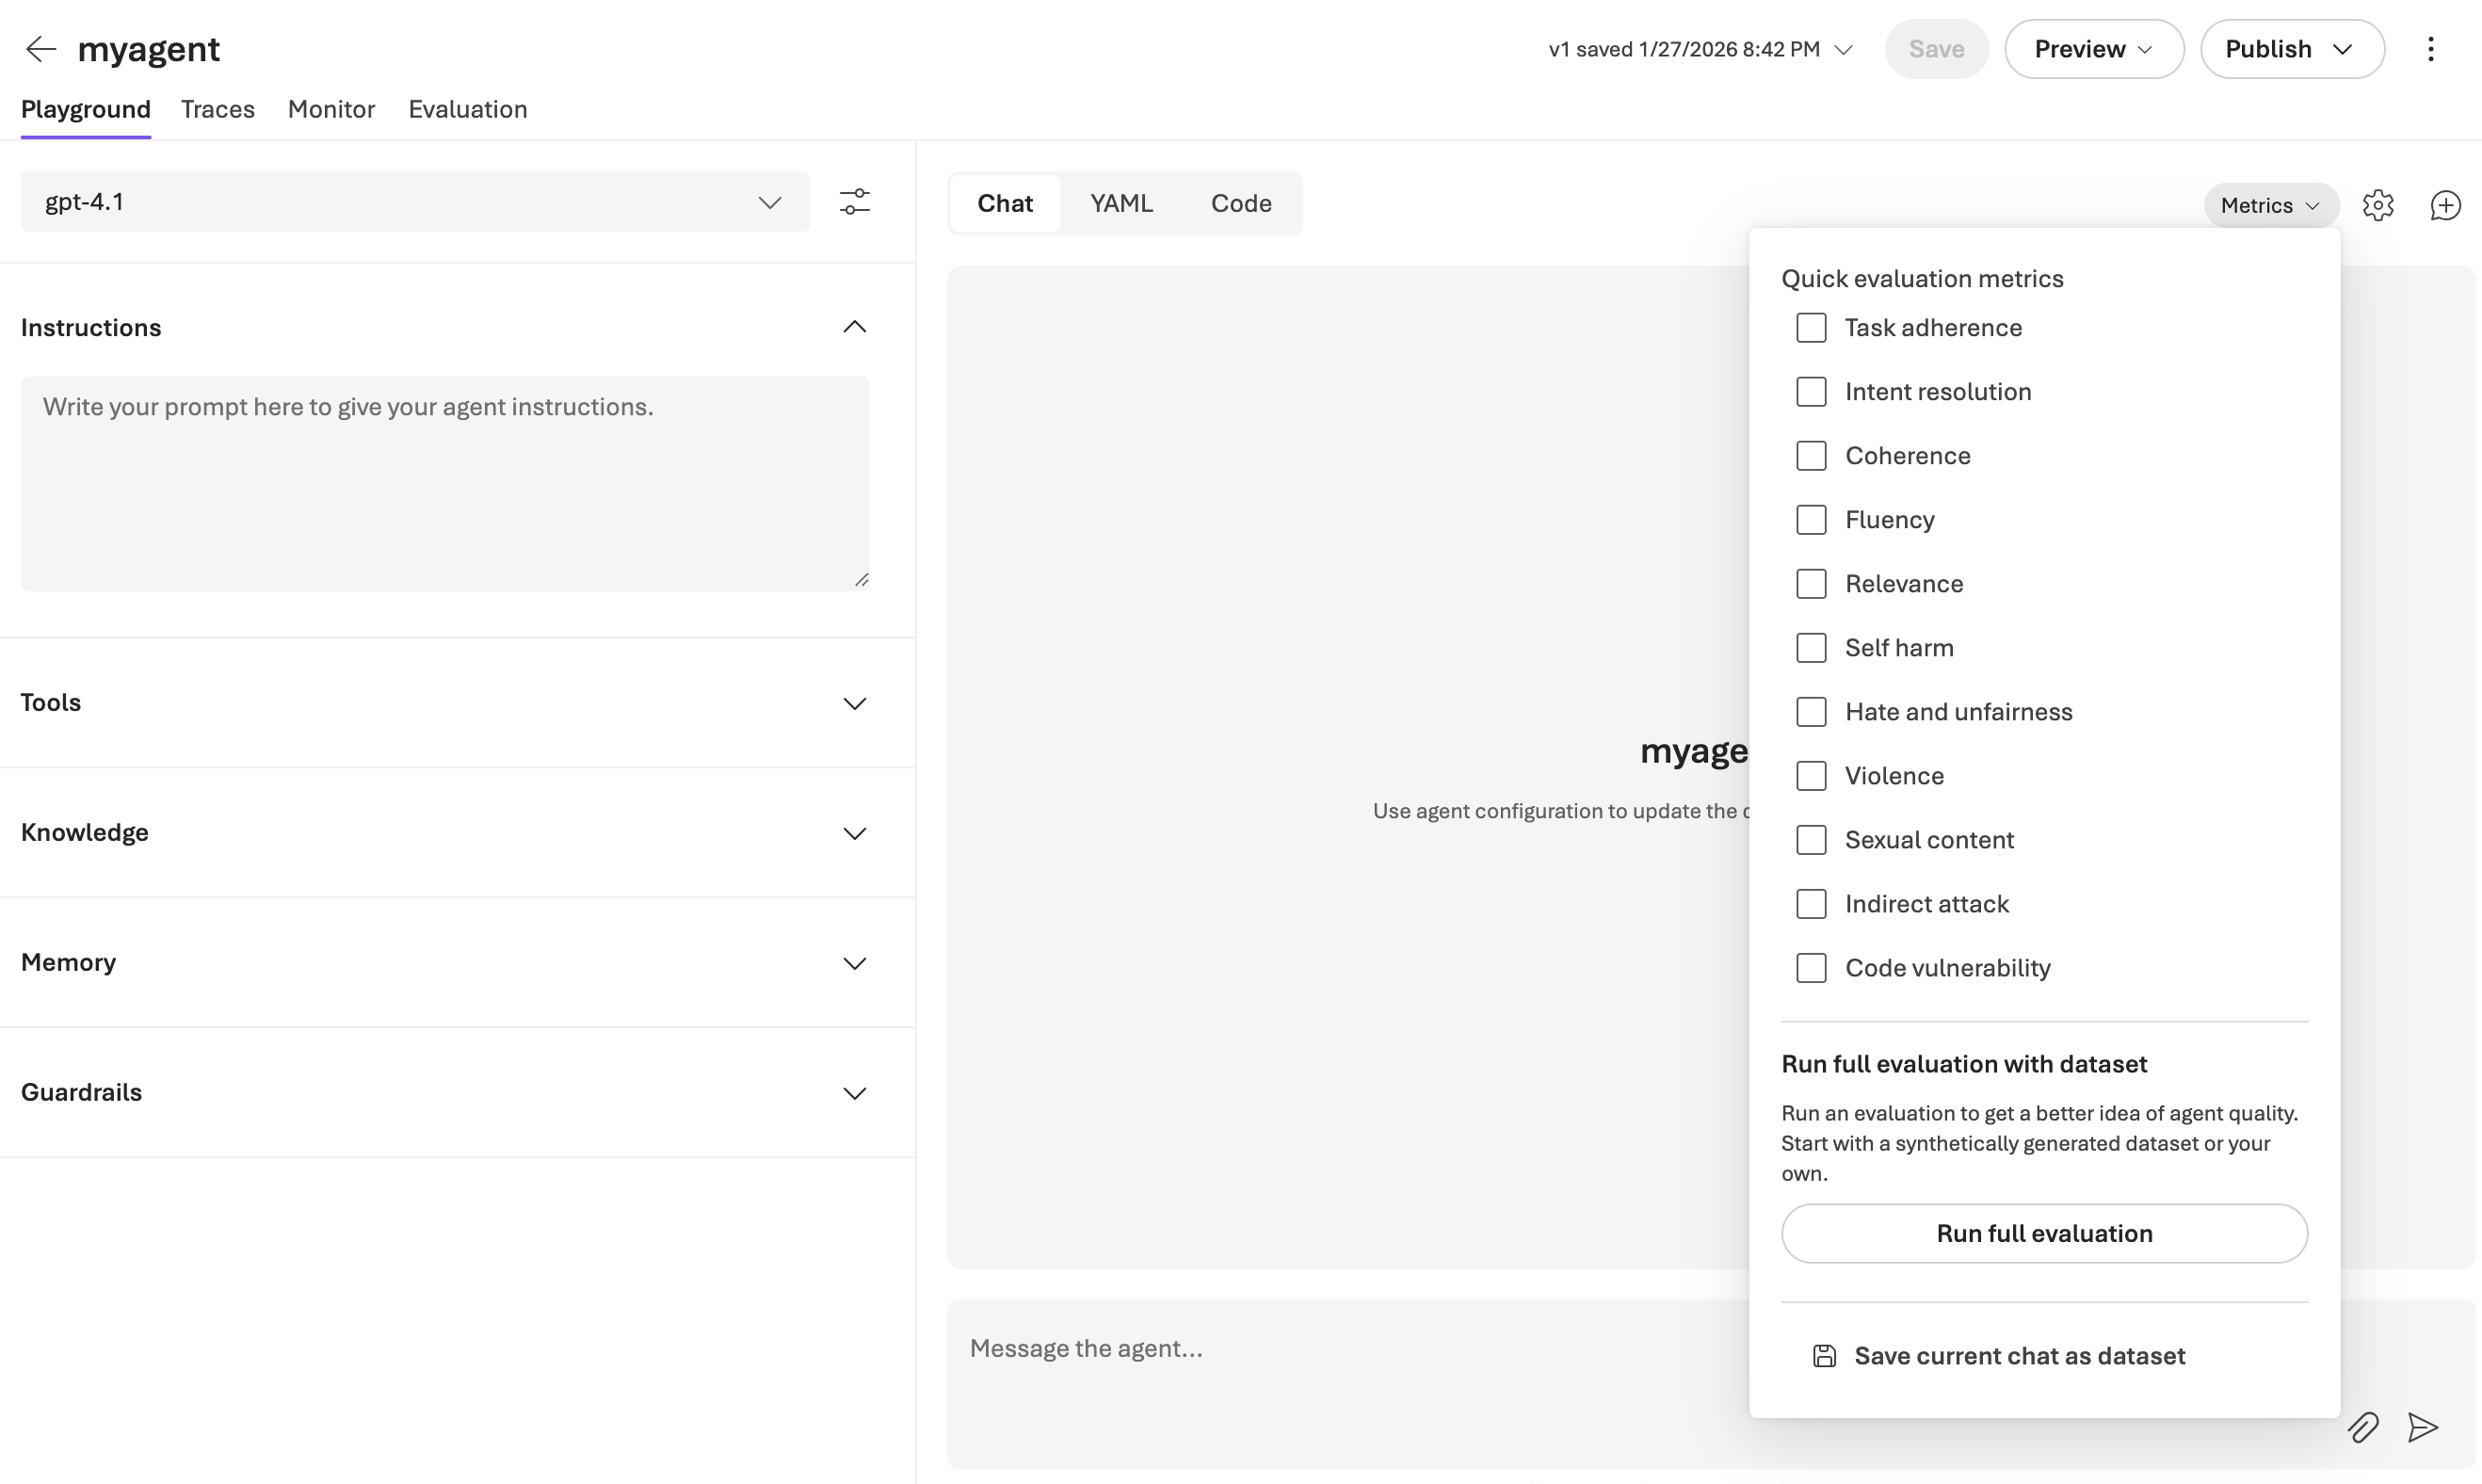
Evaluaties in de agentspeelplaats zijn standaard ingeschakeld voor alle Foundry-projecten en zijn opgenomen in facturering op basis van verbruik. Als u de playground-evaluaties wilt uitschakelen, selecteert u de metrische waarden in de rechterbovenhoek van de agentspeelruimte en verwijdert u alle evaluators.