Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of de directory te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen de mappen te wijzigen.
Van toepassing op: ✅ Warehouse in Microsoft Fabric
Dit artikel beschrijft methoden voor migratie van Azure Synapse Analytics speciale SQL-pools naar Microsoft Fabric Data Warehouse.
Hint
Voor meer informatie over de strategie en de planning van je migratie, raadpleeg Migratieplanning: Azure Synapse Analytics toegewezen SQL-pools naar Fabric Data Warehouse.
Een geautomatiseerde ervaring voor migratie vanuit toegewezen SQL-pools van Azure Synapse Analytics is beschikbaar met behulp van de Fabric Migration Assistant voor datawarehouse-ondersteuning. De rest van dit artikel bevat meer handmatige migratiestappen.
De volgende tabel vat methoden samen voor het migreren van het dataschema (DDL), databasecode (DML) en data. De kolom Optie linkt naar details voor elk scenario.
| Optienummer | Optie | Wat het doet | Vaardigheid of voorkeur | Scenariobeschrijving |
|---|---|---|---|---|
| 1 | Data Factory | Schema (DDL-conversie) Gegevensextract Gegevensopname |
ADF/Pijplijn | Alles vereenvoudigd in één schema (DDL) en gegevensmigratie. Aanbevolen voor dimensietabellen. |
| 2 | Data Factory met partitie | Schema (DDL-conversie) Gegevensextract Gegevensopname |
ADF/Pijplijn | Partitioneringsopties gebruiken om parallel lezen/schrijven te verhogen, wat tien keer de doorvoer biedt in vergelijking met optie 1 en wordt aanbevolen voor feitentabellen. |
| 3 | Data Factory met versnelde codering | Schema (DDL-conversie) | ADF/Pijplijn | Converteer en migreer eerst het schema (DDL), gebruik vervolgens CETAS om gegevens te extraheren en COPY/Data Factory om gegevens in te voeren, voor optimale algehele invoerprestaties. |
| 4 | Versnelde code voor opgeslagen procedures | Schema (DDL-conversie) Gegevensextract Codebeoordeling |
T-SQL | SQL-gebruiker die IDE gebruikt met gedetailleerdere controle over de taken waaraan ze willen werken. Gebruik COPY/Data Factory om gegevens op te nemen. |
| 5 | SQL Database Project-extensie voor Visual Studio Code | Schema (DDL-conversie) Gegevensextract Codebeoordeling |
SQL-Project | SQL Database Project voor implementatie met de integratie van optie 4. Gebruik COPY of Data Factory om gegevens op te nemen. |
| 6 | MAAK EXTERNE TABEL AAN ALS SELECT (CETAS) | Gegevensextract | T-SQL | Kosteneffectieve en krachtige gegevensextractie naar Azure Data Lake Storage (ADLS) Gen2. Gebruik COPY/Data Factory om gegevens op te nemen. |
| 7 | Migreren met behulp van dbt | Schema (DDL-conversie) database code (DML) conversie |
dbt | Bestaande dbt-gebruikers kunnen de dbt Fabric-adapter gebruiken om hun DDL en DML te converteren. Vervolgens moet u gegevens migreren met behulp van andere opties in deze tabel. |
Een workload kiezen voor de eerste migratie
Wanneer je bepaalt waar je moet beginnen met het migratieproject van Synapse dedicated SQL-pool naar Fabric Data Warehouse, kies dan een workloadgebied waarin je:
- Bewijs de haalbaarheid van migreren naar Fabric Data Warehouse door snel de voordelen van de nieuwe omgeving te realiseren. Begin klein en eenvoudig, en bereid je voor op meerdere kleine migraties.
- Geef uw interne technische medewerkers de tijd om relevante ervaring te krijgen met de processen en hulpprogramma's die ze gebruiken wanneer ze migreren naar andere gebieden.
- Maak een sjabloon voor verdere migraties die specifiek zijn voor de Synapse-bronomgeving en de hulpprogramma's en processen die u hierbij kunt helpen.
Hint
Maak een inventaris van objecten om te migreren en documenteer het migratieproces van begin tot eind zodat je het kunt herhalen voor andere toegewijde SQL-pools of workloads.
Het volume gemigreerde data bij een initiële migratie moet groot genoeg zijn om de mogelijkheden en voordelen van de Fabric Data Warehouse omgeving aan te tonen, maar niet te groot om snel waarde aan te tonen. Een grootte in het bereik van 1-10 terabyte is typisch.
Migratie met Fabric Data Factory
Deze sectie beschrijft Data Factory-opties voor gebruikers die bekend zijn met Azure Data Factory- en Synapse-pijplijnen. De drag-and-drop-interface biedt een eenvoudige manier om DDL te converteren en data te migreren.
Fabric Data Factory kan de volgende taken uitvoeren:
- Zet het schema (DDL) om naar Fabric Data Warehouse syntaxis.
- Maak het schema (DDL) op Fabric Data Warehouse.
- Migrer de data naar Fabric Data Warehouse.
Optie 1. Schema- en gegevensmigratie - Assistent voor het kopiëren van gegevens en ForEach-kopieeractiviteit
Deze methode gebruikt Data Factory Copy data assistant om verbinding te maken met de bron-dedicated SQL-pool, de dedicated SQL-pool DDL-syntax om te zetten naar Fabric en data te kopiëren naar Fabric Data Warehouse. U kunt een of meer doeltabellen selecteren (voor TPC-DS gegevensset zijn er 22 tabellen). Het genereert de ForEach om door de lijst van tabellen te lopen die in de gebruikersinterface (UI) zijn geselecteerd en 22 parallelle Copy Activity-draadprocessen te starten.
- 22
SELECTqueries (één voor elke geselecteerde tabel) worden gegenereerd en uitgevoerd in de speciale SQL-pool. - Zorg ervoor dat je de juiste DWU en resource class hebt om de gegenereerde quers te laten uitvoeren. Voor dit geval hebt u minimaal DWU1000 met
staticrc10nodig om maximaal 32 query's mogelijk te maken, zodat 22 ingediende query's afgehandeld kunnen worden. - Het direct kopiëren van data uit de speciale SQL-pool naar Fabric Data Warehouse met Data Factory vereist staging. Het innameproces kent twee fasen:
- De eerste fase haalt data uit de speciale SQL-pool naar ADLS. Deze fase wordt staging genoemd.
- De tweede fase laadt de klaargezette gegevens op in Fabric Data Warehouse. Het grootste deel van de opnametijd wordt besteed aan de stagingfase, dus staging heeft een aanzienlijk effect op de prestaties.
Aanbevolen gebruik
Door de Copy Assistant te gebruiken om een ForEach-activiteit te genereren, wordt een eenvoudige interface geboden om DDL om te zetten en geselecteerde tabellen uit de speciale SQL-pool in één stap in Fabric Data Warehouse te importeren.
Deze optie biedt echter geen optimale totale doorvoer. Staging en de noodzaak om lezen en schrijven te parallelliseren tijdens de source-to-stage-fase zijn de belangrijkste oorzaken van latentie. Gebruik deze optie alleen voor dimensietabellen.
Optie 2. DDL/Gegevensmigratie - Pijplijn met partitieoptie
Om de doorvoer te verbeteren wanneer je grotere facttabellen laadt met een Fabric-pijplijn, gebruik je voor elke facttabel een Copy-activiteit en schakel je partitionering in. Deze configuratie biedt de beste Copy-activiteit-prestaties.
Gebruik de fysieke partities van de brontabel wanneer beschikbaar. Als de tabel niet fysiek is gepartitioneerd, specificeer dan een partitiekolom en minimum- en maximumwaarden voor dynamische partitionering. In de volgende screenshot specificeren de pipeline Source-opties een dynamisch partitiebereik gebaseerd op de ws_sold_date_sk kolom.
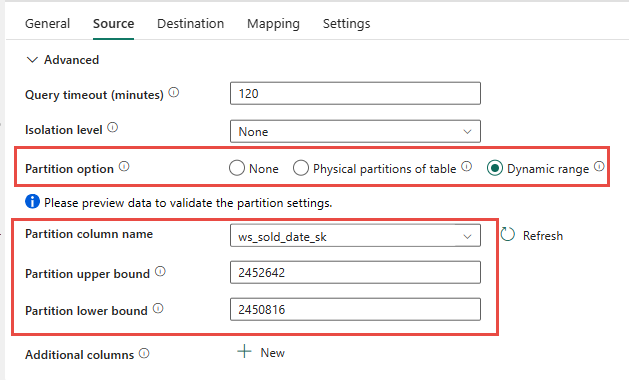
Partitioneren kan de doorvoer van de staging verhogen. Houd rekening met de volgende richtlijnen wanneer u dit configureert:
- Afhankelijk van het partitiebereik kan de operatie meer dan 128 queries genereren en alle gelijktijdige slots in de toegewijde SQL-pool gebruiken.
- Je moet tot een minimum van DWU6000 schalen om alle queries te laten uitvoeren.
- Voor de TPC-DS-tabel
web_saleszijn er bijvoorbeeld 163 query's verzonden naar de toegewezen SQL-pool. Op DWU6000 werden 128 queries uitgevoerd terwijl 35 queries in de wachtrij stonden. - Dynamische partitie selecteert automatisch de bereik-partitie. In dit geval is er een bereik van 11 dagen voor elke SELECT-query die is verzonden naar de toegewezen SQL-pool. Bijvoorbeeld:
WHERE [ws_sold_date_sk] > '2451069' AND [ws_sold_date_sk] <= '2451080')
...
WHERE [ws_sold_date_sk] > '2451333' AND [ws_sold_date_sk] <= '2451344')
Aanbevolen gebruik
Voor feittabellen gebruik je Data Factory met de partitieoptie om de doorvoer te verhogen.
Parallelle reads vereisen echter dat je de dedicated SQL-pool schaalt naar een hogere DWU zodat deze de extractiequeries kan uitvoeren. Partitionering verbetert de snelheid tienmaal vergeleken met wanneer geen partitionering wordt gebruikt. Je kunt de DWU verhogen voor meer doorvoer, maar een speciale SQL-pool staat maximaal 128 actieve queries toe.
Voor meer informatie over Synapse DWU to Fabric mapping, zie Blog: Mapping Azure Synapse dedicated SQL pools to Fabric Data Warehouse compute.
Optie 3. DDL-migratie - Assistent voor het kopiëren van gegevens ForEach-kopieeractiviteit
De twee voorgaande opties zijn geschikt voor kleinere databases. Als je een hogere doorvoersnelheid nodig hebt, gebruik dan dit alternatief:
- Haal de data uit de dedicated SQL-pool naar ADLS om de staging-overhead te verminderen.
- Gebruik Data Factory of het COPY-commando om de data in je warehouse te importeren.
Aanbevolen gebruik
U kunt Data Factory blijven gebruiken om uw schema (DDL) te converteren. Met de Copy Data Assistant kun je de specifieke tabel of Alle tabellen selecteren. Deze methode migreert het schema in één stap, waarbij het schema zonder rijen wordt uitgepakt door gebruik te maken van de valse voorwaarde TOP 0 in de query-instructie.
In het volgende codevoorbeeld wordt de schemamigratie (DDL) behandeld met Data Factory.
Codevoorbeeld: Schemamigratie (DDL) met Data Factory
Je kunt Fabric Pipelines gebruiken om eenvoudig je DDL (schema's) te migreren voor tabelobjecten vanuit elke bron, Azure SQL Database of speciale SQL-pool. Deze pijplijn migreert het schema (DDL) voor de bron-dedicated SQL-pooltabellen naar Fabric Data Warehouse.
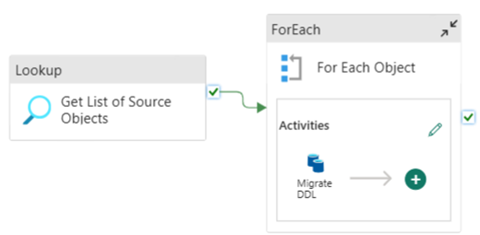
Pijplijnontwerp: parameters
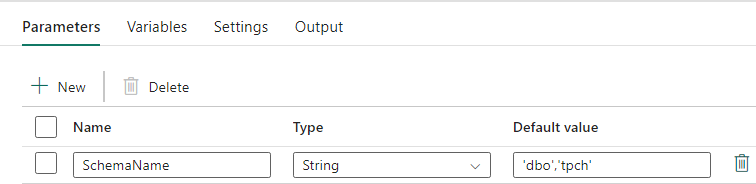
Deze pijplijn accepteert een parameter SchemaName, die je gebruikt om aan te geven welke schema's gemigreerd moeten worden. Het standaardschema is dbo.
Voer in het veld Standaardwaarde een door komma's gescheiden lijst met tabelschema's in die aangeven welke schema's moeten worden gemigreerd: 'dbo','tpch' om twee schema's op te geven, dbo en tpch.
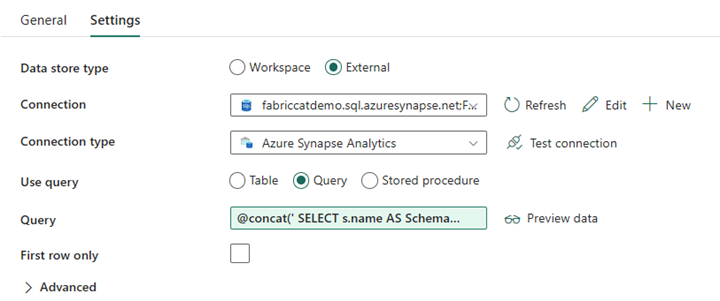
Pijplijnontwerp: Opzoekactiviteit
Maak een opzoekactiviteit en stel de verbinding in zodat deze verwijst naar uw brondatabase.
Op het tabblad Instellingen :
Stel het gegevensarchieftype in op Extern.
Verbinding is uw toegewezen SQL-pool van Azure Synapse. Verbindingstype is Azure Synapse Analytics.
Gebruik query is ingesteld op Query.
Bouw het queryveld door een dynamische expressie te gebruiken, zodat je de parameter
SchemaNamekunt gebruiken in een query die een lijst van doelbrontabellen teruggeeft. Selecteer Query en selecteer vervolgens Dynamische content toevoegen.Deze expressie in de LookUp-activiteit genereert een SQL-instructie om een query uit te voeren op de systeemweergaven om een lijst met schema's en tabellen op te halen. Het verwijst naar de
SchemaNameparameter om filtering op SQL-schema's mogelijk te maken. De output van deze expressie is een array van SQL-schema's en tabellen die de ForEach Activity als invoer gebruikt.Gebruik de volgende code om een lijst met alle gebruikerstabellen met hun schemanaam te retourneren.
@concat('
SELECT s.name AS SchemaName,
t.name  AS TableName
FROM sys.tables AS t
INNER JOIN sys.schemas AS s
ON t.type = ''U''
AND s.schema_id = t.schema_id
AND s.name in (',coalesce(pipeline().parameters.SchemaName, 'dbo'),')
')
Pijplijnontwerp: ForEach-lus
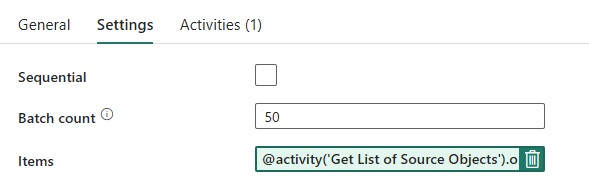
Configureer voor de ForEach-lus de volgende opties op het tabblad Instellingen :
- Schakel Sequential uit om meerdere iteraties gelijktijdig te laten draaien.
- Stel batchaantal in op
50, waardoor het maximum aantal gelijktijdige iteraties wordt beperkt. - Gebruik dynamische inhoud in het Items-veld om naar de output van de LookUp-activiteit te verwijzen. Gebruik het volgende codefragment:
@activity('Get List of Source Objects').output.value
Pijplijnontwerp: Kopieeractiviteit binnen de ForEach-lus
Voeg in de ForEach-activiteit een kopieeractiviteit toe. Deze methode gebruikt de Dynamic Expression Language binnen pijplijnen om een SELECT TOP 0 * FROM <TABLE> statement te bouwen die alleen het schema zonder data naar een warehouse migreert.
Op het tabblad Bron :
- Stel het gegevensarchieftype in op Extern.
- Verbinding is uw toegewezen SQL-pool van Azure Synapse. Verbindingstype is Azure Synapse Analytics.
- Stel Use Query in naar Query.
- In het Query-veld plakt u de dynamische inhoudsquery en gebruikt u deze expressie die nul rijen teruggeeft, maar het tabelschema bevat:
@concat('SELECT TOP 0 * FROM ',item().SchemaName,'.',item().TableName)

Op het tabblad Bestemming :
- Stel het type van datastore in op Werkruimte.
- Stel het type van de Workspace-gegevensopslag in op Data Warehouse en stel de Data Warehouse in op het gegevenswarehouse.
- De schema- en tabelnaam van de doeltabel worden gedefinieerd met dynamische inhoud.
- Schema verwijst naar het veld van de huidige iteratie,
SchemaNamemet het fragment:@item().SchemaName - Tabellenreferenties
TableNamemet het fragment:@item().TableName
- Schema verwijst naar het veld van de huidige iteratie,

Pijplijnontwerp: Afvoer
Voor Sink wijs je naar je Warehouse en verwijs je naar het bron-schema en de tabelnaam.
Wanneer je deze pipeline uitvoert, zie je je warehouse gevuld met elke tabel in je broncode, met het juiste schema.
Migratie door gebruik te maken van opgeslagen procedures in een speciale SQL-pool van Synapse
Deze optie gebruikt opgeslagen procedures om de migratie naar Fabric Data Warehouse uit te voeren.
U kunt de codevoorbeelden ophalen bij microsoft/fabric-migratie op GitHub.com. Deze code wordt gedeeld als open source, dus u kunt gerust bijdragen aan samenwerking en de community helpen.
Wat Fabric Migration opgeslagen procedures kunnen doen:
- Zet het schema (DDL) om naar Fabric Data Warehouse syntaxis.
- Maak het schema (DDL) op Fabric Data Warehouse.
- Extraheer gegevens uit de toegewezen SQL-pool van Synapse naar ADLS.
- Marker niet-ondersteunde Fabric-syntaxis voor T-SQL-codes (opgeslagen procedures, functies, views).
Aanbevolen gebruik
Deze optie is ideaal voor je als je:
- Bekend met T-SQL.
- Ik wil een geïntegreerde ontwikkelomgeving gebruiken voor T-SQL-ontwikkeling.
- Wil meer gedetailleerde controle over aan welke taken je werkt.
U kunt de specifieke opgeslagen procedure uitvoeren voor de DDL-conversie (schema), gegevensextract of T-SQL-code-evaluatie.
Voor de datamigratie gebruik je ofwel COPY INTO of Fabric Data Factory om de data in je warehouse te importeren.
Migreren met behulp van SQL-databaseprojecten
Fabric Data Warehouse ondersteunt de SQL Database Projects-extensie die binnen Visual Studio Code beschikbaar is.
Deze extensie is beschikbaar in Visual Studio Code. Deze functie maakt mogelijkheden mogelijk voor broncodebeheer, databasetests en schemavalidatie.
Voor meer informatie over source control, zie Overzicht van Ontwikkeling en implementatie.
Aanbevolen gebruik
Gebruik deze optie als je de voorkeur geeft aan SQL Database Project voor je implementatie. Deze optie integreert de opgeslagen procedures van Fabric Migration in het SQL-databaseproject om een naadloze migratie-ervaring te bieden.
Een SQL Database-project kan het volgende doen:
- Zet het schema (DDL) om naar Fabric Data Warehouse syntaxis.
- Maak het schema (DDL) op Fabric Data Warehouse.
- Extraheer gegevens uit de toegewezen SQL-pool van Synapse naar ADLS.
- Markeer niet-ondersteunde syntaxis voor T-SQL-codes (opgeslagen procedures, functies, weergaven).
Voor de datamigratie gebruik je ofwel COPY INTO of Data Factory om de data in je warehouse te importeren.
Het Microsoft Fabric CAT-team levert PowerShell-scripts om schema's (DDL) en databasecode (DML) te extraheren, creëren en uitrollen via een SQL-databaseproject. Voor een walkthrough, zie microsoft/fabric-migration op GitHub.
Zie Aan de slag met de extensie SQL Database Projects en een databaseproject maken vanaf de opdrachtregel voor meer informatie over SQL Database Projects.
Migratie van gegevens met CETAS
Het T-SQL CREATE EXTERNAL TABLE AS SELECT (CETAS) commando biedt de meest kosteneffectieve en optimale methode om data te extraheren uit Azure Synapse dedicated SQL-pools naar Azure Data Lake Storage (ADLS) Gen2.
Wat CETAS kan doen:
- Gegevens extraheren in ADLS.
- Deze optie vereist dat je het schema (DDL) in je warehouse aanmaakt voordat je de data invoert. Overweeg de opties in dit artikel om het schema (DDL) te migreren.
De voordelen van deze optie zijn:
- De migratie stuurt slechts één query per tabel in tegen de bron-Synapse dedicated SQL-pool. Deze query gebruikt niet alle concurrencyslots en blokkeert ook geen gelijktijdige ETL-processen of query's van klanten.
- Je hoeft niet naar DWU6000 te schalen, want er wordt maar één concurrency slot per tafel gebruikt, dus je kunt lagere DWU's gebruiken.
- De extractie draait parallel over alle rekenknooppunten, en deze functie verbetert de prestaties.
Aanbevolen gebruik
Gebruik CETAS om de gegevens te extraheren naar ADLS als Parquet-bestanden. Parketbestanden bieden het voordeel van efficiënte gegevensopslag met kolomcompressie, waardoor minder bandbreedte nodig is om over het netwerk te verplaatsen. Omdat Fabric de data opslaat als Delta parquet-formaat, is de gegevensopname 2,5 keer sneller dan het tekstbestandformaat, omdat er tijdens het invoeren geen overhead is omgezet naar het Delta-formaat.
CeTAS-doorvoer verhogen:
- Voeg parallelle CETAS-bewerkingen toe, waardoor het gebruik van gelijktijdigheidssloten wordt verhoogd en er meer doorvoer mogelijk is.
- Schaal de DWU in de toegewezen SQL-pool van Synapse.
Migratie via dbt
Deze sectie beschrijft de dbt-optie voor klanten die dbt al gebruiken in hun Synapse dedicated SQL pool-omgeving.
Wat dbt kan doen:
- Zet het schema (DDL) om naar Fabric Data Warehouse syntaxis.
- Maak het schema (DDL) op Fabric Data Warehouse.
- Databasecode (DML) omzetten naar Fabric-syntaxis.
Het dbt-framework genereert DDL- en DML-scripts (SQL-scripts) op elk gewenst moment met elke uitvoering. Door modelbestanden te gebruiken die in SELECT statements worden uitgedrukt, vertaalt dbt de DDL/DML direct naar elk doelplatform door het profiel (verbindingsreeks) en het adaptertype te wijzigen.
Aanbevolen gebruik
Het dbt-framework gebruikt een code-first benadering. Migreer de data met behulp van opties die in dit document worden vermeld, zoals CETAS of COPY/Data Factory.
Door de dbt-adapter voor Microsoft Fabric Data Warehouse te gebruiken, kun je bestaande dbt-projecten die zich richten op verschillende platforms zoals Azure Synapse dedicated SQL-pools, Snowflake, Databricks, Google BigQuery of Amazon Redshift migreren naar een warehouse met een eenvoudige configuratiewijziging.
Om te beginnen met een dbt-project dat zich richt op Fabric Data Warehouse, zie Tutorial: Stel dbt op voor Fabric Data Warehouse. Dit document vermeldt ook een optie om tussen verschillende magazijnen en platforms te wisselen.
Gegevensinname in Fabric Data Warehouse
Voor invoeren in Fabric Data Warehouse gebruik COPY INTO of Fabric Data Factory, afhankelijk van je voorkeur. Beide methoden zijn de aanbevolen en best presterende opties, omdat ze een vergelijkbare doorvoersnelheid hebben, gezien de voorwaarde dat de bestanden al zijn uitgepakt naar Azure Data Lake Storage (ADLS) Gen2.
Ontwerp je proces voor maximale prestaties door de volgende factoren in overweging te nemen:
- Bij Fabric is er geen resourceconditie wanneer je meerdere tabellen gelijktijdig van ADLS naar Fabric Data Warehouse laadt. Als gevolg hiervan is er geen prestatievermindering bij het laden van parallelle threads. De maximale opnamedoorvoer hangt uitsluitend af van de rekenkracht van uw Fabric-capaciteit.
- Het beheer van fabricworkloads biedt scheiding van resources die zijn toegewezen voor belasting- en querytaken. Er is geen resource-concurrentie terwijl queries en data-laden tegelijkertijd worden uitgevoerd.
Verwante inhoud
- Fabric Migration Assistant voor Gegevensmagazijn
- Een magazijn maken in Microsoft Fabric
- Prestatierichtlijnen voor Fabric Data Warehouse
- Beveiliging in Fabric Data Warehouse
- Blog: Toewijzen van Azure Synapse dedicated SQL-pools aan Fabric Data Warehouse-rekenkracht
- Overzicht van Migratie van Microsoft Fabric