Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Buforowanie jest typową techniką, której celem jest zwiększanie wydajności i skalowalności systemu. Buforowanie tymczasowo kopiuje często wykorzystywane dane do pamięci masowej znajdującej się bliżej aplikacji niż pierwotne źródło tych danych. Takie podejście może znacznie poprawić czas odpowiedzi dla aplikacji klienckich, szybciej obsługując dane.
Buforowanie jest najskuteczniejsze, gdy wystąpienie klienta wielokrotnie odczytuje te same dane, zwłaszcza jeśli wszystkie następujące warunki mają zastosowanie do oryginalnego magazynu danych:
- Magazyn danych pozostaje stosunkowo statyczny.
- Jest powolny w porównaniu do prędkości pamięci podręcznej.
- Podlega wysokiemu poziomowi rywalizacji.
- Jest wystarczająco daleko od klientów, że opóźnienie sieci jest znaczące.
Buforowanie w aplikacjach rozproszonych
Aplikacje rozproszone zwykle implementują obie z następujących strategii podczas buforowania danych:
Użyj prywatnej pamięci podręcznej, w której dane są przechowywane lokalnie na komputerze z uruchomioną aplikacją lub usługą.
Użyj udostępnionej pamięci podręcznej, która służy jako wspólne źródło, do którego może uzyskiwać dostęp wiele procesów i maszyn.
W obu przypadkach buforowanie można wykonywać po stronie klienta i po stronie serwera. Proces, który udostępnia interfejs użytkownika dla systemu, taki jak przeglądarka internetowa lub aplikacja klasyczna, obsługuje buforowanie po stronie klienta. Buforowanie po stronie serwera jest realizowane zdalnie przez proces udostępniający usługi biznesowe.
Buforowanie prywatne
Najbardziej podstawowym typem pamięci podręcznej jest magazyn w pamięci. Jest on przechowywany w przestrzeni adresowej pojedynczego procesu, a kod uruchamiany w tym procesie uzyskuje bezpośredni dostęp do pamięci podręcznej. Dostęp do tego typu pamięci podręcznej jest szybki. Może również zapewnić skuteczne środki do przechowywania skromnych ilości danych statycznych. Ilość pamięci dostępnej na maszynie zwykle ogranicza rozmiar pamięci podręcznej.
Jeśli potrzebujesz buforować więcej informacji niż jest to fizycznie możliwe w pamięci, możesz zapisać dane w pamięci podręcznej w lokalnym systemie plików. Uzyskiwanie dostępu do danych z systemu plików trwa dłużej niż w przypadku przechowywania danych w pamięci, ale nadal powinno być szybsze i bardziej niezawodne niż pobieranie danych w sieci.
Jeśli masz wiele wystąpień aplikacji, które korzystają z tego modelu uruchomionego współbieżnie, każde wystąpienie aplikacji ma własną niezależną pamięć podręczną, która przechowuje własną kopię danych.
Pomyśl o pamięci podręcznej jako o migawce oryginalnych danych z poprzedniego momentu w przeszłości. Jeśli te dane nie są statyczne, prawdopodobnie różne wystąpienia aplikacji przechowują różne wersje danych w swoich pamięciach podręcznych. W związku z tym to samo zapytanie wykonywane przez te wystąpienia może zwracać różne wyniki, jak pokazano na poniższym diagramie.
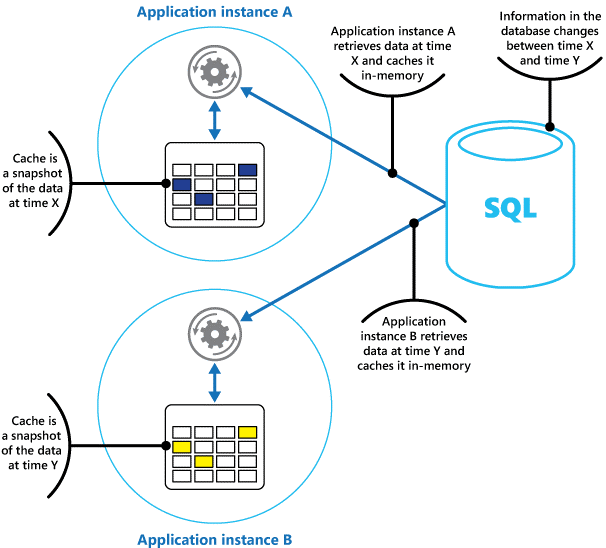
Diagram przedstawiający niespójność pamięci podręcznej w wielu wystąpieniach aplikacji połączonych z udostępnioną bazą danych SQL. Po prawej stronie znajduje się baza danych SQL reprezentowana jako cylindra. W lewym górnym rogu znajduje się duży okrąg opisany jako wystąpienie aplikacji A, a w lewym dolnym rogu znajduje się okrąg o podobnym rozmiarze, opisany jako wystąpienie aplikacji B. Wewnątrz wystąpienia aplikacji A znajduje się ikona koła zębatego, reprezentująca proces aplikacji. Poniżej ikony koła zębatego znajduje się tabela w układzie siatki przedstawiająca pamięć podręczną w pamięci operacyjnej. Poza granicą znajduje się pamięć podręczna odczytu etykiety— migawka danych w czasie X. Wewnątrz wystąpienia aplikacji B jest kolejną ikoną koła zębatego. Poniżej ikony koła zębatego znajduje się tabela w układzie siatki przedstawiająca pamięć podręczną w pamięci operacyjnej. Poza obramowaniem znajduje się etykieta o treści: pamięć podręczna to migawka danych z chwili Y. Od bazy danych SQL biegnie linia w kierunku instancji aplikacji A, opisana etykietą: instancja aplikacji A pobiera dane w chwili X i przechowuje je w pamięci podręcznej. Druga linia biegnie od bazy danych SQL w kierunku instancji aplikacji B, z etykietą: „instancja aplikacji B pobiera dane w czasie Y i buforuje je w pamięci”. Między tymi dwiema liniami adnotacji znajduje się notatka informująca, że informacje w bazie danych zmieniają się między chwilą X a chwilą Y.
Buforowanie współdzielone
Korzystając ze współdzielonej pamięci podręcznej, możesz zapewnić, że wszystkie instancje aplikacji będą widzieć ten sam stan danych w pamięci podręcznej. Pamięć podręczna znajduje się w oddzielnej lokalizacji, która jest zwykle hostowana jako część oddzielnej usługi, jak pokazano na poniższym diagramie.
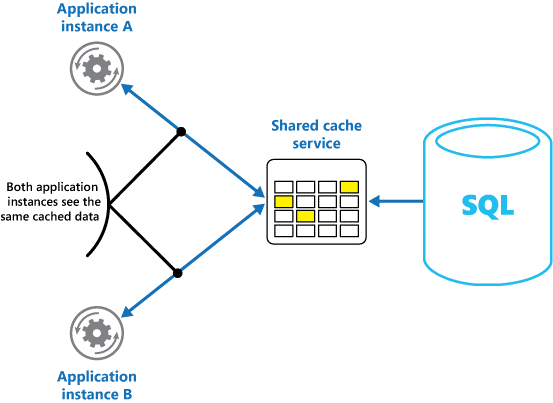
Diagram przedstawiający, jak usługa współdzielonej pamięci podręcznej rozwiązuje problem niespójności pamięci podręcznej między wieloma instancjami aplikacji połączonymi z bazą danych SQL. Po prawej stronie znajduje się baza danych SQL reprezentowana jako cylindra. Pośrodku znajduje się pole z etykietą „usługa współdzielonej pamięci podręcznej”, w którym znajduje się tabela reprezentująca współdzieloną pamięć podręczną. Po lewej stronie znajduje się ikona koła zębatego z etykietą „wystąpienie aplikacji A”. Poniżej znajduje się druga ikona koła zębatego z etykietą „wystąpienie aplikacji B”. Czarna strzałka prowadzi od bazy danych SQL do siatki usługi współdzielonej pamięci podręcznej, wskazując, że baza danych zasila współdzieloną pamięć podręczną danymi. Od usługi współdzielonej pamięci podręcznej wychodzą na zewnątrz dwie niebieskie strzałki, z których jedna jest skierowana w stronę wystąpienia aplikacji A, a druga w stronę wystąpienia aplikacji B. Po skrajnej lewej stronie zakrzywiony nawias rozciąga się pionowo między dwoma wystąpieniami aplikacji, obok niego znajduje się etykieta z napisem „Oba wystąpienia aplikacji widzą te same dane zapisane w pamięci podręcznej.” Ta etykieta i nawias wyróżniają kluczową zaletę architektury współdzielonej pamięci podręcznej: w przeciwieństwie do oddzielnej pamięci podręcznej w pamięci operacyjnej dla każdej instancji, instancje aplikacji A i B pobierają dane z tej samej scentralizowanej pamięci podręcznej.
Ważną zaletą wspólnego podejścia do buforowania jest skalowalność. Wiele usług udostępnionej pamięci podręcznej jest implementowanych przy użyciu klastra serwerów i używa oprogramowania do przezroczystego dystrybuowania danych w klastrze. Wystąpienie aplikacyjne wysyła żądanie do usługi pamięci podręcznej. Podstawowa infrastruktura określa lokalizację buforowanych danych w klastrze. Pamięć podręczną można łatwo skalować, dodając więcej serwerów.
Istnieją dwie główne wady wspólnego podejścia buforowania:
- Dostęp do pamięci podręcznej jest wolniejszy, ponieważ nie jest ona już przechowywana lokalnie z każdym wystąpieniem aplikacji.
- Zaimplementowanie oddzielnej usługi pamięci podręcznej może zwiększyć złożoność rozwiązania.
Zagadnienia dotyczące używania buforowania
W poniższych sekcjach opisano zagadnienia dotyczące projektowania i używania pamięci podręcznej.
Decydowanie o tym, kiedy mają być buforowane dane
Buforowanie może znacznie poprawić wydajność, skalowalność i dostępność. Im więcej danych i im większa liczba użytkowników, którzy muszą uzyskiwać dostęp do tych danych, tym większe korzyści wynikające z buforowania. Buforowanie zmniejsza opóźnienie i rywalizację, które są skojarzone z obsługą dużych ilości współbieżnych żądań w oryginalnym magazynie danych.
Na przykład baza danych może obsługiwać ograniczoną liczbę połączeń współbieżnych. Jednak pobieranie danych z udostępnionej pamięci podręcznej, a nie bazowej bazy danych, umożliwia aplikacji klienckiej uzyskanie dostępu do tych danych nawet wtedy, gdy liczba dostępnych połączeń jest obecnie wyczerpana. Ponadto jeśli baza danych stanie się niedostępna, aplikacje klienckie mogą nadal korzystać z danych w pamięci podręcznej.
Rozważ buforowanie danych, które są często odczytywane, ale modyfikowane rzadko. Na przykład dane pamięci podręcznej, które mają większy odsetek operacji odczytu niż operacje zapisu. Nie należy jednak używać pamięci podręcznej jako autorytatywnego magazynu informacji krytycznych. Zamiast tego zapisz wszystkie ważne zmiany w trwałym magazynie danych. Jeśli pamięć podręczna jest niedostępna, aplikacja może nadal działać, korzystając z magazynu danych, i nie tracisz ważnych informacji.
Określanie sposobu efektywnego buforowania danych
Aby efektywnie używać pamięci podręcznej, określ najbardziej odpowiednie dane do buforowania i buforuj je w odpowiednim czasie. Dane można dodawać do pamięci podręcznej, gdy aplikacja pobiera je po raz pierwszy. Aplikacja musi pobrać dane tylko raz z magazynu danych, a następnie można osiągnąć kolejny dostęp przy użyciu pamięci podręcznej.
Alternatywnie można częściowo lub w pełni wypełnić pamięć podręczną danymi z wyprzedzeniem, zazwyczaj po uruchomieniu aplikacji. Takie podejście jest znane jako zasiewanie. Nie zawsze jest wskazane inicjowanie dużej pamięci podręcznej, ponieważ takie podejście może narzucić nagłe, wysokie obciążenie oryginalnego źródła danych, gdy aplikacja zaczyna działać.
Analiza wzorców użycia pozwala zdecydować, czy wstępnie zapełnić pamięć podręczną w całości czy częściowo, oraz określić, które dane zapisać w pamięci podręcznej. Na przykład można wstępnie zapełnić pamięć podręczną statycznymi danymi profilu użytkownika dla klientów, którzy korzystają z aplikacji codziennie, ale nie dla klientów, którzy korzystają z niej tylko raz w tygodniu.
Buforowanie zwykle działa dobrze z danymi, które są niezmienne lub które zmieniają się rzadko. Przykłady obejmują informacje referencyjne, takie jak informacje o produkcie i cenach w aplikacji handlu elektronicznego lub udostępnione zasoby statyczne, które są kosztowne do konstruowania. Załaduj niektóre lub wszystkie te dane do pamięci podręcznej podczas uruchamiania aplikacji, aby zminimalizować zapotrzebowanie na zasoby i zwiększyć wydajność. Możesz również mieć proces w tle, który okresowo aktualizuje dane referencyjne w pamięci podręcznej, aby upewnić się, że są aktualne. Lub proces w tle może odświeżyć pamięć podręczną po zmianie danych referencyjnych.
Buforowanie jest mniej przydatne w przypadku danych dynamicznych, chociaż istnieją pewne wyjątki. Aby uzyskać więcej informacji, zobacz sekcję Buforowanie wysoce dynamicznych danych w dalszej części tego artykułu. Gdy oryginalne dane zmieniają się regularnie, buforowane informacje szybko stają się nieaktualne lub obciążenie związane z synchronizacją pamięci podręcznej z oryginalnym magazynem danych zmniejsza skuteczność buforowania.
Pamięć podręczna nie musi zawierać pełnych danych dla jednostki. Jeśli na przykład element danych reprezentuje obiekt wielowartościowy, taki jak klient bankowy, który ma nazwę, adres i saldo konta, niektóre z tych elementów mogą pozostać statyczne, takie jak nazwa i adres. Inne elementy, takie jak saldo konta, mogą być bardziej dynamiczne. W takich sytuacjach może być przydatne buforowanie statycznych części danych i pobieranie (lub obliczanie) tylko pozostałych informacji w razie potrzeby.
Przeprowadź testy wydajnościowe i analizę sposobu użycia, aby określić, czy odpowiednie jest wstępne wypełnianie pamięci podręcznej, ładowanie jej na żądanie, czy połączenie obu podejść. Na podstawie decyzji dotyczącej zmienności i wzorca użycia danych. Wykorzystanie pamięci podręcznej i analiza wydajności są ważne w aplikacjach, które napotykają duże obciążenia i muszą być wysoce skalowalne. Na przykład w scenariuszach wymagających wysokiej skalowalności można wstępnie wypełnić pamięć podręczną, aby zmniejszyć obciążenie magazynu danych w godzinach szczytu.
Buforowanie może również służyć do unikania powtarzania obliczeń podczas działania aplikacji. Jeśli operacja przekształca dane lub wykonuje skomplikowane obliczenia, może zapisać wyniki operacji w pamięci podręcznej. Jeśli to samo obliczenie jest wymagane później, aplikacja może pobrać wyniki z pamięci podręcznej.
Aplikacja może modyfikować dane w pamięci podręcznej. Należy jednak traktować pamięć podręczną jako przejściowy magazyn danych, który może zniknąć w dowolnym momencie. Nie przechowuj cennych danych tylko w pamięci podręcznej; upewnij się, że informacje są przechowywane w oryginalnym magazynie danych. Takie podejście minimalizuje ryzyko utraty danych, jeśli pamięć podręczna stanie się niedostępna.
Zachowaj spójność pamięci podręcznej podczas zapisu
Gdy aplikacja zmienia dane, które również przechowuje w pamięci podręcznej, zdecyduj, jak zapewnić spójność pamięci podręcznej z systemem źródłowym. Typowe są dwa podejścia:
Unieważnianie przy zapisie: Zapisz zmianę w magazynie danych, a następnie usuń odpowiedni wpis z pamięci podręcznej. Następny odczyt ponownie wypełnia pamięć podręczną z magazynu danych. Takie podejście utrzymuje prostą ścieżkę zapisu, ale czytelnik może doświadczyć chybienia pamięci podręcznej lub krótko zobaczyć nieaktualne dane natychmiast po zapisie. WzorzecCache-Aside opisuje to podejście.
Zapis: Zaktualizuj magazyn danych i pamięć podręczną w ramach tej samej operacji zapisu i zwróć odpowiedź zapisu dopiero po pomyślnym wykonaniu obu aktualizacji. Takie podejście zapewnia czytelnikom zaktualizowaną wartość natychmiast po pomyślnym zapisie, kosztem większego opóźnienia zapisu i większej logiki koordynacji.
Przykład kompleksowego rozwiązania, który używa Azure Functions do koordynowania aktualizacji z zapisem bezpośrednim w Azure SQL Database i Azure Managed Redis, znajduje się w artykule Buforowanie z zapisem bezpośrednim przy użyciu Azure Managed Redis i Azure SQL Database.
Używaj trybu write-through tylko w przypadku ścieżek dostępu z przewagą operacji odczytu, które wymagają aktualności odczytu bezpośrednio po zapisie. W przypadku danych, które są rzadko odczytywane po zapisie lub które zmieniają się stale, unieważnij zapis lub pomiń pamięć podręczną.
Buforowanie wysoce dynamicznych danych
Przechowywanie szybko zmieniających się informacji w trwałym magazynie danych może narzucić obciążenie systemu. Rozważmy na przykład urządzenie, które stale zgłasza stan lub inny pomiar. Jeśli aplikacja zdecyduje się nie buforować tych danych na podstawie tego, że buforowane informacje są zwykle nieaktualne, taka sama kwestia może być prawdziwa podczas przechowywania i pobierania tych informacji z magazynu danych. W czasie potrzebnym na zapisanie i pobranie tych danych może ulec zmianie.
W takiej sytuacji należy wziąć pod uwagę zalety przechowywania informacji dynamicznych bezpośrednio w pamięci podręcznej zamiast w trwałym magazynie danych. Jeśli dane są niekrytyczne i nie wymagają inspekcji, nie ma znaczenia, czy sporadyczne zmiany zostaną utracone.
Zarządzanie wygasaniem danych w pamięci podręcznej
W większości przypadków pamięć podręczna przechowuje dane, które są kopią danych z oryginalnego magazynu danych. Dane w oryginalnym źródle danych mogą ulec zmianie po zapisaniu ich w pamięci podręcznej, przez co dane w pamięci podręcznej mogą stać się nieaktualne. Wiele systemów buforowania umożliwia skonfigurowanie pamięci podręcznej tak, aby wygasała dane, co zmniejsza okres, w którym dane mogą być nieaktualne.
Po wygaśnięciu buforowanych danych pamięć podręczna je usunie. Następnie aplikacja pobiera nowe dane z oryginalnego magazynu danych i może zastąpić wygasłe dane w pamięci podręcznej. Podczas konfigurowania pamięci podręcznej można ustawić domyślne zasady wygasania. W wielu usługach pamięci podręcznej można również określić okres wygaśnięcia poszczególnych obiektów podczas programowego przechowywania ich w pamięci podręcznej. Niektóre pamięci podręczne umożliwiają określenie okresu wygaśnięcia jako wartości bezwzględnej lub jako wartości przesuwanej, jeśli element nie jest dostępny w określonym czasie. To ustawienie zastępuje wszystkie zasady wygasania całej pamięci podręcznej, ale tylko dla określonych obiektów.
Note
Należy dokładnie rozważyć okres wygaśnięcia pamięci podręcznej i obiekty, które zawiera. Jeśli ustawisz zbyt krótki czas dla pamięci podręcznej, obiekty będą wygasać zbyt szybko, co zmniejszy korzyści z jej używania. Jeśli okres będzie zbyt długi, ryzyko, że dane staną się nieaktualne.
Jeśli zezwolisz na przechowywanie danych w pamięci podręcznej przez długi czas, pamięć podręczna może być wypełniana. W takim przypadku wszelkie próby dodania nowych elementów do pamięci podręcznej mogą spowodować, że pamięć podręczna automatycznie usunie niektóre elementy w procesie zwanym „eviction”. Usługi pamięci podręcznej zwykle usuwają dane na zasadzie najmniej ostatnio używanego (LRU), ale zazwyczaj można zmienić te zasady i zapobiec usuwaniu elementów. Jeśli jednak zastosujesz to podejście, ryzykujesz przekroczenie pamięci dostępnej w pamięci podręcznej. Aplikacja, która próbuje dodać element do pełnej pamięci podręcznej, kończy się niepowodzeniem z wyjątkiem.
Niektóre implementacje buforowania mogą oferować inne polityki usuwania. Typy zasad eksmisji obejmują:
- Ostatnio używane zasady: usuwa ostatnio używane elementy z pamięci podręcznej w oczekiwaniu, że dane nie będą ponownie wymagane.
- Zasada „pierwsze weszło, pierwsze wyszło” (FIFO): najpierw usuwa z pamięci podręcznej najstarsze dane.
- Jawne zasady usuwania: usuwa elementy z pamięci podręcznej na podstawie zdarzenia wyzwalającego, takiego jak modyfikowane dane.
Unieważnij dane w pamięci podręcznej po stronie klienta
Dane przechowywane w pamięci podręcznej po stronie klienta są uważane za poza kontrolą usługi, która dostarcza dane klientowi. Usługa nie może bezpośrednio wymusić na kliencie dodawania ani usuwania informacji z pamięci podręcznej po stronie klienta.
To ograniczenie oznacza, że klient korzystający z źle skonfigurowanej pamięci podręcznej może nadal korzystać z nieaktualnych informacji. Jeśli na przykład zasady wygasania pamięci podręcznej nie są prawidłowo implementowane, klient może używać nieaktualnych informacji buforowanych lokalnie, gdy informacje w oryginalnym źródle danych się zmienią.
Jeśli tworzysz aplikację internetową, która obsługuje dane za pośrednictwem połączenia HTTP, możesz niejawnie wymusić na kliencie internetowym, takim jak przeglądarka lub internetowy serwer proxy, aby pobrać najnowsze informacje. To odświeżanie można wyzwolić, zmieniając identyfikator URI za każdym razem, gdy zaktualizujesz zasób. Klienci sieci Web zazwyczaj używają identyfikatora URI zasobu jako klucza w pamięci podręcznej po stronie klienta, więc jeśli identyfikator URI ulegnie zmianie, klient internetowy ignoruje wszystkie wcześniej buforowane wersje zasobu i pobiera nową wersję.
Zarządzanie współbieżnością w pamięci podręcznej
Często projektujesz pamięci podręczne, które mają być współużytkowane przez wiele wystąpień aplikacji. Każde wystąpienie aplikacji może odczytywać i modyfikować dane w pamięci podręcznej, więc te same problemy ze współbieżnością, które występują w dowolnym udostępnionym magazynie danych, mają zastosowanie również do pamięci podręcznej. W sytuacji, gdy aplikacja musi zmodyfikować dane przechowywane w pamięci podręcznej, może być konieczne upewnienie się, że aktualizacje wprowadzone przez jedno wystąpienie aplikacji nie zastępują zmian wprowadzonych przez inne wystąpienie.
W zależności od charakteru danych i prawdopodobieństwa kolizji należy przyjąć jedno z dwóch podejść do współbieżności:
Optymistycznej: Zanim aplikacja zaktualizuje dane, sprawdza, czy dane w pamięci podręcznej uległy zmianie od czasu ich pobrania. Jeśli dane są nadal takie same, aplikacja wprowadza zmianę. W przeciwnym razie aplikacja decyduje, czy ją zaktualizować. Logika biznesowa, która napędza tę decyzję, jest specyficzna dla aplikacji. Takie podejście jest odpowiednie w sytuacjach, gdy aktualizacje są rzadkie lub gdy prawdopodobieństwo wystąpienia kolizji jest niewielkie.
Pesymistyczne: Gdy aplikacja pobiera dane, blokuje je w pamięci podręcznej, aby uniemożliwić innemu wystąpieniu ich zmianę. Ten proces gwarantuje, że nie mogą wystąpić kolizje, ale może również blokować inne wystąpienia, które muszą przetwarzać te same dane. Pesymistyczna współbieżność może mieć wpływ na skalowalność rozwiązania i jest zalecana tylko w przypadku krótkotrwałych operacji. Takie podejście może być odpowiednie w sytuacjach, w których kolizje są bardziej prawdopodobne, zwłaszcza jeśli aplikacja aktualizuje wiele elementów w pamięci podręcznej i musi zapewnić spójne stosowanie tych zmian.
Implementowanie wysokiej dostępności i skalowalności oraz zwiększanie wydajności
Unikaj używania pamięci podręcznej jako podstawowego repozytorium danych. Oryginalny magazyn danych, z którego jest wypełniana pamięć podręczna, pełni tę rolę. Oryginalny magazyn danych zapewnia trwałość danych.
Należy zachować ostrożność, aby nie wprowadzać krytycznych zależności od dostępności usługi pamięci podręcznej w swoich rozwiązaniach. Aplikacja powinna mieć możliwość kontynuowania działania, jeśli udostępniona pamięć podręczna jest niedostępna. Aplikacja nie powinna stać się nieodpowiadającą lub przestać działać podczas oczekiwania na ponowne uruchomienie usługi pamięci podręcznej.
W związku z tym aplikacja musi być przygotowana do wykrywania dostępności usługi pamięci podręcznej i powrotu do oryginalnego magazynu danych, jeśli pamięć podręczna jest niedostępna. WzorzecCircuit-Breaker jest przydatny do obsługi tego scenariusza. Usługę udostępniającą pamięć podręczną można przywrócić, a gdy ponownie stanie się dostępna, pamięć podręczną można ponownie zapełnić w miarę odczytywania danych z oryginalnego magazynu danych, zgodnie ze strategią, taką jak wzorzec Cache-Aside.
Jednak skalowalność systemu może mieć wpływ, jeśli aplikacja wróci do oryginalnego magazynu danych, gdy pamięć podręczna jest tymczasowo niedostępna. Podczas odtwarzania pamięci podręcznej oryginalny magazyn danych może zostać zalany żądaniami danych, co może skutkować przekroczeniem limitu czasu i nieudanymi połączeniami.
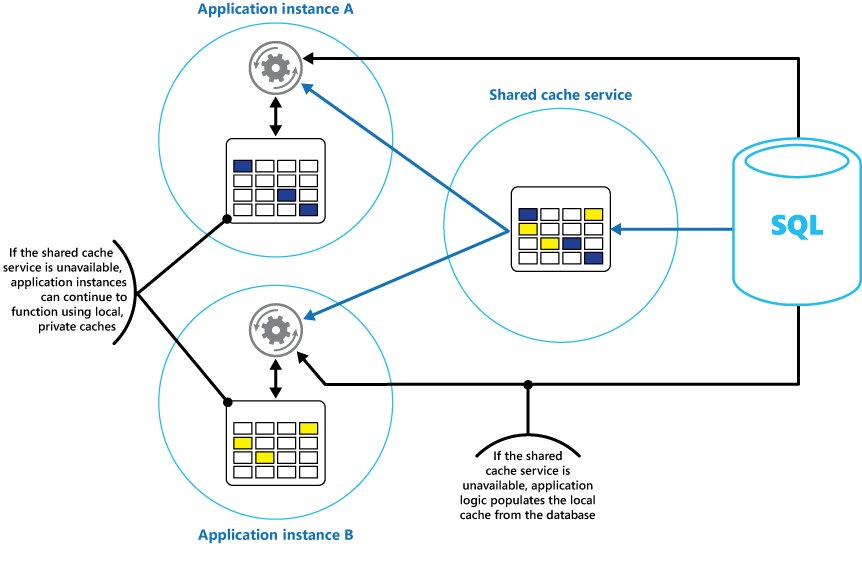
Rozważ zaimplementowanie lokalnej, prywatnej pamięci podręcznej w każdym wystąpieniu aplikacji wraz z udostępnioną pamięcią podręczną dostępną dla wszystkich wystąpień aplikacji. Gdy aplikacja pobiera element, może najpierw sprawdzić w lokalnej pamięci podręcznej, a następnie w udostępnionej pamięci podręcznej, a na koniec w oryginalnym magazynie danych. Lokalna pamięć podręczna może zostać wypełniona przy użyciu danych w udostępnionej pamięci podręcznej lub w bazie danych, jeśli udostępniona pamięć podręczna jest niedostępna.
Takie podejście wymaga starannej konfiguracji, aby zapobiec temu, że lokalna pamięć podręczna stanie się zbyt przestarzała w porównaniu do udostępnionej pamięci podręcznej. Jednak lokalna pamięć podręczna działa jako bufor, jeśli udostępniona pamięć podręczna jest niedostępna, jak pokazano na poniższym diagramie.
Aby obsługiwać duże pamięci podręczne przechowujące stosunkowo długotrwałe dane, niektóre usługi pamięci podręcznej zapewniają opcję wysokiej dostępności, która implementuje automatyczne przełączanie awaryjne, jeśli pamięć podręczna stanie się niedostępna. Takie podejście zwykle polega na replikowaniu buforowanych danych przechowywanych na serwerze podstawowej pamięci podręcznej na pomocniczym serwerze pamięci podręcznej i przełączaniu się na serwer pomocniczy, jeśli serwer podstawowy ulegnie awarii lub zostanie utracona łączność.
Aby zmniejszyć opóźnienie związane z zapisywaniem w wielu miejscach docelowych, replikacja do serwera pomocniczego może wystąpić asynchronicznie, gdy dane są zapisywane w pamięci podręcznej na serwerze podstawowym. Takie podejście prowadzi do możliwości utraty niektórych buforowanych informacji, jeśli wystąpi awaria, ale odsetek tych danych powinien być niewielki w porównaniu z ogólnym rozmiarem pamięci podręcznej.
Jeśli udostępniona pamięć podręczna jest duża, korzystne może być podzielenie buforowanych danych między węzłami w celu zmniejszenia szans rywalizacji i zwiększenia skalowalności. Wiele udostępnionych pamięci podręcznych obsługuje możliwość dynamicznego dodawania i usuwania węzłów oraz ponownego równoważenia danych między partycjami. Takie podejście może obejmować klastrowanie, w którym kolekcja węzłów jest przedstawiana aplikacjom klienckim jako pojedyncza pamięć podręczna. Jednak wewnętrznie dane są rozproszone między węzłami zgodnie ze wstępnie zdefiniowaną strategią dystrybucji, która równoważy obciążenie. Aby uzyskać więcej informacji, zobacz wzorzec fragmentowania.
Klastrowanie może również zwiększyć dostępność pamięci podręcznej. Jeśli węzeł ulegnie awarii, pozostała część pamięci podręcznej będzie nadal dostępna. Klastrowanie jest często używane z replikacją i przełączaniem awaryjnym. Każdy węzeł można replikować, a replika może zostać szybko przełączona do trybu online, jeśli węzeł ulegnie awarii.
Wiele operacji odczytu i zapisu może obejmować pojedyncze wartości danych lub obiekty. Jednak czasami może być konieczne szybkie przechowywanie lub pobieranie dużych ilości danych. Na przykład rozmieszczanie pamięci podręcznej może obejmować zapisywanie setek lub tysięcy elementów w pamięci podręcznej. Aplikacja może również wymagać pobrania dużej liczby powiązanych elementów z pamięci podręcznej w ramach tego samego żądania.
Wiele pamięci podręcznych na dużą skalę zapewnia operacje wsadowe w tych celach. Ta funkcja umożliwia aplikacji klienckiej spakowanie dużej liczby elementów do pojedynczego żądania, co zmniejsza obciążenie związane z wykonywaniem dużej liczby małych żądań.
Buforowanie i spójność docelowa
Aby wzorzec Cache-Aside działał, instancja aplikacji, która uzupełnia pamięć podręczną, musi mieć dostęp do najnowszej i spójnej wersji danych. W systemie, który implementuje spójność ostateczną (na przykład zreplikowany magazyn danych), ten warunek może nie być spełniony.
Jedno wystąpienie aplikacji może zmodyfikować element danych i unieważnić buforowane wersje tego elementu. Inna instancja aplikacji może próbować odczytać ten element z pamięci podręcznej, co skutkuje nietrafieniem pamięci podręcznej. Następnie odczytuje dane z magazynu danych i dodaje je do pamięci podręcznej. Jeśli jednak magazyn danych nie jest w pełni zsynchronizowany z innymi replikami, wystąpienie aplikacji może odczytywać i wypełniać pamięć podręczną starą wartością.
Rozproszona pamięć podręczna wprowadza dodatkową warstwę do tego problemu. Twierdzenie CAP stwierdza, że system rozproszony może zapewnić co najwyżej dwie z trzech gwarancji: spójność, dostępność i tolerancję partycji. Ponieważ partycje sieciowe są nieuniknione w środowiskach chmury, należy wybrać między spójnością a dostępnością. Większość rozproszonych pamięci podręcznych, w tym Redis, priorytetują dostępność i tolerancję partycji ponad silną spójność. Ten priorytet oznacza, że odczyty z repliki pamięci podręcznej mogą zwracać nieaktualne dane podczas partycji sieciowej lub natychmiast po zapisie w innym węźle. Projektując strategię buforowania, zdecyduj, jak duży stopień nieaktualności danych aplikacja może tolerować, i odpowiednio ustaw wartości czasu życia (TTL). W przypadku danych, które muszą być aktualne, użyj krótszych czasów trwania TTL lub pomiń pamięć podręczną w całości i czytaj bezpośrednio z źródłowego magazynu danych.
Aby uzyskać więcej informacji na temat obsługi spójności danych w systemach rozproszonych, zobacz Zagadnienia dotyczące danych dla mikrousług.
Ochrona buforowanych danych
Niezależnie od używanej usługi pamięci podręcznej należy rozważyć sposób ochrony danych w pamięci podręcznej przed nieautoryzowanym dostępem. Istnieją dwa główne kwestie:
- Prywatność danych w pamięci podręcznej.
- Prywatność danych podczas ich przepływu między pamięcią podręczną a aplikacją, która z niej korzysta.
Aby chronić dane w pamięci podręcznej, usługa pamięci podręcznej może zaimplementować mechanizm uwierzytelniania, który wymaga od aplikacji określenia następujących szczegółów:
- Które tożsamości mogą uzyskiwać dostęp do danych w pamięci podręcznej.
- Które operacje odczytu i zapisu te tożsamości mogą wykonywać.
Aby zmniejszyć nakład pracy związany z odczytywaniem i zapisywaniem danych, po udzieleniu tożsamości dostępu do zapisu lub odczytu do pamięci podręcznej ta tożsamość może używać dowolnych danych w pamięci podręcznej.
Jeśli musisz ograniczyć dostęp do podzbiorów buforowanych danych, użyj jednej z następujących metod:
Podziel pamięć podręczną na partycje przy użyciu różnych serwerów pamięci podręcznej. Przyznawaj tożsamościom dostęp tylko do partycji, z których mogą korzystać.
Szyfruj dane w każdym podzestawie przy użyciu różnych kluczy. Podaj klucze szyfrowania tylko tożsamościom, które powinny mieć dostęp do każdego podzestawu. Aplikacja kliencka może nadal mieć możliwość pobrania wszystkich danych w pamięci podręcznej, ale może odszyfrować tylko dane, dla których ma klucze.
Należy również chronić dane, gdy przepływają do i z pamięci podręcznej. Zależy od funkcji zabezpieczeń udostępnianych przez infrastrukturę sieci używaną przez aplikacje klienckie do łączenia się z pamięcią podręczną. Jeśli pamięć podręczna jest implementowana przy użyciu serwera lokalnego w tej samej organizacji, która hostuje aplikacje klienckie, izolacja samej sieci może nie wymagać wykonania dodatkowych kroków. Jeśli pamięć podręczna znajduje się zdalnie i wymaga połączenia TCP lub HTTP za pośrednictwem sieci publicznej, takiej jak Internet, rozważ zaimplementowanie protokołu TLS.
Implementowanie buforowania przy użyciu usługi Azure Managed Redis
W pozostałych sekcjach tego artykułu opisano sposób implementowania wzorców buforowania przy użyciu Azure Managed Redis. Azure Managed Redis to usługa Redis zarządzana przez Azure, której można używać jako wspólnej pamięci podręcznej w wystąpieniach aplikacji. Obsługuje buforowanie klucz-wartość, struktury danych, takie jak zestawy, posortowane zestawy i listy, oraz opcjonalne zachowanie trwałości w przypadku ponownych uruchomień.
Aby uzyskać informacje o dostępnych warstwach, planowaniu pojemności, sieci i szczegółach funkcji, zobacz dokumentację usługi Azure Managed Redis.
Łączenie i konfigurowanie aplikacji klienckich
Usługa Redis obsługuje aplikacje klienckie w wielu językach programowania. W przypadku aplikacji platformy .NET dostępnych jest kilka bibliotek klienckich, z których każda jest odpowiednia dla różnych obciążeń usługi Redis. Wybór biblioteki zależy od tego, czy używasz usługi Redis ściśle jako pamięci podręcznej, czy jako wielomodelowej platformy danych.
Aby nawiązać połączenie z serwerem Redis, użyj metody statycznej ConnectConnectionMultiplexer klasy . Połączenie tworzone przez tę metodę jest tworzone do użycia przez cały okres istnienia aplikacji klienckiej. Wiele współbieżnych wątków może używać tego samego połączenia. Nie nawiązuj i nie zrywaj połączenia przy każdej operacji Redis, ponieważ może to obniżyć wydajność.
Przykłady połączeń dla poszczególnych języków znajdziesz w Use Azure Managed Redis in .NET Core.
Wybieranie biblioteki klienta platformy .NET
W przypadku używania usługi Azure Managed Redis do buforowania użyj następujących bibliotek .NET:
StackExchange.Redis: Klient usługi Redis niskiego poziomu, który zapewnia wysoką wydajność. Użyj go, gdy potrzebujesz bezpośredniego dostępu do poleceń Redis, operacji atomowych, transakcji, potokowania lub skryptowania w Lua.
Microsoft.Extensions.Caching.StackExchangeRedis: Zapewnia integrację
IDistributedCachedla ASP.NET Core. Służy do prostego buforowania wartości klucz-wartość, gdzie wartości są przechowywane jako nieprzezroczyste tablice bajtów. Ta abstrakcja nie uwidacznia zaawansowanych struktur danych usługi Redis.
Te biblioteki udostępniają elementy pierwotne wymagane do tworzenia typowych wzorców buforowania, ale aplikacja musi zaimplementować samą logikę buforowania.
Implementowanie wzorców cache'owania
Najprostszym sposobem użycia usługi Redis do buforowania jest przechowywanie wartości w kluczach przy użyciu modelu klucz-wartość. Wartości mogą być ciągami lub danymi binarnymi o dowolnej długości, dzięki czemu usługa Redis jest odpowiednia do buforowania serializowanych obiektów, danych konfiguracji, stanu sesji lub wstępnie skompilowanych wyników.
Dokładnie zaplanuj przestrzeń kluczy i użyj znaczących (ale nie rozwlekłych) kluczy. Na przykład użyj kluczy strukturalnych, takich jak customer:100 (zamiast tylko 100), aby reprezentować klucz klienta o identyfikatorze 100. Ten schemat umożliwia rozróżnienie między wartościami, które przechowują różne typy danych. Możesz na przykład użyć klucza orders:100 do reprezentowania klucza dla zamówienia o identyfikatorze 100.
Chociaż ciągi są najbardziej typowym podejściem do buforowania, usługa Redis obsługuje bogaty zestaw natywnych typów danych, takich jak skróty, listy, zestawy, zestawy posortowane i strumienie, które umożliwiają bardziej elastyczne wzorce buforowania. Aby uzyskać więcej informacji na temat typów danych usługi Redis, zobacz dokumentację usługi Redis dotyczącą typów danych.
Implementacja wzorca Cache-Aside
Jak opisano w artykule Określanie efektywnego buforowania danych, typowym podejściem jest ładowanie danych do pamięci podręcznej na żądanie. Poniższy przykład najpierw sprawdza cache, pobiera dane ze źródła w przypadku braku, a następnie zapisuje wynik dla kolejnych żądań.
var config = new ConfigurationOptions();
// ... configure endpoint, credentials, TLS, etc.
ConnectionMultiplexer redisHostConnection = ConnectionMultiplexer.Connect(config);
IDatabase cache = redisHostConnection.GetDatabase();

async Task<string> RetrieveItemAsync(string itemKey)
{
    // Attempt to retrieve the item from the Redis cache
    string itemValue = await cache.StringGetAsync(itemKey);

    // If the value returned is null, the item was not found in the cache
    // So retrieve the item from the data source and add it to the cache
    if (itemValue is null)
    {
        itemValue = await GetItemFromDataSourceAsync(itemKey);
        await cache.StringSetAsync(itemKey, itemValue);
    }

    return itemValue;
}
Wykonywanie operacji atomowych i wsadowych
Gdy wielu klientów lub instancji aplikacji współużytkuje pamięć podręczną, należy zapobiec uszkodzeniu danych spowodowanemu współbieżnymi aktualizacjami. Ogólne strategie współbieżności opisano w artykule Zarządzanie współbieżnością w pamięci podręcznej wcześniej w tym artykule. Usługa Redis udostępnia kilka mechanizmów implementujących te strategie.
Atomowe operacje na pojedynczym kluczu: Używaj poleceń do aktualizowania wartości w jednym kroku, eliminując warunki wyścigu, które występują, gdy
GETiSETsą wykonywane oddzielnie.INCR,INCRBY,DECR,DECRBYniepodzielnie zwiększają lub zmniejszają wartość liczbową. W pliku StackExchange.Redis użyj poleceniaIDatabase.StringIncrementAsynciIDatabase.StringDecrementAsync. Te polecenia są przydatne w przypadku liczników, ograniczników szybkości i śledzenia limitów przydziału, w których wielu klientów aktualizuje ten sam klucz jednocześnie.GETSETatomowo ustawia klucz na nową wartość i zwraca poprzednią wartość. W pliku StackExchange.Redis użyj poleceniaIDatabase.StringGetSetAsync:string oldValue = await cache.StringGetSetAsync("data:counter", 0);
Operacje na wielu kluczach:
MGETiMSETumożliwiają odczyt lub zapis wielu wartości tekstowych w jednym cyklu komunikacji, zmniejszając obciążenie sieci, gdy trzeba pracować z kilkoma kluczami jednocześnie. MetodyIDatabase.StringGetAsynciIDatabase.StringSetAsyncsą przeciążone w celu obsługi tej funkcji:// Create a list of key-value pairs var keysAndValues = new KeyValuePair<RedisKey, RedisValue>[] { new("data:key1", "value1"), new("data:key99", "value2"), new("data:key322", "value3") }; // Store the list of key-value pairs in the cache await cache.StringSetAsync(keysAndValues); ... // Find all values that match a list of keys RedisKey[] keys = ["data:key1", "data:key99", "data:key322"]; // Values should contain { "value1", "value2", "value3" } RedisValue[] values = await cache.StringGetAsync(keys);Transakcje (optymistyczna współbieżność): Za pomocą polecenia
WATCHmożna monitorować jeden lub więcej kluczy przed rozpoczęciem transakcji za pomocąMULTI/EXEC. Jeśli zostaną wykryte jakiekolwiek zmiany w obserwowanych kluczach przed rozpoczęciem transakcji, usługa Redis odrzuci transakcję, a klient może ponowić próbę. Biblioteka StackExchange zapewnia obsługę transakcji za pośrednictwem interfejsuITransaction.Tworzysz obiekt
ITransactionza pomocą metodyIDatabase.CreateTransaction. Wywołujesz polecenia na transakcję za pomocą metod dostarczonych przez obiektITransaction.Interfejs
ITransactionzapewnia dostęp do zestawu metod, które są podobne do metod uzyskiwanych przezIDatabaseinterfejs, z tą różnicą, że wszystkie metody są asynchroniczne. Oznacza to, że są wykonywane tylko po wywołaniuITransaction.Executemetody. Wartość zwracana przezITransaction.Executemetodę wskazuje, czy transakcja została utworzona pomyślnie (prawda), czy też zakończyła się niepowodzeniem (false).Poniższy fragment kodu przedstawia przykład, który zwiększa i dekrementuje dwa liczniki w ramach tej samej transakcji:
ITransaction transaction = cache.CreateTransaction();

var tx1 = transaction.StringIncrementAsync("data:counter1");
var tx2 = transaction.StringDecrementAsync("data:counter2");

bool result = await transaction.ExecuteAsync();

Console.WriteLine($"Transaction {(result ? "succeeded" : "failed")}");

if (result)
{
    long increment = await tx1;
    long decrement = await tx2;

    Console.WriteLine($"Result of increment: {increment}");
    Console.WriteLine($"Result of decrement: {decrement}");
}
Transakcje usługi Redis są w przeciwieństwie do transakcji w relacyjnych bazach danych. Metoda
Executekolejkuje wszystkie polecenia, które składają się na transakcję do uruchomienia, a jeśli jakiekolwiek polecenie jest nieprawidłowe, transakcja zostanie zatrzymana. Jeśli wszystkie polecenia są pomyślnie kolejkowane, każde polecenie jest uruchamiane asynchronicznie. Jeśli jakiekolwiek polecenie zakończy się niepowodzeniem, inne nadal kontynuują przetwarzanie. Jeśli musisz sprawdzić, czy polecenie zostało ukończone pomyślnie, pobierz wyniki przy użyciuResultwłaściwości odpowiedniego zadania, jak pokazano w poprzednim przykładzie.Skrypty Lua. W przypadku wieloetapowych aktualizacji, które muszą być atomowe i obejmować wiele kluczy, można uruchomić na serwerze skrypt Lua. Usługa Redis uruchamia cały skrypt jako pojedynczą operację bez przeplatania innych poleceń.
Note
W przypadku wdrożeń klastrowanych wszystkie klucze zaangażowane w transakcję lub skrypt Lua muszą znajdować się w tym samym gnieździe skrótu. Użyj tagów hash, takich jak
customer:{123}:namelubcustomer:{123}:email, aby umieścić powiązane klucze razem.
Wykonuj operacje „fire-and-forget” na pamięci podręcznej
Jeśli aktualizacja pamięci podręcznej nie ma wpływu na poprawność aplikacji, na przykład zwiększanie licznika widoku lub odświeżanie niekrytycznej statystyki, można pominąć oczekiwanie na odpowiedź serwera. W operacji pamięci podręcznej typu fire-and-forget Twoja aplikacja inicjuje zadanie w tle i kontynuuje działanie, nie czekając na jego zakończenie. Redis obsługuje operacje typu „wyślij i zapomnij”, które zmniejszają opóźnienia komunikacji klienta z serwerem, dzięki flagom poleceń:
await cache.StringSetAsync("data:key1", 99);
...
cache.StringIncrement("data:key1", flags: CommandFlags.FireAndForget);
Określanie automatycznie wygasających kluczy
Strategie wygasania opisane w temacie Zarządzanie wygasaniem danych w pamięci podręcznej są implementowane w usłudze Redis za pośrednictwem usługi TTL na każdy klucz. Podczas przechowywania elementu w pamięci podręcznej Redis można określić limit czasu, po którym element zostanie automatycznie usunięty. Możesz również wykonać zapytanie, ile czasu ma klucz przed jego wygaśnięciem TTL , używając polecenia . To polecenie jest dostępne dla aplikacji StackExchange za pośrednictwem IDatabase.KeyTimeToLive metody .
Poniższy fragment kodu pokazuje, jak ustawić czas wygaśnięcia 20 sekund na kluczu i wysłać zapytanie o pozostały okres istnienia klucza:
// Add a key with an expiration time of 20 seconds
await cache.StringSetAsync("data:key1", 99, TimeSpan.FromSeconds(20));
...
// Query how much time a key has left to live
// If the key has already expired, the KeyTimeToLive function returns null
TimeSpan? expiry = cache.KeyTimeToLive("data:key1");
Możesz również ustawić wygaśnięcie na określoną datę i godzinę przy użyciu EXPIREAT polecenia , które jest dostępne w bibliotece StackExchange jako metodę KeyExpireAsync . Przyjmuje parametr DateTime:
await cache.StringSetAsync("data:key1", 99);
await cache.KeyExpireAsync("data:key1",
    new DateTime(2026, 9, 1, 0, 0, 0, DateTimeKind.Utc));
Wskazówka
Element z pamięci podręcznej można usunąć ręcznie przy użyciu DEL polecenia , które jest dostępne za pośrednictwem biblioteki StackExchange jako IDatabase.KeyDeleteAsync metody .
Gdy usługa Redis osiągnie limit pamięci, eksmituje klucze zgodnie ze skonfigurowanymi zasadami eksmisji. Domyślna polityka to volatile-lru, która usuwa najrzadziej używany klucz, który ma ustawiony czas TTL. Inne zasady obejmują allkeys-lru, volatile-randomi noeviction (co powoduje niepowodzenie operacji zapisu, gdy pamięć jest pełna). Wybierz politykę zwalniania na podstawie tego, czy aplikacja konsekwentnie używa TTLs i czy wolisz chronić klucze, które nie mają daty ważności. Aby uzyskać więcej informacji, zobacz Zarządzanie pamięcią.
Krzyżowo skoreluj buforowane elementy
W przypadku buforowania elementów pokrewnych często trzeba je znaleźć według relacji, a nie tylko za pomocą klucza podstawowego. Możesz na przykład buforować wpisy w blogu i odpowiedzieć na zapytania, takie jak "które wpisy udostępniają tag Y?" lub "które tagi należą do wpisu X?"
W usłudze Azure Managed Redis zalecanym podejściem jest użycie RedisJSON i RediSearch. Przechowuj każdy buforowany element jako dokument JSON z jego metadanymi, a następnie utwórz indeks RediSearch dla pól, które chcesz zapytania. Usługa RediSearch obsługuje wyszukiwanie wsteczne, filtrowanie oparte na tagach, zapytania zakresu i wyszukiwanie pełnotekstowe bez konieczności obsługi oddzielnych struktur indeksów przez aplikację.
W przypadku prostszych scenariuszy można również użyć zestawów Redis do ręcznego tworzenia indeksów do przodu i wstecz. Przechowuj zbiór dla każdego wpisu (zawierający jego tagi) oraz zbiór dla każdego tagu (zawierający identyfikatory wpisów):
foreach (BlogPost post in posts)
{
    string postTagsKey = $"blog:posts:{post.Id}:tags";
    await cache.SetAddAsync(
        postTagsKey, post.Tags.Select(s => (RedisValue)s).ToArray());

    foreach (var tag in post.Tags)
    {
        await cache.SetAddAsync($"tag:{tag}:blog:posts", post.Id);
    }
}
Następnie można wykonywać zapytania o tagi dla wpisu przy użyciu polecenia SetMembersAsync, znajdować wspólne tagi między wpisami przy użyciu polecenia SetCombineAsync(SetOperation.Intersect, ...)lub znajdować wszystkie wpisy dla danego tagu. Kompromis polega na tym, że aplikacja musi utrzymywać zarówno zbiory powiązań w przód, jak i wstecz, co zwiększa złożoność wraz ze wzrostem liczby relacji.
Znajdowanie ostatnio używanych elementów
Wiele aplikacji musi śledzić ostatnio dostępne lub wyświetlane elementy. Na przykład witryna blogowania może wyświetlać ostatnio odczytywane wpisy do powracającego gościa. Listy Redis zapewniają wydajny sposób implementowania wzorców buforowania opartego na recencyjności. Elementy można dodawać na dowolnym końcu listy przy użyciu LPUSH lub RPUSH, a usuwać przy użyciu LPOP lub RPOP. Użyj polecenia LTRIM , aby ograniczyć długość listy i zapobiec niezwiązanym wzrostom pamięci.
Zaimplementować tabelę wyników
Zestawy sortowane redis (ZSETs) utrzymują uporządkowane rankingi, kojarząc każdy element z wynikiem liczbowym. Redis automatycznie zachowuje kolejność.
ZADD ma złożoność O(log N), a zapytania o zakres, takie jak ZRANGE i ZREVRANGE, mają złożoność O(log N + M), gdzie M to liczba zwracanych elementów, więc zbiory sortowane pozostają wydajne nawet przy dużej liczbie elementów.
Dodawanie elementów do rankingu
W poniższym przykładzie pokazano, jak dodać wpis na blogu oraz jego wynik do tablicy wyników za pomocą polecenia ZADD przez SortedSetAddAsync:
var db = connection.GetDatabase();
string redisKey = "blog:post_rankings";

BlogPost blogPost = ...; // The blog post being ranked

await db.SortedSetAddAsync(redisKey, blogPost.Title, blogPost.Score);
Pobieranie elementów sklasyfikowanych
Elementy w kolejności rosnącej oceny można pobrać przy użyciu polecenia SortedSetRangeByRankWithScoresAsync:
var entries = await db.SortedSetRangeByRankWithScoresAsync(redisKey);

foreach (var entry in entries)
{
    Console.WriteLine($"{entry.Element}: {entry.Score}");
}
Note
SortedSetRangeByRankAsync zwraca tylko wartości członkowskie, a nie oceny.
Pobierz pierwsze N elementów
Aby uzyskać najwyżej oceniane elementy, takie jak 10 pierwszych wpisów, użyj kolejności malejącej:
foreach (var post in await cache.SortedSetRangeByRankWithScoresAsync(
                               redisKey, 0, 9, Order.Descending))
{
    Console.WriteLine(post);
}
Pobieranie elementów według zakresu wyników
Możesz również wykonywać zapytania dotyczące elementów na podstawie granic wyników, a nie rangi:
foreach (var post in await cache.SortedSetRangeByScoreWithScoresAsync(
                               redisKey, 5000, 100000))
{
    Console.WriteLine(post);
}
Aby zapobiec nieograniczonemu rozrastaniu się rankingu, usuwaj stare wpisy za pomocą SortedSetRemoveRangeByRankAsync lub używaj kluczy ograniczonych czasowo (na przykład dla rankingów dziennych lub tygodniowych). Możesz aktualizować wyniki atomowo, używając SortedSetIncrementAsync (ZINCRBY).
Buforuj stan sesji i dane wyjściowe HTML
Za pomocą usługi Azure Managed Redis można przechowywać dane stanu sesji i wyjściowej pamięci podręcznej dla aplikacji ASP.NET Core i ASP.NET. Gdy przechowujesz dane sesji i renderowane wyniki we współdzielonej pamięci podręcznej opartej na Redis, aplikacje działające w wielu wystąpieniach, na przykład w Azure App Service, Azure Kubernetes Service (AKS), Azure Container Apps lub w zestawach skalowania maszyn wirtualnych, mogą zapewniać spójne doświadczenia użytkowników bez konieczności stosowania koligacji sesji.
Wskazówka
Aby uzyskać najlepszą wydajność, wdróż aplikację i wystąpienie usługi Azure Managed Redis w tym samym regionie świadczenia usługi Azure.
ASP.NET Core
Aplikacje ASP.NET Core używają abstrakcji IDistributedCache oraz oprogramowania pośredniczącego sesji. Usługa Azure Managed Redis integruje się z IDistributedCache za pomocą pakietu Microsoft.Extensions.Caching.StackExchangeRedis.
builder.Services.AddStackExchangeRedisCache(options =>
{
    options.Configuration = "<your-cache-name>.<region>.redis.azure.net:10000";
    options.InstanceName = "app-cache:";
});

builder.Services.AddSession();
Oprogramowanie pośredniczące pamięci podręcznej danych wyjściowych w ASP.NET Core może również używać rozwiązania Redis jako rozproszonego magazynu bazowego, umożliwiając aplikacjom udostępnianie renderowanych fragmentów lub stron między wszystkimi wystąpieniami. Aby uzyskać więcej informacji, zobacz dostawcę pamięci podręcznej wyjściowej ASP.NET Core dla Redis.
Integracja platformy .NET Aspire
Aplikacje .NET Aspire mogą używać Aspire.Hosting.Azure.Redis pakietu do deklarowania zasobu usługi Azure Managed Redis na hoście aplikacji. Projekty korzystające automatycznie otrzymują konfigurację połączenia poprzez wstrzykiwanie zależności, co eliminuje ręczne zarządzanie ciągiem połączenia między usługami.
// App host: declare the Azure Managed Redis resource
var cache = builder.AddAzureManagedRedis("cache");

builder.AddProject<Projects.ProductService>()
    .WithReference(cache);
Korzystanie z usług rejestruje rozproszoną pamięć podręczną w taki sam sposób jak każdy inny IDistributedCache dostawca. Aby uzyskać więcej informacji, zobacz Wprowadzenie do integracji z usługą Redis.
Wysoka dostępność, skalowalność i partycjonowanie
Każde wystąpienie usługi Azure Managed Redis wykorzystuje replikację podstawowych/zapasowych serwerów. Usługa monitoruje kondycję węzła i automatycznie promuje replikę w przypadku awarii podstawowej. Ponieważ replikacja jest asynchroniczna, podczas nieoczekiwanego przejścia w tryb failover można utracić niewielką ilość ostatnio zapisanych danych. Ogólne strategie związane z replikacją, trybem failover i buforowaniem warstwowym można znaleźć w temacie Implementowanie wysokiej dostępności i skalowalności oraz zwiększanie wydajności we wcześniejszej sekcji tego artykułu.
Możesz połączyć lokalną pamięć podręczną w pamięci z usługą Azure Managed Redis, aby zmniejszyć opóźnienie i zapewnić rezerwę, jeśli udostępniona pamięć podręczna jest tymczasowo niedostępna. Wzorce Circuit-Breaker i Cache-Aside pomagają w zarządzaniu tym wielowarstwowym podejściem.
W przypadku obciążeń przekraczających pojemność jednego węzła usługa Azure Managed Redis obsługuje partycjonowanie (dzielenie na fragmenty) danych w wielu węzłach usługi Redis. W przypadku obu zasad klastrowania dane są automatycznie dzielone na fragmenty między węzłami za pomocą haszowania kluczy do fragmentów, z automatycznym przełączaniem awaryjnym i resynchronizacją oraz redystrybucją fragmentów w trybie online (zwiększaniem i zmniejszaniem liczby węzłów). Usługa Azure Managed Redis obsługuje dwie zasady klastrowania:
Zasady klastrowania OSS (ustawienie domyślne): Klienci komunikują się bezpośrednio z odpowiednim shardem i postępują zgodnie z semantyką klastra Redis OSS, w tym przekierowaniami MOVED i ASK. Klienci obsługujący klaster, tacy jak StackExchange.Redis, automatycznie obsługują te przekierowania. Ta zasada zapewnia najmniejsze obciążenie związane z routingu.
Zasady klastrowania Redis Enterprise: Serwer proxy zapewnia przezroczysty routing za pośrednictwem jednego punktu końcowego. Klienci nie muszą implementować logiki obsługującej klaster ani obsługiwać odpowiedzi MOVED/ASK. Te zasady oferują prostszą integrację klienta, ale wprowadza niewielką ilość obciążeń związanych z routingiem.
Usługa Azure Managed Redis obsługuje również tryb nieklastrowany, który używa pojedynczej pary podstawowa–replika bez shardingu. Ten tryb jest odpowiedni dla mniejszych obciążeń, które nie wymagają skalowania w poziomie.
Note
Niestandardowe modele partycjonowania, takie jak haszowanie po stronie klienta lub serwery proxy inne niż firmy Microsoft, są zazwyczaj potrzebne tylko w samodzielnie zarządzanych wdrożeniach Redis na maszynach wirtualnych lub na platformie Kubernetes. Klaster usługi Azure Managed Redis obsługuje routing, tryb failover i automatyczne dzielenie na fragmenty.
Aktywna replikacja geograficzna
W przypadku dostępności w wielu regionach usługa Azure Managed Redis obsługuje aktywną replikację geograficzną, która łączy wystąpienia między regionami Azure w jedną grupę replikacji. Każde wystąpienie może obsługiwać operacje odczytu i zapisu oraz automatycznie synchronizować zmiany. Aplikacja jest odpowiedzialna za przekierowywanie ruchu do sprawnego wystąpienia podczas błędu w regionie. Aby uzyskać więcej informacji, zobacz Konfigurowanie aktywnej replikacji geograficznej.
Stan trwały danych
Domyślnie buforowane dane w usłudze Azure Managed Redis są przechowywane w pamięci i mogą zostać utracone w przypadku ponownego uruchomienia węzła lub trybu failover. W przypadku obciążeń, w których odbudowa cache'u ze źródłowego magazynu danych będzie powolna lub kosztowna, Azure Managed Redis oferuje opcjonalną funkcję trwałości danych.
Migawki RDB (bazy danych Redis) tworzą okresowe migawki stanu z określonego momentu, zapisywane na dysku zarządzanym. Baza danych RDB ma minimalny wpływ na wydajność podczas normalnych operacji, ale dane zapisane od ostatniej migawki mogą zostać utracone.
AOF (Append-Only File) rejestruje każdą operację zapisu na dysku. AOF zmniejsza potencjalną utratę danych do około jednej sekundy zapisów, ale generuje większe pliki i może zmniejszyć przepływność zapisu.
Można używać zarówno bazy danych RDB, jak i AOF razem. Redis ładuje migawkę RDB podczas uruchamiania, a następnie odtwarza dziennik AOF, aby niemal całkowicie odzyskać dane.
Important
Trwałość danych zwiększa odporność na awarie węzłów, ale nie jest mechanizmem tworzenia kopii zapasowych ani odtwarzania po awarii. W przypadku danych krytycznych zawsze utrzymuj autorytatywną wersję danych w źródłowym magazynie danych i użyj wzorca Cache-Aside, aby ponownie zapełniać pamięć podręczną.
Aby uzyskać szczegółowe informacje o konfiguracji, zobacz Konfigurowanie trwałości danych.
Ochrona danych buforowanych w usłudze Azure Managed Redis
Wskazówki zawarte w artykule Ochrona danych w pamięci podręcznej opisują kwestie związane z kontrolą dostępu i tranzytem danych. Usługa Azure Managed Redis pomaga rozwiązać te kwestie na następujące sposoby:
Użyj uwierzytelniania Microsoft Entra ID jako podstawowego mechanizmu kontroli dostępu i postępuj zgodnie z zasadą najmniejszych uprawnień podczas udzielania dostępu.
Użyj prywatnych punktów końcowych , aby ograniczyć dostęp do sieci, aby ruch nie przechodził przez publiczny Internet.
Usługa Azure Managed Redis szyfruje dane podczas przesyłania przy użyciu protokołu TLS oraz dane w spoczynku.
Zagadnienia dotyczące serializacji
W przypadku przechowywania obiektów platformy .NET w usłudze Redis jako wartości ciągu należy je serializować. Po wybraniu formatu serializacji rozważ kompromis między wydajnością, współdziałaniem, przechowywaniem wersji i rozmiarem ładunku. Nie ma jednego najszybszego serializatora dla wszystkich scenariuszy. Testy porównawcze są bardzo zależne od kontekstu i mogą nie odzwierciedlać rzeczywistego obciążenia.
Jeśli warstwa Azure Managed Redis obsługuje format RedisJSON, można przechowywać obiekty jako natywne dokumenty JSON i wykonywać zapytania dotyczące poszczególnych pól bez deserializacji całej wartości:
public static class RedisJsonExtensions
{
    public static async Task<T?> GetAsync<T>(
        this IDatabase cache,
        string key,
        string path = "$")
    {
        var result = await cache.ExecuteAsync("JSON.GET", key, path);

        if (result.IsNull)
            return default;

        return JsonSerializer.Deserialize<T>(result!);
    }

    public static async Task SetAsync<T>(
        this IDatabase cache,
        string key,
        T value,
        TimeSpan? expiry = null,
        string path = "$")
    {
        var json = JsonSerializer.Serialize(value);

        // Store JSON document
        await cache.ExecuteAsync("JSON.SET", key, path, json);

        // Apply TTL if provided
        if (expiry.HasValue)
        {
            await cache.KeyExpireAsync(key, expiry);
        }
    }

    public static async Task<bool> ExpireAsync(
        this IDatabase cache,
        string key,
        TimeSpan expiry)
    {
        return await cache.KeyExpireAsync(key, expiry);
    }
}
W przypadku serializacji wartości jako ciągów Redis typowe opcje formatowania obejmują:
JSON — format czytelny dla człowieka, który ma szeroką obsługę międzyplatformową. Nie jest to najbardziej kompaktowy format, ale dobry wybór, gdy buforowane elementy są zwracane bezpośrednio do klientów HTTP, ponieważ pozwala uniknąć dodatkowego kroku deserializacji i ponownej synchronizacji.
MessagePack — kompaktowy format binarny, który nie ma wymagania dotyczącego schematu. Generuje mniejsze ładunki niż JSON z niższym obciążeniem serializacji.
Bufory protokołu (protobuf) — oparty na schemacie format binarny, który generuje kompaktowe ładunki. Wymaga
.protoplików definicji i kroku kompilacji w celu wygenerowania kodu specyficznego dla języka.BSON — format binarny, który rozszerza dane JSON o więcej typów, takich jak daty i nieprzetworzone dane binarne. Ładunki są porównywalne wielkością do JSON. Praktyczny wybór, gdy aplikacja używa już kodu BSON w innym miejscu, na przykład z bazą danych MongoDB.
Powiązane zasoby
- Dokumentacja usługi Azure Managed Redis
- Azure Managed Redis — często zadawane pytania
- Dokumentacja usługi Redis
- StackExchange.Redis
Podczas implementowania buforowania w aplikacjach mogą być istotne następujące wzorce:
Wzorzec Cache-Aside: Ten wzorzec opisuje sposób ładowania danych na żądanie z magazynu danych do pamięci podręcznej. Pomaga również zachować spójność danych w pamięci podręcznej i danych w oryginalnym magazynie danych.
Wzorzec fragmentowania: ten wzorzec zawiera informacje na temat implementowania partycjonowania poziomego w celu zwiększenia skalowalności podczas przechowywania i uzyskiwania dostępu do dużych ilości danych.