Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Tworzenie i obsługa oddzielnych tabel odnośników dla danych, które aplikacje często używają w zapytaniach, gdy magazyn danych nie udostępnia odpowiednich indeksów pomocniczych. Takie podejście zwiększa wydajność odczytu, unikając pełnego skanowania danych, gdy zapytania nie używają klucza podstawowego ani klucza partycji.
Kontekst i problem
Wiele magazynów danych organizuje dane dla kolekcji jednostek przy użyciu klucza podstawowego. Aplikacja może użyć tego klucza w celu zlokalizowania i pobrania danych. Na poniższej ilustracji przedstawiono przykład magazynu danych przechowującego informacje o kliencie zorganizowane według klucza podstawowego, identyfikatora klienta.
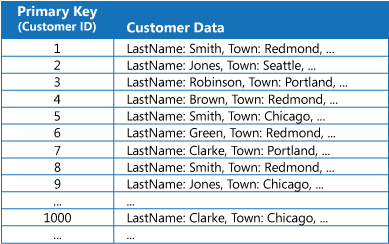
Obraz przedstawia dwukolumną tabelę rekordów klientów. Pierwsza kolumna Primary Key (Customer ID) zawiera identyfikatory klientów od 1 do 9, a następnie wielokropek, identyfikator 1000 i kolejny wielokropek. Druga kolumna Dane klienta zawiera dane klienta składające się z nazwiska i miejscowości, po której następuje wielokropek. Widoczne przykłady obejmują identyfikator 1, który mapuje na nazwisko Smith i miasto Redmond oraz identyfikator 2, który mapuje na nazwisko Jones i miasto Seattle. Kolejny wiersz przedstawia Smitha w Chicago, a następny — Smitha w Redmond. Kolejny wiersz przedstawia Jonesa w Chicago.
Mimo że klucz podstawowy jest przydatny w przypadku zapytań pobierających dane na podstawie wartości tego klucza, aplikacja, która musi pobierać dane na podstawie innego pola, nie może użyć klucza podstawowego dla tego zapytania. W przykładzie z klientami aplikacja nie może pobrać danych o klientach przy użyciu klucza podstawowego Identyfikator klienta, jeśli zapytanie odwołuje się wyłącznie do wartości innego atrybutu, takiego jak miejscowość zamieszkania klienta. Aby wykonać zapytanie, które odwołuje się tylko do miasta, może być konieczne pobranie i sprawdzenie każdego rekordu klienta, co może być powolnym procesem.
Wiele systemów zarządzania relacyjnymi bazami danych obsługuje indeksy pomocnicze. Indeks pomocniczy to oddzielna struktura danych zorganizowana przez co najmniej jedno pole klucza innego niż podstawowe (pomocnicze). Indeks pomocniczy wskazuje, gdzie są przechowywane dane dla każdej indeksowanej wartości. Elementy w indeksie pomocniczym zwykle są sortowane według wartości kluczy pomocniczych w celu umożliwienia szybkiego wyszukiwania danych. System zarządzania bazami danych zwykle automatycznie utrzymuje te indeksy.
Relacyjne bazy danych umożliwiają obsługę różnych wzorców zapytań dla wielu indeksów pomocniczych. Na przykład w tabeli Customers w relacyjnej bazie danych, w której identyfikator klienta jest kluczem podstawowym, korzystne jest dodanie indeksu pomocniczego do pola Miasto, jeśli aplikacja często wyszukuje klientów w mieście, w którym się znajdują.
Mimo że indeksy pomocnicze są wspólne w systemach relacyjnych, nie wszystkie magazyny danych zapewniają równoważną funkcję. Niektóre magazyny danych nie mają indeksów pomocniczych, a inne udostępniają indeksy, które nie spełniają wymagań dotyczących zapytania, partycjonowania ani wydajności obciążenia. W takich przypadkach aplikacje muszą wybierać między pełnymi skanowaniami a ręcznym zarządzaniem indeksem.
Rozwiązanie
Utwórz tabelę indeksów, która organizuje dane według określonego klucza. W poniższej sekcji opisano trzy typowe strategie tworzenia struktury tabeli indeksów. W dwóch kolejnych sekcjach opisano użycie tabel indeksów w określonych scenariuszach.
Standardowe strategie strukturyzowania
Poniższe strategie są często używane do tworzenia struktury tabeli indeksów. Wybierz strategię opartą na liczbie indeksów pomocniczych, których wymaga twój scenariusz, oraz charakter zapytań, które wykonuje aplikacja.
Kompletna denormalizacja
Kompletna denormalizacja duplikuje dane w każdej tabeli indeksów, ale organizuje je według kluczy innych niż klucz podstawowy. Na poniższej ilustracji przedstawiono tabele indeksowe, które porządkują te same informacje o klientach według pól Town (Miasto) i LastName (Nazwisko).
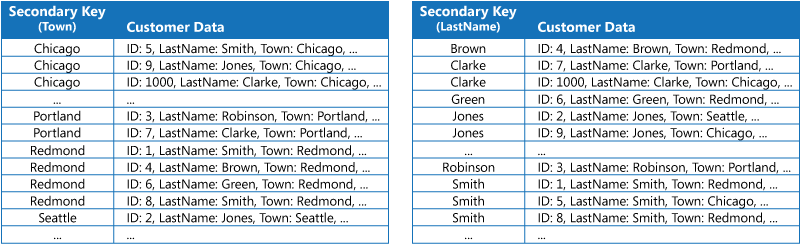
Ta strategia działa dobrze w przypadku obciążeń wymagających odczytu, w których dane zmieniają się rzadko. Wraz ze wzrostem szybkości aktualizacji obsługa każdej kopii dodaje obciążenie związane z przetwarzaniem (zobacz Złożoność spójności). W przypadku zestawów danych o dużej ilości przechowywanie kopii może również wymagać znacznego miejsca.
Znormalizowany indeks
Znormalizowana tabela indeksów organizuje dane według kluczy innych niż klucz podstawowy. Znormalizowana tabela indeksów odwołuje się do oryginalnych danych przy użyciu klucza podstawowego, a nie duplikowania tych danych, jak pokazano na poniższym rysunku. Dane oryginalne są nazywane tabelą faktów.
Tip
W tym miejscu tabela faktów oznacza autorytatywną tabelę źródłową przywołyną przez indeks. Nie oznacza to modelu danych wymiarowych.
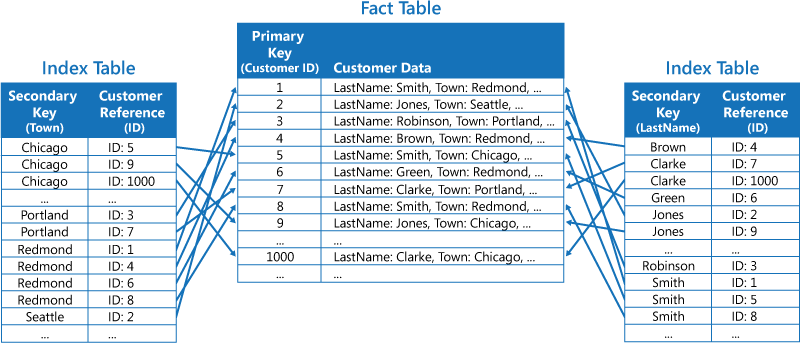
Ta technika pozwala zaoszczędzić miejsce i obniżyć koszty związane z obsługą zduplikowanych danych. Wadą jest to, że aplikacja musi wykonywać dwie operacje wyszukiwania, aby znaleźć dane przy użyciu klucza pomocniczego. Aplikacja musi znaleźć klucz podstawowy dla danych w tabeli indeksów, a następnie użyć klucza podstawowego, aby wyszukać dane w tabeli faktów.
Częściowa denormalizacja
Częściowa denormalizacja tworzy tabele indeksów, które duplikują często pobierane pola i są uporządkowane według kluczy innych niż klucz podstawowy. Tabela faktów jest używana w celu uzyskania dostępu do rzadziej używanych pól. Na poniższej ilustracji pokazano, jak często używane dane są duplikowane w każdej tabeli indeksów.
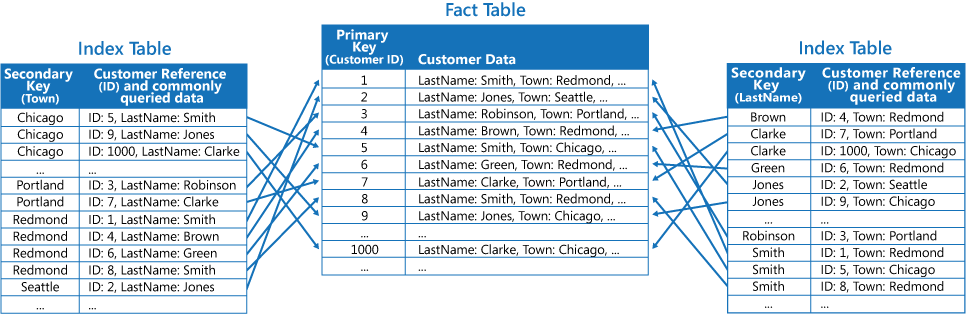
Ta strategia równoważy dwa pierwsze podejścia. Możesz szybko pobierać dane dla typowych zapytań przy użyciu jednego wyszukiwania, podczas gdy obciążenie związane z przestrzenią i konserwacją nie jest tak istotne, jak duplikowanie całego zestawu danych.
Klucze złożone
Niektóre aplikacje często wysyłają zapytania o dane, określając kombinację wartości, na przykład "Znajdź wszystkich klientów, którzy mieszkają w Redmond i mają nazwisko Smitha". W takiej sytuacji utwórz klucze indeksu na podstawie wielu atrybutów, takich jak Town i LastName w tym przypadku.
Użyj kodowania, które zachowuje granice składników, aby różne kombinacje wartości nie mogły wygenerować tego samego klucza. Jeśli zapytania zależą od kolejności kluczy, upewnij się również, że kodowanie zachowuje wymaganą kolejność sortowania w ramach reguł sortowania klucza magazynu danych.
Na poniższej ilustracji przedstawiono tabelę indeksów opartą na kluczach złożonych. Klucze są sortowane według pola Miejscowość, a następnie według pola Nazwisko dla rekordów, które mają tę samą wartość w polu Miejscowość.
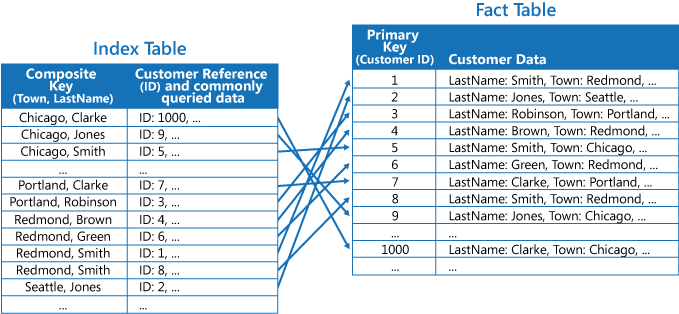
Diagram zawiera tabelę indeksów po lewej stronie i tabelę faktów po prawej stronie. Tabela faktów organizuje dane klienta według klucza podstawowego, identyfikatora klienta. Każdy wiersz Dane klienta zawiera nazwisko klienta, miasto i wielokropek wskazujący inne dane. Tabela indeksów jest zorganizowana za pomocą klucza złożonego, który łączy miasto i nazwisko. Druga kolumna, Customer Reference (ID) i często odpytywane dane, zawiera identyfikator klienta i wielokropek. Strzałki prowadzą od wierszy tabeli indeksowej do tabeli faktów, przy czym każda strzałka wskazuje wiersz identyfikatora klienta, do którego odwołuje się dany wpis indeksu. Krzyżujące się strzałki ilustrują, że wpisy uporządkowane według klucza złożonego mogą odwoływać się do wierszy klienta na różnych pozycjach w tabeli faktów.
Tabele indeksów dla danych shardowanych
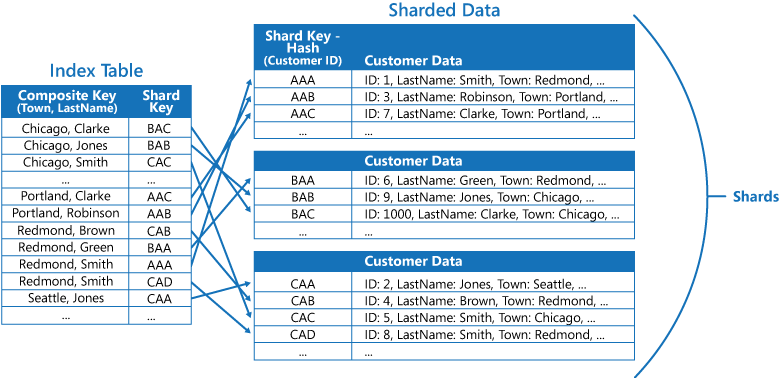
Tabele indeksów mogą przyspieszyć operacje zapytań na danych podzielonych na fragmenty. Są szczególnie przydatne, gdy klucz podziału jest haszowany. Na poniższej ilustracji przedstawiono przykład, w którym klucz fragmentu jest skrótem identyfikatora klienta. Tabela indeksów organizuje wpisy według niehaszowanych wartości Town i LastName oraz przechowuje przy każdym wpisie odpowiadający mu zhaszowany klucz fragmentacji.
Ten układ umożliwia wyszukiwanie zakresowe i uporządkowane dla wartości niehaszowanych, a jednocześnie zapewnia informacje o trasowaniu potrzebne do pobrania każdego rekordu z właściwego fragmentu. Na przykład zapytanie, takie jak "Znajdź wszystkich klientów mieszkających w Redmond", może zlokalizować pasujące elementy w ciągłym bloku w tabeli indeksów. Następnie aplikacja podąża za odwołaniami do danych klienta, używając kluczy fragmentacji przechowywanych w tabeli indeksowej.
Problemy i zagadnienia
Podczas podejmowania decyzji o zaimplementowaniu tego wzorca należy wziąć pod uwagę następujące kwestie:
Koszty konserwacji. Utrzymywanie indeksów pomocniczych może zwiększyć znaczne obciążenie. Przeanalizuj i zapoznaj się z zapytaniami używanymi przez aplikację. Twórz tabele indeksów tylko wtedy, gdy prawdopodobnie będą używane regularnie. Nie twórz tabel indeksów spekulacyjnych w celu obsługi zapytań, które aplikacja nie wykonuje ani nie wykonuje tylko od czasu do czasu. Wraz ze wzrostem liczby wzorców zapytań liczba tabel indeksów rośnie, a każdy z nich dodaje obszar powierzchni operacyjnej do monitorowania, konserwacji i debugowania. Rozważ korzyści z zapytania dla każdej tabeli indeksów względem kosztów operacyjnych utrzymania innej pochodnej struktury danych. Okresowo przeglądaj istniejące tabele indeksów, aby zidentyfikować i usunąć wszystkie, które nie są już odpytywane.
Koszt magazynowania i przepływności. Duplikowanie danych w tabeli indeksów zwiększa koszty magazynowania proporcjonalnie do liczby tabel indeksów i rozmiaru skopiowanych pól. Obsługa wielu kopii danych również zwiększa nakład pracy. Każdy zapis do tabeli indeksów zużywa przepustowość, na przykład w postaci transakcji wliczanych do limitów konta magazynu w usłudze Azure Table Storage lub jednostek żądań w usłudze Azure Cosmos DB. Koszt nie ogranicza się do pamięci masowej, ale obejmuje także przepustowość zapisu.
Podwójna kara za wyszukiwanie. Zaimplementowanie tabeli indeksów jako znormalizowanej struktury, która odwołuje się do danych oryginalnych, wymaga od aplikacji wykonania dwóch operacji wyszukiwania w celu odnalezienia danych. Pierwsza operacja przeszukuje tabelę indeksów w celu pobrania klucza podstawowego, a druga pobiera dane przy użyciu tego klucza podstawowego.
Złożoność zapewnienia spójności Jeśli system zawiera wiele tabel indeksów dla dużych zestawów danych, utrzymanie spójności między tabelami indeksów a oryginalnymi danymi może być trudne. Jeśli nie można zaktualizować wpisów danych źródłowych i indeksu w tej samej transakcji, zaprojektuj aplikację wokół modelu spójności ostatecznej. Trwale zarejestruj każdą zmianę w źródle, zanim potwierdzisz operację zapisu. Na przykład korzystaj z kanału zmian w bazie danych, użyj wzorca Transactional Outbox, aby zapisać rekord w tabeli outbox w tej samej transakcji co zmiana w danych źródłowych, lub umieść polecenie w kolejce przed zmianą danych źródłowych. W podejściu opartym na poleceniach użyj modułu roboczego do przetwarzania polecenia i aktualizowania danych źródłowych oraz ich indeksów. Nie aktualizuj danych źródłowych, a następnie niezależnie publikuj komunikat o aktualizacji indeksu, ponieważ niepowodzenie między tymi operacjami może pozostawić indeks nieaktualny.
Zaprojektuj odbiorcę asynchronicznego tak, aby był idempotentny, ponieważ dostarczanie komunikatów i ponawianie prób może spowodować uruchomienie tej samej aktualizacji więcej niż raz. Aktualizacje tego samego rekordu źródłowego mogą również docierać w niewłaściwej kolejności. Dołącz wersję źródłową lub numer sekwencji w każdej aktualizacji indeksu i zastosuj aktualizację tylko wtedy, gdy jest nowsza niż wersja w indeksie. W przypadku operacji usuwania zachowaj wersjonowany znacznik usunięcia lub równoważną górną granicę wersji, aby opóźniona, starsza aktualizacja nie mogła ponownie utworzyć usuniętego wpisu w indeksie. W okresie między zapisem danych źródłowych a asynchroniczną aktualizacją indeksu zapytania kierowane do tabeli indeksu mogą zwracać nieaktualne odwołania do rekordów, które zostały zaktualizowane lub usunięte w danych źródłowych, a także pomijać niedawno dodane rekordy.
Partycjonowanie tabel indeksów. Tabele indeksów mogą być partycjonowane lub podzielone na fragmenty, co zwiększa złożoność routingu zapytań i wymaga strategii partycjonowania w celu dopasowania do wzorców zapytań, które indeks jest przeznaczony do obsługi.
Kiedy należy używać tego wzorca
Tego wzorca należy używać, gdy aplikacja często musi pobierać dane przy użyciu klucza innego niż klucz podstawowy (lub fragment), a magazyn danych nie obsługuje natywnie indeksów pomocniczych lub jego natywnych indeksów nie spełnia wymagań dotyczących zapytania, partycjonowania ani wydajności obciążenia.
Ten wzorzec może nie być odpowiedni w następujących przypadkach:
Dane są ulotne. Dane zmieniają się tak często, że szybkość zapisu przekracza szybkość, z jaką tabele indeksów mogą być odświeżane asynchronicznie. Okres nieaktualności wydłuża się, aż indeks stanie się trwale nieaktualny, przez co staje się nieskuteczny, a narzut związany z pamięcią masową i przepustowością wynikający z utrzymywania tabeli indeksu przewyższa wszelkie oszczędności wynikające z zapytań.
Masz niedyskryminujące klucze. Pole wybrane jako klucz pomocniczy dla tabeli indeksu jest niedyskryminujące i może zawierać tylko niewielki zestaw wartości (na przykład pole logiczne, które rejestruje, czy element jest aktywny). Tabela indeksów wiąże się z pełnym kosztem magazynowania i przepływności, ale zapewnia minimalną selektywność zapytań.
Wartości danych mają niesymetryczny rozkład. Równowaga wartości danych dla pola wybranego jako klucz pomocniczy dla tabeli indeksów jest wysoce niesymetryczna. Jeśli na przykład 90 procent rekordów zawiera tę samą wartość w polu, utworzenie i utrzymanie tabeli indeksów w celu wyszukania danych na podstawie tego pola może spowodować zwiększenie obciążenia niż sekwencyjnie skanowanie danych. Jeśli jednak zapytania często dotyczą wartości docelowych, które znajdują się w pozostałych 10 procentach, ten indeks nadal może być przydatny.
Projektowanie obciążenia pracy
Architekt powinien ocenić, jak zastosować wzorzec tabeli indeksowej w projekcie obciążenia roboczego, aby uwzględnić cele i zasady omówione w filarach platformy Azure Well-Architected Framework. Poniższa tabela zawiera wskazówki dotyczące tego, jak ten wzorzec obsługuje cele poszczególnych filarów.
| Filar | Jak ten wzorzec obsługuje cele filaru |
|---|---|
| Niezawodność pomaga obciążeniu roboczemu osiągnąć założone cele w zakresie odporności i odzyskiwania po awarii, dzięki tworzeniu nadmiarowości i zachowaniu funkcjonalności podczas awarii. | Konserwacja indeksu asynchronicznego może uniemożliwić tymczasowe błędy aktualizacji indeksu blokujące zapisy danych źródłowych. Przetwarzanie idempotentne, obsługa komunikatów błędnych, monitorowanie i rekonsyliacja pomagają przywrócić spójność indeksu po awariach. - RE:07 Instynkt samozachowawczy - MONITOROWANIE RE:10 |
| Efektywność wydajności pomaga wydajnie sprostać wymaganiom dzięki optymalizacjom skalowania, danych i kodu. | Tabele indeksów ułatwiają szybkie wyszukiwanie w polach kluczy innych niż podstawowe bez konieczności pełnego skanowania danych. W przypadku partycjonowanych magazynów danych tabele indeksów mogą organizować wpisy według wartości niehaszowanych, aby obsługiwać zapytania zakresowe i sortujące, których sam klucz shardu nie jest w stanie wydajnie obsłużyć. - PE:05 Skalowanie i partycjonowanie - PE:08 Wydajność danych |
Podobnie jak w przypadku każdej decyzji projektowej, jeśli ten wzorzec wprowadza kompromisy w ramach filaru, należy wziąć pod uwagę je przed celami innych filarów.
Example
Rozważmy aplikację, która przechowuje informacje o filmach. Załóżmy, że katalog jest duży i z przewagą operacji odczytu, każdy film ma jeden główny gatunek, zapytania dotyczące aktorów są częste, dane o obsadzie zmieniają się rzadko, a niewielkie opóźnienie aktualizacji indeksu jest dopuszczalne. Usługa Table Storage przechowuje każdą jednostkę jako ustrukturyzowany zestaw nazwanych właściwości. Każda encja zawiera PartitionKey, RowKey i znacznik czasu, a encje w tej samej tabeli mogą mieć różne zestawy właściwości.
Usługa Table Storage używa złożonego klucza podstawowego, który składa się z elementów PartitionKey i RowKey. Wartość PartitionKey określa partycję, w której jest przechowywana jednostka. W ramach partycji RowKey wartość unikatowo identyfikuje jednostkę. Usługa Table Storage jest zoptymalizowana pod kątem zapytań, które określają zarówno klucze, jak i pobierają ciągły zakres wartości klucza wiersza w ramach jednej partycji.
Tip
Usługa Table Storage obsługuje aktualizacje transakcyjne jednostek w tej samej tabeli i partycji za pośrednictwem transakcji grupy jednostek. Transakcja nie może obejmować tabeli faktów i oddzielnej tabeli indeksów. Aby atomowo zaktualizować encję faktu i encje indeksu, przechowuj je w tej samej tabeli z tym samym PartitionKey. Transakcje grupy jednostek są ograniczone do 100 jednostek na partię z maksymalnym ładunkiem wynoszącym 4 miB.
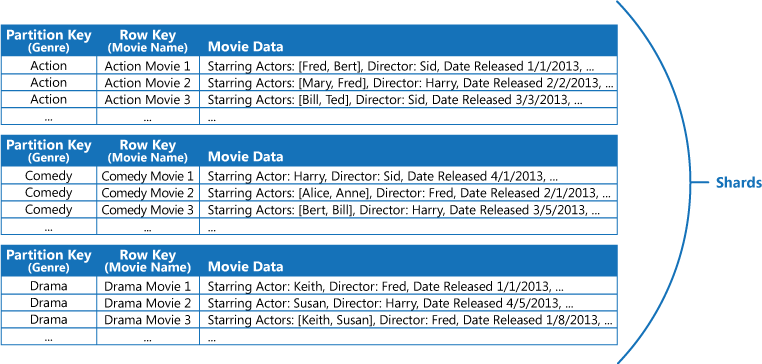
W tym przykładzie utwórz tabelę Azure z partycjami dla każdego gatunku przy użyciu zakodowanego identyfikatora gatunku jako klucza partycji i stabilnego, unikatowego identyfikatora filmu jako klucza wiersza. Przechowuj gatunki i nazwy filmów jako właściwości. Na poniższej ilustracji użyto czytelnych nazw zamiast identyfikatorów, aby ułatwić obserwowanie przykładu.
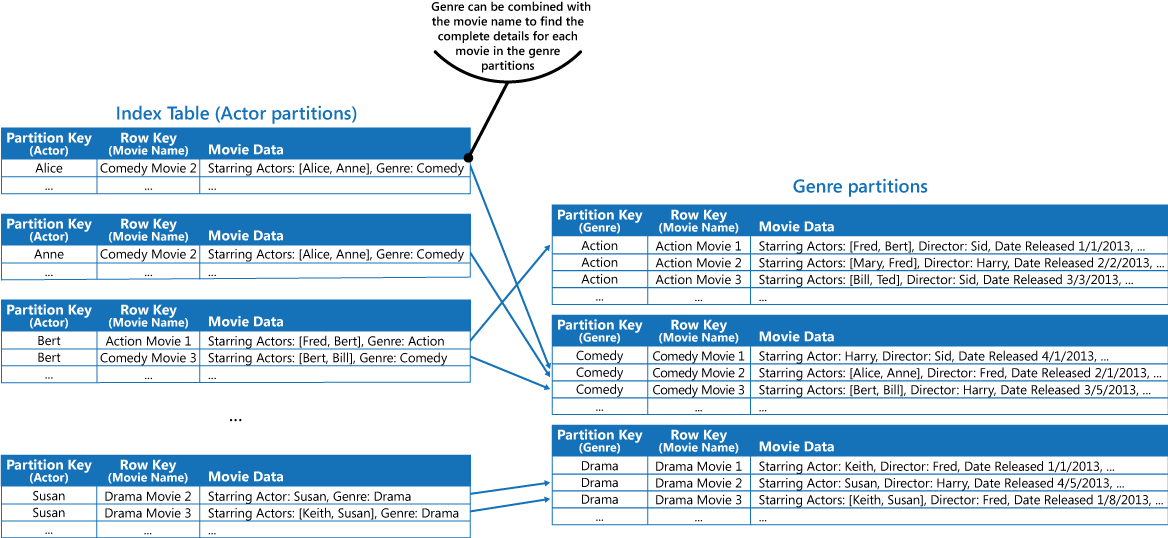
Ta metoda jest mniej skuteczna, jeśli aplikacja musi również wykonywać zapytania według aktorów występujących w danych filmach. W takim przypadku utwórz oddzielną tabelę Azure, która działa jako tabela indeksów. Użyj zakodowanego, stabilnego identyfikatora aktora jako klucza partycji i identyfikatora filmu jako klucza wiersza. Przechowuj nazwy aktorów i filmów jako właściwości. Na poniższej ilustracji użyto czytelnych nazw zamiast identyfikatorów. Jeśli film zawiera więcej niż jednego aktora, ten sam film występuje w wielu partycjach.
Na poniższej ilustracji przedstawiono tabelę indeksów aktorów.
Przewodnik po projekcie
Tabela filmów używa gatunku jako klucza partycjonowania, co oznacza, że zapytania filtrujące według gatunku są wykonywane wydajnie jako skany partycji obejmujące ciągłe zakresy kluczy wierszy. Jednak usługa Table Storage obsługuje tylko jeden indeks klastrowany dla PartitionKey i RowKey. Nie ma indeksów pomocniczych. Zapytanie, takie jak „znajdź wszystkie filmy z udziałem określonego aktora”, wymaga pełnego skanowania tabeli we wszystkich partycjach gatunkowych, co jest kosztowne przy dużej skali.
Tabela indeksów aktorów rozwiązuje to ograniczenie, odwracając wzorzec dostępu. Każdy identyfikator aktora staje się kluczem partycji, a każdy identyfikator filmu staje się kluczem wiersza, więc zapytania oparte na aktorach są rozpoznawane jako wydajne wyszukiwania partycji. Ponieważ każda partycja zawiera tylko jedno filmy aktora, zapytanie zwraca ciągły zakres jednostek bez skanowania niepowiązanych danych.
Ponieważ wpisy dotyczące filmów i aktorów korzystają z oddzielnych tabel i kluczy partycji, nie mogą one współdzielić transakcji w ramach tej samej grupy encji. Utrzymuj indeks aktorów za pomocą trwałego asynchronicznego mechanizmu rejestrowania zmian oraz zaprojektuj aplikację tak, aby tolerowała krótkotrwałą nieaktualność wyników zapytań.
Tabela indeksów stosuje częściową denormalizację: każdy wpis duplikuje często używane pola (takie jak nazwy innych aktorów), dzięki czemu najczęściej zadawane zapytania można odpowiedzieć z tabeli indeksów samodzielnie przy użyciu pojedynczego wyszukiwania. W przypadku rzadziej używanych pól wpis zawiera klucz partycji dla gatunku z oryginalnej tabeli filmów, co umożliwia wykonanie ukierunkowanego zapytania punktowego do partycji gatunku w celu pobrania pełnego rekordu. Ten projekt równoważy szybkość zapytań względem kosztów magazynu i obciążeń związanych z konserwacją.
Następne kroki
Wskazówki dotyczące projektowania zapytań usługi Table Storage opisują wzorce indeksów pomocniczych, które używają
PartitionKeyiRowKey, w tym podejścia do przechowywania wpisów indeksu w tej samej partycji lub w oddzielnych partycjach.Strategie partycjonowania danych wyjaśnia, jak wybierać klucze partycji i wierszy na podstawie wzorców zapytań, dystrybucji danych, wymagań dotyczących transakcji i celów skalowalności.
Strategie architektury służące do optymalizowania wydajności danych zawierają wskazówki dotyczące oceny wzorców zapytań, indeksów, partycji i wymagań dotyczących monitorowania.
Poziomy spójności w Azure Cosmos DB opisują modele spójności, które są istotne podczas obsługi tabel indeksów w Azure Cosmos DB.
Powiązane zasoby
Podczas implementowania tego wzorca mogą być również istotne następujące wzorce:
Wzorzec fragmentowania. Wzorzec tabeli indeksowej jest często używany w połączeniu z danymi partycjonowanymi przy użyciu shardów. Wzorzec fragmentowania opisuje sposób dzielenia magazynu danych na zestaw fragmentów.
Materialized View pattern (Wzorzec zmaterializowanego widoku). Zamiast indeksować dane w celu obsługi zapytań sumujących dane, bardziej odpowiednie może być utworzenie zmaterializowanego widoku danych. Ten wzorzec opisuje sposób generowania wstępnie zapełnionych widoków danych w celu obsługi wydajnych zapytań agregujących.
Wzorzec transakcyjnej skrzynki nadawczej. Użyj wzorca Transactional Outbox, aby umożliwić niezawodne publikowanie zmian na potrzeby asynchronicznego utrzymania indeksu, gdy danych źródłowych i wpisów indeksu nie można zaktualizować w ramach jednej transakcji.