Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Określanie priorytetów żądań wysyłanych do usług w taki sposób, aby obciążenie przetwarzało żądania o wysokim priorytcie szybciej niż żądania o niższym priorytcie. To podejście opiera się na komunikatach wysyłanych do jednej lub większej liczby kolejek i jest przydatne w przypadku aplikacji, które zapewniają różne poziomy usług lub umowy SLA dla różnych typów żądań lub klientów.
Kontekst i problem
Obciążenia mogą wymagać zarządzania zadaniami i przetwarzania ich z różnym poziomem ważności i pilności. Niektóre zadania wymagają natychmiastowej uwagi, podczas gdy inne mogą czekać. Niezajęcie się zadaniami o wysokim priorytecie może negatywnie wpłynąć na doświadczenie użytkownika i prowadzić do naruszenia umów SLA.
Aby sprawnie przetwarzać zadania zgodnie z ich priorytetem, obciążenia robocze potrzebują mechanizmu do odpowiedniego przetwarzania i uruchamiania zadań. Domyślnie większość obciążeń przetwarza zadania w kolejności ich nadejścia, z wykorzystaniem struktury kolejki „pierwsze weszło, pierwsze wyszło” (FIFO). Takie podejście nie uwzględnia różnego znaczenia zadania.
Rozwiązanie
Kolejki priorytetowe umożliwiają przetwarzanie zadań na podstawie ich priorytetu, a nie wyłącznie według kolejności ich wpłynięcia. Aplikacja lub producent , który wysyła żądanie, przypisuje wartość priorytetu do komunikatu, a konsumenci przetwarzają komunikaty według priorytetu. Wzorzec kolejki priorytetowej odpowiada na następujące wymagania:
Obsługuje zadania o różnej pilności i ważności: Masz zadania z różnymi poziomami pilności i ważności i musisz upewnić się, że przetwarzasz bardziej krytyczne zadania przed mniej krytycznymi zadaniami.
Obsługuje różne umowy SLA: Oferujesz różne umowy SLA dla różnych klientów i musisz zapewnić klientom o wysokim priorytetu lepszą wydajność i dostępność.
Obsługuje różne potrzeby związane z zarządzaniem obciążeniem: Masz obciążenie robocze, w ramach którego niektóre zadania muszą zostać wykonane natychmiast, podczas gdy mniej pilne zadania mogą poczekać.
Istnieją dwa główne podejścia do implementowania wzorca kolejki priorytetu:
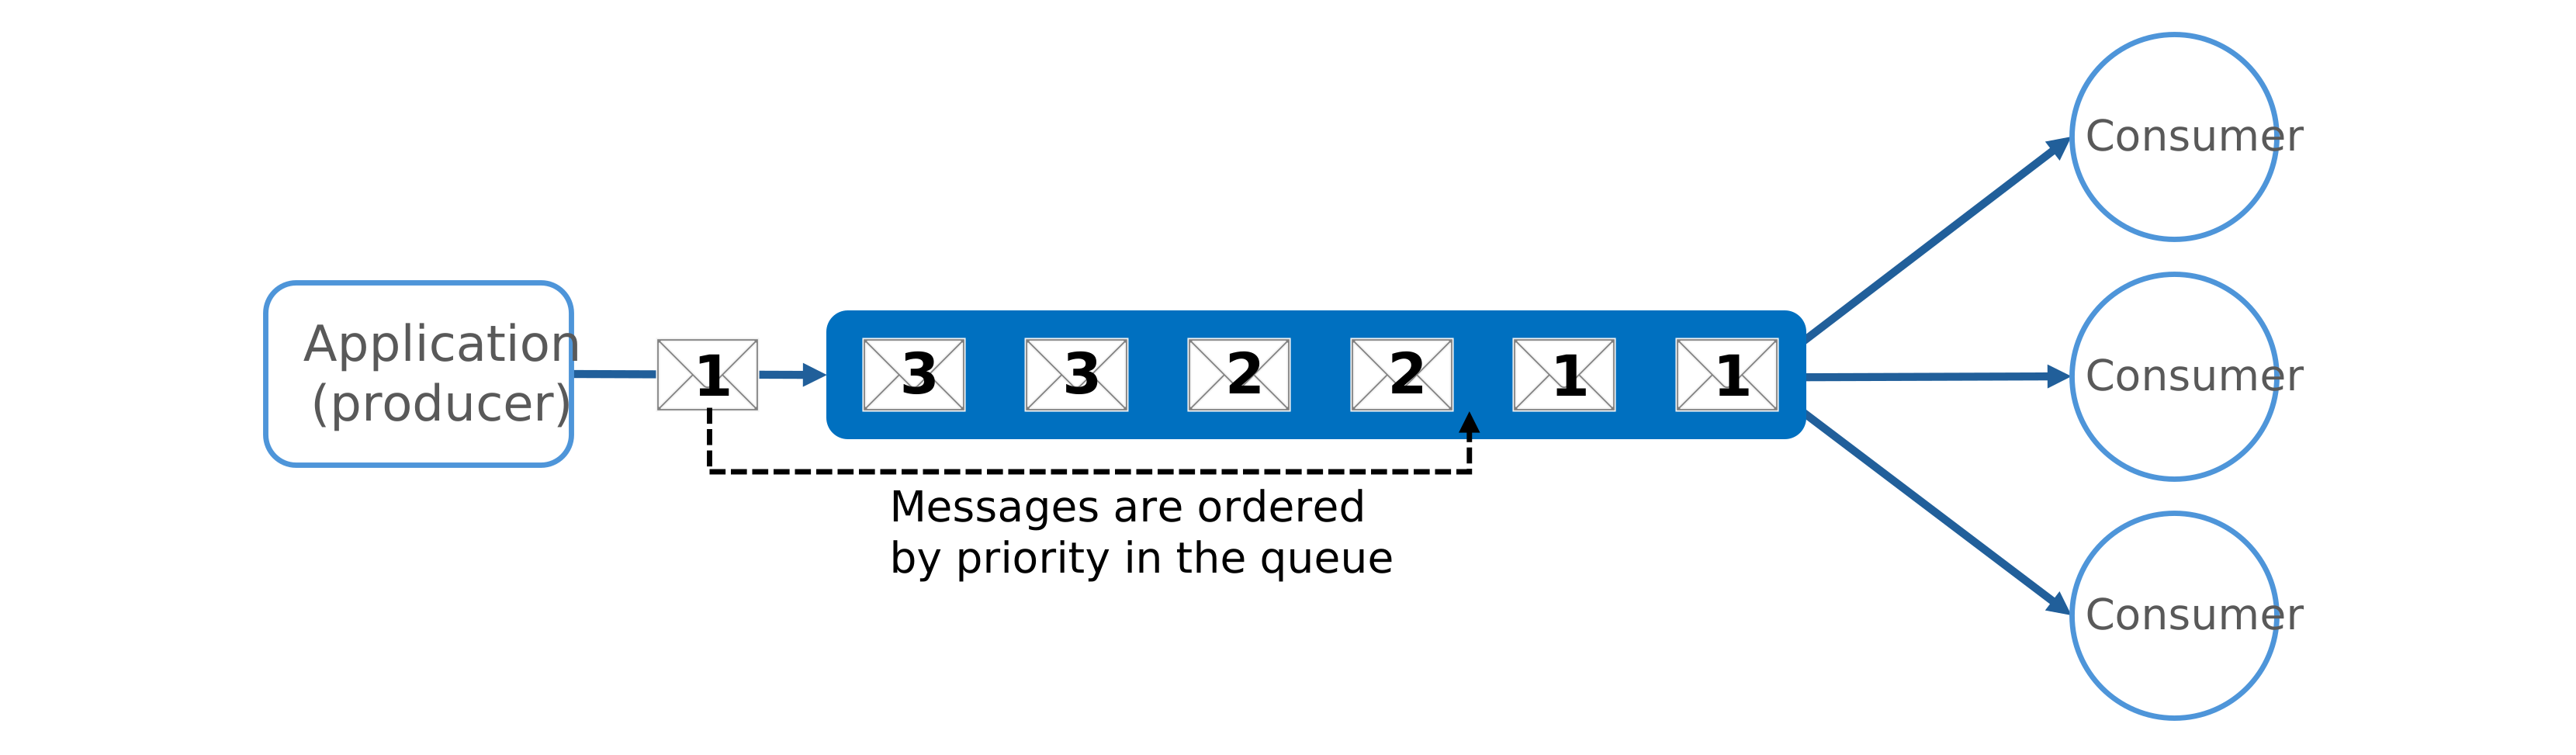
Pojedyncza kolejka: Każdy komunikat ma przypisaną wartość priorytetu, a wszystkie komunikaty używają tej samej kolejki.
Wiele kolejek: Każdy komunikat ma przypisaną wartość priorytetu, a komunikaty o różnych priorytetach używają oddzielnych kolejek.
Pojedyncza kolejka
W podejściu do jednej kolejki aplikacja przypisuje priorytet do każdego komunikatu i wysyła wszystkie komunikaty do jednej kolejki. Kolejka porządkuje komunikaty według priorytetu, zapewniając, że użytkownicy przetwarzają komunikaty o wyższym priorytcie przed komunikatami o niższym priorytcie.
Wiele kolejek
Wiele kolejek oddziela komunikaty według priorytetu. Aplikacja przypisuje priorytet do każdego komunikatu i kieruje komunikat do kolejki, która odpowiada jego priorytetowi, w którym konsumenci przetwarzają komunikaty. Rozwiązanie z wieloma kolejkami może używać jednej puli odbiorców lub wielu pul odbiorców.
Pojedyncza pula odbiorców
W ramach konfiguracji pojedynczej puli wszystkie kolejki współdzielą tę samą pulę odbiorców. Konsumenci przetwarzają komunikaty z kolejki o najwyższym priorytecie i przetwarzają komunikaty z kolejek o niższym priorytecie tylko wtedy, gdy nie ma więcej komunikatów o wysokim priorytecie. W rezultacie pojedyncze pule konsumentów zawsze przetwarzają komunikaty o wyższym priorytecie przed komunikatami o niższym priorytecie. Ta konfiguracja może prowadzić do ciągłego opóźnienia komunikatów o niższym priorytcie i potencjalnie nigdy nie są przetwarzane.
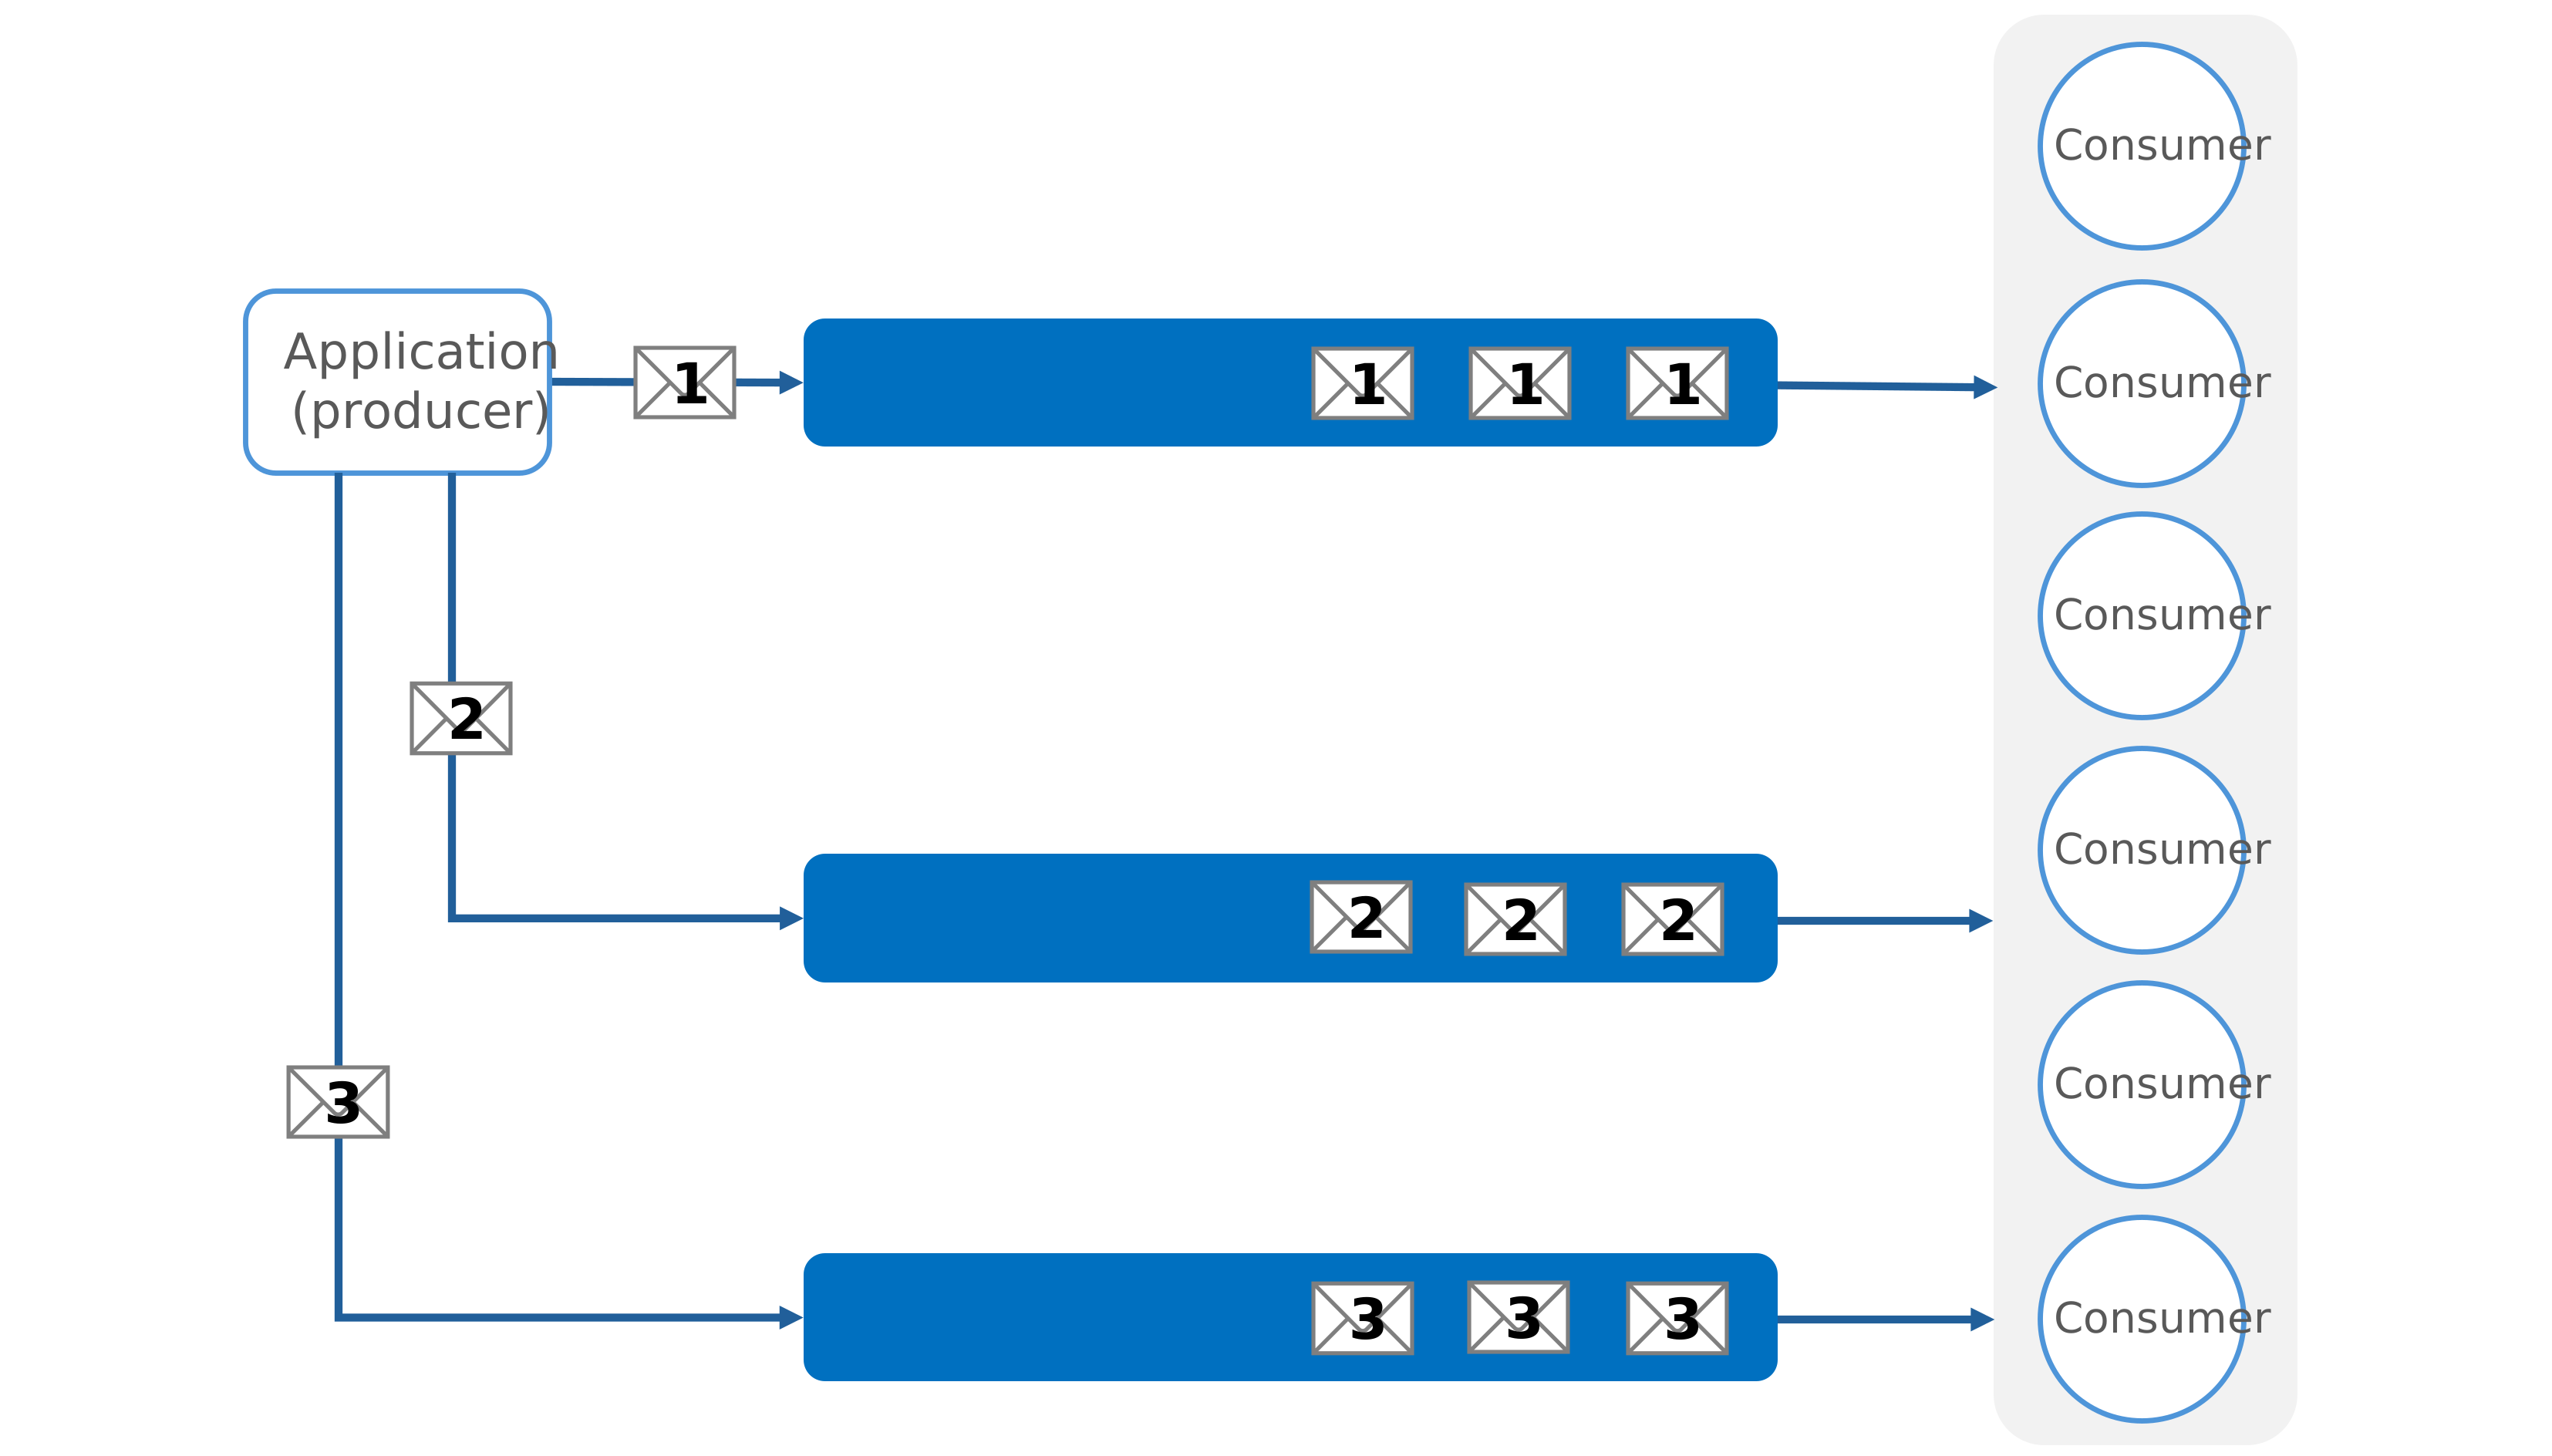
Użyj pojedynczej puli odbiorców z następujących powodów:
Proste zarządzanie. Użyj pojedynczej puli odbiorców, gdy łatwa konfiguracja i konserwacja są priorytetem. Pojedyncza pula zmniejsza złożoność konfiguracji i monitorowania.
Ujednolicone potrzeby przetwarzania. Użyj pojedynczej puli odbiorców, gdy zadania przychodzące są podobne do typu.
Wiele pul odbiorców
W wielu pulach odbiorców każda kolejka ma dedykowaną pulę odbiorców. Kolejki o wyższym priorytcie używają większej liczby użytkowników lub wyższych warstw wydajności do szybszego przetwarzania komunikatów niż kolejki o niższym priorytcie.
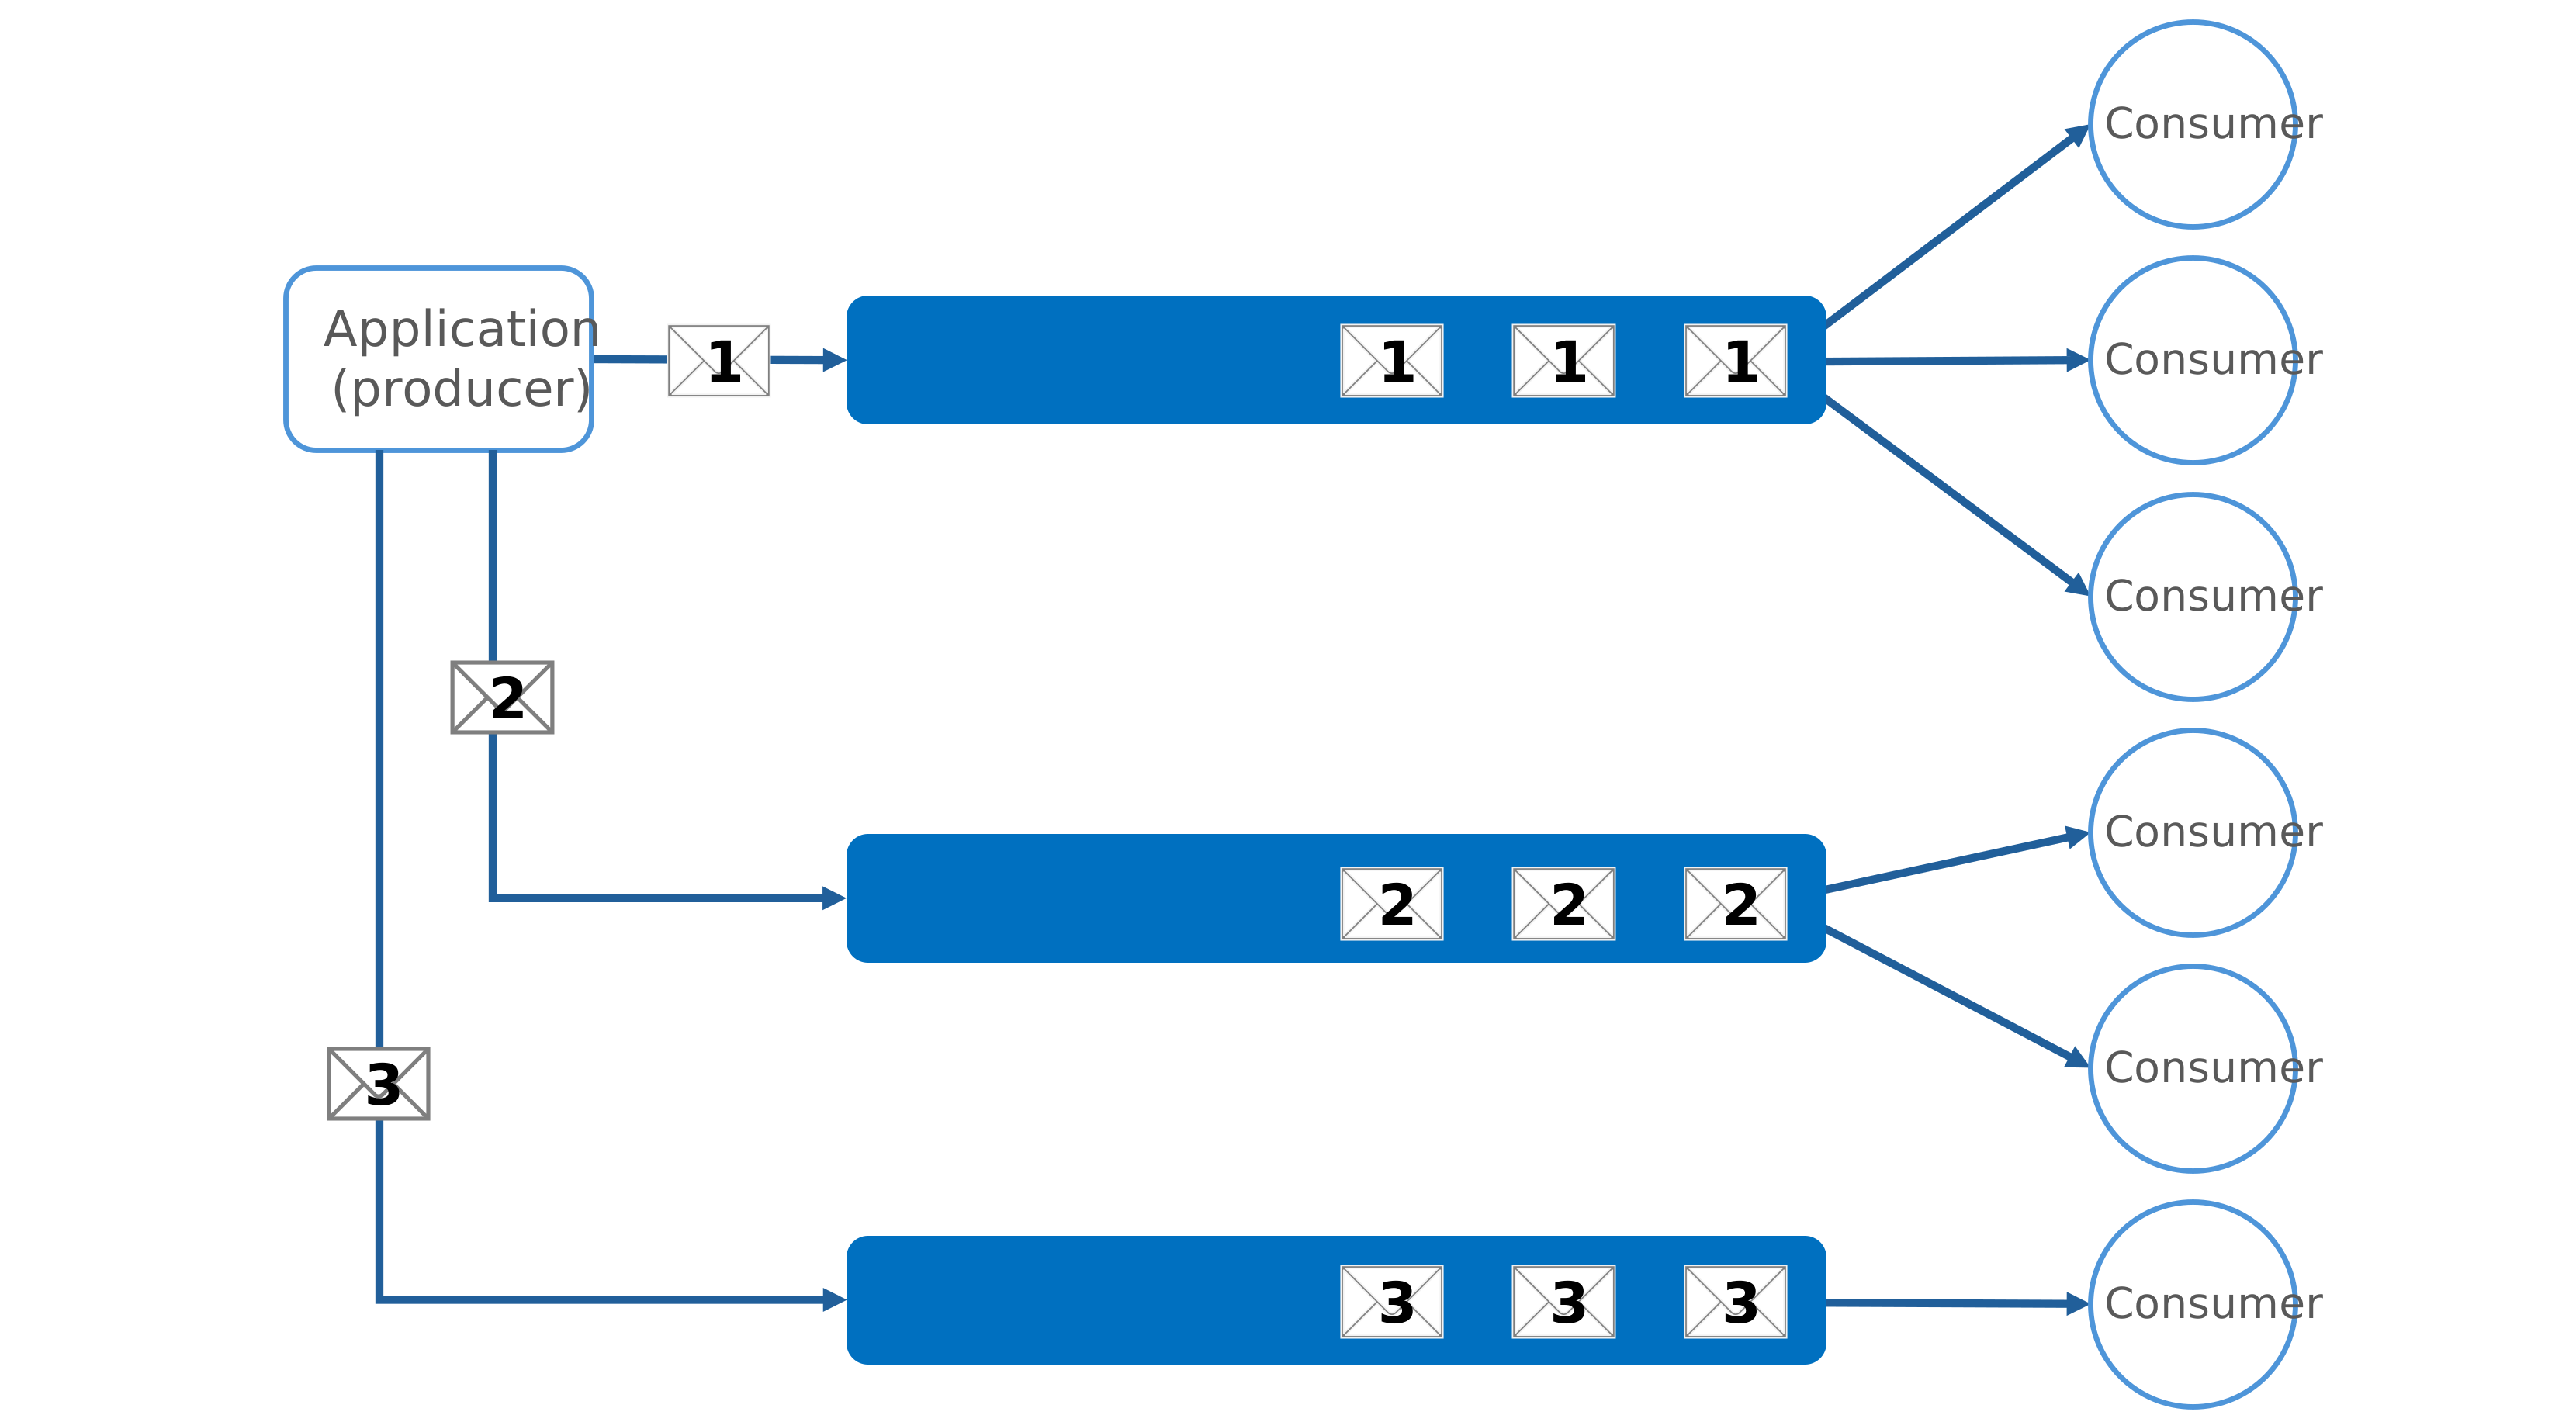
Użyj wielu pul odbiorców z następujących powodów:
Ścisłe wymagania dotyczące wydajności. Użyj wielu pul odbiorców, gdy różne priorytety zadań mają ścisłe wymagania dotyczące wydajności, które muszą zostać spełnione niezależnie.
Wymagania dotyczące wysokiej niezawodności. Używaj wielu pul odbiorców dla aplikacji, gdy izolacja niezawodności i błędów ma krytyczne znaczenie, a problemy w jednej kolejce nie mogą mieć wpływu na inne kolejki.
Złożone aplikacje. Używaj wielu pul odbiorców w przypadku złożonych aplikacji, w których różne zadania wymagają różnych właściwości przetwarzania i gwarancji wydajności.
Problemy i zagadnienia
Podczas podejmowania decyzji o zaimplementowaniu tego wzorca należy wziąć pod uwagę następujące kwestie:
Zalecenia ogólne
Jasno zdefiniuj priorytety. Ustanów odrębne i jasne poziomy priorytetów, które są istotne dla twojego rozwiązania. Można na przykład zdefiniować komunikaty o wysokim priorytcie jako te, które wymagają przetwarzania w ciągu 10 sekund. Zidentyfikuj wymagania konsumentów dotyczące obsługi elementów o wysokim priorytcie i odpowiednio przydziel niezbędne zasoby.
Dynamiczne dostosowywanie pul odbiorców. Skaluj rozmiar pul konsumentów na podstawie długości kolejek, które obsługują.
Monitorowanie kondycji kolejki. Monitoruj długość kolejki, latencję przetwarzania, liczbę dostarczeń i przepływność, aby wykrywać zaległości i spowolnienia, zanim wpłyną na pracę.
Używaj kolejek komunikatów niedostarczonych. Przenieś zatrute komunikaty do kolejki utraconych komunikatów po konfigurowalnej liczbie prób dostarczenia, dzięki czemu jeden z nieprawidłowych komunikatów nie blokuje ścieżki priorytetu.
Określanie priorytetów poziomów usług. Zaimplementuj kolejki priorytetów, aby spełnić potrzeby biznesowe, które wymagają priorytetowej dostępności lub wydajności. Na przykład klienci o wysokim priorytcie mogą otrzymać wyższy poziom usług, aby mieli lepszą wydajność i dostępność.
Rozważ przetwarzanie o niskim priorytcie. Zdecyduj, czy wszystkie elementy o wysokim priorytcie muszą być przetwarzane przed wszystkimi elementami o niższym priorytcie. Jeśli to możliwe, dynamicznie zwiększa priorytet starych komunikatów, aby upewnić się, że komunikaty o niskim priorytcie ostatecznie są przetwarzane.
Optymalizowanie i minimalizowanie kosztów. Natychmiast przetwarzaj zadania krytyczne dla dostępnych użytkowników. Zaplanuj mniej krytyczne zadania w tle w krótszym czasie pracy.
Jeśli używasz jednej kolejki, zoptymalizuj koszty, zmniejszając liczbę konsumentów. Komunikaty o wysokim priorytcie najpierw przetwarzają się, ale prawdopodobnie wolniej, podczas gdy komunikaty o niższym priorytcie mogą napotykać dłuższe opóźnienia.
Ochrona procesorów przed szczytami zapotrzebowania. Jeśli tempo napływu od producenta może przekroczyć zdolność przetwarzania konsumenta, połącz ten wzorzec ze wzorcem wyrównywania obciążenia opartym na kolejce. Takie podejście buforuje wzrost ruchu i pomaga zapobiegać przeciążeniu zasobów przetwarzania podrzędnego.
Zalecenia dotyczące wielu kolejek
Monitorowanie szybkości przetwarzania. Aby upewnić się, że komunikaty są przetwarzane z oczekiwaną szybkością, stale monitoruj tempo przetwarzania kolejek o wysokim i niskim priorytecie.
Wdrożenie wywłaszczania i zawieszenia. Jeśli używasz wielu kolejek z jedną pulą odbiorców, zaimplementuj algorytm, który zapewnia, że kolejki o wysokim priorytcie są zawsze obsługiwane przed kolejkami o niższym priorytcie.
Rozważ koszty kolejki. Należy pamiętać o kosztach finansowych związanych z kolejkami sprawdzania i przetwarzania. Niektóre usługi kolejkowania pobierają opłaty za wysyłanie, pobieranie i wyszukiwanie wiadomości. Te opłaty mogą wzrosnąć wraz z liczbą kolejek.
Kiedy należy używać tego wzorca
Użyj tego wzorca, gdy:
Musisz spełniać różne cele dotyczące opóźnień lub poziomu usług dla różnych klas zadań, na przykład zgłoszeń klientów premium i standardowych.
Praca napływa falami i musisz chronić kluczowe operacje, najpierw przetwarzając komunikaty o wysokim priorytecie, a zadania o niższym priorytecie odkładając na później.
Ten wzorzec może nie być odpowiedni w następujących przypadkach:
Wszystkie elementy robocze mają podobne znaczenie biznesowe, a ścisłe przetwarzanie FIFO jest ważniejsze niż planowanie oparte na priorytetach.
Zadania mają silne zależności porządkowania między poziomami priorytetu, a zmiana kolejności pracy według priorytetu może spowodować niespójne wyniki lub wymagać złożonej logiki koordynacji.
Projektowanie obciążenia pracy
Oceń sposób użycia wzorca kolejki priorytetowej w projekcie obciążenia w celu rozwiązania celów i zasad omówionych w filarach platformy Azure Well-Architected Framework. Poniższa tabela zawiera wskazówki dotyczące tego, jak ten wzorzec obsługuje cele poszczególnych filarów.
| Filar | Jak ten wzorzec obsługuje cele filaru |
|---|---|
| Decyzje projektowe dotyczące niezawodności pomagają obciążeniu stać się odporne na awarię i zapewnić, że zostanie przywrócony do w pełni funkcjonalnego stanu po wystąpieniu awarii. | Oddzielenie elementów na podstawie priorytetu biznesowego umożliwia skoncentrowanie wysiłków związanych z niezawodnością na najbardziej krytycznej pracy. - RE:02 Przepływy krytyczne |
| Efektywność wydajności pomaga wydajnie sprostać wymaganiom dzięki optymalizacjom skalowania, danych i kodu. | Oddzielenie elementów na podstawie priorytetu biznesowego umożliwia skoncentrowanie wysiłków związanych z wydajnością w najbardziej czasochłonnej pracy. - PE:09 Przepływy krytyczne |
Jeśli ten wzorzec wprowadza kompromisy w ramach filaru, rozważ je przed celami innych filarów.
Example
Przykład wzorca kolejki priorytetów w serwisie GitHub przedstawia implementację wzorca kolejki priorytetów, która wykorzystuje tematy i subskrypcje usługi Azure Service Bus. W tym przykładzie wdrażane jest bezpieczne konto magazynu, zasób usługi Application Insights na potrzeby monitorowania oraz przestrzeń nazw Service Bus umożliwiająca komunikację między funkcjami nadawcy i użytkownika.
Wdrożenie obejmuje trzy aplikacje funkcji: jedną aplikację nadawcy i dwie aplikacje odbiorców. Aplikacje konsumenckie używają różnych maksymalnych liczb wystąpień do symulowania priorytetyzacji komunikatów. Funkcja funcPriorityQueueConsumerHigh może skalować w poziomie do 200 wystąpień, natomiast funkcja funcPriorityQueueConsumerLow jest ograniczona do 40 wystąpień. Wszystkie aplikacje funkcyjne korzystają z planu Flex Consumption i są połączone z usługą Application Insights w celu diagnostyki i monitorowania.
Przypisania ról zapewniają bezpieczny dostęp do usług Service Bus i Storage za pomocą tożsamości zarządzanych. Wszystkie aplikacje funkcji korzystają z tego samego konta magazynu danych i zasobu usługi Application Insights. Ta konfiguracja umożliwia scentralizowanie obserwowania i rejestrowania.
Na poniższym diagramie przedstawiono architekturę kolejki priorytetów:

Na powyższym diagramie:
Aplikacja (producent). Aplikacja
PriorityQueueSendertworzy komunikaty, przypisuje każdemu komunikatowi niestandardową właściwość aplikacji o nazwiePriorityi ustawia wartośćPrioritynaHighlubLow.Broker komunikatów i temat komunikatów. Broker komunikatów Service Bus wysyła komunikaty do pojedynczego tematu Service Bus o nazwie
messages. Service Bus używa filtrów SQL do kierowania każdego komunikatu do subskrypcji o wysokim priorytecie lub niskim priorytecie na podstawie jegoPrioritywartości.Wiele pul odbiorców. Grupy odbiorców
PriorityQueueConsumerHighiPriorityQueueConsumerLowreagują na komunikaty z subskrypcji o wysokim lub niskim priorytecie za pomocą wyzwalaczy usługi Service Bus w Azure Functions.
| Rola w przykładzie | usługa Azure w przykładzie | Nazwa w przykładzie |
|---|---|---|
| Aplikacja (producent) | aplikacja Azure Functions | PriorityQueueSender |
| Broker komunikatów | Azure Service Bus | <przestrzeń nazw usługi Service Bus> |
| Temat komunikatu | Temat usługi Azure Service Bus | messages |
| Subskrypcje komunikatów | subskrypcje Azure Service Bus | highPrioritylowPriority |
| Klienci | aplikacja Azure Functions |
KolejkaPriorytetowaKonsumentWysoki PriorityQueueConsumerLow |
Następne kroki
- Service Bus, kolejki, tematy i subskrypcje: Zapoznaj się z encjami usługi Service Bus i różnicami między kolejkami a tematami.
- Wykrywanie duplikatów: dowiedz się, jak Service Bus może odrzucać zduplikowane komunikaty, gdy nadawca ponawia próbę po niepewnym wysłaniu.
- Kolejki utraconych komunikatów: dowiedz się, jak Service Bus przenosi komunikaty, których nie można przetworzyć do kolejki utraconych komunikatów na potrzeby badania lub ponownego przetwarzania.
- Co to jest Azure Queue Storage?: Przejrzyj podstawowe pojęcia Azure Queue Storage, aby porównać je z kolejkami Service Bus.
Powiązane zasoby
Podczas implementowania tego wzorca mogą być przydatne następujące wzorce:
Wzorzec równoważenia obciążenia oparty na kolejce: Użyj kolejki jako bufora między przyjmowaniem żądań a ich przetwarzaniem. Użyj tego z wzorcem kolejki priorytetowej, gdy potrzebujesz zarówno ochrony przed nagłymi skokami obciążenia, jak i zróżnicowanej obsługi.
Wzorzec konkurujących odbiorców: zaimplementuj wielu użytkowników, którzy nasłuchują tej samej kolejki i przetwarzają zadania równolegle w celu zwiększenia przepływności. Tylko jeden użytkownik przetwarza każdy komunikat.
Wzorzec ograniczania przepustowości: zaimplementuj ograniczanie przepustowości przy użyciu kolejek do zarządzania szybkościami żądań. Użyj komunikatów priorytetowych, aby określić priorytety żądań od krytycznych aplikacji lub klientów o wysokiej wartości w porównaniu z mniej ważnymi.