Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Ten artykuł zawiera przegląd uruchamiania i migracji obciążeń stanowych w usłudze Azure Kubernetes Service (AKS): wzorców projektowych, opcji magazynowania oraz punktów wejścia migracji dla baz danych i usług stanowych.
Czym są obciążenia z pamięcią stanu?
Stanowa praca obciążeniowa to aplikacja, która używa trwałego magazynu danych do zachowania stanu pomiędzy wieloma instancjami, co zapewnia płynne i spersonalizowane doświadczenie użytkownika. Ten projekt jest kluczowy dla usług takich jak bankowość internetowa, zakupy online i e-mail, gdzie spójność danych, historia sesji i niezawodność są istotne. Stanowe obciążenia robocze oferują również efektywność w scenariuszach przetwarzania o wysokiej wydajności i bliskiej rzeczywistemu czasowi, które korzystają z zaawansowanych funkcji, takich jak przełączenie awaryjne i odzyskiwanie, zapewniając ciągłość działania biznesu.
Chociaż obciążenia z pamięcią stanową oferują wiele korzyści, wiążą się także z pewnymi wyzwaniami. Na przykład, zadania z utrzymywaniem stanu często wprowadzają skomplikowane wzorce przetwarzania, które mogą prowadzić do zwiększenia narzutu i kosztów wydajności. Ważne jest, abyś zrozumiał i wziął pod uwagę specyficzne potrzeby swojej aplikacji, aby pomóc w określeniu właściwej równowagi między stanowością a bezstanowością.
Biorąc pod uwagę krytyczną rolę obciążeń stanowych, Azure oferuje kilka podejść do ich efektywnego uruchamiania. Ta sekcja przedstawia najlepsze praktyki wdrażania obciążeń stanowych na Azure Kubernetes Service (AKS), pomagając deweloperom i organizacjom wybrać najbardziej odpowiednią opcję dla ich potrzeb.
Migrowanie obciążeń stanowych do usługi AKS
Jeśli przenosisz istniejące aplikacje stanowe do usługi AKS, skorzystaj z tego krótkiego planu rozpoczęcia migracji, aby ograniczyć ryzyko i przyspieszyć wdrożenie:
- Określ wymagania dotyczące pamięci masowej i dostępności: Udokumentuj wymagania dotyczące liczby operacji we/wy na sekundę (IOPS), przepustowości, opóźnień, trwałości i wysokiej dostępności danych. Określ, czy Twoje obciążenie wymaga pamięci blokowej (Azure Disk), pamięci plikowej (Azure Files) czy wyspecjalizowanej pamięci masowej opartej na CSI.
- Wybierz sterownik CSI i topologię magazynowania: Wybierz sterownik CSI obsługiwany w usłudze AKS, który odpowiada tym wymaganiom (na przykład Azure Disk CSI dla magazynu blokowego, Azure Files CSI dla współdzielonej pamięci plików lub sterownik CSI innej firmy do zaawansowanych funkcji). Sprawdź, czy są obsługiwane wymagania dotyczące migawek woluminów i replikacji.
- Wdrażanie za pomocą obiektów StatefulSet lub operatora: Migruj repliki za pomocą obiektów StatefulSet lub użyj operatora bazy danych do zarządzania przełączaniem awaryjnym, członkostwem i kopiami zapasowymi. Sprawdź poprawność zachowania przywracania, trybu failover i uaktualniania stopniowego w środowisku testowym przed rozpoczęciem migracji jednorazowej.
Aby uzyskać więcej informacji, zobacz Zagadnienia dotyczące migrowania obciążeń stanowych do usługi AKS.
Typowe scenariusze migracji stanowej
- PostgreSQL: oceń wymagania dotyczące IOPS i HA, wybierz pamięć masową blokową lub replikowaną pamięć masową opartą na CSI oraz wdrażaj za pomocą StatefulSet lub operatora PostgreSQL. Zobacz Wskazówki dotyczące bazy danych PostgreSQL.
- MongoDB: zweryfikuj topologię zapisu, dziennika i zestawu replik; wybierz magazyn spełniający wymagania dotyczące przepływności i trwałości, a następnie wdróż go przy użyciu elementów StatefulSets lub operatora Bazy danych MongoDB. Zobacz Wskazówki dotyczące bazy danych MongoDB.
Stos stanowej struktury fundamentu Kubernetes
Stanowa struktura Kubernetes rozpoczyna się od wspólnego stosu podstawowego. W tym przypadku użyj stosu KATE , popularnego, ustandaryzowanego stosu używanego w wielu projektach infrastruktury. Stos KATE używa następujących narzędzi open-source:
Przewodniki AKS nie implementują ArgoCD ani Terraform, ponieważ są zaprojektowane do operacji Day 1. Jednak wraz ze wzrostem skali wdrożenia i ewolucji wymagań, powinno być łatwiej zintegrować ArgoCD i Terraform, ponieważ przewodniki wykorzystują część stosu KATE.
Kubernetes stanowy framework dla Azure
Mając już ustaloną podstawową warstwę infrastruktury, musimy teraz ulepszyć framework, aby obsługiwał stanowe obciążenia robocze na platformie Azure, w szczególności poprzez integrację niezbędnych zasobów do uruchamiania infrastruktury danych na Azure Kubernetes Service (AKS).
Wspieranie skomplikowanych obciążeń stanowych, takich jak bazy danych czy kolejki wiadomości, wymaga możliwości przechowywania, które przewyższają opcje efemeryczne. W szczególności potrzebne są systemy, które oferują zwiększoną odporność i dostępność w celu obsługi różnych zdarzeń, takich jak awarie aplikacji lub ponowne przypisywanie obciążeń do różnych hostów. Tę odporność można osiągnąć przy użyciu podsystemu PersistentVolume, który obejmuje trzy połączone zasoby Kubernetes: PersistentVolumes, PersistentVolumeClaims i StorageClasses. Ten podsystem zapewnia interfejs API dla użytkowników i administratorów, aby abstrahować szczegóły dotyczące sposobu udostępniania pamięci masowej od sposobu jej wykorzystania.
Większość obciążeń z zachowaniem stanu potrzebuje danych z tajnych zasobów, takich jak ciągi połączeń, nazwy użytkowników, hasła i certyfikaty. Azure Key Vault zapewnia bezpieczne miejsce przechowywania sekretów, które używamy do przechowywania niezbędnych sekretów związanych z stanowymi frameworkami.
Potrzebujemy również kontrolera Kubernetes lub operatora Kubernetes, na przykład Secrets Store CSI Driver lub External Secrets Operator, aby synchronizować sekrety magazynu jako sekrety Kubernetes.
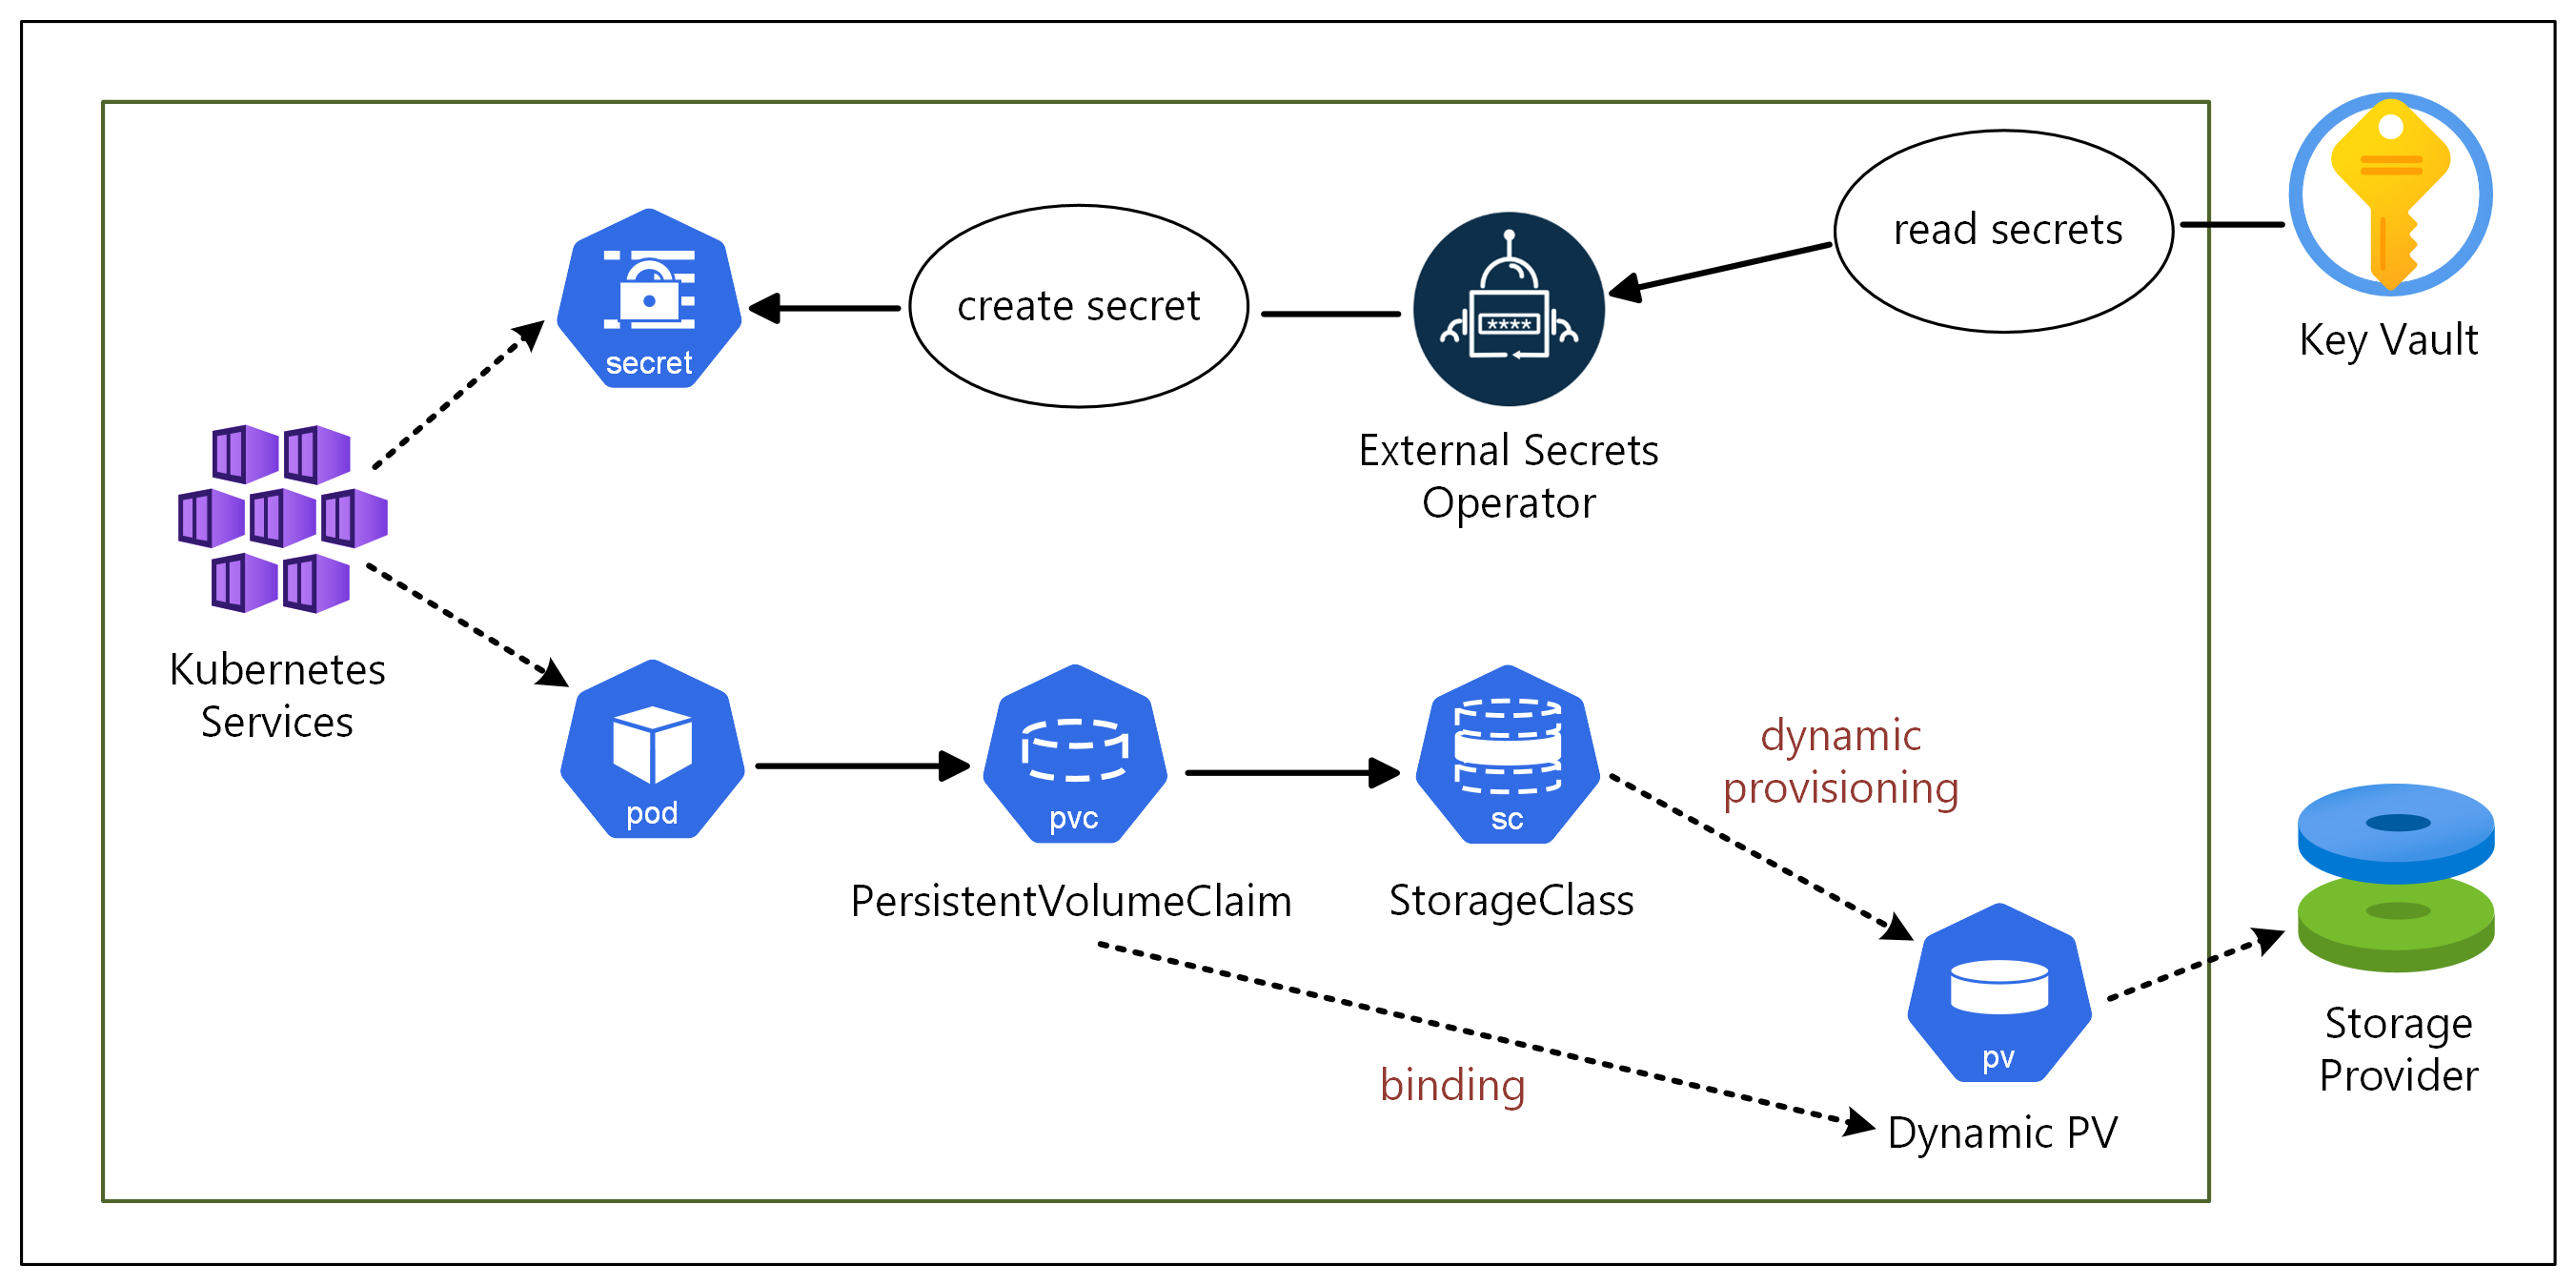
Projektuj i wdrażaj zadania wymagające stanu na platformie Azure
Jeśli migrujesz istniejące obciążenie z zachowaniem stanu do usługi AKS, zacznij od przewodnika wdrożeniowego dotyczącego migracji obciążeń z zachowaniem stanu do usługi AKS, aby zapoznać się z krokami oceny i weryfikacji związanymi z migracją.
Poniższe sekcje zawierają linki do informacji o projektowaniu i wdrażaniu w scenariuszach obciążeń stanowych na platformie Azure.
MongoDB
- Omówienie projektu obciążenia z zachowaniem stanu dla bazy danych MongoDB
- Utwórz infrastrukturę do uruchamiania klastra MongoDB na Azure Kubernetes Service (AKS)
- Skonfiguruj i wdroż klaster MongoDB na Azure Kubernetes Service (AKS)
- Wdrażanie aplikacji klienckiej w celu połączenia się z klastrem MongoDB na platformie Azure Kubernetes Service (AKS)
- Weryfikowanie odporności klastra Bazy danych MongoDB w usłudze Azure Kubernetes Service (AKS)
- Sprawdź odporność MongoDB podczas aktualizacji puli węzłów w usłudze Azure Kubernetes Service (AKS)
- Konfigurowanie monitorowania klastra Bazy danych MongoDB w usłudze Azure Kubernetes Service (AKS)
PostgreSQL
- Przegląd projektowania stanowych obciążeń roboczych w PostgreSQL
- Utwórz infrastrukturę do uruchamiania wysoce dostępnej bazy danych PostgreSQL na Azure Kubernetes Service (AKS)
- Wdrażanie bazy danych PostgreSQL o wysokiej dostępności w usłudze Azure Kubernetes Service (AKS)
Valkey
- Przegląd projektu stanowego obciążenia roboczego Valkey
- Tworzenie infrastruktury do uruchamiania klastra Valkey w usłudze Azure Kubernetes Service (AKS)
- Konfiguracja i wdrożenie klastra Valkey na usłudze Azure Kubernetes (AKS)
- Sprawdź odporność klastra Valkey na usłudze Azure Kubernetes Service (AKS)
- Sprawdź odporność Valkey podczas aktualizacji puli węzłów w usłudze Azure Kubernetes Service (AKS)
Apache Airflow
- Przegląd projektowania stanowego obciążenia Apache Airflow
- Utwórz infrastrukturę do uruchamiania Apache Airflow na Azure Kubernetes Service (AKS)
- Skonfiguruj i wdrażaj Airflow na usłudze Azure Kubernetes Service (AKS)
Platforma Apache Kafka z oprogramowaniem Strimzi
- Wdrażanie klastra Platformy Kafka w usłudze Azure Kubernetes Service (AKS) przy użyciu usługi Strimzi — omówienie
- Przygotowywanie infrastruktury do wdrażania platformy Kafka w usłudze Azure Kubernetes Service (AKS)
- Konfigurowanie i wdrażanie składników Strimzi i Kafka w usłudze Azure Kubernetes Service (AKS)
- Konfigurowanie monitorowania i sieci dla klastra Platformy Kafka w usłudze Azure Kubernetes Service (AKS)
Funkcja GitHub Actions z usługą Azure Files
- Omówienie rozwiązania służącego do wdrażania funkcji GitHub Actions o wysokiej dostępności w usłudze Azure Kubernetes Service (AKS)
- Tworzenie infrastruktury do wdrażania funkcji GitHub Actions o wysokiej dostępności w usłudze Azure Kubernetes Service (AKS)
- Wdrażanie i testowanie funkcji GitHub Actions w usłudze Azure Kubernetes Service (AKS)
Note
Mimo że obiekty StatefulSet zapewniają trwałe tożsamości i trwałą pamięć masową, pule węzłów Azure Spot nie są zalecane w przypadku stanowych obciążeń o krytycznym znaczeniu dla środowisk produkcyjnych. Maszyny wirtualne Spot mogą zostać wycofane z niewielkim wyprzedzeniem, gdy platforma Azure odzyskuje dostępne zasoby, co może prowadzić do nagłego zakończenia działania węzła oraz potencjalnych opóźnień w odzyskiwaniu woluminu lub ponownym zaplanowaniu poda. W przypadku obciążeń roboczych, które zależą od trwałego przechowywania danych i wysokiej dostępności, należy używać standardowych pul węzłów oraz odpowiednich mechanizmów zapewniania odporności pamięci masowej. Pule węzłów Azure Spot powinny być zarezerwowane dla obciążeń podatnych na przerwanie, które mogą tolerować niespodziewaną utratę węzłów.
Współautorzy
Microsoft utrzymuje ten artykuł. Następujący autorzy pierwotnie napisali ten tekst:
- Don High | Główny Inżynier ds. Klienta
- Colin Mixon | Menedżer produktu
- Erin Schaffer | Content Developer 2