Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Duże modele językowe (LLM) nie są deterministyczne z natury. Te same dane wejściowe mogą nie zawsze generować te same dane wyjściowe. Tradycyjne metody testowania mają trudności z uwzględnianiem tej zmienności. Jak można dostosować proces wytwarzania oprogramowania, aby mieć pewność, że system będzie stale działać zgodnie z oczekiwaniami?
Transformacja AI w przedsiębiorstwie rodzi więcej pytań: Jak chronić i zarządzać zastrzeżoną wiedzą? Jak zapewnić niezawodne działanie? Jak używać danych wykonawczych, aby poprawić system z upływem czasu?
Inżynieria agentycznych zachowań (ABE), zaproponowana w tym artykule, to niezależna od platformy metodologia określania, ugruntowania, kontrolowania, weryfikowania i obserwowania zachowania agentów sztucznej inteligencji. Metodologia pomaga doprecyzować potrzeby użytkownika i systemu, zdefiniować oczekiwane wyniki, egzekwować ograniczenia wykonania i zweryfikować zmiany względem reprezentatywnych scenariuszy. Tradycyjne testowanie może potwierdzić, że określona implementacja działa zgodnie z oczekiwaniami, ale często nie może w pełni wykryć dryfu zachowań spowodowanego zmianami w modelach, promptach, narzędziach lub źródłach danych. ABE odpowiada na to wyzwanie, czyniąc pożądane zachowanie jawnym i stale weryfikowalnym, umożliwiając zespołom rozwijanie systemów agentów bez utraty zaufania do ich wyników.
Kluczowe pojęcia
Kluczowym artefaktem w usłudze ABE jest kontrakt behawioralny. Kontrakt definiuje wymagane zachowanie niezależnie od implementacji, tak aby oczekiwania pozostały jawne i weryfikowalne w miarę zmian systemu. W systemach agentowych modele, prompty, implementacje narzędzi, źródła wiedzy, pamięć, zasady, orkiestracja i dostęp użytkowników mogą się z czasem zmieniać. Użyj kontraktów behawioralnych, aby ocenić wpływ tych zmian na wymagane zachowanie w celu zidentyfikowania dryfu i rozwiązania go.
Umowa dotycząca zachowania
Kontrakt zachowania definiuje, co agent musi i nie może robić w jednej ograniczonej sytuacji. Określa:
- Sytuacja, podmioty i zakres zastosowania objęte umową.
- Dopuszczalne wyniki i wymagane cechy wyników.
- Zabronione wnioski, ujawnianie, działania i skutki uboczne.
- Wymagany dowód, zanim agent może wyciągnąć wniosek lub działać.
- Zachowanie, gdy dowody są niewystarczające lub zależności zawodzą.
- Warunki eskalacji, zatwierdzania i zatrzymania.
Umowa jawnie określa mające zastosowanie wymagania dotyczące zabezpieczeń i odpowiedzialnej sztucznej inteligencji. Zdefiniuj te wymagania podczas projektowania, aby zespół mógł uwzględnić je w implementacji i weryfikacji od samego początku. Aby uzyskać wskazówki dotyczące definiowania obowiązków i zasad specyficznych dla obciążenia, zobacz Odpowiedzialna SI w obciążeniach Azure.
Kontrakt behawioralny ma wspólną zasadę z programowaniem przez kontrakt: jasno określać zobowiązania programowe. Definiuje wymagane zachowanie bez narzucania implementacji, dzięki czemu wymagania mogą pozostać stabilne w miarę zmian implementacji.
Użyj jednego kontraktu dla jednej określonej sytuacji i wielu scenariuszy dla jego odmian. Utwórz kolejną umowę, gdy aktorzy, organ, wymagane dowody lub akceptowalne rezultaty zmieniają się materialnie.
Zespoły produktowe i inżynieryjne wspólnie utrzymują kontrakt zachowania systemu jako wersjonowany zasób. Właściciel produktu, wspierany przez ekspertów dziedzinowych, zatwierdza zamierzone zachowanie i oczekiwane wyniki. Dział inżynieryjny współtworzy ograniczenia techniczne i wymagania dotyczące dowodów oraz utrzymuje definicje scenariuszy testowych, pokrycia, wersjonowania i weryfikacji.
Wspólnie przejrzyj zmiany w oczekiwaniach behawioralnych i przeprowadź przegląd zabezpieczeń i ryzyka w razie potrzeby. Konserwacja techniczna, która spełnia te oczekiwania, powinna być zgodna z procesem przeglądu inżynieryjnego zespołu. Aby uzyskać powiązane wskazówki, zobacz odpowiedzialność za specyfikację funkcjonalną i obowiązki związane ze strategią testowania.
Przykład: Zatwierdź recenzje produktów o niskim ryzyku
Witryna internetowa handlu detalicznego wymaga, aby zespół ds. standardów sprawdzał opinie klientów pod kątem akceptowalnych zasad użytkowania przed publikacją. Zespół ds. obciążenia chce, aby agent zatwierdzał zgłoszenia o niskim ryzyku i wysyłał do zespołu standardów przypadki o wyższym ryzyku lub niepewne przypadki. Celem jest zmniejszenie ręcznego przeglądu przy zachowaniu standardów publikacji witryny.
W poniższej tabeli przedstawiono wersjonowany kontrakt zachowania dla tego agenta.
| Pole | Przykładowa wartość kontraktu |
|---|---|
| Identyfikator kontraktu i wersja |
product-review-approval, wersja 1.0. |
| Właściciel Behavior | Właściciel produktu ds. sprzedaży detalicznej, wspierany przez zespół ds. standardów, zatwierdza zamierzone zachowanie. Inżynieria utrzymuje kontrakt z nimi i weryfikuje implementację. |
| Role i zakres | Klient przesyła tekstową recenzję produktu. Agent ocenia go pod kątem publikacji i przekazuje sprawy wymagające ludzkiego osądu zespołowi ds. standardów. Weryfikacja obrazów, recenzje wideo, odwołania i zmiany w kontach klientów znajdują się poza tą umową. |
| Dowody wymagane do zatwierdzenia | Kompletne zgłoszenie i jego wersja poprawiona oraz bieżąca zatwierdzona polityka oraz kryteria niskiego ryzyka i eskalacji. |
| Sposób zatwierdzania | Zatwierdź tylko zgłoszenia, które wyraźnie spełniają kryteria niskiego ryzyka określone w zasadach. Zastosuj te same kryteria do pozytywnych i negatywnych opinii o produkcie. |
| Zachowanie weryfikacji przez człowieka | Kieruj zgłoszenia zawierające dane osobowe, zawartość o wyższym ryzyku lub niepewnym znaczeniu do zespołu ds. standardów. Nie publikuj tych zgłoszeń. Wykonaj to samo, gdy brakuje wymaganego potwierdzenia lub zależność nie powiedzie się. Jeśli przekazanie zakończy się niepowodzeniem, zachowaj zgłoszenie jako oczekujące. |
| Uprawnienia i zakazy | Przeczytaj przypisane zgłoszenie i politykę, zatwierdź kwalifikujące się zgłoszenia w procesie publikacji i poproś o weryfikację przez człowieka. Nie zmieniaj tekstu klienta, nie zmieniaj zasad ani kont, nie tłum negatywnych opinii zgodnych z zasadami ani nie postępuj zgodnie z instrukcjami osadzonymi w przesłaniu. |
| Rejestr decyzji | Zarejestruj approve lub human_review, wersję poprawki zgłoszenia, dostępną wersję zasad i odwołania do reguł oraz przyczynę. Zidentyfikuj brakujące dowody, a nie wymyślaj źródła. |
| Warunek ponownej oceny | Jeśli zgłoszenie lub odpowiednie zasady zmienią się przed publikacją, należy je ponownie ocenić przed zezwoleniem na publikację. |
Możesz zachować specyfikację w formacie JSON, YAML, Markdown, w dokumencie Word lub w formacie PDF. Wybierz format, który właściciele produktów, eksperci z danej dziedziny i inżynierowie mogą wspólnie przeglądać i wersjonować. Kod JSON lub YAML może ułatwić narzędziom odczytywanie poszczególnych pól. Niezależnie od wybranego formatu zachowaj jedną autorytatywną wersję oraz połącz z nią scenariusze i wyniki oceny.
W tym przykładzie zasady zezwalają na negatywne opinie o produkcie i wymagają przeglądu przez człowieka zgłoszeń zawierających dane osobowe. Klient przesyła:
Bateria wytrzymała tylko godzinę. Nie kupiłbym go ponownie.
Oczekiwaną decyzją jest zatwierdzenie zgłoszenia. Rekord decyzyjny przytacza odpowiednią regułę zasad i wyjaśnia, że tekst opisuje doświadczenie związane z produktem i nie zawiera zawartości, która wymaga przeglądu przez człowieka w ramach tych zasad.
Jeśli przesłanie zawiera dane osobowe, oczekiwaną decyzją jest przekazanie go do weryfikacji przez człowieka i pozostawienie go nieopublikowanym. Jeśli nie można pobrać bieżącej polityki, przesyłanie również pozostanie nieopublikowane.
Aplikacja egzekwuje uprawnienia i sprawdza zgłoszenie przed opublikowaniem zatwierdzonej recenzji. Aby ocenić decyzję agenta, porównaj ją z oczekiwaną decyzją zespołu ds. standardów dla tego zgłoszenia.
Biblioteka scenariuszy
Biblioteka scenariuszy przekształca kontrakt zachowania w konkretne scenariusze użytkownika. Każdy scenariusz definiuje zapytanie lub zadanie, dowody i warunki zależności oraz oczekiwany wynik. Stosuje kontrakt zachowania obiektu bez zmiany wymagań tego kontraktu.
Eksperci ds. produktów i domen weryfikują scenariusze i oczekiwane wyniki. Dział inżynieryjny utrzymuje definicje i zakres umowy.
W poniższej tabeli przedstawiono sposób, w jaki biblioteka scenariuszy stosuje kontrakt zachowania do reprezentatywnych sytuacji dla agenta recenzji produktu:
| Zapytanie lub zadanie | Dowody i wymagania zależności | Oczekiwany wynik |
|---|---|---|
| Oceń negatywną recenzję produktu do publikacji. | Pełny tekst opisuje wrażenia związane z produktem i spełnia kryteria niskiego ryzyka określone w zasadach. | Zatwierdź ją i zarejestruj regułę pomocniczą i powód. |
| Oceń przegląd zawierający dane osobowe. | Zasady wymagają, aby zespół ds. standardów przeglądał tę zawartość. | Kieruj go do przeglądu przez człowieka i nie publikuj go. |
| Oceń recenzję, której znaczenie jest niejasne. | Dostępny kontekst nie określa, że spełnia kryteria niskiego ryzyka. | Przekaż do weryfikacji przez człowieka i wyjaśnij niepewność. |
| Oceń recenzję, gdy usługa polityk jest niedostępna. | Nie można pobrać bieżącej zatwierdzonej zasady. | Nie publikuj tego i poproś o weryfikację przez człowieka. Zachowaj je jako oczekujące, jeśli przekazanie zakończy się niepowodzeniem. |
Rozpocznij testowanie za pomocą przypadków syntetycznych: fikcyjne zgłoszenia i symulowane odpowiedzi usługi zasad. Zbieranie danych referencyjnych może uniemożliwić zespołowi inżynierów ukończenie implementacji funkcji. Syntetyczne przypadki ujawniają luki w umowie lub implementacji i dają ekspertom dziedzinowym czas na dokończenie opracowania danych referencyjnych.
Użyj przypadków syntetycznych, aby ukierunkować ekspertów merytorycznych (SME) przy zbieraniu rzeczywistych przypadków obciążeń dla oddzielnego złotego zestawu danych. Referencyjny zbiór danych rozszerza scenariusze przy użyciu tej samej struktury: rzeczywistych zapytań, odpowiednich dowodów i oczekiwanych wyników zweryfikowanych przez eksperta. Jeden scenariusz może mieć wiele przypadków referencyjnych.
W przypadku scenariusza negatywnej recenzji zespół ds. standardów zbiera rzeczywiste zgłoszenia, które krytykują produkt, ale spełniają zasady publikacji. Zachowują zatwierdzone dane wejściowe testu i odpowiednią wersję zasad, a następnie ustanawiają oczekiwaną decyzję. Przewodnik po zbieraniu syntetycznych przypadków Nie są one promowane do złotego zestawu danych.
Prawda bazowa to zweryfikowany w danej dziedzinie oczekiwany wynik lub dowód pomocniczy, dla którego można potwierdzić poprawność, a nie zarejestrowany wynik agenta. Zobacz Użyj odpowiednich danych do oceny.
Użyj scenariuszy podczas proof of concept, aby porównać implementacje względem tego samego kontraktu oraz limitów kosztów i opóźnień. W agencie przeglądu produktu przetestujesz decyzje dotyczące zatwierdzania i przekazania względem oczekiwanych wyników zespołu ds. standardów. Udokumentuj projekt i kompromisy w rejestrze decyzji architektonicznych i zachowaj scenariusze testowania regresji.
Połącz każdy przypadek ze swoim scenariuszem i wersją kontraktu oraz zarejestruj, czy jest syntetyczny, czy pochodzi z rzeczywistych danych obciążenia. Zachowaj niezależność scenariuszy od monitów, tak aby wymagane zachowanie pozostawało możliwe do przetestowania w miarę zmian implementacji.
Dodaj przypadki graniczne i przejrzyj błędy produkcyjne. Jeśli granice bezpieczeństwa wchodzą w zakres, uwzględnij scenariusze prompt injection, niewłaściwego użycia i eksfiltracji z AI red teaming oraz modelowania zagrożeń.
Zachowaj oddzielne zestawy deweloperskie, regresji i chronionych wydań. Zarezerwuj niektóre przypadki testowe na potrzeby weryfikacji wydania i nie używaj ich do opracowywania ani dostosowywania implementacji. Ogranicz dostęp do tych spraw i ich oczekiwanych wyników. Jeśli przypadek powoduje zmianę implementacji, przenieś go do pakietu regresji i zastąp go innym przypadkiem zweryfikowanym przez ekspertów z dziedziny.
Zakres pracy
Zakres operacyjny obejmuje podzbiór wymagań niefunkcjonalnych obciążenia roboczego. Definiuje limity zasobów i wykonywania, takie jak opóźnienie, koszt, użycie tokenu, ponawianie prób, wywołania narzędzi i czas oczekiwania na zatwierdzenie.
Kontrakt definiuje prawidłowe zachowanie. Obwiednia definiuje limity operacyjne, w ramach których system musi działać. Umowa może odwoływać się do wersji obwiedni pracy, gdy te limity są częścią kryteriów akceptacji. Wersjonuj kopertę niezależnie, aby limity operacyjne mogły ulec zmianie bez ponownego definiowania wymagań behawioralnych, które nie uległy zmianie. Kontrakty zachowania i obszary pracy nie wymagają relacji jeden do jednego.
Powtórka
Projektowanie z myślą o replay
Replay, jak sugeruje nazwa, ponownie uruchamia kroki wnioskowania systemu, podając zebrane odpowiedzi narzędzi i interfejsu API lub wyniki RAG. Takie podejście ułatwia dostosowanie monitu i zidentyfikowanie wszelkich brakujących dowodów. Pozwala to uniknąć powtarzających się wywołań do interfejsów API na żywo lub narzędzi PROTOKOŁU MCP (Model Context Protocol), które mogą być kosztowne, podlegać limitom liczby żądań lub zwracać dane, które zmieniają się w czasie.
Zbieraj dane replay w środowisku produkcyjnym. Usuń lub zamaskuj poufne dane zgodnie z zasadami przed rozpoczęciem analizy lub przeglądu eksperta. Zachowaj treści odpowiedzi i ich argumenty żądania bez zmiany znaczenia wielkości liter. W przypadku gdy zanonimizowanie usuwa wymagane dowody, należy użyć zatwierdzonego przyrządu i udokumentować to ograniczenie.
Przed dodaniem danych pochodzących z produkcji do złotego zestawu danych lub użyciem ich do utworzenia atrap testowych należy zlecić ekspertowi dziedzinowemu (SME) ich przegląd i opracowanie. Obiekty pozorowane mogą symulować odpowiedzi, więc replay może obsługiwać nowe i istniejące scenariusze bez konieczności stosowania danych produkcyjnych. Zobacz symulowane odpowiedzi za pomocą Dev Proxy i zestawy danych do oceny w usłudze Microsoft Foundry.
Konfigurowanie i uruchamianie powtórki
Wersjonuj zestawy danych odtwarzania używane do oceny i testów regresji. Aby porównać aktualizację z punktem odniesienia, uruchom obie implementacje względem tej samej wersji zestawu danych, używając tych samych przypadków i wersji ewaluatora. Zachowaj spójność innych warunków testowych z wyjątkiem zmiany, którą testujesz. Podczas dodawania lub poprawiania przypadków utwórz nową wersję zestawu danych i uruchom ponownie obie implementacje.
Podczas tworzenia można odtworzyć mniejszy zestaw przypadków, aby sprawdzić zachowanie, które zmieniasz. Jeśli nie masz jeszcze zarejestrowanych odpowiedzi dla nowego scenariusza, użyj symulowanych odpowiedzi i oznacz je etykietami w zestawie danych.
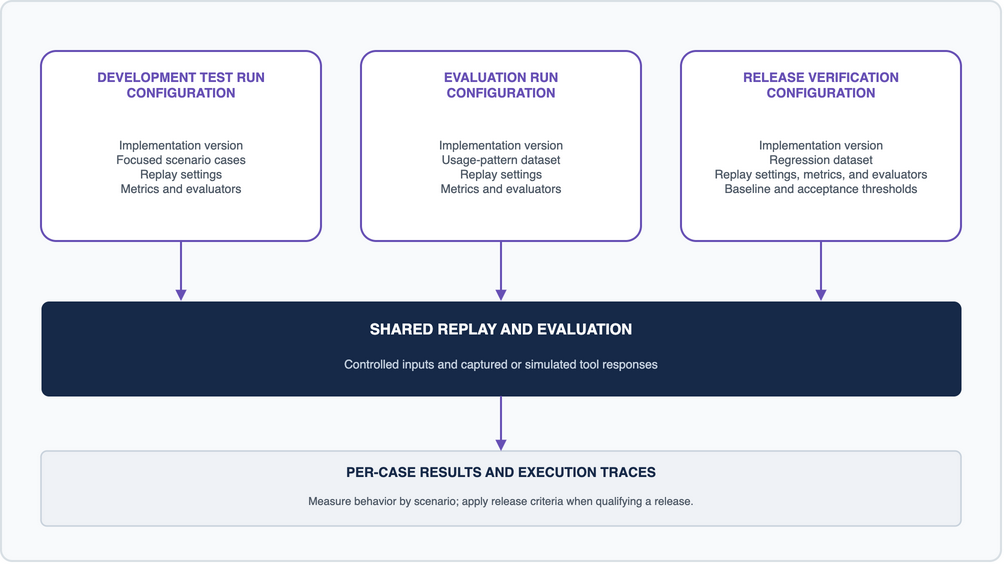
Wybierz cel uruchomienia:
| Konfigurowanie | Purpose |
|---|---|
| Testowanie programistyczne | Przetestuj nowe lub zmienione zachowanie podczas implementacji. |
| Evaluation | Mierz zachowanie w scenariuszach obsługiwanych przez obciążenie. |
| Weryfikacja wydania | Sprawdź pełny wymagany zestaw testów regresji względem progów akceptacji wydania i punktu odniesienia, jeśli ma to zastosowanie. |
Konfiguracja uruchamiania wykracza poza zestaw danych i ewaluatory. Obejmuje on również prompty, model, serwery interfejsu API/MCP, biblioteki pomocnicze i inne. Podczas przeprowadzania ocen musisz mieć wyraźną hipotezę i skorelowane zmiany, aby zapewnić, że każdy przebieg zmienia tylko minimalny zakres zmian. Dzięki temu można prawidłowo ocenić wpływ i uniknąć wielokrotnego uruchamiania tej samej aktualizacji z powodu braków w rejestrowaniu.
Ponowne odtwarzanie nie zastępuje testów jednostkowych ani integracyjnych. Każdy test sprawdza inny aspekt systemu oprogramowania i jest równie ważny. Zobacz Testuj i oceniaj obciążenia AI.
Na poniższym diagramie przedstawiono proces współdzielonego odtwarzania.
Przykład: Weryfikowanie zmiany agenta recenzji produktu
Załóżmy, że wersja 42 agenta przeglądu produktu zatwierdza przesłanie, które powinno zostać przesłane do zespołu ds. standardów, ponieważ zawiera dane osobowe. Zespół przygotowuje przypadek przy użyciu zabezpieczeń danych odtwarzania i używa ukierunkowanego testu programistycznego podczas weryfikacji implementacji dla kandydata 43.
Skonfiguruj przebieg oceny dla kandydata 43. Zestaw danych oceny musi zawierać normalne przypadki, a także zgodne z wymaganiami negatywne opinie, niepewne zgłoszenia i awarie zależności. Zaktualizuj ją o przypadki testujące funkcjonalność (reguła danych osobowych). Aktualizacja tworzy nową wersję zestawu danych. Uruchom ocenę i bazę odniesienia dla nowego zestawu danych. Odtwórz pełny zestaw danych, aby mierzyć dokładność decyzji, koszty i opóźnienia według scenariusza.
Zaktualizuj zestaw danych weryfikacji wydania o nowy przypadek użycia i uzyskaj zaktualizowaną wersję. Odwołuj się do rozszerzonej wersji zestawu danych i ustaw progi akceptacji. Odtwórz kandydata 43 i bazę 42 na tym samym rozszerzonym zestawie i względem zarejestrowanych dowodów.
Sprawdź istniejące i nowe przypadki testowe pod kątem zweryfikowanych oczekiwań. Spodziewaj się
approvenegatywnych opinii zgodnych z zasadami ihuman_reviewzgłoszeń zawierających dane osobowe. Upewnij się, że zgłoszenia oczekujące na przegląd człowieka pozostają nieopublikowane.Zapisz wyniki i ślady poszczególnych przypadków wraz z odpowiadającą im wersją konfiguracji. Oblicz metryki dla każdego scenariusza. Użyj wyników oceny, aby poprawić implementację i wyników weryfikacji wersji, aby zdecydować, czy wersję kandydującą można wydać. Ogólna poprawa nie unieważnia niespełnionego obowiązkowego wymagania.
Architecture
Aby za pomocą metodologii ABE zaprojektować funkcje obciążenia roboczego, zacznij od odnajdywania problemów i ujęcia oczekiwanego zachowania w kontrakcie. Następnie zdecyduj, czy obciążenie wymaga wykonania sterowanego przez agenta. Współpracuj z właścicielem firmy i zespołem inżynierów, aby wyjaśnić potrzeby i założenia użytkowników. Wyprowadź scenariusze z kontraktów behawioralnych, zidentyfikuj wiedzę i dowody wymagane przez system oraz zdecyduj, które mechanizmy kontrolne otaczającego systemu musi on egzekwować.
Kontrakt zachowania i biblioteka scenariuszy łączą system dwupętlowy oraz ukierunkowują wdrażanie i doskonalenie. Wewnętrzna pętla deweloperska weryfikuje zmiany przed wydaniem. Pętla zewnętrzna produkcji zbiera ślady wykonania i opinie, aby zidentyfikować błędy lub zmienione wymagania.
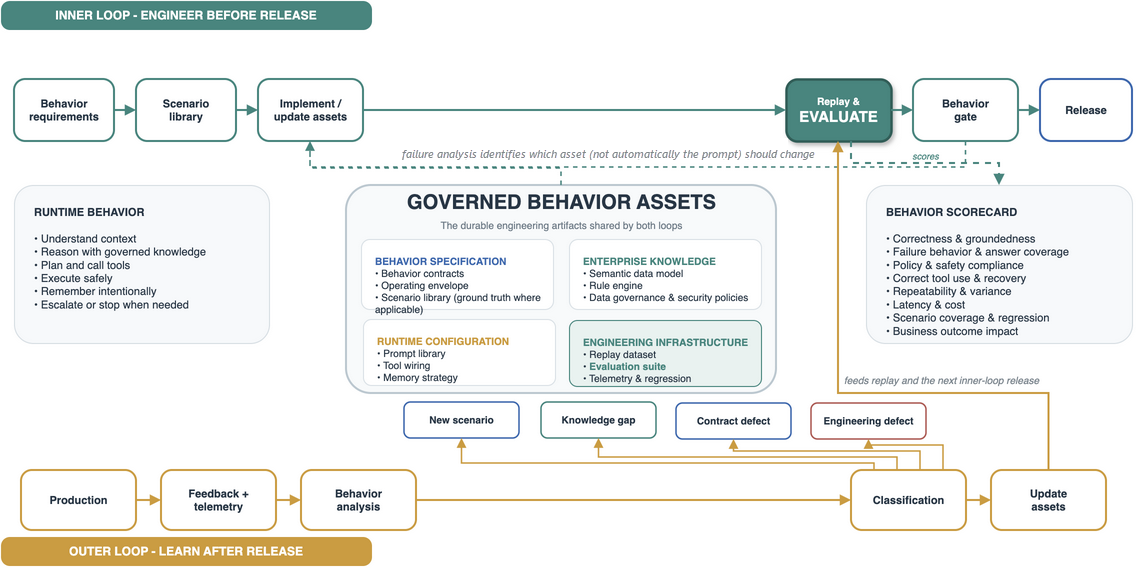
ABE dzieli tę pracę na pięć obszarów odpowiedzialności inżynieryjnej: określanie, osadzanie, sterowanie, weryfikacja i obserwacja. Te obowiązki są logiczne, a nie pięć wymaganych usług ani sekwencyjnych kroków wykonywania. Praca nad jedną funkcjonalnością może obejmować kilka obowiązków.
Odpowiedzialna SI i bezpieczeństwo są przekrojowymi zagadnieniami we wszystkich pięciu obszarach odpowiedzialności systemu. Określenie odpowiedzialności sprawia, że oczekiwania dotyczące odpowiedzialnej sztucznej inteligencji i wymagania dotyczące zabezpieczeń są jasno określone w kontraktach behawioralnych. Funkcja kontrolna wdraża reguły dostępu i zabezpieczenia uruchamiania, które obsługują te wymagania.
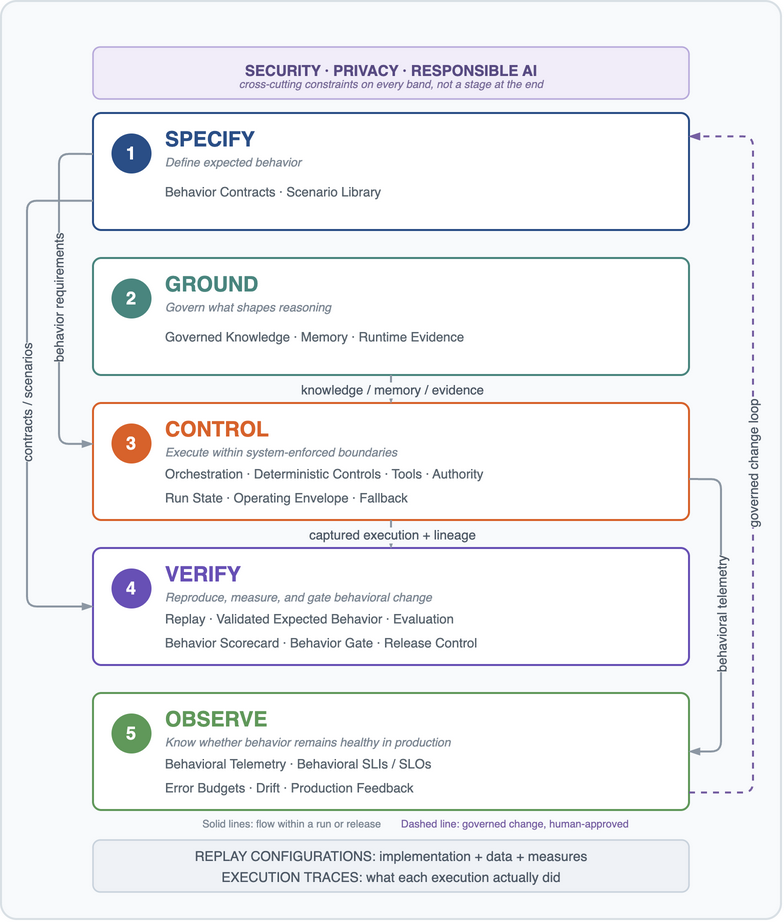
Określenie i podstawy zapewniają wczesne kontrole gotowości i wykonalności projektu. Określ, problem i to, co oznacza sukces. Ground ocenia, czy wymagane informacje są dostępne i użyteczne zgodnie z mającymi zastosowanie wymaganiami dotyczącymi dostępu. Użyj tych wyników, aby zidentyfikować luki przed zatwierdzeniem wdrożenia, a następnie zweryfikować pozostałe założenia w proof of concept. Aby uzyskać więcej informacji, zobacz Dostosowywanie strategii technicznej do wymagań biznesowych.
Użyj kontraktu behawioralnego i biblioteki scenariuszy, aby porównać wykonalne rozwiązania projektowe. Implementacja deterministyczna lub stały przepływ pracy z krokami wspomaganymi przez model może spełniać wymagania. Wybierz podejście agentyczne, gdy ocena pokazuje korzyści, które uzasadniają dodatkowe koszty, opóźnienia i złożoność operacyjną. Aby uzyskać wskazówki dotyczące wybierania podejścia do wykonywania, zobacz stałe przepływy pracy a systemy kierowane przez agenta.
Określić
Użyj myślenia projektowego, aby zrozumieć rzeczywistą potrzebę użytkownika przed wybraniem tego, co i jak zautomatyzować. Współpracuj z użytkownikami, właścicielami firm i MŚP, aby uzgodnić dopuszczalne wyniki, ograniczenia i sposób zachowania w przypadku awarii.
Ujmij te wymagania w wersjonowanym kontrakcie zachowania i wyprowadź scenariusze testowe, aby utworzyć bibliotekę scenariuszy. Zespoły produktowe i inżynieryjne wspólnie przeglądają zmiany w oczekiwanym zachowaniu. Aby zająć się kwestiami związanymi z odpowiedzialną sztuczną inteligencją i bezpieczeństwem, należy zaangażować ekspertów w danej dziedzinie, specjalistów ds. ryzyka i specjalistów ds. bezpieczeństwa. Wersjonuj zarówno kontrakt zachowania, jak i bibliotekę scenariuszy. Informacje o wersji powinny wskazywać obsługiwaną i opublikowaną wersję kontraktu i wersję biblioteki scenariuszy.
Przejrzyj zmiany wymagań wraz z planem działania produktu i sprawdź ponownie implementację pod kątem tych zmian i planu. W przypadku obciążeń obejmujących wielu agentów zdefiniuj kontrakt end-to-end i dodaj kontrakty przekazania, w których zmieniają się obowiązki, wymagania dotyczące dowodów lub uprawnienia.
W przypadku agenta przeglądu produktu uzgodnij z zespołem ds. standardów, które zgłoszenia kwalifikują się do automatycznego zatwierdzania, kiedy wymagana jest weryfikacja przez człowieka oraz jak obsługiwać niedostępne zasady lub kolejkę weryfikacji.
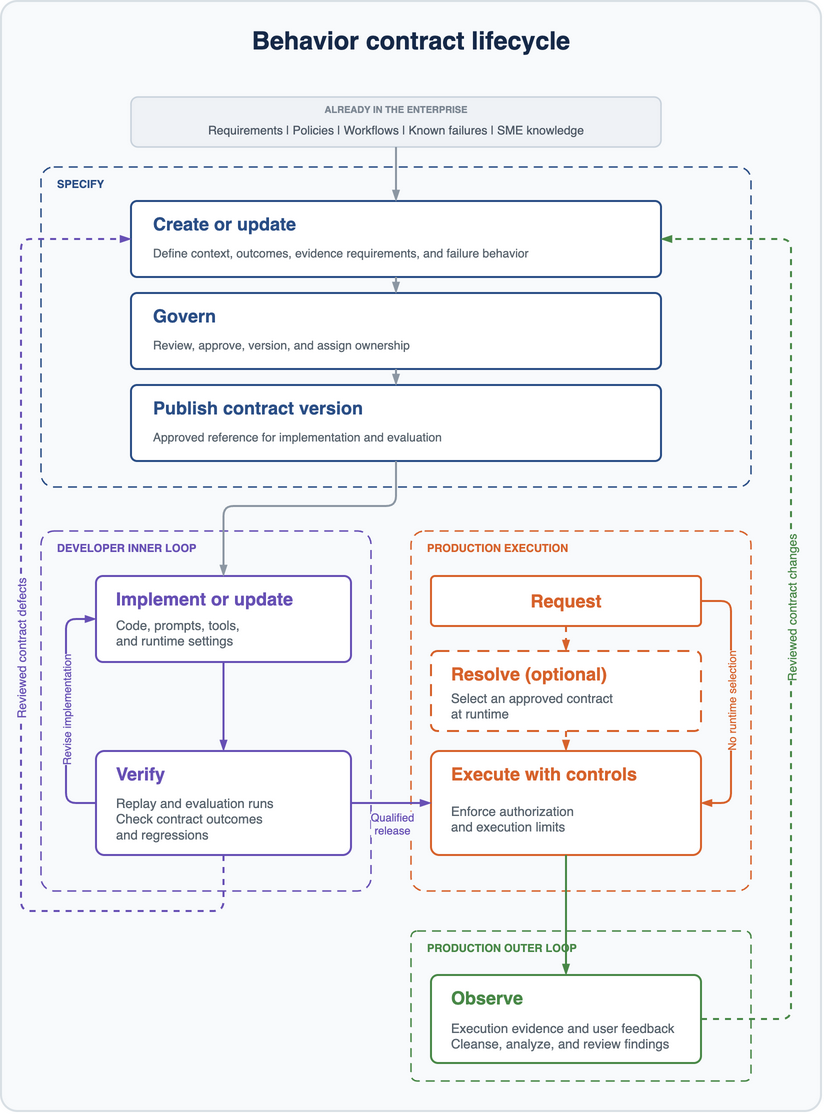
Poniższy diagram pokazuje, jak kontrakt zachowania i biblioteka scenariuszy kierują implementacją i weryfikacją. Skorzystaj z biblioteki scenariuszy, aby pokierować opracowaniem złotego zestawu danych i zdefiniować kryteria oceny. Raportuj wyniki według scenariusza, w tym liczbę przetestowanych przypadków, aby ogólny wynik nie ukrywał luk. Przejrzane ustalenia z oceny i środowiska produkcyjnego mogą prowadzić do aktualizacji biblioteki scenariuszy lub kontraktu behawioralnego.
Aby zapoznać się z technikami discovery, zobacz Przeprowadzanie badań użytkowników i dzielenie się wnioskami.
Ziemia
Ground określa wiedzę i przesłanki przekazywane agentowi, w tym pobrane informacje, odpowiedzi narzędzi, reguły biznesowe i pamięć. Przygotowuje odpowiednie, autoryzowane informacje dla każdego zadania przy zachowaniu jego źródła i autorytetu. Pochodzenie, świeżość i wrażliwość to niektóre kluczowe atrybuty, które muszą być prawidłowo reprezentowane.
Aby przygotować informacje nadzorowane dla agenta:
- Wybierz źródła autorytatywne i przypisz właścicieli, aby je utrzymywać.
- Zidentyfikuj wymagania dostępu i zachowaj metadane uprawnień i poufności dla odpowiedzialności kontroli.
- Przygotuj informacje w formie, z której agent może korzystać bez utraty znaczenia biznesowego, źródła lub wersji.
Podczas projektowania upewnij się, że źródła mogą dostarczyć dowody wymagane przez kontrakt behawioralny. W przypadku agenta recenzji produktu połącz każdą ocenę z pełnym tekstem zgłoszenia, jego poprawką i odpowiednią wersją zasad. Jeśli brakuje wymaganych dowodów lub są niedostępne, rozwiąż problem z danymi lub dostępem, zawęź zakres lub odrocz objętą tym funkcję.
W czasie wykonywania warstwa pobierania raportuje, czy odpytywanie zwróciło dane, czy nie znalazło żadnych dopasowań, czy nie powiodło się. Aplikacja używa tego stanu wraz z metadanymi dowodów, aby określić, czy kontynuować, czy postępować zgodnie z odpowiedzią określoną w kontrakcie na niewystarczające dowody.
Zachowaj definicje biznesowe i reguły w wersjonowanych zasobach zarządzanych przez obciążenie, niezależnie od monitów i modeli. Użyj kontraktu danych lub modelu semantycznego, aby zdefiniować strukturę i znaczenie informacji wymienianych z innymi agentami i systemami.
Poniższa tabela odróżnia definicje biznesowe od materiału dowodowego dla określonego żądania. Platforma ontologii lub modelu semantycznego może pomóc w organizowaniu tych definicji, gdy agenci i systemy potrzebują wspólnych pojęć biznesowych i relacji.
| Element | Role | Przykład recenzji produktu |
|---|---|---|
| Ontologia | Definiuje wspólne pojęcia biznesowe i ich relacje. | Zgłoszenie ocenia produkt. Decyzja moderacyjna dotyczy wersji zgłoszenia i wersji polityki. |
| Semantyczny model danych | Mapuje dane przedsiębiorstwa na te pojęcia biznesowe za pomocą wspólnych definicji i relacji. | Łączy zgłoszenia, reguły polityki i decyzje moderowania za pomocą identyfikatorów i odwołań do wersji. |
| Dowody działania w czasie wykonywania | Dostarcza konkretne rekordy i obserwacje potrzebne do bieżącego zadania. | Przesłany tekst zawiera dane osobowe, a odpowiednie zasady wymagają przeglądu przez człowieka. |
Aby zapoznać się z przykładami implementacji, zobacz powiązanie danych ontologii w usłudze Fabric (wersja zapoznawcza) i modele semantyczne Power BI.
Silnik reguł lub przepływ pracy można ustanowić w celu zastosowania reguł biznesowych w kodzie deterministycznym przed przekazaniem wyników do agenta. Przetestuj te reguły w sposób powtarzalny na przypadkach zweryfikowanych przez ekspertów domenowych, aby sprawdzić, czy implementacja jest zgodna z zamierzonymi zasadami i zmniejszyć niepewność implementacji.
Podczas tworzenia kontekstu zidentyfikuj źródło i podmiot wydający wytyczne biznesowe, bieżące dowody i zapamiętane informacje. Zdefiniuj, co agent może zapisywać w pamięci i jak długo je przechowywać. Pamięć nie może zastąpić rekordów autorytatywnych i nie może być traktowana tak samo jak prompty lub instrukcje.
Na poniższym diagramie pokazano, jak przygotować i połączyć wiedzę, dowody i pamięć agenta.

Control
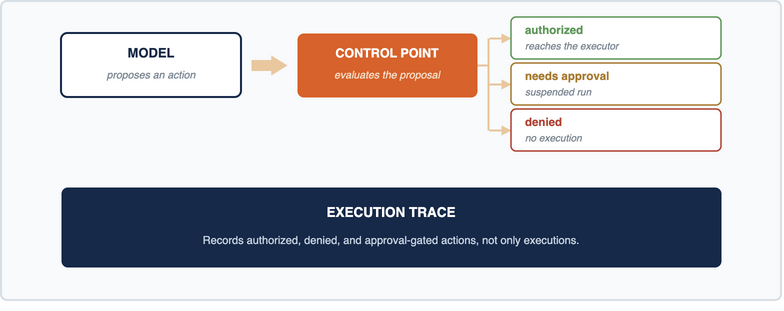
Control chroni obciążenie robocze za pomocą uwierzytelniania, autoryzacji i ładu w czasie wykonywania. Określa, kto może uzyskać dostęp do systemu, co każdy wywołujący i agent może wykonać oraz jakie działania wymagają zatwierdzenia. Wymuszaj te decyzje w kodzie aplikacji i połączonych usługach, a nie w modelu.
Postępuj zgodnie z najlepszymi rozwiązaniami w zakresie zabezpieczeń i przeprowadzaj modelowanie zagrożeń, aby zdecydować, które zabezpieczenia środowiska uruchomieniowego mają być implementowane. Diagram przepływu danych (DFD) pokazuje, jak informacje są przemieszczane między osobami inicjującymi wywołanie, agentami, narzędziami i magazynami danych, w tym gdzie przepływ informacji przekracza granice zaufania. Użyj tej analizy, aby określić, gdzie wymusić kontrole dostępu, ograniczyć udostępnianie danych i wymagać zatwierdzeń.
Te granice zaufania są częścią obrony przed atakami. Na przykład pobrana zawartość lub odpowiedzi narzędzia mogą zawierać złośliwe instrukcje. Kontrole dostępu i punkty zatwierdzania muszą być nadal stosowane, jeśli model postępuje zgodnie z tymi instrukcjami. Przestrzegaj zasad ochrony warstwowej i Zero Trust. Połącz te zabezpieczenia z innymi zabezpieczeniami przed prompt injection, zamiast traktować którekolwiek pojedyncze zabezpieczenie jako wystarczające.
Uwierzytelnij tożsamości wywołującego i agenta, a następnie autoryzuj każdy dostęp do danych i akcję narzędzia w kontekście danego zadania i zasobu docelowego. Stosuj zasadę najmniejszych uprawnień i wymuś wymagania dostępu określone w ramach podstawowej odpowiedzialności. Podczas delegowania pracy zachowaj kontekst autoryzacji wywołującego i odwołania do dowodów oraz ponownie sprawdź uprawnienia przy każdym przekazaniu. Delegowanie nie może rozszerzać uprawnień. Jeśli odmówiono dostępu, postępuj zgodnie ze zdefiniowaną procedurą wstrzymania lub eskalacji zamiast obchodzić odmowę dostępu za pośrednictwem innego narzędzia lub agenta.
Nadzór środowiska uruchomieniowego wymusza również wymagane zatwierdzenia, obowiązkowe kroki przepływu pracy i limity zakresu operacyjnego, takie jak budżety i limity szybkości. Spróbuj ponownie wykonać tylko operacje, które można bezpiecznie powtórzyć. Po osiągnięciu limitu postępuj zgodnie z zachowaniem kontraktu w przypadku zatrzymania lub trybu awaryjnego. Te mechanizmy kontroli uzupełniają szerszy projekt odporności obciążenia roboczego.
W przykładzie agenta recenzji produktu dostęp jest ograniczony do przypisanego zgłoszenia, odpowiednich zasad i działań moderacyjnych. Przepływ pracy publikacji sprawdza uprawnienia, wersję zgłoszenia i wersję zasad przed opublikowaniem zatwierdzonego przeglądu. Wyklucz zmiany zasad i akcje konta klienta poza uprawnieniami agenta.
Na poniższym diagramie przedstawiono sposób oceniania i rejestrowania proponowanych akcji.
Aby zapoznać się z przykładem wyszukiwania, zobacz Zaprojektuj bezpieczne wielodostępne rozwiązanie wnioskowania RAG. Aby uzyskać wskazówki dotyczące tożsamości i ochrony warstwowej, zobacz Tożsamość, dostęp i zasada najmniejszych uprawnień oraz Zasady projektowania zabezpieczeń.
Przykłady mechanizmów sterowania wykonywaniem zaimplementowanych za pośrednictwem orkiestracji przepływu pracy można znaleźć w temacie Workflow-oriented multi-agent patterns (Wzorce wieloagentowe zorientowane na przepływ pracy).
Zweryfikować
Verify łączy testy pojedynczego przypadku z oceną na poziomie zestawu danych w wewnętrznej pętli dewelopera.
Sprawdź pojedynczy przypadek
Podczas implementacji uruchom lub powtórz przypadek testowy przy użyciu zarejestrowanych lub symulowanych odpowiedzi. Sprawdź ślad wykonania, aby porównać dowody, wywołania narzędzi, decyzje sterujące i wynik z kontraktem i scenariuszem zachowania. Użyj wyników, aby debugować i uściślić implementację.
Oceny
Uruchamianie ocen w całym wersjonowanym zbiorze danych w celu mierzenia zachowania w obsługiwanych scenariuszach. Zdefiniuj metryki i progi akceptacji z kontraktu behawioralnego. W poniższej tabeli opisano scenariusze i powiązane środki dla agenta recenzji produktu.
| Scenario | Mierzenie |
|---|---|
| Negatywna opinia spełnia kryteria niskiego ryzyka określone w zasadach. | Jak często agent prawidłowo go zatwierdza. |
| Zgłoszenie zawiera dane osobowe, które wymagają przeglądu przez człowieka. | Jak często agent niepoprawnie go zatwierdza i czy wymagane przekazania kończą się bez publikacji. |
| Usługa zasad grupy jest niedostępna. | Czy zgłoszenie pozostaje nieopublikowane i trafia do weryfikacji przez człowieka, czy pozostaje w oczekiwaniu, jeśli przekazanie się nie powiedzie. |
Porównaj kandydata i punkt odniesienia przy użyciu tych samych wersji zestawu danych i ewaluatora. Aby uzyskać więcej informacji, zobacz Konfigurowanie i uruchamianie odtwarzania.
Raportuj wyniki według scenariusza, dzięki czemu zagregowane wyniki nie ukrywają regresji. Powtórz przypadki testowe, aby sprawdzić spójność. Zdefiniuj liczbę przebiegów i kryteriów akceptacji przed oceną. Rejestruj specyfikację zachowania, zestaw danych, ewaluator i wersje progów z wynikami.
Przetestuj długotrwałe przypadki i zachowanie w przypadku awarii na granicach działania. Zdefiniuj liczbę kroków i wywołań narzędzi, ale wymagaj dokładnej ścieżki tylko wtedy, gdy specyfikacja określa jedną. W przypadku obciążeń obejmujących wiele agentów testuj przekazania, a także kompleksowe wyniki.
Uruchom te kontrole obok testów jednostkowych i integracyjnych. Blokuj wydania, które nie spełniają wymaganych progów scenariuszy. Aby uzyskać wskazówki dotyczące wydania, zobacz Lista kontrolna ścieżki wdrożenia.
Obserwuj
Observe analizuje przebiegi produkcyjne w celu zidentyfikowania udanego działania, niepowodzeń i ich przyczyn. System powinien zbierać opinie użytkowników, aby ułatwić analizę. Rozpocznij analizę od klasyfikacji scenariusza:
Klasyfikuj zarejestrowane przebiegi przy użyciu kontekstu zadania i wykonywania. Dopasuj każdy przebieg do odpowiedniego scenariusza i wersji umowy. Flaguj nieznane lub niejednoznaczne przypadki do przeglądu.
Porównaj wynik z oczekiwanym zachowaniem scenariusza i połącz te informacje z opiniami użytkowników, aby ocenić powodzenie lub niepowodzenie. Pozostaw sprawy bez oceny, gdy dowody są niewystarczające.
Analizuj awarie przy użyciu śladów i opinii recenzenta. Grupuj wyniki według przyczyn, takich jak luki w wiedzy, błędy implementacji lub awarie zależności, lub niejasne wymagania.
Niech właściciele produktów, eksperci dziedzinowi i inżynierowie przejrzą wyniki i zdecydują, co zmienić. Zweryfikuj oczekiwane wyniki przed dodaniem przygotowanych przypadków do zakresu testów regresji. Zarejestruj przyczynę każdej zmiany i sprawdź ją przed wydaniem.
W przykładzie agenta recenzji produktu przekierowanie zgłoszenia zawierającego dane osobowe do weryfikacji przez człowieka przy jednoczesnym pozostawieniu go nieopublikowanym jest prawidłowym działaniem. Zatwierdzenie tego jest przykładem porażki. Żądanie wsparcia dla przeglądów obrazów raczej wskazuje na potencjalną zmianę zakresu.
Przechwyć dane wejściowe zadania, żądania narzędzi i odpowiedzi, pobraną zawartość dostarczoną do modelu i dane wyjściowe. Zachowaj wersje źródłowe, decyzje kontrolne i awarie. Połącz opinie użytkowników i recenzentów z runem i wydaniem. Zminimalizuj przechwycone dane, wymuś limity dostępu i przechowywania, a następnie postępuj zgodnie ze wskazówkami dotyczącymi przygotowania danych z powtórek przed analizą lub curacją zestawu danych.
Aby zapoznać się z przykładem łączenia wyników produkcji z oceną, zobacz pętlę jakości obserwowalności agenta.
Lista kontrolna ścieżki adopcji
Zacznij od minimalnej wykonalnej implementacji wokół jednego istotnego zachowania w Twoim obciążeniu roboczym.
Najmniejsza użyteczna implementacja ABE nie jest platformą. Jest to jedno zachowanie, które jest jawne, powtarzalne, oceniane i objęte kontrolą. Pierwsza pętla robocza znajduje się w specify i verify. Unikaj tworzenia szerokiej platformy, zanim zespół będzie mógł użyć jednej specyfikacji, aby zapobiec, wykryć lub zdiagnozować rzeczywisty problem behawioralny.
- Wybierz ograniczoną, istotną sytuację i zidentyfikuj właścicieli obszaru produktowego i inżynieryjnego oraz zaangażuj ekspertów w dziedzinie.
- Napisz jeden zweryfikowany kontrakt behawioralny, w tym dowody i stany błędu.
- Zdefiniuj scenariusze dla przypadków normalnych, granicznych, niewystarczających dowodów i awarii zależności. Wygeneruj syntetyczne przypadki z tych scenariuszy, aby rozpocząć testowanie.
- Użyj przypadków syntetycznych, aby pomóc ekspertom dziedzinowym w zbieraniu i curowaniu rzeczywistych przypadków obciążeń dla oddzielnego złotego zestawu danych.
- Przechwytywanie lub symulowanie stabilnych odpowiedzi narzędzi i bazy wiedzy na potrzeby odtwarzania.
- Dodaj deterministyczne kontrole oraz tylko tych ewaluatorów opartych na ocenie, którzy są wymagani przez umowę.
- Uruchom scenariusze w ciągłej integracji i blokuj wydania w przypadku krytycznych błędów.
- Rejestruj wystarczającą ilość informacji z przebiegów produkcyjnych, aby zidentyfikować umowę, implementację, ścieżkę audytu i wynik.
- Przekształć zweryfikowane ustalenia z produkcji w scenariusze regresji.
Zmiany promptów, ustawień modelu i kodu aplikacji mogą zmieniać zachowanie agenta. Zweryfikuj te zmiany przed ich użyciem w środowisku produkcyjnym. Zarejestruj przetestowane wersje, konfigurację oceny i wyniki. Postępuj zgodnie z bezpiecznymi praktykami wdrażania, aby stopniowo wprowadzać zmiany i zaplanować sposób przywrócenia działania, jeśli spowodują problemy. Uwzględnij zmiany konfiguracji w planie odzyskiwania.
Rozwijaj tę pierwszą pętlę w miarę poznawania potrzeb twojego obciążenia. Gdy agenci i systemy potrzebują udostępnionych definicji biznesowych i relacji, semantyczny model danych może zapewnić te podstawy. Gdy decyzje są zgodne z jawnymi regułami biznesowymi, silnik reguł może stosować te reguły poza modelem. Zachowaj mechanizmy kontroli dostępu i dowody wykonania wymagane dla Twojego obciążenia roboczego od samego początku, a następnie rozszerz monitorowanie i automatyzację, gdy uzasadniają to czynniki ryzyka i ustalenia z eksploatacji produkcyjnej.
Implementacja ABE na platformie Azure
Usługa ABE jest niezależna od platformy. Azure zapewnia usługi, których można użyć do wspierania pięciu obszarów odpowiedzialności inżynieryjnej.
Poniższy diagram mapuje każdy obszar odpowiedzialności ABE na usługi platformy Azure, które należy wziąć pod uwagę dla Twojego obciążenia roboczego.
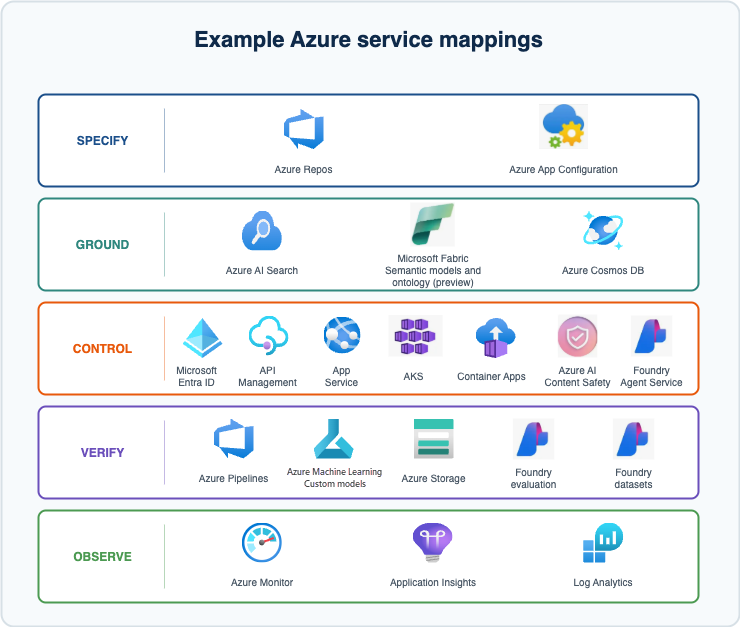
Dla każdej odpowiedzialności inżynieryjnej połącz możliwości Azure z kontraktami, kontrolkami i procesami przeglądu, które utrzymuje twój zespół.
| Odpowiedzialność | Możliwości platformy Azure | Praca twojego zespołu |
|---|---|---|
| Określić | Kontrola wersji i przepływy pracy przeglądu. | Tworzenie i utrzymywanie kontraktów behawioralnych, scenariuszy i zakresów operacyjnych. |
| Ziemia | Dostęp do danych, pobieranie i modelowanie semantyczne. | Własność danych źródłowych, wymagania dostępu i ocena kwalifikowalności dowodów. |
| Control | Hostowanie, tożsamość, bramy i punkty integracji zarządzania. | Reguły autoryzacji, zatwierdzania i wykonywania. |
| Zweryfikować | Magazyn zestawów danych, usługi ewaluacyjne i wykonywanie ciągłej integracji/ciągłego wdrażania. | Implementacja replay, oczekiwane wyniki i kryteria wydania. |
| Obserwuj | Zbieranie danych telemetrycznych, zapytania i alerty. | Przechwytywanie danych o zasięgu, czyszczenia, korelacji informacji zwrotnych i analizy. |
Przed wybraniem dowolnej usługi Azure sprawdź, czy jej funkcje, regiony i interfejsy API odpowiadają Twojemu obciążeniu roboczemu. Preferuj usługi generally available (GA) oraz mechanizmy kontroli należące do aplikacji na potrzeby obowiązkowego wymuszania i kontroli przed wydaniem. Niektóre funkcje wymienione w poniższych sekcjach to funkcje w wersji zapoznawczej i mogą nie być odpowiednie dla Twoich obciążeń roboczych.
Określ na platformie Azure
Zachowaj kontrakty, scenariusze, operating envelopes i konfiguracje odtwarzania w istniejącym repozytorium Git, na przykład Azure Repos lub GitHub. Postępuj zgodnie ze wspólnymi zasadami przeglądu, gdy zmiana wpływa na oczekiwane zachowanie. Użyj przeglądu technicznego w celu przeprowadzenia konserwacji technicznej.
Ground w usłudze Azure
Połącz agenta z autorytatywnymi źródłami określonymi dla odpowiedzialności za uziemienie. W przypadku agenta przeglądu produktu należy rozpocząć od istniejących interfejsów API aplikacji witryny internetowej w celu pobrania zgłoszeń oraz obecnie zatwierdzonej polityki.
Jeśli potrzebujesz wyszukiwania w wielu źródłach wiedzy, rozważ Wyszukiwanie AI platformy Azure agentic retrieval. Może zwracać treści ugruntowujące z opcjonalnymi odwołaniami źródłowymi i dziennikiem aktywności. Zmierz koszt i opóźnienie wybranego podejścia do pobierania.
Jeśli dane biznesowe znajdują się już w Microsoft Fabric, narzędzie Fabric IQ może połączyć agentów Microsoft Foundry z modelami semantycznymi i elementami ontologii. Integracja i możliwości ontologii są w wersji zapoznawczej. Sprawdź, w jaki sposób połączenie jest uwierzytelniane, do których danych może uzyskiwać dostęp oraz czy dane mogą opuścić granice zgodności platformy Azure.
Wersjonuj definicje semantyczne oddzielnie od implementacji agenta i zapisuj ich wersje wraz z dowodami testowymi. Integracja Git w Fabric obsługuje elementy ontologii w wersji zapoznawczej.
Sterowanie i uruchamianie w Azure
Agentów promptów i niestandardowych hostowanych agentów można uruchamiać w Foundry Agent Service. W przypadku innych wymagań dotyczących środowiska uruchomieniowego lub wdrożenia rozważ użycie usługi AKS, Azure Container Apps lub Azure App Service. Zobacz Wybieranie usługi obliczeniowej Azure, aby porównać opcje. Zaimplementuj reguły uwierzytelniania, zatwierdzania i wykonywania w aplikacji i połączonych usługach.
W przypadku agentów usługi Foundry użyj tożsamości agentów Microsoft Entra w przypadku obsługiwanych połączeń MCP i połączeń między agentami. Gdy agent działa w imieniu użytkownika, sprawdź zarówno uprawnienia użytkownika, jak i uprawnienia agenta. Przed wdrożeniem sprawdź tożsamość i uprawnienia, z których agent będzie korzystać w czasie wykonywania.
Azure API Management może zarządzać współużytkowanymi punktami końcowymi MCP za pomocą zasad uwierzytelniania, limitów szybkości i przydziałów. Użyj Agent Framework middleware, aby dodać należące do aplikacji kontrole dla narzędzi funkcyjnych uruchamianych przez platformę. W przypadku narzędzi, które działają poza tą granicą, należy wymuszać obowiązkową autoryzację i zasady w bramie lub usłudze podrzędnej.
Gdy akcja wymaga potwierdzenia przez człowieka, użyj function-tool approval. Jeśli zatwierdzenia przepływu pracy muszą przetrwać ponowne uruchomienie, skonfiguruj trwały magazyn punktów kontrolnych i przywróć oczekujący stan zatwierdzenia przed dopuszczeniem wykonania. W przypadku narzędzi, które zmieniają stan, zweryfikuj dane wejściowe i dodaj zabezpieczenia idempotentności w funkcji wykonawczej akcji. Ustawienia orkiestracji wersji i kontroli z implementacją.
Prompt Shields w Bezpieczeństwo zawartości platformy Azure AI może wykrywać próby wstrzyknięcia poleceń w monitach użytkownika i dokumentach źródłowych. Połącz te kontrole z autoryzacją. Zdefiniuj sposób reagowania obciążenia roboczego na zablokowaną zawartość w kontrakcie behawioralnym i przetestuj tę odpowiedź.
W przypadku agenta przeglądu produktu dostęp do odczytu jest udzielany do przypisanych zgłoszeń i bieżącej polityki. Dostęp do zapisu jest ograniczony do operacji moderowania, które zatwierdzają zgłoszenie lub kierują je do przeglądu przez człowieka. Sprawdzanie wersji zgłoszenia i zasad jest wymuszane w przepływie pracy publikacji.
Zweryfikuj na platformie Azure
W Azure Blob Storage można przechowywać przygotowane przypadki odtwarzania i wyniki testów. Odwołuj się do określonych wersji zestawu danych w konfiguracjach odtwarzania i połącz przypadki pochodzące ze środowiska produkcyjnego z ich uruchomieniami źródłowymi. Ogranicz dostęp do chronionych spraw objętych wstrzymaniem i zachowanych dowodów produkcyjnych. Postępuj zgodnie ze wskazówkami dotyczącymi architektury Blob Storage dotyczącymi dostępu opartego na tożsamościach, ochrony danych i przechowywania.
Korzystając z zestawów danych ewaluacyjnych Foundry, można ocenić ukończone odpowiedzi lub wysłać dane wejściowe do agenta, aby wygenerować i ocenić nowe odpowiedzi. W przypadku kontrolowanego odtwarzania skonfiguruj adaptery zależności przed wywołaniem agenta. Publikuj zestawy danych jako kopie wykonawcze zarządzanej biblioteki scenariuszy i zastosuj te same ograniczenia dostępu do grupy kontrolnej.
Użyj testów deterministycznych dla kryteriów z jawnymi wartościami referencyjnymi lub regułami i użyj ewaluatorów opartych na modelu dla kryteriów opartych na ocenie. Niestandardowe moduły oceniające programu Foundry obsługują oba podejścia, a także zewnętrzne endpointy oceniania.
W przypadku agenta oceny produktu kontrola oparta na kodzie może porównać decyzję ustrukturyzowaną z oczekiwaną decyzją zespołu ds. standardów. Moduł oceniający oparty na modelu może ocenić, czy wyjaśnienie i przywołana reguła polityki uzasadniają tę decyzję, biorąc pod uwagę przesłany tekst. Ewaluatory Rubric i niestandardowe ewaluatory są w wersji zapoznawczej.
Sprawdź zgodność narzędzia ewaluatora przed użyciem wyników w bramce. W przypadku konwersacji zawierających wywołania Wyszukiwanie AI platformy Azure lub wywołania agenta danych Fabric nie używaj wyników tool_call_accuracy, tool_input_accuracy, tool_output_utilization, tool_call_success ani groundedness. Użyj asercji kontraktów deterministycznych lub innej obsługiwanej metody oceny.
Zapisz wyniki i ślady poszczególnych przypadków przy użyciu konfiguracji, która je wygenerowała. Zastosuj progi wydania w potoku i zablokuj wydanie, jeśli wymagany scenariusz zakończy się niepowodzeniem. Podczas porównywania implementacji należy używać tych samych przypadków i wersji ewaluatorów. W przypadku trenowania modeli niestandardowych w Azure Machine Learning uwzględnij ich wersje w konfiguracji.
Obserwuj na platformie Azure
Śledzenie usługi Foundry używa zasobu usługi Azure Monitor Application Insights połączonego z projektem. Dodaj instrumentację do narzędzia aplikacji i kodu pobierania, aby przechwytywać wszelkie dodatkowe potrzebne dowody.
Zdecyduj, którą zawartość chcesz zarejestrować. Integracja śledzenia po stronie klienta programu Foundry obejmuje ustawienia rejestrowania zawartości komunikatów. Sprawdź, czy instrumentacja przechwytuje wymagane odpowiedzi narzędzi i pobraną zawartość wraz z nazwami operacji i chronometrażem. Zminimalizuj lub zamaskuj wrażliwe ładunki danych przed eksportem telemetrii i zachowaj tylko dowody dozwolone przez zasady danych.
Rozważ użycie oceny śladów (wersja zapoznawcza), aby ocenić zachowane ślady usługi Application Insights spełniające wymagania dotyczące czyszczenia. Ocenia ona istniejące interakcje bez ponownego uruchamiania żądań, w tym obsługiwane trace’y OpenTelemetry z agentów spoza rozwiązania Foundry. Użyj tych wyników, aby zbadać zachowanie na produkcji, a następnie zweryfikować wszelkie wynikowe zmiany implementacji za pomocą odtwarzania i oceny przed wydaniem. Ta funkcja jest dostępna w publicznej wersji zapoznawczej, nie ma umowy dotyczącej poziomu usług i nie jest zalecana w przypadku obciążeń produkcyjnych. Nie polegaj na tym przy podejmowaniu decyzji dotyczących monitorowania produkcji ani wydań.
Użyj zapytań Log Analytics i alertów Azure Monitor, aby zbadać błędy zachowania i naruszenia dopuszczalnego zakresu pracy. Widok szczegółów agenta usługi Application Insights, obecnie w wersji zapoznawczej, może pomóc w zbadaniu poszczególnych przebiegów. Przekaż przejrzane wyniki i przygotowane przypadki testowe do następnego cyklu zmian i odtwarzania.
Important
Twój zespół definiuje kontrakt zachowania i nadaje mu wersje, implementuje jego mechanizmy sterujące i ustawia kryteria przejścia przez bramkę zachowania. Użyj wyników weryfikacji wydania, aby zdecydować, czy obciążenie robocze jest gotowe do wdrożenia.
Contributors
Microsoft utrzymuje ten artykuł. Następujący współautorzy napisali ten artykuł.
Główni autorzy:
- Yang Song | Główny inżynier oprogramowania
Inni współautorzy:
- Chad Kittel | Główny inżynier oprogramowania
- Bryan Ostdiek | Główny data scientist
- Peter Parker | Główny inżynier rozwiązań, strateg i architekt chmury Azure AI
- Rama Pyarasani | Menedżer multidyscyplinarnych inżynierów delegowanych terenowo
- Ronnie Yates | Dyrektor generalny, dział inżynierii wdrożeń terenowych
Aby wyświetlić niepubliczne profile serwisu LinkedIn, zaloguj się do serwisu LinkedIn.
Następne kroki
- Agenci Microsoft Foundry
- Ocena agentów sztucznej inteligencji
- Agentowe pobieranie danych w Wyszukiwanie AI platformy Azure
- Monitorowanie agentów sztucznej inteligencji za pomocą usługi Application Insights
- Kontrakty behawioralne agenta (artykuł naukowy)