Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Pozyskiwanie dzienników to proces zbierania, przekształcania i przygotowywania danych dziennika z aplikacji, serwerów, kontenerów i usług w chmurze, dzięki czemu można przechowywać, analizować i monitorować je. Dzienniki przechwytują informacje, takie jak błędy, ostrzeżenia, wzorce użycia i wydajność systemu. Niezawodne pozyskiwanie dzienników zapewnia, że dane operacyjne i dane zabezpieczeń są dostępne niemal w czasie rzeczywistym na potrzeby rozwiązywania problemów i szczegółowych informacji. W tym artykule wyjaśniono, jak wysyłać dzienniki z usługi Fluentd do usługi Azure Data Explorer (Kusto), w tym kroki instalacji, konfiguracji i walidacji.
Przegląd
Co to jest Fluentd?
Fluentd to moduł zbierający dane typu open source, którego można użyć do ujednolicenia zbierania dzienników i routingu w wielu systemach. Obsługuje ponad 1000 wtyczek i udostępnia elastyczne opcje filtrowania, buforowania i przekształcania danych. Możesz użyć rozwiązania Fluentd w środowiskach natywnych dla chmury i przedsiębiorstwa na potrzeby scentralizowanej agregacji i przekazywania dzienników.
Co to jest usługa Azure Data Explorer?
Azure Data Explorer (ADX) to szybka, w pełni zarządzana usługa analizy zoptymalizowana pod kątem analizy w czasie rzeczywistym dużych ilości ustrukturyzowanych, częściowo ustrukturyzowanych i nieustrukturyzowanych danych. Usługa ADX używa języka Kusto Query Language (KQL) i jest powszechnie używana do telemetrii, monitorowania, diagnostyki i interaktywnej eksploracji danych.
Wymagania wstępne
- Ruby zainstalowany na węźle, na którym dzienniki muszą być przetwarzane. Aby zainstalować zależności Fluentd przy użyciu menedżera pakietów gem, zobacz instrukcje instalacji języka Ruby
- Dostęp do klastra i bazy danych usługi Azure Data Explorer.
- Aplikacja usługi Azure Active Directory z uprawnieniami do pozyskiwania danych.
Jak rozpocząć pracę z usługą Fluentd i usługą Azure Data Explorer
Zainstaluj aplikację Fluentd przy użyciu języka RubyGems:
gem install fluentdZainstaluj wtyczkę Fluentd Kusto:
gem install fluent-plugin-kustoSkonfiguruj aplikację Fluentd , tworząc plik konfiguracji (na przykład
fluent.conf) z następującą zawartością. Zastąp symbole zastępcze wartościami platformy Azure i wtyczki:<match <tag-from-source-logs>> @type kusto endpoint https://<your-cluster>.<region>.kusto.windows.net database_name <your-database> table_name <your-table> logger_path <your-fluentd-log-file-path> # Authentication options auth_type <your-authentication-type> # AAD authentication tenant_id <your-tenant-id> client_id <your-client-id> client_secret <your-client-secret> # Managed identity authentication (optional) managed_identity_client_id <your-managed-identity-client-id> # Workload identity authentication (optional) workload_identity_tenant_id <your-workload-identity-tenant-id> workload_identity_client_id <your-workload-identity-client-id> # Non-buffered mode buffered false delayed false # Buffered mode # buffered true # delayed <true/false> <buffer> @type memory timekey 1m flush_interval 10s </buffer> </match>
Aby uzyskać więcej szczegółów dotyczących konfiguracji i uwierzytelniania, zobacz dokumentację wtyczki Fluentd Kusto
Przygotowanie usługi Azure Data Explorer do wdrażania danych:
Utwórz klaster i bazę danych ADX. Zobacz Tworzenie klastra i bazy danych usługi Azure Data Explorer.
Utwórz aplikację usługi Azure Active Directory i przyznaj uprawnienia do pozyskiwania danych do bazy danych ADX. Zobacz Tworzenie rejestracji aplikacji Microsoft Entra w usłudze Azure Data Explorer.
Uwaga / Notatka
Zapisz klucz aplikacji i identyfikator aplikacji do użycia w przyszłości.
Utwórz tabelę na potrzeby zbierania dzienników. Przykład:
.create table LogTable (
  tag:string,
  timestamp:datetime,
  record:dynamic
)
Uruchom aplikację Fluentd z plikiem konfiguracji:
fluentd -c fluent.confZweryfikuj przetwarzanie dzienników przez:
Sprawdzanie pliku dziennika Fluentd, potwierdzenie braku błędów oraz że żądania ingestowania są wysyłane pomyślnie.
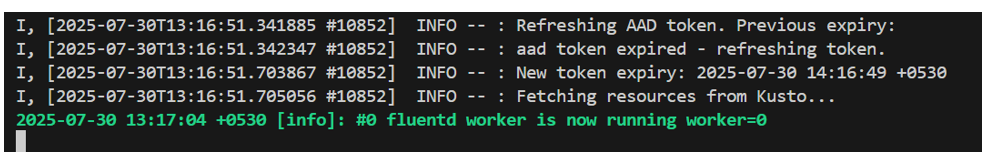
Zapytanie do tabeli ADX w celu upewnienia się, że dzienniki zostały prawidłowo pozyskane:
LogTable
| take 10
Mapowanie pozyskiwania: użyj wstępnie zdefiniowanych mapowań pozyskiwania w usłudze Kusto, aby przekształcić dane z domyślnego formatu 3-kolumnowego do żądanego schematu. Aby uzyskać więcej informacji, zobacz Wsparcie dla mapowań przetwarzania danych.