Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Important
Ta funkcja jest dostępna w wersji beta. Aby z niego korzystać, administrator przestrzeni roboczej musi włączyć AI/BI Dashboard Materialization na stronie Zapowiedzi . Zobacz Zarządzanie wersjami zapoznawczami usługi Azure Databricks.
Dashboardy AI/BI są zbudowane na zestawach danych o skali dashboardowej. Domyślnie każdy zbiór danych jest analizowany na żywo, więc za każdym razem, gdy ładuje się dashboard lub przegląda go przeglądający, zapytania bazowe, łączenia i skany źródłowe uruchamiają się ponownie w twoim magazynie SQL. W przypadku paneli opartych na drogich zapytaniach źródłowych lub wielu połączeniach, powtarzanie tych zapytań przy każdej interakcji jest powolne i kosztowne.
Materializacja zbioru danych wstępnie oblicza i przechowuje wyniki, na których opiera się zbiór danych, dzięki czemu zasobożerne przetwarzanie jest wykonywane jednorazowo zgodnie z harmonogramem, zamiast przy każdym wczytaniu panelu lub każdej interakcji. Interakcje są następnie generowane na podstawie zapisanych wyników, dzięki czemu opublikowane pulpity nawigacyjne działają szybciej.
Materialization wykorzystuje technologię materializacji widoków metrycznych Unity Catalog. Zobacz Materializacja widoków metryk.
Co się materializuje
Materializacja wstępnie oblicza i przechowuje dane ze zbioru danych. To, co jest przechowywane, różni się między dwoma typami zbiorów danych:
- W zbiorach danych SQL pełny wynik zapytania jest wstępnie obliczany i przechowywany.
- W przypadku lokalnych widoków metryk przechowywany jest model danych na poziomie wiersza (dane źródłowe, łączenia i pola filtrujące), podczas gdy miary są nadal obliczane w czasie zapytania względem wstępnie obliczonej bazy.
Benefits
Materializacja zbiorów danych przynosi następujące korzyści:
- Szybsze dashboardy bez konieczności przeprojektowywania. Kosztowne łączenia i skanowania źródła są uruchamiane zgodnie z harmonogramem tylko raz, a nie przy każdym ładowaniu, co eliminuje czas oczekiwania użytkowników, gdy pulpit ponownie odpytuje duże tabele.
- Niższe koszty magazynu na podstawie odczytu. Wstępne obliczenie bazowego modelu danych pozwala uniknąć powtarzania tego samego kosztownego zapytania dla każdego użytkownika i przy każdym załadowaniu strony, co ogranicza zbędne wykorzystanie hurtowni danych.
- Brak narzutów operacyjnych. Azure Databricks tworzy, przechowuje i odświeża zmaterializowane dane dla Ciebie. Nie ma pipeline, schematu ani magazynu do zarządzania.
Costs
Materializacja zbioru danych wiąże się z kosztami przechowywania i obliczeniami:
- Pamięć. Płacisz za przechowywanie zmaterializowanych danych. Opłaty zależą od użytej pamięci bazowej. Aby uzyskać przegląd pamięci masowej w Unity Catalog, zobacz: Połącz się z chmurowym przechowywaniem obiektów za pomocą Unity Catalog.
- Obliczyć. Początkowe tworzenie oraz odświeżanie są uruchamiane w bezserwerowych potokach Lakeflow i wiążą się z opłatami za moc obliczeniową. Zobacz ceny rurociągów Lakeflow.
Porównaj te koszty z oszczędnościami wynikającymi z unikania powtarzających się skanów i łączenia źródeł. Wybierz harmonogram odświeżania, który równoważy świeżość danych z kosztami obliczeniowymi.
Kiedy stosować materializację
Materializacja nie zawsze jest właściwym narzędziem dla wydajności. Korzyść wynika z zastąpienia powtarzalnego, pełnego przeobliczenia zbioru danych (skanowania i łączenia) odczytami względem wstępnie obliczonej tabeli. Materializuj zbiór danych, gdy ma zastosowanie jedno lub więcej z poniższych warunków:
- Silnie interaktywne pulpity. Pulpit zawiera wiele filtrów, filtrowanie krzyżowe lub funkcje drążenia w dół. Bez materializacji każda interakcja powoduje ponowne wykonanie zapytania do zbioru danych, więc wstępne obliczenie tych zbiorów danych wielokrotnie się zwraca w trakcie sesji.
- Drogie zbiory danych. Zbiór danych opiera się na połączeniach wielu tabel, rozbudowanych widokach, wspólnych wyrażeniach tabelowych (CTE), funkcjach okiennych lub operacjach UNION obejmujących wiele tabel.
- Selektywne filtry dla dużych tabel. Zbiór danych wybiera niewielki podzbiór, na przykład jeden region lub ostatnie 7 dni spośród miliardów wierszy. Materializacja przechowuje tylko niewielki podzbiór.
- Tolerancja na świeżość w zaplanowanym terminie. Dane muszą być aktualizowane tylko tak często, jak wymaga tego harmonogram odświeżania panelu, na przykład co godzinę lub codziennie, a nie w czasie rzeczywistym.
W przypadku małych zbiorów danych lub pulpitów, które rzadko są ładowane, zapytanie na żywo często jest wystarczająco szybkie, a materializacja może nie być warta kosztów. Ponieważ materializacja jest opcjonalna dla każdej publikacji i każdego zbioru danych, możesz ją stosować tylko tam, gdzie przynosi korzyści.
Wymagania
- Dostęp do pulpitu nawigacyjnego AI/BI.
- Panel jest publikowany z opcją Udostępnij uprawnienia do danych . Materializacja nie jest obsługiwana w przypadku pulpitów nawigacyjnych opublikowanych z indywidualnymi uprawnieniami do danych. Zobacz Co to są uprawnienia do danych udostępnionych?.
- W obszarze roboczym włączono bezserwerowe przetwarzanie. Początkowe tworzenie i odświeżenia są uruchamiane w bezserwerowych potokach Lakeflow. Zobacz Konfigurowanie bezserwerowych magazynów SQL Warehouse.
- Uprawnienie CAN USE do hurtowni SQL działającej w środowisku Databricks Runtime 17.3 lub nowszym.
Umożliwienie materializacji zbioru danych
Zbiory danych są domyślnie wybierane do materializacji, ale materializacja jest wyłączona na pulpicie, dopóki nie włączysz opcji Materializuj zbiory danych podczas publikowania.
Wybierz, które zbiory danych zmaterializować
Na zakładce Dane kliknij ikonę materializacji obok zbioru danych, aby go uwzględnić lub wykluczyć.
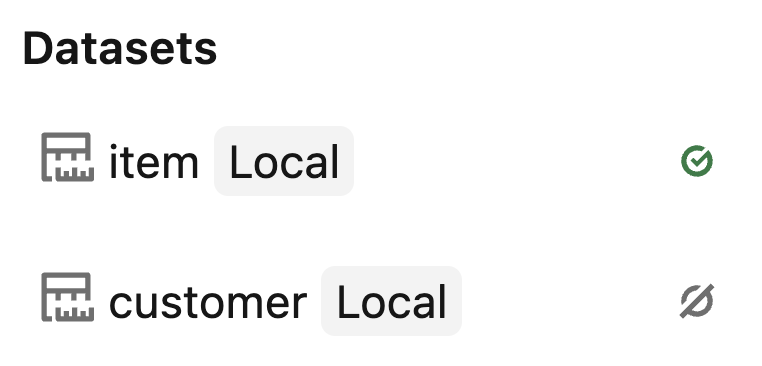
Gdy wykluczasz zbiór danych z materializacji, zapytania do tego zbioru zwracają wyniki na żywo, natomiast zapytania względem zmaterializowanych zbiorów odzwierciedlają najnowszy przebieg materializacji. Gdy wszystkie zbiory danych korzystają z tego samego harmonogramu materializacji, widżety mają stałą świeżość danych.
Publikuj z materializacją
- Kliknij Opublikuj w panelu wersji roboczej.
- Wybierz Udostępnij uprawnienia do udostępniania danych w oknie publikacji.
- Włącz opcję Materializuj zbiory danych , aby zmaterializować wybrane zbiory danych na zakładce Data .
- Kliknij Publikuj.
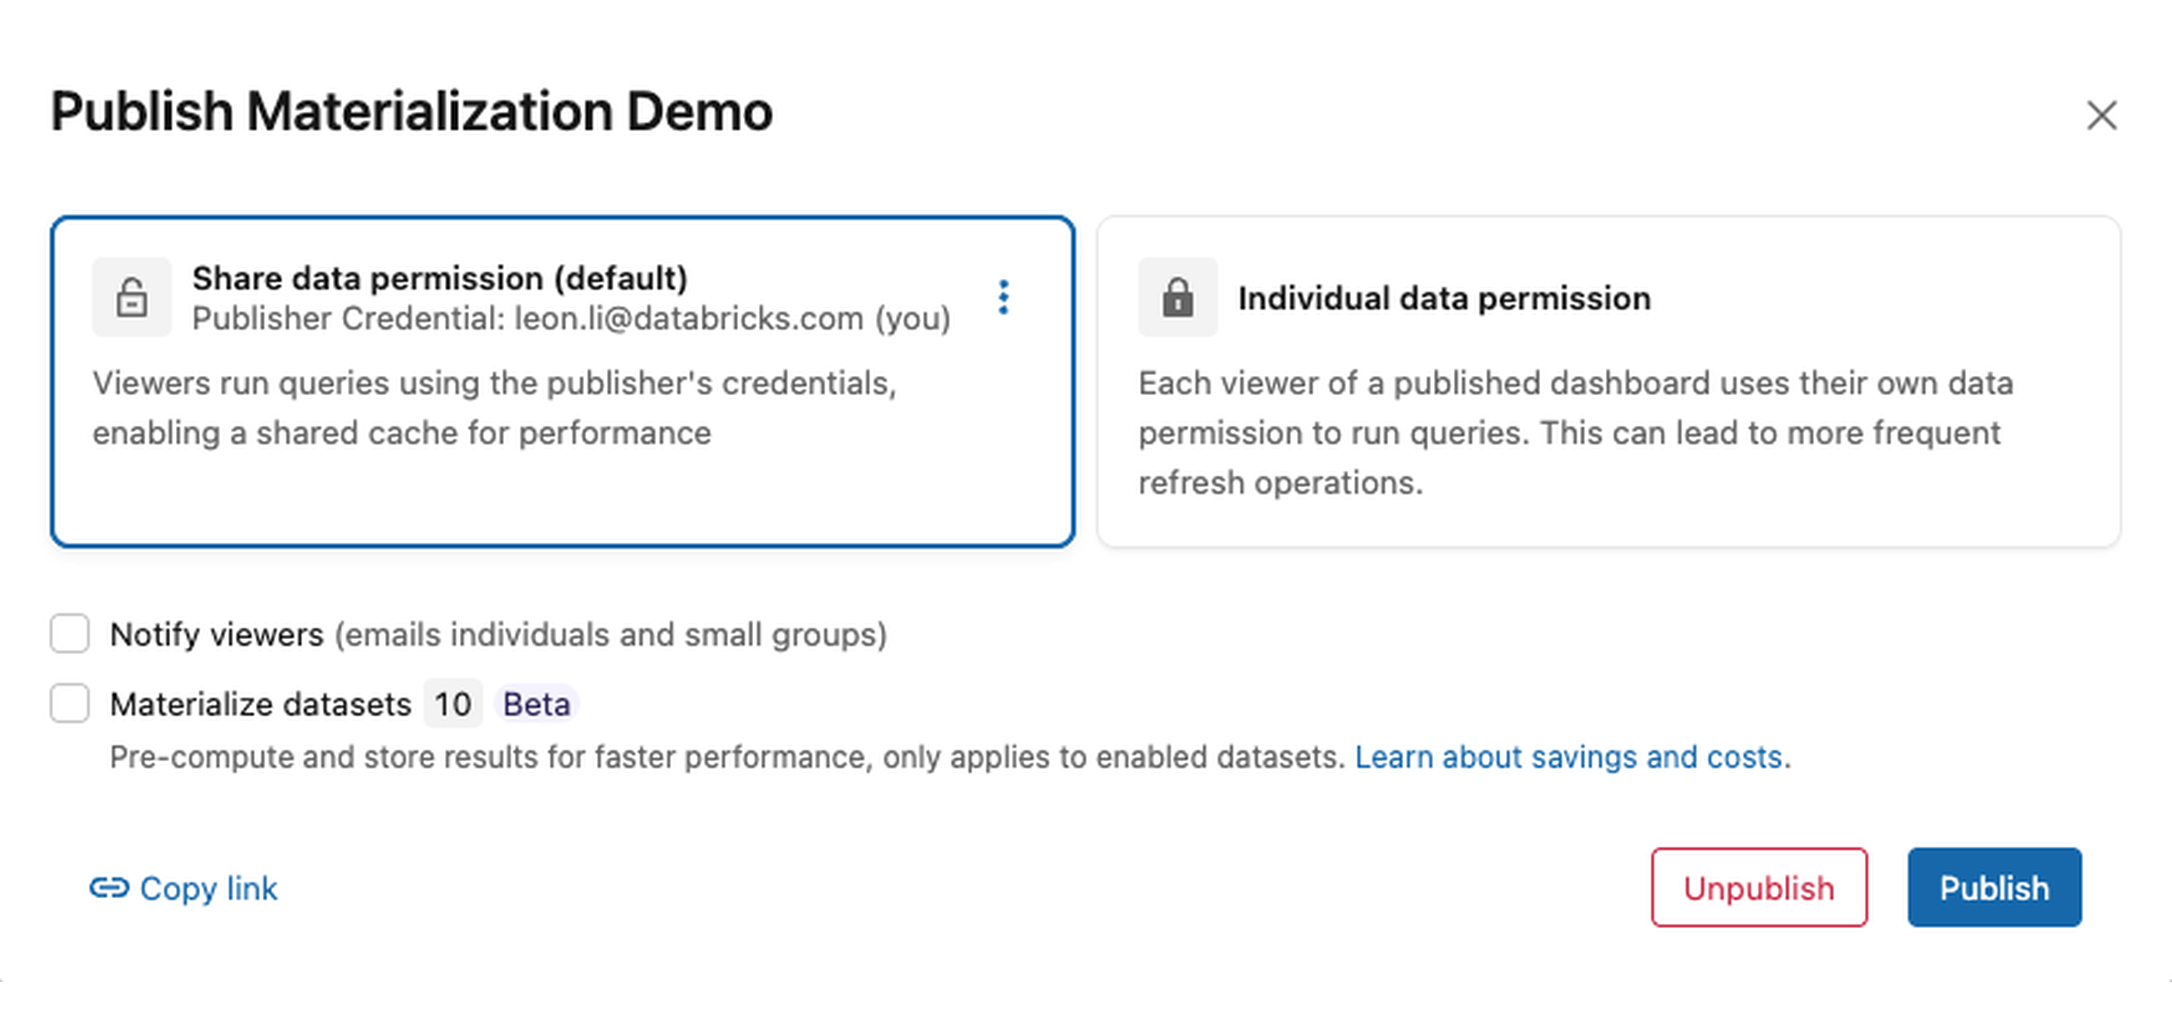
Włącz opcję Materializuj zestawy danych przy każdym publikowaniu.
Ustaw harmonogram odświeżania
Dane zmaterializowane są odświeżane zgodnie z harmonogramem odświeżania pulpitu nawigacyjnego. Użyj harmonogramu dashboardu , aby dostosować częstotliwość odświeżania.
Jeśli dashboard nie ma harmonogramu, publikacja z włączoną materializacją dodaje codzienny harmonogram odświeżania. Istniejące rozkłady jazdy są zachowane. Bez aktywnego harmonogramu zmaterializowane dane nie odświeżają się automatycznie po utworzeniu.
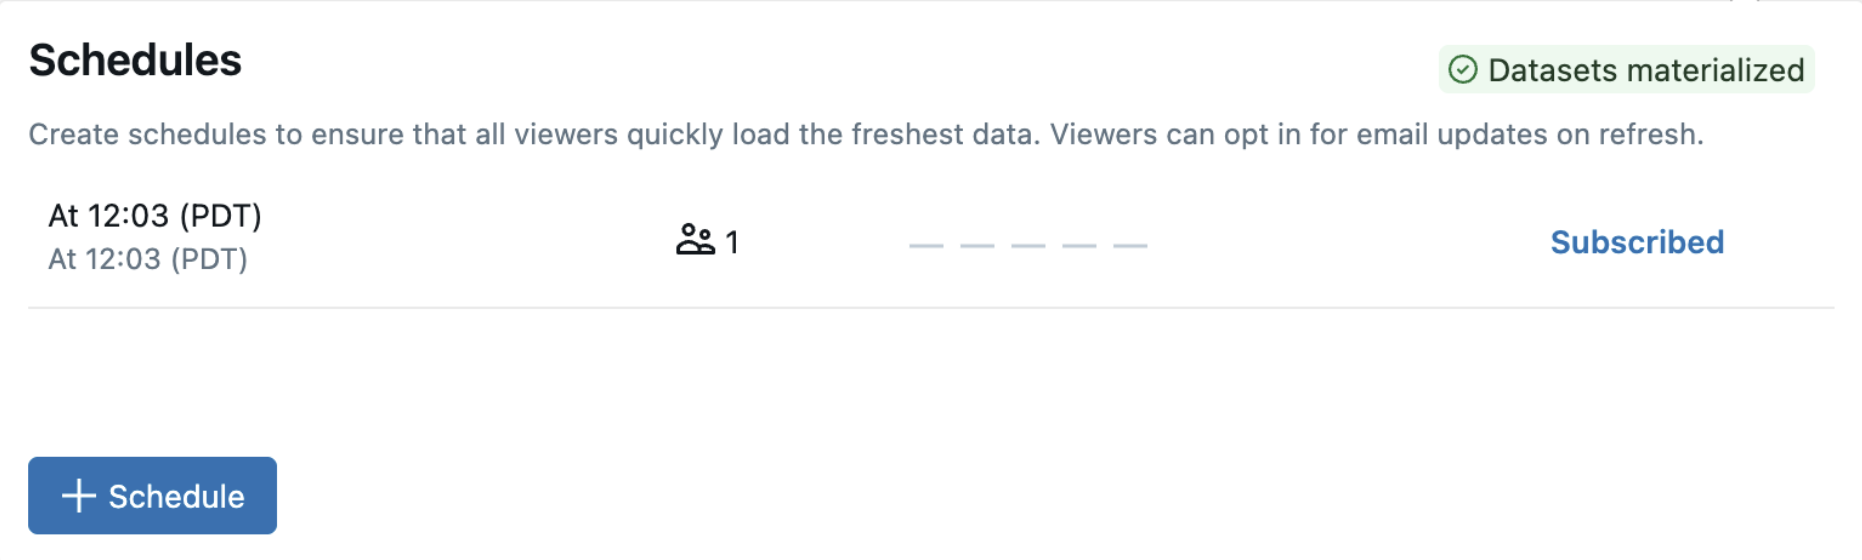
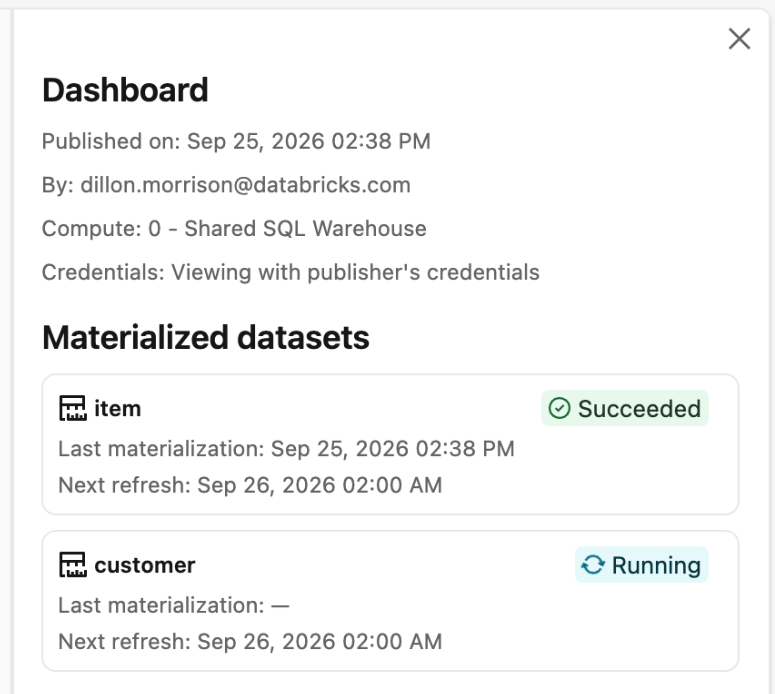
Wyświetl status materializacji
W opublikowanym panelu otwórz  . menu i wybierz Info. Pasek boczny pokazuje status i informacje o odświeżeniu każdego zmaterializowanego zbioru danych.
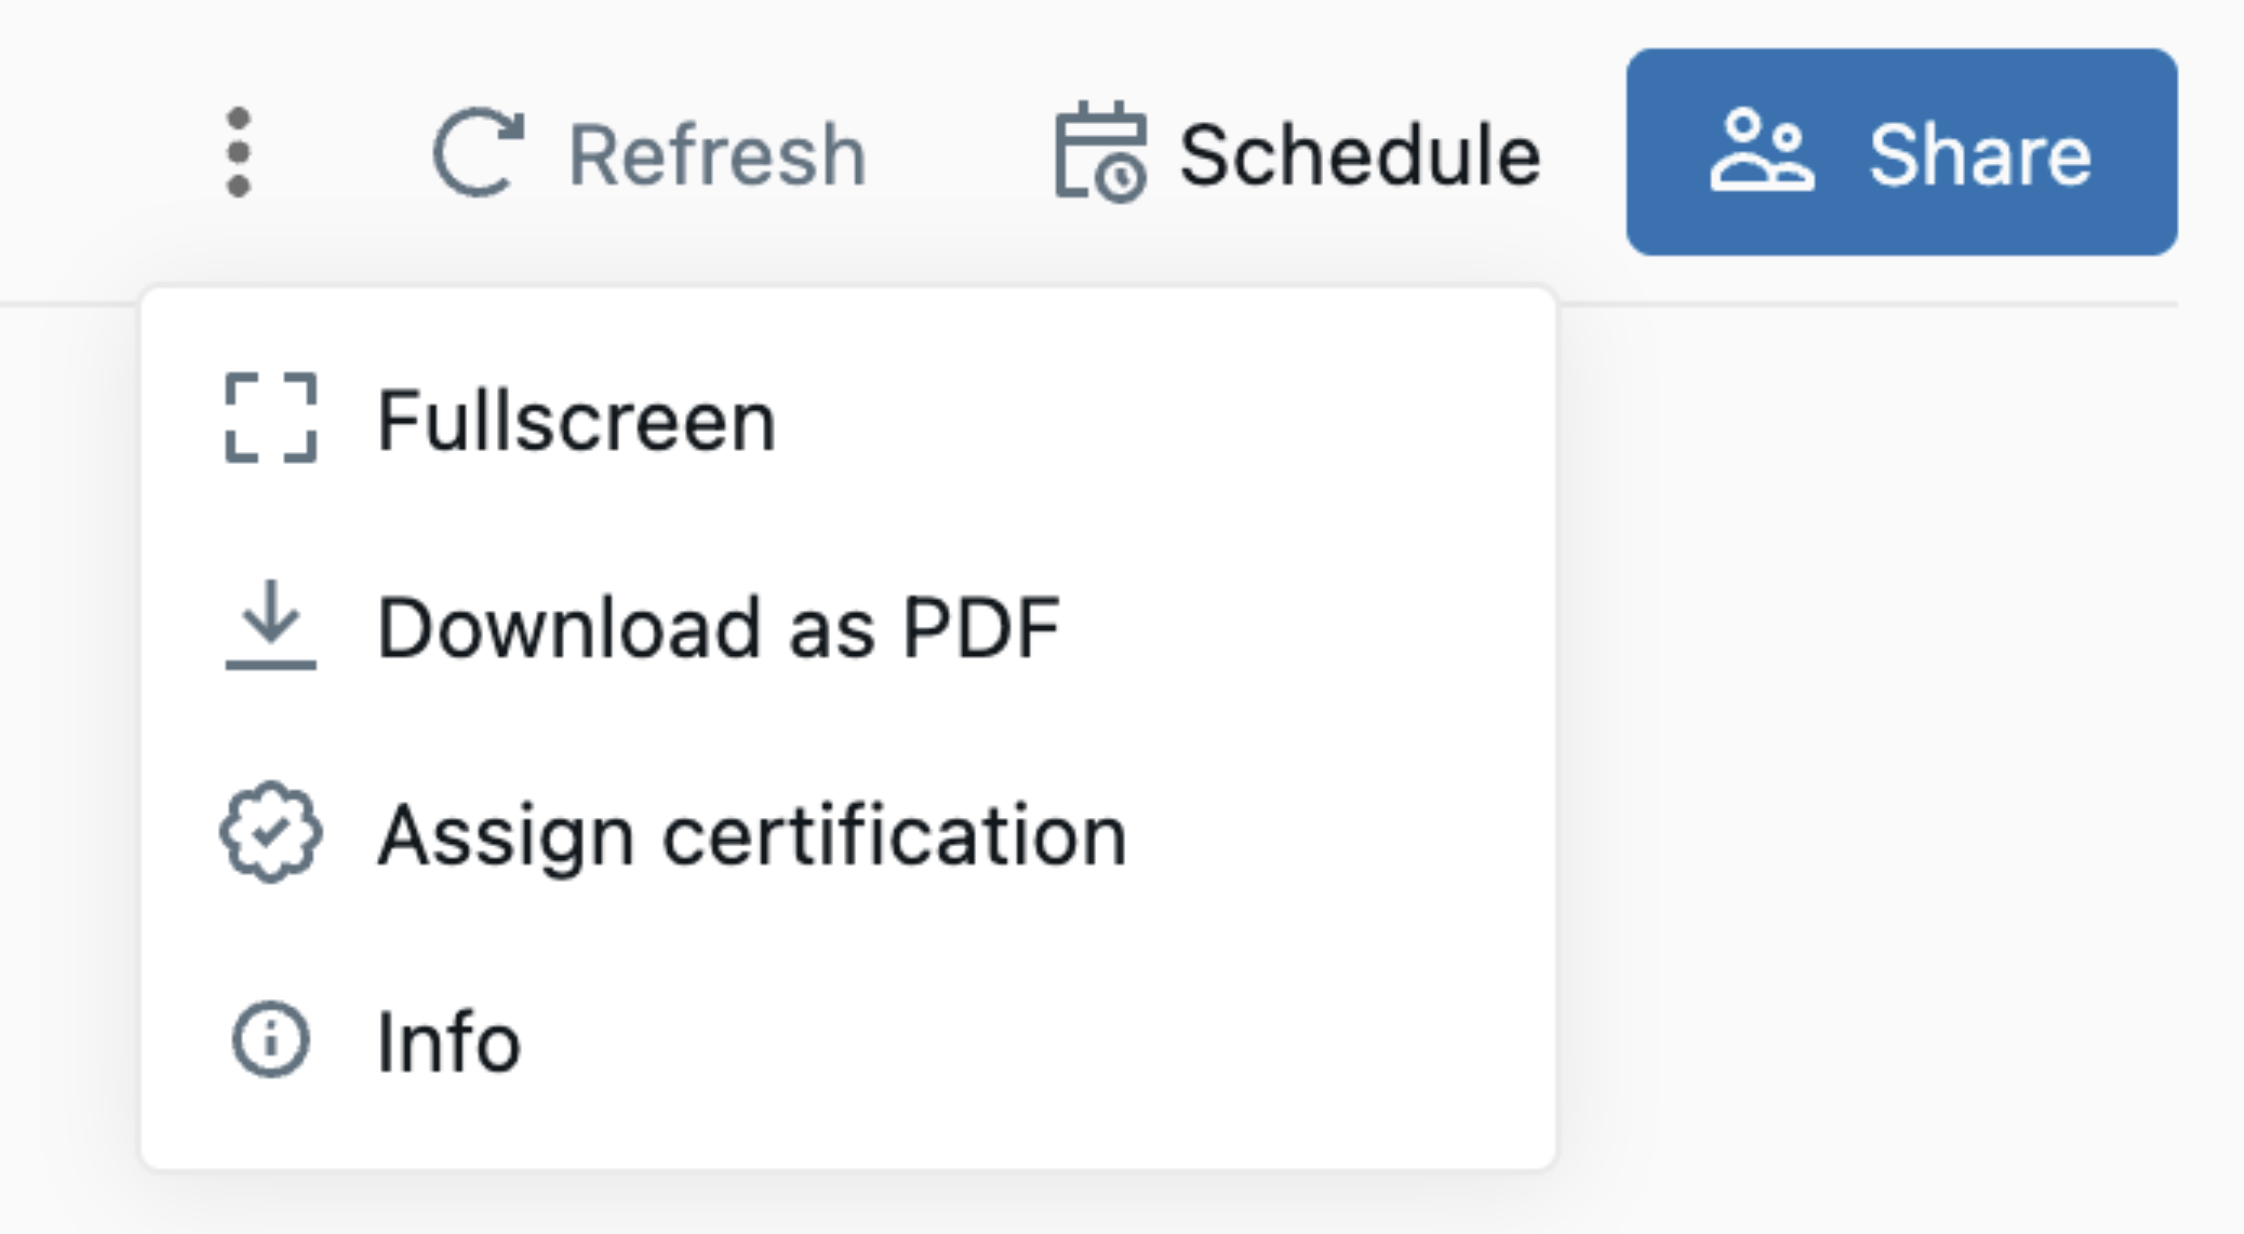
Ponowne wykorzystanie i sprzątanie
Azure Databricks zarządza cyklem życia Twoich zmaterializowanych danych:
- Ponowne wykorzystanie w różnych wersjach. Jeśli dashboard zostanie ponownie opublikowany przez tego samego użytkownika, a zbiór danych nie zmieni się, istniejąca materializacja zostanie wykorzystana, unikając marnowania obliczeń.
- Automatyczne sprzątanie. Azure Databricks usuwa materializacje, do których opublikowany pulpit nawigacyjny już się nie odwołuje, na przykład po zmianie definicji lub cofnięciu publikacji.
Ponowne publikowanie niekoniecznie odświeża zmaterializowane dane.
Ograniczenia
Materializacja zbioru danych ma następujące ograniczenia:
- Tylko opublikowane pulpity. Materializacja dotyczy opublikowanych pulpitów nawigacyjnych. Wersje robocze nadal zapytują dane na żywo.
- Brak parametryzowanych zbiorów danych. Zbiory danych definiujące parametry nie mogą być materializowane. Jeśli włączysz materializację dla parametryzowanego zbioru danych, Azure Databricks oznaczy go jako zakończony niepowodzeniem, zamiast go zmaterializować.
- Odświeżanie podąża wyłącznie za harmonogramem dashboardu. Nie ma osobnego harmonogramu odświeżania dla każdego zbioru danych. Materializacja odświeża się zgodnie z harmonogramem odświeżania na panelu.
- Wymagane jest działanie bez serwera. Początkowe tworzenie i odświeżanie są uruchamiane w bezserwerowych potokach Lakeflow, więc w obszarze roboczym musi być włączona obsługa obliczeń bezserwerowych.
- Chronione dane nie są udostępniane z materializacji. Materializacja nie może być tworzona dla danych źródłowych chronionych przez bezpieczeństwo na poziomie wiersza, maski kolumnowe ani polityki kontroli dostępu opartej na atrybutach (ABAC). Jeśli zabezpieczenia na poziomie wierszy zostaną dodane do tabeli źródłowej po utworzeniu materializacji, kolejne zapytania względem widoku metryk pomijają materializację i są wykonywane na danych źródłowych.
- Wymagane są uprawnienia do udostępniania danych. Materializację można włączyć tylko wtedy, gdy publikujesz z uprawnieniami do współdzielonych danych. Nie możesz go włączyć, gdy publikujesz z indywidualnymi uprawnieniami do danych.
Często zadawane pytania
Poniższe pytania dotyczą zachowań materializacji zbiorów danych, odświeżania oraz uprawnień.
Czy materializacja zmienia moje metryki lub wyniki?
Materializacja zachowuje logikę zapytań zbioru danych, ale jego dane odzwierciedlają ostatnie pomyślne odświeżenie. W lokalnych widokach metrycznych miary obliczane są w czasie zapytania względem zmaterializowanych danych. Zobacz, co się zmaterializuje.
Co się stanie, jeśli materializacja nie jest gotowa lub nie jest dostępna?
Jeśli materializacja nie jest gotowa lub niedostępna w momencie wykonywania zapytania, zapytanie zwraca błąd zamiast odpytywać dane na żywo. Poczekaj, aż materializacja się zakończy, a potem ponownie uruchom zapytanie.
Gdzie przechowywane są zmaterializowane dane?
Azure Databricks przechowuje zmaterializowane dane w zarządzanej, wewnętrznej pamięci magazynowej, dostosowanej do Twojego opublikowanego pulpitu. Nie masz nic do opublikowania w Unity Catalog, ani schematu ani pamięci do zarządzania. Access nadal podąża za Twoim dashboardem i uprawnieniami danych.
Jak często odświeżane są dane materializowane?
Dane zmaterializowane są odświeżane zgodnie z harmonogramem odświeżania pulpitu nawigacyjnego. Zobacz Ustaw harmonogram odświeżania.
Jakiej mocy obliczeniowej wymaga materializacja?
Zarówno początkowe utworzenie, jak i odświeżenia są uruchamiane w bezserwerowych potokach Lakeflow zarządzanych przez Azure Databricks. Dlatego w przestrzeni roboczej musi być włączona funkcja bezserwerowych zasobów obliczeniowych.
Czy materializacja wpływa na uprawnienia?
No. Materializacja nie daje dodatkowego dostępu do danych. Access nadal podąża za konfiguracją udostępniania panelu oraz uprawnieniami użytymi do jego publikacji.
Co się stanie, gdy opublikuję ponownie?
Istniejące materializacje mogą być ponownie wykorzystane, gdy ten sam użytkownik publikuje niezmieniony zbiór danych. Zobacz ponowne użycie i sprzątanie. Włącz opcję Materializuj zestawy danych przy każdym publikowaniu.