Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Spark SQL wykorzystuje optymalizator oparty na kosztach (CBO) do wyboru efektywnych planów zapytań. CBO wykorzystuje statystyki tabelowe i kolumnowe, takie jak wielkość tabeli i rozkład danych, aby oszacować koszt alternatywnych planów i wybrać plan o najniższym szacowanym koszcie. To ma największe znaczenie w przypadku zapytań z wieloma połączeniami, gdzie słaby plan może być o rzędy wielkości wolniejszy niż dobry.
CBO jest domyślnie włączone, ale zależy to od statystyk. Jeśli statystyki są brakujące lub nieaktualne, CBO może wybrać nieefektywną kolejność dołączenia lub strategię dołączania. Zbieraj statystyki tabelowe i kolumnowe i utrzymuj je na bieżąco. Zobacz Zbieranie statystyk.
Najlepsze praktyki
Aby pomóc CBO wybrać efektywne plany zapytań, stosuj następujące praktyki:
- Zbieraj statystyki dla tabel używanych w zapytaniach wielołącznych. Jeśli używasz optymalizacji predykcyjnej na zarządzanych tabelach Unity Catalog, statystyki są zbierane za Ciebie. Zobacz Zbieranie statystyk.
- Sprawdź plany zapytań , gdy zapytanie z wieloma połączeniami jest wolniejsze niż oczekiwano. Brakujące lub niedokładne statystyki są częstą przyczyną. Zobacz Weryfikowanie planów zapytań.
- Usuń statystyki lub wyłącz CBO tylko po to, by złagodzić konkretny problem z planowaniem, który statystyki powodują. Zobacz Wyłącz optymalizator oparty na kosztach.
Zbieranie statystyk
Aby uzyskać pełną korzyść z CBO, ważne jest zebranie zarówno statystyk kolumn, jak i statystyk tabeli. Możesz użyć ANALYZE TABLE polecenia , aby ręcznie zebrać statystyki.
Napiwek
Aby zachować aktualność statystyk, uruchom ANALYZE TABLE po zapisaniu w tabeli.
Użyj ANALYZE
Optymalizacja predykcyjna automatycznie uruchamia ANALYZE polecenie służące do zbierania statystyk w tabelach zarządzanych przez katalog Unity Catalog. Databricks zaleca włączenie optymalizacji predykcyjnej dla wszystkich tabel zarządzanych przez Unity Catalog, aby uprościć utrzymanie danych i zmniejszyć koszty magazynowania. Zobacz ANALYZE TABLE ... STATYSTYKI OBLICZENIOWE.
Możesz usunąć statystyki optymalizatora, aby optymalizator nie polegał już na nich, na przykład, aby rozwiązać problem z planowaniem spowodowany przez statystyki. Zobacz ANALYZE TABLE … DROP STATISTICS.
Weryfikowanie planów zapytań
Istnieje kilka sposobów weryfikacji planu zapytania.
EXPLAIN polecenie
Aby sprawdzić, czy plan używa statystyk, użyj polecenia EXPLAINSQL .
Jeśli brakuje statystyk, plan zapytania może nie być optymalny.
== Optimized Logical Plan ==
Aggregate [s_store_sk], [s_store_sk, count(1) AS count(1)L], Statistics(sizeInBytes=20.0 B, rowCount=1, hints=none)
+- Project [s_store_sk], Statistics(sizeInBytes=18.5 MB, rowCount=1.62E+6, hints=none)
   +- Join Inner, (d_date_sk = ss_sold_date_sk), Statistics(sizeInBytes=30.8 MB, rowCount=1.62E+6, hints=none)
      :- Project [ss_sold_date_sk, s_store_sk], Statistics(sizeInBytes=39.1 GB, rowCount=2.63E+9, hints=none)
      :  +- Join Inner, (s_store_sk = ss_store_sk), Statistics(sizeInBytes=48.9 GB, rowCount=2.63E+9, hints=none)
      :     :- Project [ss_store_sk, ss_sold_date_sk], Statistics(sizeInBytes=39.1 GB, rowCount=2.63E+9, hints=none)
      :     :  +- Filter (isnotnull(ss_store_sk) && isnotnull(ss_sold_date_sk)), Statistics(sizeInBytes=39.1 GB, rowCount=2.63E+9, hints=none)
      :     :     +- Relation[ss_store_sk,ss_sold_date_sk] parquet, Statistics(sizeInBytes=134.6 GB, rowCount=2.88E+9, hints=none)
      :     +- Project [s_store_sk], Statistics(sizeInBytes=11.7 KB, rowCount=1.00E+3, hints=none)
      :        +- Filter isnotnull(s_store_sk), Statistics(sizeInBytes=11.7 KB, rowCount=1.00E+3, hints=none)
      :           +- Relation[s_store_sk] parquet, Statistics(sizeInBytes=88.0 KB, rowCount=1.00E+3, hints=none)
      +- Project [d_date_sk], Statistics(sizeInBytes=12.0 B, rowCount=1, hints=none)
         +- Filter ((((isnotnull(d_year) && isnotnull(d_date)) && (d_year = 2000)) && (d_date = 2000-12-31)) && isnotnull(d_date_sk)), Statistics(sizeInBytes=38.0 B, rowCount=1, hints=none)
            +- Relation[d_date_sk,d_date,d_year] parquet, Statistics(sizeInBytes=1786.7 KB, rowCount=7.30E+4, hints=none)
Ważne
Statystyka rowCount jest szczególnie ważna w przypadku zapytań z wieloma sprzężeniami. Jeśli rowCount brakuje, oznacza to, że nie ma wystarczającej ilości informacji, aby je obliczyć (oznacza to, że niektóre wymagane kolumny nie mają statystyk).
W Databricks Runtime 16.0 i wyższych wynik polecenia EXPLAIN wymienia tabele, do których istnieją odwołania, które mają brakujące, częściowe i pełne statystyki, na przykład:
== Optimizer Statistics (table names per statistics state) ==
  missing = date_dim, store
  partial =
  full    = store_sales
Corrective actions: consider running the following command on all tables with missing or partial statistics
  ANALYZE TABLE <table-name> COMPUTE STATISTICS FOR ALL COLUMNS
Interfejs użytkownika platformy Spark SQL
Użyj strony interfejsu użytkownika usługi Spark SQL, aby wyświetlić wykonany plan i dokładność statystyk.
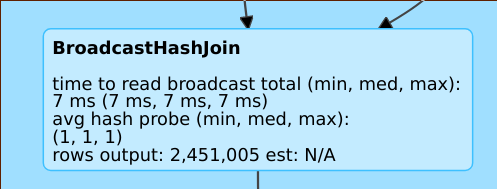
Linia, taka jak rows output: 2,451,005 est: N/A oznacza, że ten operator generuje około 2 mln wierszy i nie było dostępnych statystyk.
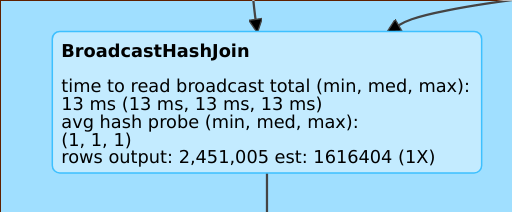
Linia taka jak rows output: 2,451,005 est: 1616404 (1X) oznacza, że ten operator generuje około 2 mln wierszy, podczas gdy szacowanie wynosiło około 1,6 mln, a współczynnik błędu szacowania wynosił 1.
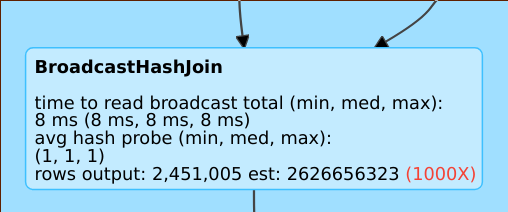
Wiersz taki jak rows output: 2,451,005 est: 2626656323 oznacza, że ten operator generuje około 2 mln wierszy, podczas gdy szacowanie wynosiło 2B wierszy, więc współczynnik błędu szacowania wynosił 1000.
Wyłącz optymalizator oparty na kosztach
Funkcja CBO jest domyślnie włączona. Należy wyłączyć CBO, zmieniając flagę spark.sql.cbo.enabled .
spark.conf.set("spark.sql.cbo.enabled", false)