Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
W tym artykule opisano sześciofazowy proces migracji obciążenia wykorzystującego model LLM z jednego modelu bazowego na inny: co należy wziąć pod uwagę na każdym etapie, które funkcje Microsoft Foundry mają zastosowanie oraz jak zmienia się zakres prac w przypadku różnych typów zespołów.
Co oznacza migracja modelu
Każdy model uruchamiany w środowisku produkcyjnym ma datę wycofania. Gdy model, od którego zależysz, zostanie zastąpiony lub gdy nowszy model będzie lepiej obsługiwał obciążenie, należy przeprowadzić migrację. Zamiana modelu to nie jest zmiana sprowadzająca się do jednej linijki: inny model może niepostrzeżenie zmienić ton, formatowanie, strukturę JSON, opóźnienia, koszt lub sposób wywoływania narzędzi, a także zepsuć działanie kodu zależnego od dotychczasowego zachowania.
Pomyślna migracja zachowuje zachowanie aplikacji lub poprawia ją w wymierny sposób. Sukces wymaga powtarzalnego procesu wykrywania dryfu, bezpiecznego dostosowywania i udowodnienia jakości przed szerokim wdrożeniem.
Kiedy przeprowadzić migrację
Migracja zwykle rozpoczyna się z jednego z czterech powodów:
- Model zostaje wycofany. W Foundry każdy model ogólnie dostępny ma określoną datę wycofania, a starsze rodziny są z czasem zastępowane. Informacje o zasadach wycofywania i terminach można znaleźć w dokumentach Zasady cyklu życia i wsparcia modeli Foundry oraz Harmonogram wycofywania modeli.
- Dostępny jest lepszy model. Nowszy model oferuje wyższą jakość, niższe koszty, lepsze opóźnienie lub możliwość (np. ustrukturyzowane dane wyjściowe lub ulepszone wywoływanie narzędzi), których potrzebuje obciążenie.
- Problem z kosztami lub opóźnieniami wymusza zmianę. Opóźnienie lub koszt jednostkowy bieżącego modelu nie spełnia już Twoich potrzeb.
- Luka w zakresie możliwości blokuje produkt. Bieżący model nie może teraz zrobić czegoś, czego wymaga Twój produkt.
Co się stanie w dniu wycofania
To, co Azure robi, gdy model zostaje wycofany, zależy od tego, w jaki sposób kupujesz moc obliczeniową, a Foundry stosuje odrębną terminologię dla każdej z tych ścieżek:
- Wdrożenia Standard, Global Standard i Data Zone Standard (płatność zgodnie z użyciem) są automatycznie aktualizowane stopniowo, region po regionie. Możesz kontrolować harmonogram, ustawiając
versionUpgradeOptionna jedną z następujących wartości:OnceNewDefaultVersionAvailable,OnceCurrentVersionExpiredlubNoAutoUpgrade(co oznacza, że wdrożenie przestaje działać po wycofaniu). Przetwarzanie priorytetowe przebiega tą samą ścieżką. - Wdrożenia aprowizowane (PTU)nie są automatycznie aktualizowane. Migrujesz je samodzielnie, albo na miejscu (ruch jest przenoszony w ciągu 20–30 minut bez przestojów), albo równolegle (uruchamiasz nowe wdrożenie, testujesz je, przełączasz ruch i usuwasz stare).
- Wsadowe wdrożenia przebiegają według ścieżki równoległej: wdrożenie nowego modelu, ponowne zgłoszenie zadań, wycofanie starego wdrożenia.
Niezależnie od tego, która ścieżka ma zastosowanie, wyzwanie dla deweloperów jest takie samo: w określonej dacie ruch zaczyna trafiać do innego modelu. Fakt, że punkt końcowy nadal odpowiada, nie oznacza, że aplikacja wciąż działa prawidłowo, dlatego zarówno automatycznie zaktualizowane, jak i ręcznie zmigrowane obciążenia korzystają z oceny i walidacji opisanych w tym artykule.
Przeprowadź migrację przed datą wycofania
Automatyczna aktualizacja to jedynie zabezpieczenie dla wdrożeń z rozliczaniem według użycia, a nie plan migracji. Wdrożenia aprowizowane nie mają zabezpieczenia awaryjnego. Tak czy inaczej, nie jest to zamiennik planu migracji. Dwa zobowiązania w ramach polityki dają możliwość migracji zgodnie z własnym harmonogramem zamiast czekać do ostatecznego terminu:
- Model zastępczy staje się dostępny około 90 dni przed wycofaniem w usłudze Global Standard oraz około 30 dni przed wycofaniem w regionach z aprowizacją, w których poprzedni model jest wycofywany. Użyj tego okna, aby ocenić nowy model i przeprowadzić migrację ręcznie.
- Daty wycofania nie są rozszerzalne. Nie ma procedury wyjątków, więc data, której nie uwzględniono w planie, nadal obowiązuje.
Nie potrzebujesz powiadomienia o wycofaniu, aby rozpocząć. Jeśli nowszy model jest tańszy, szybszy lub bardziej zdolny, uruchom go teraz. Migrowanie celowo zamienia datę wycofania na formalność. Ponieważ migracje powtarzają się, warto powtórzyć proces.
Kto powinien korzystać z procesu migracji
Proces migracji najlepiej sprawdza się wtedy, gdy zespół tworzy funkcję opartą na modelu LLM w ramach większego produktu lub platformy, przeprowadza migracje mniej więcej raz na kwartał i ma wyraźnie wskazanego właściciela (na przykład centralny zespół platformowy lub zespół aplikacji), który świadomie prowadzi każdą migrację.
Ten proces sprawdza się również w zespołach tworzonych wokół AI, gdzie model jest produktem. Fazy są takie same, ale działają szybciej i często równolegle, a nie w ścisłej kolejności.
W procesie zakłada się, że przechodzisz między modelami podstawowymi, czyli modelami wdrażanymi w postaci opublikowanej w katalogu modeli, bez dostosowywania na poziomie wag. Dostrojone obciążenia robocze nie wchodzą w zakres. Nie mogą być automatycznie uaktualniane, ponieważ niosą własne szkolenie i zegar wycofania wdrożenia. Dostosowanie dostrojonych obciążeń oznacza destylację lub ponowne trenowanie, a nie monitowanie i zmiany schematu. Jeśli korzystasz z wdrożeń modeli dostrojonych, zaplanuj odpowiednio wcześnie ich ponowne dostrojenie na podstawie zastępczego modelu bazowego.
Fazy migracji
Migracja przechodzi przez sześć faz. Każda faza generuje dane wyjściowe używane w następnej fazie. Fazy migracji to:
Odkrywanie → ocena → dostosowywanie → weryfikowanie → → wycofywanie
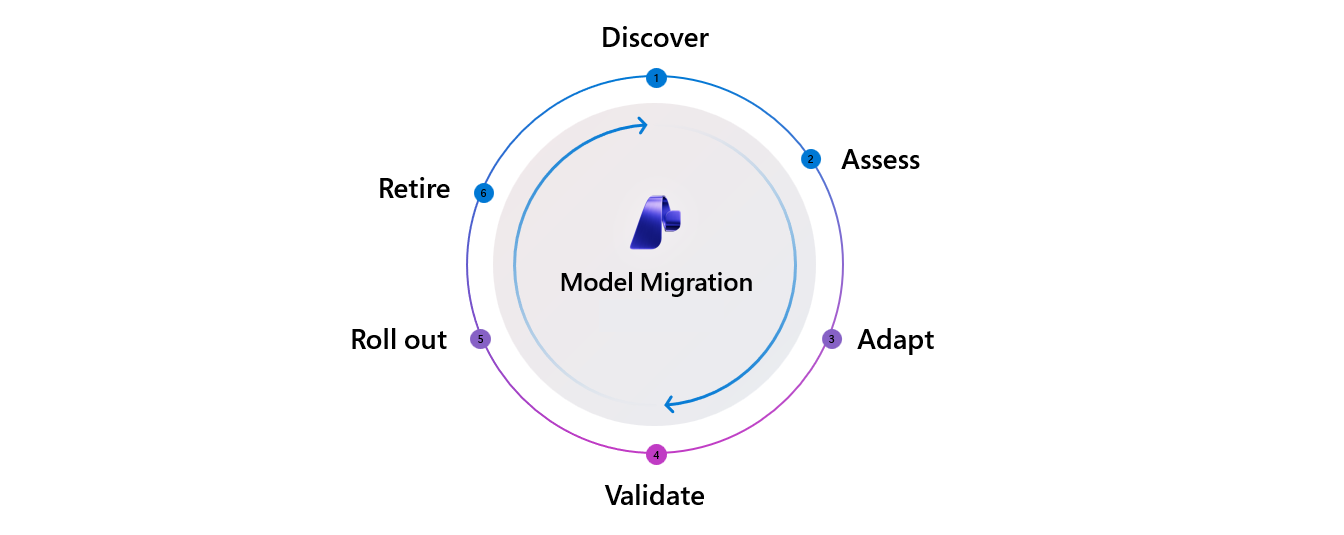
W poniższej tabeli opisano każdą fazę oraz funkcje i narzędzia Foundry, które ją wspierają. Funkcje są dostępne zarówno w Microsoft Foundry, jak i Azure OpenAI, chyba że jest oznaczona tylko funkcja Foundry, co oznacza, że Azure OpenAI nie ma odpowiednika.
Sekcje poświęcone poszczególnym fazom w dalszej części tego artykułu wyjaśniają, dlaczego każda faza istnieje, jak wygląda pomyślny rezultat, co należy wziąć pod uwagę, kiedy korzystać z poszczególnych funkcji oraz w którym miejscu dana faza najczęściej zawodzi.
| Phase | Description | Funkcje i narzędzia |
|---|---|---|
| Odkryj | Dowiedz się, czy zmiana modelu nadchodzi, czy jest potrzebna, i zdecyduj, czy chcesz działać. |
|
| Ocenić | Wybierz model docelowy i upewnij się, że jest on dostępny operacyjnie. |
|
| Dostosowywanie | Powtórz bieżące obciążenie w nowym modelu, zdiagnozuj zmiany behawioralne i ponownie utwórz monity, parametry, definicje narzędzi, schematy wyjściowe i kod wywołujący wokół nich. |
|
| Zweryfikuj | Oceń dostosowane obciążenie robocze według kryteriów jakości, aby zdecydować, czy można je bezpiecznie wdrożyć. |
|
| Wdrażanie | Wdrażaj na środowisko produkcyjne poprzez stopniowe udostępnianie, monitoruj działanie w środowisku produkcyjnym i zatwierdź wdrożenie lub je wycofaj. |
|
| Retire | Wycofaj stare wdrożenie, zwolnij zasoby, zarchiwizuj ewaluacje i zaktualizuj dokumentację zależną. |
|
Przed migracją: przygotowywanie testowego zestawu danych
Ten krok przygotowania składa zestaw reprezentatywnych danych wejściowych, oczekiwanych danych wyjściowych i uzgodnionych kryteriów powodzenia przed rozpoczęciem wszelkich prac migracji. Ten zestaw stanowi kluczową zależność w środkowej części procesu: nie można powtórzyć działania w fazie Adapt bez danych wejściowych i nie można przeprowadzić oceny w fazie Validate bez danych referencyjnych i kryteriów.
Co należy wziąć pod uwagę
- Zbuduj zbiór danych, zanim wybierzesz cel. Zestaw danych opisuje Twoje obciążenie robocze, a nie model brany pod uwagę, więc możesz przygotować go równolegle w Discover.
- Zbieranie danych wejściowych z rzeczywistych lub syntetycznych źródeł. Użyj przechwyconego ruchu produkcyjnego lub starannie dobranych przykładów domenowych w formacie CSV lub JSONL. Jeśli nie masz jeszcze reprezentatywnych danych, wygeneruj syntetyczne i niepożądane dane wejściowe za pomocą symulatora.
- Rejestruj instrumenty, zanim będą potrzebne. Przechwytywanie treści w środowisku produkcyjnym jest funkcją opcjonalną i nigdy nie działa wstecz, więc nie można analizować ruchu, którego nie zarejestrowano. Zacznij rejestrować prompty, odpowiedzi, opóźnienia i liczbę tokenów już teraz.
- Blokowanie zestawu danych. Zachowaj stałe dane wejściowe, podstawowe prawdy i kryteria sukcesu dla całej migracji. Jeśli którykolwiek z nich ulegnie zmianie, nie można już porównać wyników źródłowych i docelowych.
Potrzebujesz również wykazu wdrożeń modeli, z których korzysta obciążenie robocze, w tym typów tych wdrożeń (standardowe, aprowizowane lub wsadowe). Dla każdego modelu źródłowego zanotuj datę wycofania i sugerowane zastąpienie z harmonogramu wycofania modelu.
Faza 1. Odnajdywanie
Celem fazy odkrywania jest rozpoznanie, że zbliża się zmiana modelu lub że warto ją wprowadzić, oraz podjęcie decyzji, czy należy działać. Rezultatem jest decyzja o kontynuacji lub rezygnacji, a pozostanie przy obecnym modelu jest uzasadnionym wyborem. Pożądanym rezultatem jest wczesny, uporządkowany sygnał, który wskazuje datę wycofania, model zastępczy i okres migracji lub świadomą decyzję o pozostaniu przy obecnym modelu.
Co należy wziąć pod uwagę
- Jaka jest data przejścia na emeryturę i ile pasa startowego rzeczywiście masz? Traktuj datę wycofania pomniejszoną o czas weryfikacji i wdrożenia jako rzeczywisty termin.
- Czy istnieje konkretnie wskazany sugerowany zamiennik, czy trzeba samodzielnie sporządzić krótką listę kandydatów?
- Czy ta zmiana wiąże się z wymogami dotyczącymi zgodności lub ograniczeniami regionalnymi (w przypadku obciążeń podlegających regulacjom dostępność i certyfikacja często mają większe znaczenie niż jakość)?
Gdzie jest to często przerywane
Zespoły dowiadują się o wycofaniach w niespójny sposób — z wiadomości e-mail, banera w portalu lub komunikatu wewnętrznego — i dostrzegają te sygnały z opóźnieniem. To opóźnienie jeszcze bardziej skraca i tak już krótki przedział czasowy. Samodzielni programiści i małe zespoły często dowiadują się o wycofaniu czegoś z użycia wskutek błędu na produkcji, zamiast z ogłoszenia.
Co przynosisz
Harmonogram wycofania i interfejs API modeli udostępniają dane w ramach stabilnego kontraktu. Dojrzałe organizacje dodają do tego niewielką wewnętrzną warstwę powiadomień, aby kierować je do właściwych osób odpowiedzialnych.
Faza 2. Ocena
Celem fazy oceny jest wybranie wybranego modelu docelowego kandydata i potwierdzenie, że można go uruchomić: właściwy region, odpowiedni typ wdrożenia, wystarczający limit przydziału i dostępność obok bieżącego modelu, dzięki czemu wycofanie pozostanie możliwe. Pomyślny rezultat to jednoznaczny wybór spośród rozważanych modeli, przy potwierdzonych przed rozpoczęciem dostrajania: regionie, wariancie SKU, limicie przydziału i koszcie.
Co należy wziąć pod uwagę
- Jakość i pozycja poszczególnych kandydatów. Gdy rozważasz kilka modeli, zdecyduj, który z nich najlepiej pasuje do Twojego obciążenia roboczego pod względem jakości, a nie tylko który uzyskuje najwyższy wynik w publicznym benchmarku.
- Koszt ruchu własnego. Struktura cenowa zmienia się między generacjami modeli. Tokeny rozumowania, buforowane dane wejściowe i narzut związany ze strukturyzowanym wyjściem mogą zmieniać ekonomikę jednostkową nawet 2x lub bardziej, więc szacuj miesięczny koszt na podstawie historycznego ruchu, a nie wyłącznie ceny katalogowej.
- Dostępność operacyjna. Potwierdź region, jednostkę SKU i limit przydziału oraz to, że środowisko docelowe może działać równolegle ze środowiskiem źródłowym, aby zachować możliwość wycofania zmian.
- Sprawdzanie zgodności. W przypadku obciążeń podlegających regulacjom certyfikacja i dostępność regionalna mogą zawężać listę kandydatów, zanim jakość w ogóle stanie się tematem.
Gdzie jest to często przerywane
Paraliż wyboru ustawia się, gdy kilku kandydatów ma niejasne pozycjonowanie. Zespoły dopiero w trakcie planowania odkrywają, że wybrany model nie jest dostępny w ich regionie lub w danym wariancie SKU. Lub projekcja kosztów pokazuje, że nowy model jest znacznie droższy w przypadku rzeczywistego ruchu.
Co przynosisz
Testy porównawcze są obliczane na publicznych zestawach danych, więc traktuj ranking jako filtr, a nie linię zakończenia i potwierdź krótką listę względem własnego obciążenia. Prognoza kosztów to podobna historia: miesięczny widok opiera się na własnych logach tokenów, co jest proste, gdy masz już dane o ruchu.
Faza 3. Dostosowanie
Celem fazy adaptacji jest dostosowanie obciążenia roboczego tak, aby działało prawidłowo na nowym modelu. Odtwórz najpierw istniejące obciążenie bez zmian (aby wyizolować zmiany w zachowaniu wynikające z modelu), zdiagnozuj, co się zmieniło, a następnie iteracyjnie przeprojektuj rozwiązanie. Pomyślny rezultat to równoległe porównanie działania względem rzeczywistego lub reprezentatywnego ruchu, z rejestrowaniem każdej zmiany.
Adapt to coś więcej niż edycja promptów
Prompty są najbardziej widoczną warstwą, ale migracja zwykle obejmuje cztery inne:
-
Parametry.
temperature,top_p,max_tokensi ustawienia poziomu wysiłku rozumowania nie mają bezpośrednich odpowiedników między generacjami, a nowsze rodziny modeli mogą nie obsługiwać niektórych parametrów. - Definicje narzędzi. Może być konieczne zmiana kolejności lub zaostrzenie nazw argumentów, opisów i wymaganych pól, które niezawodnie kierowały starym modelem.
- Schematy wyjściowe. Modele różnią się w zależności od struktury danych wyjściowych. Może być konieczne dodanie do schematu jawnych ograniczeń, których stary model przestrzegał jedynie w luźny sposób, albo wreszcie będzie można wyegzekwować zgodność ze schematem.
- Kod wywołujący Różnice między powierzchnią interfejsu API i zestawem SDK (uzupełnienia czatu a odpowiedzi, kształt przesyłania strumieniowego i nowe lub zmienione pola żądania). Może być również konieczne zaktualizowanie analizy podrzędnej, która zakłada stary kształt odpowiedzi.
W przypadku obciążeń związanych z agentami i przepływami pracy praca nad schematami i wywołaniami narzędzi często ma większe znaczenie niż praca nad promptami.
Co należy wziąć pod uwagę
- Odtwórz ponownie bez zmian przed dostrojeniem. Uruchom bieżącą konfigurację w modelu docelowym bez żadnych zmian. Takie podejście pomaga oddzielić zachowanie zmienione przez model od zmian, które wprowadzasz Ty, i zapewnia punkt odniesienia.
- Zobacz, co się naprawdę zmienia. Szczegółowość, głębokość rozumowania, zgodność z wymaganym formatem wyjściowym, forma wywołania narzędzia, zachowanie przy odmowie oraz zmienność opóźnień często się zmieniają.
- Odtwarzaj rzeczywiste ślady, aby wykrywać regresje wywołań narzędzi. Dodatkowe pola, argumenty o zmienionych nazwach i zmieniona kolejność ujawniają się tylko w rzeczywistych śladach, a nie w benchmarkach jednoetapowych.
- Śledź zmiany. Przeprojektowanie promptu jest łatwe, ale równie łatwo zaprzepaścić jego efekty. Zachowaj oryginalną zawartość i zapisz, co się zmieniło i dlaczego.
Funkcje rozwiązania Foundry
Trzy funkcje rozwiązania Foundry obsługują tę fazę:
- Prompt Optimizer to przycisk Optymalizuj znajdujący się bezpośrednio pod polem instrukcji systemowej w środowisku testowym Agenta. Umożliwia zmianę instrukcji przy użyciu najlepszych rozwiązań z zakresu inżynierii monitów, przedstawia uzasadnienie poszczególnych akapitów dla każdej zmiany i obsługuje pętlę iteracji: dodaj sugestię, taką jak "zachowaj dokładnie schemat JSON" i ponownie zoptymalizuj. Dostępne tylko w narzędziu Foundry, a nie Azure OpenAI.
- Optymalizacja agenta dostraja instrukcje, narzędzia i wybór modelu łącznie pod kątem obciążeń agentowych. Dostępne tylko w narzędziu Foundry, a nie Azure OpenAI.
- Symulator generuje syntetyczne i adwersarialne dane wejściowe, gdy nie masz danych produkcyjnych do ponownego odtworzenia.
Gdzie jest to często przerywane
W przypadku wdrożeń osadzonych, skierowanych do użytkownika końcowego, ten etap zwykle zajmuje najwięcej czasu, ponieważ cykl diagnozowania jest ręczny: zespoły ponownie uruchamiają prompty, analizują różnice i rzadko odnotowują, co zmieniły lub dlaczego.
Co przynosisz
- Zacznij od optymalizatorów, a następnie sprawdź. Stosują ogólne najlepsze praktyki w jednym przebiegu, zamiast dopasowywać je do Twojego zbioru danych, i dostrajają tekst instrukcji, a nie definicje narzędzi ani schematy wyjściowe. Potraktuj wynik jako solidny szkic: najpierw skopiuj oryginalny prompt (nie ma historii wersji), a następnie ponownie oceń go na podstawie zamrożonego zestawu danych, zanim zaufasz tej zmianie.
- Zaplanuj dodatkowe prace ręczne przy przenoszeniu między rodzinami. Nie ma ścieżki „optymalizacji pod model docelowy X”, więc przejście między rodzinami modeli wymaga świadomego tłumaczenia promptów i schematów.
- Rejestruj ruch, zanim będzie potrzebny. Funkcja Replay jest tylko tak dobra, jak jakość rejestrowanych danych, a rejestrowanie zawartości wymaga uprzedniego włączenia i nigdy nie działa wstecz.
Faza 4. Weryfikacja
Celem etapu walidacji jest podjęcie decyzji, czy dostosowane obciążenie robocze jest bezpieczne do wdrożenia, poprzez ocenę go według kryteriów jakości na starannie dobranym zbiorze danych. Kryteria oceny mogą być oparte na regułach, na materiale referencyjnym, na modelu LLM w roli sędziego, na weryfikacji przez człowieka lub na strukturze właściwej dla danej dziedziny. Pomyślny rezultat to dostarczenie wiarygodnego zestawu do oceny, działającego na niezmiennym zbiorze danych, któremu ufa zarówno zespół aplikacji, jak i wszyscy recenzenci.
Walidacja jest jednym z etapów, ale ma dwa punkty styku, więc nie traktuj jej jako pojedynczego etapu na końcu procesu:
- Przygotuj się wcześnie. Zamrozij zestaw danych i kryteria powodzenia w sekcji Przed migracją przed dostosowaniem. Moment, w którym te zmiany, źródło i cel przestaną być porównywalne.
- Opóźnione bramkowanie, w dwóch przebiegach. Najpierw uruchom bieżący model w zamrożonym zestawie, aby ustanowić punkt odniesienia źródła, liczbę, którą należy pokonać. Następnie należy ocenić element docelowy na podstawie tego samego zestawu i podjąć decyzję.
Co należy wziąć pod uwagę
- Zachowaj zestaw danych i kryteria zamrożone. Jest to jedna najważniejsza dyscyplina w procesie utrzymania porównywalnych wyników.
- Zmierz trzy wymiary, które decydują o akceptacji: jakość (oceny ewaluatora lub reviewera), opóźnienie (czas do pierwszego tokenu i przepustowość, w odniesieniu wyłącznie do migrowanego wywołania) oraz koszt (koszt tokenów wejściowych i wyjściowych na żądanie).
- Dopasuj rubrykę do obciążenia. Kryteria oceny podsumowań klinicznych, warunek dotyczący kolejności wywołań narzędzi w przypadku agentów lub istniejące sygnały informacji zwrotnej od użytkowników mogą być bardziej miarodajne niż ogólny wynik.
- Traktuj bramę jako sygnał dla zespołów natywnych dla sztucznej inteligencji. Zamiast jednorazowej oceny zero-jedynkowej, ewaluacja odbywa się w sposób ciągły, przy każdym zatwierdzeniu zmian, i jest zintegrowana z Roll out.
Funkcje rozwiązania Foundry
Dwie funkcje rozwiązania Foundry obsługują tę fazę:
- Zestaw Azure AI Evaluation SDK zawiera ponad 30 wbudowanych ewaluatorów obejmujących ugruntowanie, istotność, wyszukiwanie, spójność, płynność, metryki oparte na referencjach (F1, BLEU i ROUGE), bezpieczeństwo oraz mechanizmy oceniające agentów i Azure OpenAI. Obejmuje również niestandardowy model LLM-as-judge do oceniania według kryteriów specyficznych dla danego zadania.
- Ocena w portalu uruchamia te same ewaluatory dla obiektów docelowych takich jak model, agent, zbiór danych i ślad.
Uruchom ten sam zestaw ewaluatorów dla zarówno źródła, jak i celu na zamrożonym zestawie danych, aby wyniki były porównywalne.
| Wymiar | Co mierzyć | Where |
|---|---|---|
| Jakość | Oceny ewaluatora dla źródła i celu | Azure zestaw SDK oceny sztucznej inteligencji, ocena portalu |
| Opóźnienie | Czas do pierwszego tokenu i przepustowość | Ranking testów porównawczych, metryki operacyjne |
| Cost | Koszt tokenu wejściowego i wyjściowego na żądanie | Dane wyjściowe oceny, cennik modelu |
Gdzie jest to często przerywane
Większość zespołów nie ma zestawu do ewaluacji, a te, które go mają, często stworzyły go samodzielnie. W przypadku obciążeń podlegających regulacjom obowiązkowa weryfikacja przez człowieka lub dział zarządzania jakością stanowi dodatkowy etap i staje się wąskim gardłem. Te migracje utknęły w trybie Validate, a nie Adapt.
Co przynosisz
Ewaluatory są gotowe do uruchomienia, ale przygotowanie testowego zestawu danych odpowiedniego dla domeny na podstawie your own ruchu produkcyjnego wymaga praktycznej pracy w przypadku obciążeń modelowych (nieagentowych). Dlatego właśnie etap przygotowania szybko się zwraca.
Faza 5. Wdrażanie
Celem tej fazy jest stopniowe wdrażanie zweryfikowanej konfiguracji na środowisko produkcyjne: najpierw na środowiska nieprodukcyjne, następnie w formie wdrożenia kanarkowego lub dla określonego procentu ruchu, a potem na szerszą skalę. Przez cały ten czas monitoruj opóźnienie w czasie rzeczywistym, błędy oraz, najlepiej, jakość względem poziomu bazowego sprzed migracji. Następnie zatwierdź lub wycofaj. Udany wynik to stopniowa ekspozycja przez kanary, ważony lub cień ruchu, sygnał jakości na żywo poza opóźnieniem i błędami oraz zachowaną ścieżkę wycofywania.
Co należy wziąć pod uwagę
- Poznaj typ wdrożenia. Typ wdrożenia określa sposób działania: wdrożenia z rodziny Standard mogą być automatycznie aktualizowane według harmonogramu, którym zarządzasz. Aprowizowane, wsadowe i dostosowane wdrożenia są migrowane ręcznie. W poniższej tabeli przedstawiono mechanikę według typu.
- Zachowaj korytarz wycofywania. Utrzymuj stare wdrożenie jako dostępne, dopóki nie nabierzesz pewności. Decyzje o cofnięciu zmian, wymuszone przez termin zakończenia wsparcia zamiast podejmowane na podstawie dowodów, są sygnałem ostrzegawczym, że zaczęto zbyt późno.
- Jeśli nie możesz zastosować wdrożenia kanarkowego, użyj trybu shadow lub mirror. Przepływy podlegające regulacjom (PHI, transakcje finansowe) często nie mogą wystawiać nowego modelu na rzeczywisty ruch klientów. Jest to odpowiednik polegający na uruchomieniu nowego modelu offline na produkcyjnych danych wejściowych i porównaniu jego wyników z wynikami starego modelu bez wpływu na użytkowników.
- Uważaj na regresje, których nie wykryła ocena offline. Opóźnienia doświadczane przez rzeczywistych użytkowników i zachowanie w przypadkach brzegowych mogą ujawnić się dopiero przy obciążeniu produkcyjnym.
Mechanika migracji według typu wdrożenia
| Typ wdrożenia | Podejście do migracji | Quota |
|---|---|---|
| Standardowy, Standardowy globalny, Standardowy strefy danych | Automatyczna aktualizacja według harmonogramu stopniowego. Steruj czasem za pomocą versionUpgradeOption (OnceNewDefaultVersionAvailable, OnceCurrentVersionExpired lub NoAutoUpgrade). Przetwarzanie priorytetowe przebiega tą samą ścieżką. |
Przenosi automatycznie |
| Udostępnione | Ręczne: na miejscu docelowym (ruch jest przekierowywany w ciągu 20–30 minut) lub równolegle (nowe wdrożenie, przekierowanie ruchu, usunięcie starego). | Najpierw upewnij się, że limit dla modelu docelowego jest dostępny |
| Batch | Równolegle: wdróż nowy model, uruchom zadania ponownie, a następnie wycofaj poprzednie wdrożenie. | Zapewnij limit dla modelu docelowego |
| Dostrojone (poza zakresem tego artykułu) | Nie jest automatycznie aktualizowany; oddzielne okresy wycofania dla szkolenia i wdrożenia. Dostosuj ponownie lub destyluj do zastępczego modelu bazowego. | Zapewnij limit dla modelu docelowego |
Po przełączeniu ruchu skonfiguruj ciągłą ocenę, aby oceniać wypróbkowany odsetek ruchu produkcyjnego na pulpicie nawigacyjnym Foundry Observability, połączonym ze śladami na potrzeby analizy przyczyn źródłowych, a także alertami usługi Azure Monitor na wypadek spadku jakości.
Gdzie jest to często przerywane
Spadki jakości, których nie wykryła ocena offline, ujawniają się przy obciążeniu produkcyjnym. Decyzje o wycofaniu zmian są często wymuszane przez termin deprecjacji, a nie podejmowane na podstawie przesłanek, co świadczy o tym, że migrację rozpoczęto zbyt późno.
Co przynosisz
Routowanie ważone między dwoma wdrożeniami realizuje się we własnej bramie lub warstwie aplikacji, a okres na wycofanie zmian jest celowym wyborem, aby utrzymać poprzednie wdrożenie w gotowości przez pewien czas (zespoły systemów wbudowanych zwykle potrzebują około 30 dni). Oba te elementy warto zaprojektować raz i wykorzystywać ponownie przy każdej migracji.
Faza 6. Wycofywanie
Celem fazy wycofania jest wycofanie z eksploatacji starego wdrożenia, zwolnienie zasobów, zarchiwizowanie artefaktów oceny oraz przekazanie informacji o zmianie dalej — do dokumentacji przeznaczonej dla klientów, stron marketingowych, procedur operacyjnych wsparcia technicznego i dzienników audytu, w przypadku których wymagane jest przechowywanie. Na koniec stare wdrożenie znika, liczba wdrożeń maleje, a wyciągnięte wnioski przechodzą do następnego cyklu.
Co należy wziąć pod uwagę
- Traktuj wycofywanie jako nadzór, a nie tylko porządkowanie. W przypadku obciążeń regulowanych obowiązki związane z przechowywaniem mogą wymagać przechowywania artefaktów przez lata.
- Potwierdź, że źródło rzeczywiście zniknąło. Sprawdź, czy stara wersja została wycofana, a następnie usuń wdrożenie, aby przestać zużywać pojemność.
- Wykorzystaj zdobyte wnioski w kolejnych działaniach. Włącz nowe dane śladowe z produkcji z powrotem do referencyjnego zbioru danych, aby kolejna migracja zaczęła się mniejszym kosztem.
Gdzie jest to często przerywane
Zespoły pomijają wycofanie, co prowadzi do akumulowania wdrożeń zombie. Zespoły, które nie przechodzą aktywnie na emeryturę, przeprowadzają znacznie więcej wdrożeń na żywo niż ich rówieśnicy, a większość z tych liczb to szczątki strukturalne z poprzednich migracji. Typowym pominiętym krokiem podrzędnym jest komunikacja: dokumentacja marketingowa i produktu nadal odwołuje się do starego modelu po zamianie.
Co przynosisz
Dashboard obserwowalności pokazuje, że liczba wdrożeń spada, ale decyzja o tym, które wdrożenia nadal obsługują ruch, należy do Twojego zespołu. Potraktuj planowanie emerytury jako wyraźnie zdefiniowane i śledzone zadanie, zamiast jedynie mieć nadzieję.
Migracja rzadko jest binarna
W praktyce migracje często mają charakter przejściowy: część obciążenia działa już w nowym modelu, podczas gdy ścieżka wrażliwa na opóźnienia lub obarczona wyższym ryzykiem pozostaje przy starym modelu, czasem przez kilka tygodni. Zaplanuj częściowe wdrożenie i częściowe wycofanie, zamiast jednorazowego przejścia ze starego modelu na nowy. Wycofywanie często następuje dopiero po tygodniach lub miesiącach od wdrożenia, a te stare wdrożenia, które nadal pozostają, są właśnie tym, co widać jako nadmiar.
Treści powiązane
- Poznaj harmonogram wycofywania i wsparcia w dokumencie Cykl życia modeli Foundry i zasady wsparcia
- Sprawdź daty wycofania i zamienniki w harmonogramie wycofywania modeli
- Zobacz, co już wycofano w wycofanych modelach Microsoft Foundry
- Porównanie modeli kandydatów z testami porównawczymi modeli i rankingami
- Dostosowywanie monitów do nowego modelu za pomocą funkcji Optymalizowanie monitów za pomocą optymalizatora monitów
- Zweryfikuj jakość przed przełączeniem, uruchamiając oceny z portalu Foundry
- Monitoruj zmigrowane obciążenie za pomocą obserwowalności w generatywnej AI