Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Użyj metody Kernel SHAP (SHapley Additive exPlanations), aby objaśnić model klasyfikacji danych tabelarycznych. Kernel SHAP to niezależna od modelu metoda, która szacuje wkład każdej cechy w predykcję modelu. Wytrenujesz model regresji logistycznej w zestawie danych Adult Census Income, a następnie użyjesz transformatora SynapseML TabularSHAP , aby obliczyć wyjaśnienia na poziomie funkcji.
Prerequisites
Uzyskaj subskrypcję usługi Microsoft Fabric. Możesz też utworzyć konto bezpłatnej wersji próbnej usługi Microsoft Fabric.
Zaloguj się do Microsoft Fabric.
Przełącz na Fabric, używając przełącznika doświadczenia w dolnym lewym rogu twojej strony głównej.
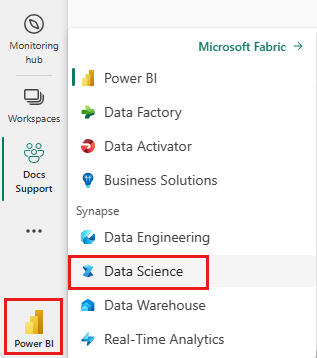
- Utwórz nowy notesnik w obszarze roboczym i dołącz go do magazynu danych. Aby uzyskać więcej informacji, zobacz Tworzenie notesu.
SynapseML, PySpark, pandas i plotly są preinstalowane w środowiskach notesników Fabric. Nie jest wymagana dodatkowa instalacja pakietu.
Importowanie pakietów i definiowanie pomocniczych funkcji UDF
W notesie Fabric wklej następujący kod do komórki i uruchom go. Ten krok importuje wymagane biblioteki i definiuje dwie funkcje zdefiniowane przez użytkownika (UDF) do wyodrębniania elementów wektorów później.
import pyspark
from synapse.ml.explainers import TabularSHAP
from pyspark.ml import Pipeline
from pyspark.ml.classification import LogisticRegression
from pyspark.ml.feature import StringIndexer, OneHotEncoder, VectorAssembler
from pyspark.sql.types import FloatType, ArrayType
from pyspark.sql.functions import col, lit, rand, broadcast, udf
import pandas as pd

vec_access = udf(lambda v, i: float(v[i]), FloatType())
vec2array = udf(lambda vec: vec.toArray().tolist(), ArrayType(FloatType()))
Sprawdź: uruchom następujący kod w nowej komórce. Powinny zostać wyświetlone dane wyjściowe TabularSHAP imported successfully.
print("TabularSHAP imported successfully")
print(f"PySpark version: {pyspark.__version__}")
Ładowanie danych i trenowanie modelu klasyfikacji
Załaduj zestaw danych Adult Census Income z Azure Blob Storage, zaindeksuj etykietę docelową i wytrenuj potok regresji logistycznej.
df = spark.read.parquet(
    "wasbs://publicwasb@mmlspark.blob.core.windows.net/AdultCensusIncome.parquet"
)

labelIndexer = StringIndexer(
    inputCol="income", outputCol="label", stringOrderType="alphabetAsc"
).fit(df)
print("Label index assignment: " + str(set(zip(labelIndexer.labels, [0, 1]))))

training = labelIndexer.transform(df).cache()

categorical_features = [
    "workclass",
    "education",
    "marital-status",
    "occupation",
    "relationship",
    "race",
    "sex",
    "native-country",
]
categorical_features_idx = [feat + "_idx" for feat in categorical_features]
categorical_features_enc = [feat + "_enc" for feat in categorical_features]
numeric_features = [
    "age",
    "education-num",
    "capital-gain",
    "capital-loss",
    "hours-per-week",
]

strIndexer = StringIndexer(
    inputCols=categorical_features, outputCols=categorical_features_idx
)
onehotEnc = OneHotEncoder(
    inputCols=categorical_features_idx, outputCols=categorical_features_enc
)
vectAssem = VectorAssembler(
    inputCols=categorical_features_enc + numeric_features, outputCol="features"
)
lr = LogisticRegression(featuresCol="features", labelCol="label", weightCol="fnlwgt")
pipeline = Pipeline(stages=[strIndexer, onehotEnc, vectAssem, lr])
model = pipeline.fit(training)
Sprawdź: Uruchom następującą komórkę. Powinny zostać wyświetlone liczby wierszy dla danych szkoleniowych i potwierdzenie etapów potoku.
print(f"Training rows: {training.count()}")
print(f"Pipeline stages: {[type(s).__name__ for s in model.stages]}")
assert training.count() > 30000, "Dataset should contain over 30,000 rows"
print("Model trained successfully")

# Expected output:
#Training rows: 32561
#Pipeline stages: ['StringIndexerModel', 'OneHotEncoderModel', #'VectorAssembler', 'LogisticRegressionModel']
#Model trained successfully
Wybierz obserwacje, aby wyjaśnić
Losowo wybierz pięć obserwacji z ocenianych danych treningowych. Te obserwacje to wystąpienia, dla których generujesz wyjaśnienia SHAP.
explain_instances = (
    model.transform(training).orderBy(rand()).limit(5).repartition(200).cache()
)
display(explain_instances)
Sprawdź: Potwierdź rozmiar próbki.
count = explain_instances.count()
print(f"Explain instances: {count}")
assert count == 5, f"Expected 5 rows, got {count}"
print("Sample selected successfully")
Konfigurowanie i uruchamianie programu TabularSHAP
Utwórz objaśnienie TabularSHAP i zastosuj je do wybranych obserwacji. Kluczowe parametry to:
| Parameter | Opis |
|---|---|
inputCols |
Kolumny funkcji używane przez model do przewidywania. |
outputCol |
Nazwa kolumny zawierającej wartości wyjściowe SHAP. |
numSamples |
Liczba próbek perturbacji do estymacji metodą Kernel SHAP. Wyższe wartości są dokładniejsze, ale wolniejsze. |
model |
Wytrenowany model potoku do wyjaśnienia. |
targetCol |
Kolumna danych wyjściowych modelu do wyjaśnienia. W tym przykładzie kolumna to probability. |
targetClasses |
Indeksy klas do objaśnienia.
[1] wyjaśnia tylko prawdopodobieństwo klasy 1. Użyj [0, 1], aby wyjaśnić obie klasy. |
backgroundData |
Przykład danych szkoleniowych używanych jako dystrybucja referencyjna do integrowania funkcji. |
shap = TabularSHAP(
    inputCols=categorical_features + numeric_features,
    outputCol="shapValues",
    numSamples=5000,
    model=model,
    targetCol="probability",
    targetClasses=[1],
    backgroundData=broadcast(training.orderBy(rand()).limit(100).cache()),
)

shap_df = shap.transform(explain_instances)
Note
Ten krok może potrwać kilka minut w zależności od numSamples i rozmiaru klastra. W przypadku numSamples=5000 i pięciu obserwacji spodziewaj się 3–10 minut w domyślnym klastrze Fabric Spark.
Sprawdź: Sprawdź, czy kolumna danych wyjściowych SHAP istnieje.
assert "shapValues" in shap_df.columns, "shapValues column missing"
print(f"SHAP output columns: {shap_df.columns}")
print("TabularSHAP transform completed")
Wyodrębnij wartości SHAP
Wyodrębnij wartości prawdopodobieństwa klasy 1 i SHAP z wynikowej ramki danych. Dla każdej obserwacji wektor wartości SHAP rozpoczyna się od wartości podstawowej (średniej danych wyjściowych zestawu danych w tle), a następnie jednej wartości na funkcję.
shaps = (
    shap_df.withColumn("probability", vec_access(col("probability"), lit(1)))
    .withColumn("shapValues", vec2array(col("shapValues").getItem(0)))
    .select(
        ["shapValues", "probability", "label"] + categorical_features + numeric_features
    )
)

shaps_local = shaps.toPandas()
shaps_local.sort_values("probability", ascending=False, inplace=True, ignore_index=True)
pd.set_option("display.max_colwidth", None)
display(shaps_local)
Sprawdź: Potwierdź strukturę obiektu DataFrame biblioteki pandas.
expected_cols = len(categorical_features) + len(numeric_features) + 3
print(f"DataFrame shape: {shaps_local.shape}")
print(f"Expected columns: {expected_cols}, Actual: {shaps_local.shape[1]}")
assert shaps_local.shape == (5, expected_cols), f"Unexpected shape: {shaps_local.shape}"
print("SHAP values extracted successfully")
Wizualizowanie wartości SHAP
Utwórz wykres słupkowy dla każdej obserwacji, który pokazuje, jak każda funkcja przyczynia się do przewidywanego prawdopodobieństwa.
from plotly.subplots import make_subplots
import plotly.graph_objects as go

features = categorical_features + numeric_features
features_with_base = ["Base"] + features

rows = shaps_local.shape[0]

fig = make_subplots(
    rows=rows,
    cols=1,
    subplot_titles="Probability: "
    + shaps_local["probability"].apply("{:.2%}".format)
    + "; Label: "
    + shaps_local["label"].astype(str),
)

for index, row in shaps_local.iterrows():
    feature_values = [0] + [row[feature] for feature in features]
    shap_values = row["shapValues"]
    list_of_tuples = list(zip(features_with_base, feature_values, shap_values))
    shap_pdf = pd.DataFrame(list_of_tuples, columns=["name", "value", "shap"])
    fig.add_trace(
        go.Bar(
            x=shap_pdf["name"],
            y=shap_pdf["shap"],
            hovertext="value: " + shap_pdf["value"].astype(str),
        ),
        row=index + 1,
        col=1,
    )

fig.update_yaxes(range=[-1, 1], fixedrange=True, zerolinecolor="black")
fig.update_xaxes(type="category", tickangle=45, fixedrange=True)
fig.update_layout(height=400 * rows, title_text="SHAP explanations")
fig.show()
Sprawdź: Upewnij się, że obiekt wykresu został utworzony.
print(f"Figure traces: {len(fig.data)}")
print(f"Figure height: {fig.layout.height}px")
assert len(fig.data) == 5, f"Expected 5 traces, got {len(fig.data)}"
print("Visualization created successfully")
Interpretacja wyników
Każdy podlot reprezentuje jedną obserwację. Słupki pokazują:
- Podstawa: średnie dane wyjściowe modelu w zestawie danych w tle (prawdopodobieństwo punktu odniesienia).
- Dodatnie wartości SHAP: cechy, które przesuwają predykcję w kierunku klasy 1 (dochód większy niż 50 tys.).
- Ujemne wartości SHAP: funkcje, które wypychają przewidywanie do klasy 0 (dochód mniejszy lub równy 50K).
Suma wartości bazowej i wszystkich wartości SHAP cech jest równa przewidywanemu przez model prawdopodobieństwu dla tej obserwacji.
Troubleshooting
| Problematyka | Przyczyna | Resolution |
|---|---|---|
OutOfMemoryError podczas TabularSHAP |
numSamples jest za duży dla dostępnej pamięci. |
Zmniejsz numSamples, na przykład do 1 000, lub zwiększ pamięć executora Spark. |
| Transformacja SHAP jest powolna | Wysokie numSamples z wieloma funkcjami zwiększa czas obliczeniowy. |
Zmniejsz numSamples do 1000–2000, aby uzyskać szybsze wyniki eksploracyjne. Zwiększ wartość na potrzeby ostatecznej analizy. |
FileNotFoundException dla parquet |
Dostęp do mmlspark.blob.core.windows.net z sieci jest zablokowany. |
Sprawdź, czy obszar roboczy Fabric ma wychodzący dostęp do Internetu. Alternatywnie prześlij zestaw danych do swojego lakehouse’u. |
shapValues kolumna zawiera wartości null |
Niektóre obserwacje mogą zakończyć się niepowodzeniem, jeśli wartości funkcji znajdują się poza rozkładem trenowania. | Sprawdź, czy w cechach wejściowych występują wartości null lub wartości nieoczekiwane. Filtruj wartości null z wyników. |
display() pokazuje brak danych wyjściowych |
Kod działa poza środowiskiem notesu Fabric. | Użyj shaps_local.head() lub print(shaps_local) w standardowych środowiskach Python. |
Czyszczenie
Jeśli przesłano zestaw danych do lakehouse w ramach tego samouczka, usuń go, aby zwolnić miejsce w magazynie:
# Remove cached DataFrames from memory
training.unpersist()
explain_instances.unpersist()
print("Cached DataFrames released")