Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Dotyczy:✅ Magazyn w systemie Microsoft Fabric
Ten artykuł opisuje metody migracji hurtowni danych w SQL Server do Microsoft Fabric Data Warehouse.
Wskazówka
Więcej informacji o strategii i planowaniu można znaleźć w artykule Migration planning: SQL Server to Fabric Data Warehouse.
Skorzystaj z Fabric Asystent migracji for Data Warehouse do zautomatyzowanej migracji z SQL Server. Reszta tego artykułu opisuje bardziej ręczne kroki migracji.
Poniższa tabela podsumowuje metody migracji schematu danych (DDL), kodu bazy danych (DML) oraz danych. Każda opcja została opisana później w tym artykule.
| Option | Metoda | Do czego służy | Umiejętność lub preferencje | Scenario |
|---|---|---|---|---|
| 1 | Fabryka danych | Konwersja schematu Wyodrębnianie danych Pozyskiwanie danych |
potok usługi Data Factory | Uproszczony schemat i migracja danych. Zalecane w przypadku tabel wymiarów. |
| 2 | Data Factory z podziałem na partycje | Konwersja schematu Wyodrębnianie danych Pozyskiwanie danych |
potok usługi Data Factory | Równoległa migracja dla dużych tabel faktów. |
| 3 | Migracja typu Schema first | Konwersja schematu | Potok w usłudze Data Factory | Najpierw migruj schemat, a następnie wyodrębnij i pobieraj dane osobno, aby zwiększyć kontrolę nad przepustowością. |
| 4 | Skrypty migracji SQL | Konwersja schematu Wyodrębnianie danych Ocena kodu |
T-SQL | Używaj IDE i skryptów do szczegółowej kontroli zadań migracyjnych. |
| 5 | projekty baz danych SQL | Konwersja schematu Ocena kodu |
Projekt SQL | Użyj projektu bazy danych do kontroli źródła, oceny i wdrażania. |
| 6 | dbt | Konwersja schematu Konwersja kodu bazy danych |
dbt | Ponownie wykorzystaj istniejący projekt dbt, zmieniając adapter i konfigurację docelową. |
Wybieranie obciążenia na potrzeby migracji początkowej
Kiedy zdecydujesz, od czego rozpocząć projekt migracji z programu SQL Server do usługi Fabric Data Warehouse, wybierz obszar obciążenia, w którym możesz:
- Udowodnij wykonalność migracji do Fabric Data Warehouse, szybko dostarczając korzyści z nowego środowiska. Zacznij od małych i prostych kroków, przygotowując się na wielokrotne małe migracje.
- Daj swojemu zespołowi technicznemu czas na zdobycie odpowiedniego doświadczenia w procesach i narzędziach, których używają do migracji innych obciążeń.
- Stwórz szablon do dalszych migracji dostosowany do środowiska, narzędzi i procesów SQL Server.
Wskazówka
Stwórz inwentarz obiektów, które wymagają migracji, i dokumentuj proces migracji od początku do końca, aby mógł być powtarzany dla innych baz danych lub obciążeń.
Objętość danych podczas początkowej migracji powinna być na tyle duża, by pokazać możliwości i korzyści Fabric Data Warehouse, ale jednocześnie na tyle mała, by szybko wykazać wartość. Typowy jest rozmiar zakresu 1–10 terabajtów.
Migracja z Fabric Data Factory
Fabric Data Factory oferuje interfejs low-code, który może konwertować DDL tabel i migrować dane z SQL Server.
Usługa Fabric Data Factory może wykonywać następujące zadania:
- Przekonwertowanie schematu (DDL) na składnię Fabric Data Warehouse.
- Tworz obiekty schematu w Fabric Data Warehouse.
- Migracja danych do Fabric Data Warehouse.
Opcja 1. Migracja schematów i danych z pomocą asystenta kopiowania
Ta metoda wykorzystuje asystenta kopiowania Data Factory do łączenia ze źródłową bazą danych SQL Server, konwertowania instrukcji DDL tabeli na składnię Fabric oraz kopiowania danych do magazynu danych Fabric. Możesz wybrać jedną lub więcej tabel źródłowych. Wygenerowany potok wykorzystuje aktywność ForEach do kopiowania wybranych tabel równolegle.
Podczas konfiguracji operacji kopiowania:
- Użyj złącza SQL Server do połączenia źródłowego.
- Ogranicz kopie równoległe do poziomu, który źródłowa baza danych i sieć są w stanie utrzymać.
- Monitoruj obciążenie procesora źródłowego, operacje we/wy, użycie dziennika transakcyjnego oraz opóźnienia produkcyjnego obciążenia podczas ekstrakcji.
Zalecane użycie
Użyj narzędzia Copy assistant, aby skorzystać z prostego interfejsu, który konwertuje DDL i importuje wybrane tabele w ramach jednej operacji. Ta metoda dobrze sprawdza się w tabelach wymiarowych i mniejszych obciążeniach.
Dla dużych tabel użyj partycjonowania, aby zwiększyć równoległość odczytu i zapisu.
Opcja 2. Migracja danych z partycjonowaniem
W przypadku dużych tabel faktów użyj dla każdej tabeli działania Copy i skonfiguruj partycjonowanie po stronie źródła. Używaj fizycznych partycji, gdy są dostępne, lub konfiguruj podziały zakresu dynamicznego, określając odpowiednią kolumnę liczbową lub datową oraz jej minimalne i maksymalne wartości.
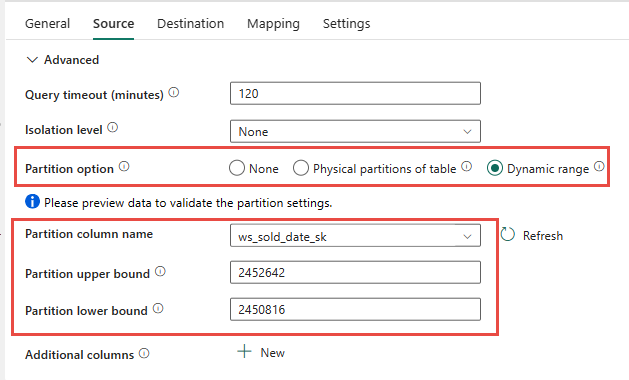
Gdy używasz partycjonowania:
- Wybierz kolumnę partycji, która równomiernie rozdziela wiersze.
- Unikaj tworzenia większej liczby współcześnych zapytań źródłowych, niż SQL Server jest w stanie przetworzyć bez wpływu na obciążenia produkcyjne.
- Testuj zakres partycji i ustawienia kopiowania równoległego względem reprezentatywnego obciążenia.
- Stopniowo zwiększać równoległość, monitorując źródło i cel.
Zalecane użycie
Użyj partycjonowania w usłudze Data Factory dla dużych tabel faktów, gdy ekstrakcja równoległa zwiększa przepustowość. Rozmiar liczby partii i zakresów partycji dostosuj do zasobów bazy źródłowej i przepustowości sieci.
Opcja 3. Migracja typu Schema first
W przypadku większych baz danych oddziel migrację schematu od migracji danych:
- Konwertuj i twórz schematy tabel w Fabric Data Warehouse.
- Wyodrębnij dane źródłowe do Azure Data Lake Storage (ADLS) Gen2.
- Użyj Data Factory lub polecenia COPY INTO, aby pobrać dane etapowe do Fabric Data Warehouse.
Oddzielenie tych faz pozwala samodzielnie dostroić ekstrakcję i spożycie.
Migracja schematu z Data Factory
Możesz użyć Fabric pipeline do migracji schematów tabel z SQL Server do Fabric Data Warehouse bez kopiowania wierszy.
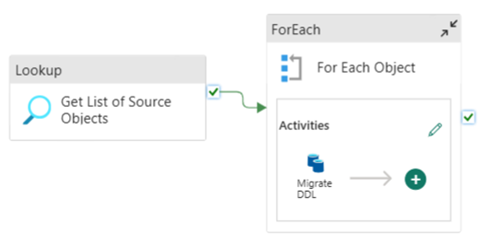
Konfiguruj parametry potoku
Stwórz parametr, SchemaName który określa, które schematy mają się przenieść. Użyj dbo jako domyślnej lub wprowadź listę oddzieloną przecinkami, taką jak 'dbo','sales'.
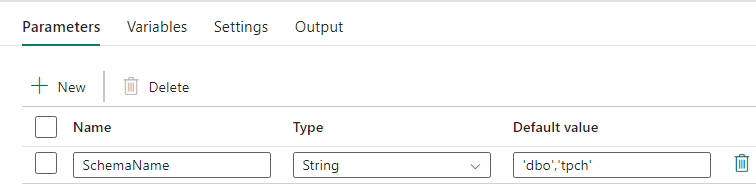
Konfiguruj aktywność wyszukiwania
Utwórz aktywność wyszukiwania i ustaw jej połączenie z bazą źródłową SQL Server. Na karcie Ustawienia:
- Ustaw typ magazynu danych na Zewnętrzny.
- Wybierz źródłowe połączenie SQL Server.
- Ustaw Użyj zapytania na Zapytanie.
- Dodaj dynamiczne zapytanie, które zwraca schemat źródłowy i nazwy tabel.
Użyj następującego wyrażenia, aby utworzyć zapytanie:
@concat('
SELECT s.name AS SchemaName,
t.name AS TableName
FROM sys.tables AS t
INNER JOIN sys.schemas AS s
ON t.type = ''U''
AND s.schema_id = t.schema_id
AND s.name in (',coalesce(pipeline().parameters.SchemaName, 'dbo'),')
')
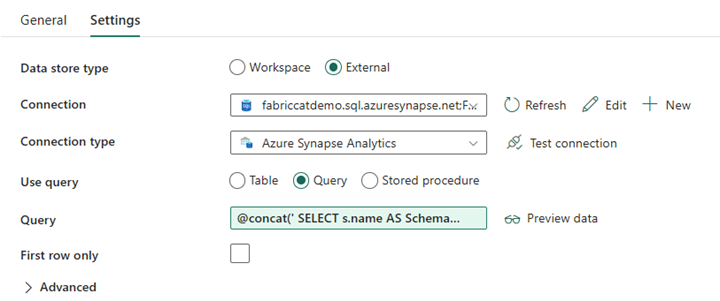
Konfiguruj aktywność ForEach
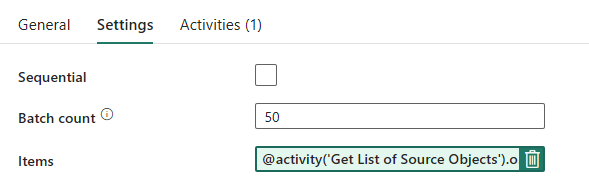
Na karcie Ustawienia aktywności ForEach:
- Wyłącz opcję Sequential, aby umożliwić równoległe uruchamianie iteracji.
- Ustaw liczbę wsad na wartość, którą baza źródłowa może utrzymać. Zacznij od wartości konserwatywnej i przetestuj ją.
- Ustaw elementy na
@activity('Get List of Source Objects').output.value.
Skonfiguruj działanie kopiowania
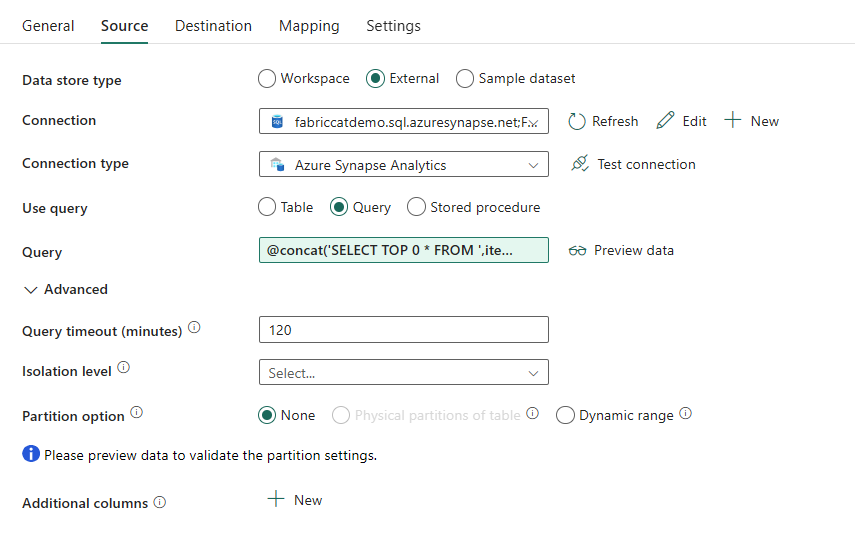
W ramach aktywności ForEach dodaj aktywność kopiowania. Na karcie Źródło:
- Ustaw typ magazynu danych na Zewnętrzny.
- Wybierz źródłowe połączenie SQL Server.
- Ustaw Użyj zapytania na Zapytanie.
-
Ustaw zapytanie tak,
@concat('SELECT TOP 0 * FROM ',item().SchemaName,'.',item().TableName)aby migrowane były tylko metadane tabeli.
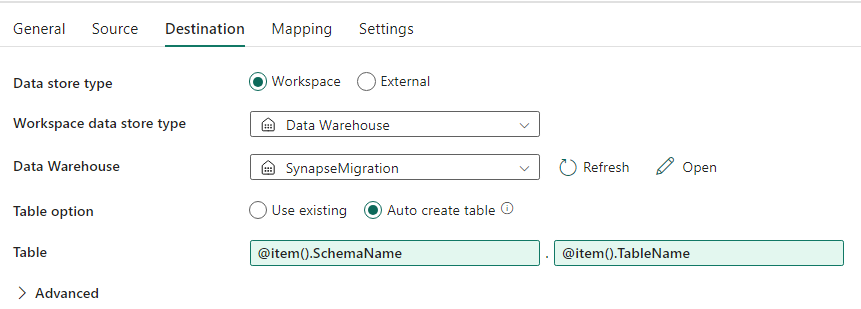
Na karcie Miejsce docelowe:
- Ustaw Typ magazynu danych na Obszar roboczy.
- Ustaw typ magazynu danych Workspace na Data Warehouse i wybierz docelowy magazyn.
- Ustaw schemat docelowy na
@item().SchemaName. - Ustaw tabelę docelową na
@item().TableName.
Po uruchomieniu pipeline'u sprawdź, czy Fabric Data Warehouse zawiera każdą wybraną tabelę z oczekiwanym schematem.
Migracja za pomocą skryptów SQL
Używaj skryptów migracji T-SQL i PowerShell, gdy chcesz mieć szczegółową kontrolę nad konwersją schematów, ekstrakcją danych i oceną kodu.
Skrypty migracji mogą:
- Przekonwertowanie schematu (DDL) na składnię Fabric Data Warehouse.
- Tworz obiekty schematu w Fabric Data Warehouse.
- Ekstrakt danych z SQL Server do ADLS Gen2.
- Oznacz nieobsługiwaną składnię T-SQL w procedurach, funkcjach i widokach przechowywanych.
Zespół CAT Microsoft Fabric udostępnia przykłady kodu do migracji w repozytorium fabric-migration.
Zalecane użycie
Korzystaj ze skryptów, gdy znasz T-SQL, preferujesz zintegrowane środowisko programistyczne i musisz kontrolować poszczególne zadania migracji. Użyj COPY INTO lub Data Factory, aby zaimportować wyodrębnione dane do magazynu danych Fabric Data Warehouse.
Migrowanie przy użyciu projektów bazy danych SQL
Usługa Fabric Data Warehouse jest obsługiwana w rozszerzeniu SQL Database Projects dla Visual Studio Code.
Projekt bazy danych SQL zapewnia kontrolę wersji, testowanie baz danych, walidację schematów oraz możliwości wdrożenia. Usługa ma następujące możliwości:
- Przekonwertowanie schematu (DDL) na składnię Fabric Data Warehouse.
- Tworz obiekty schematu w Fabric Data Warehouse.
- Oceń nieobsługiwaną składnię T-SQL w procedurach, funkcjach i widokach przechowywanych.
Do migracji danych użyj usługi Data Factory, aby kopiować dane bezpośrednio z programu SQL Server, albo wyodrębnij dane do usługi ADLS Gen2 i załaduj je przy użyciu COPY INTO lub usługi Data Factory.
Opis korzystania z projektów baz danych SQL ze skryptami migracji można znaleźć w repozytorium fabric-migration.
Więcej informacji można znaleźć w artykułach Wprowadzenie do rozszerzenia SQL Database Projects oraz Utwórz projekt bazy danych z poziomu wiersza polecenia.
Migracja z dbt
Jeśli Twoja hurtownia danych SQL Server używa dbt, możesz użyć adaptera dbt dla usługi Fabric Data Warehouse do konwersji schematu i kodu bazy danych przez zmianę profilu docelowego i adaptera.
Framework dbt generuje skrypty DDL i DML z plików modeli. Dane musisz migrować osobno, korzystając z Data Factory lub innej opcji migracji danych opisanej w tym artykule.
Aby rozpocząć, zobacz Samouczek: Skonfiguruj dbt dla usługi Fabric Data Warehouse.
Pobieranie danych do Fabric Data Warehouse
Dla danych etapowych użyj COPY INTO lub Fabric Data Factory, aby pobrać pliki z ADLS Gen2 do Fabric Data Warehouse. Weź pod uwagę następujące wskazówki:
- Równolegle wyodrębniaj duże tabele, gdy baza danych i sieć źródłowa mają wystarczającą pojemność.
- Preferuj pliki Parquet, aby zmniejszyć zużycie pamięci i sieci oraz poprawić efektywność pobierania.
- Ładuj jednocześnie wiele tabel docelowych, gdy usługa Fabric może obsłużyć to obciążenie.
- Monitoruj zarówno ekstrakcję źródłową, jak i pojemność Fabric, aby znaleźć optymalny stopień równoległości.