Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Dotyczy: ✅ Magazynu w platformie Microsoft Fabric
Ten artykuł opisuje metody migracji z Azure Synapse Analytics dedykowanych pul SQL do Microsoft Fabric Data Warehouse.
Tip
Więcej informacji dotyczących strategii i planowania migracji znajdziesz w Planowanie migracji: z dedykowanych pul SQL usługi Azure Synapse Analytics do magazynu danych Fabric.
Zautomatyzowane środowisko migracji z dedykowanych pul SQL usługi Azure Synapse Analytics jest dostępne przy użyciu narzędzia Fabric Asystent migracji for Data Warehouse. Pozostała część tego artykułu zawiera więcej kroków migracji ręcznej.
Poniższa tabela podsumowuje metody migracji schematu danych (DDL), kodu bazy danych (DML) oraz danych. Kolumna Opcja zawiera szczegóły dla każdego scenariusza.
| Numer opcji | Opcja | Do czego służy | Umiejętność lub preferencje | Scenariusz |
|---|---|---|---|---|
| 1 | Fabryka Danych | Konwersja schematu (DDL) Wyciąg danych Pozyskiwanie danych |
ADF/Pipeline | Uproszczenie schematu wszystko-w-jednym (DDL) i migracji danych. Zalecane w przypadku tabel wymiarów. |
| 2 | Fabryka Danych z partycją | Konwersja schematu (DDL) Wyciąg danych Pozyskiwanie danych |
ADF/Pipeline | Użycie opcji partycjonowania w celu zwiększenia równoległości odczytu/zapisu, co zapewnia dziesięciokrotnie większą przepływność w porównaniu z opcją 1, jest zalecane dla tabel faktów. |
| 3 | Usługa Data Factory z przyspieszonym kodem | Konwersja schematu (DDL) | ADF/Pipeline | Najpierw przekonwertuj i zmigruj schemat (DDL), a następnie użyj CETAS do wyodrębnienia danych, a COPY lub Data Factory do ich zaimportowania, aby osiągnąć optymalną ogólną wydajność pozyskiwania danych. |
| 4 | Przyspieszony kod procedur przechowywanych | Konwersja schematu (DDL) Wyciąg danych Ocena kodu |
Język T-SQL | Użytkownik SQL korzystający ze środowiska IDE z bardziej szczegółową kontrolą nad zadaniami, nad którymi chcą pracować. Użyj funkcji COPY/Data Factory do pozyskiwania danych. |
| 5 | Rozszerzenie projektu usługi SQL Database dla programu Visual Studio Code | Konwersja schematu (DDL) Wyciąg danych Ocena kodu |
Projekt SQL | Projekt usługi SQL Database na potrzeby wdrożenia z integracją opcji 4. Użyj COPY lub Data Factory do pozyskiwania danych. |
| 6 | UTWÓRZ ZEWNĘTRZNĄ TABELĘ Z WYBOREM (CETAS) | Wyciąg danych | Język T-SQL | Ekonomiczny i wysokowydajny eksport danych do Azure Data Lake Storage (ADLS) Gen2. Użyj funkcji COPY/Data Factory do pozyskiwania danych. |
| 7 | Migracja za pomocą dbt | Konwersja schematu (DDL) Konwersja kodu bazy danych (DML) |
dbt | Istniejący użytkownicy dbt mogą użyć adaptera dbt Fabric do konwersji swoich DDL i DML. Następnie należy przeprowadzić migrację danych przy użyciu innych opcji w tej tabeli. |
Wybieranie obciążenia na potrzeby migracji początkowej
Decydując, od czego zacząć projekt migracji z dedykowanej puli SQL w usłudze Synapse do usługi Fabric Data Warehouse, wybierz obszar obciążenia roboczego, w którym możesz:
- Udowodnij wykonalność migracji do Fabric Data Warehouse, szybko dostarczając korzyści z nowego środowiska. Zacznij od małych i prostych kroków, przygotowując się na wielokrotne małe migracje.
- Zezwól pracownikom technicznym na uzyskanie odpowiedniego doświadczenia z procesami i narzędziami używanymi podczas migracji do innych obszarów.
- Utwórz szablon dla dalszych migracji, który będzie specyficzny dla źródłowego środowiska Synapse oraz narzędzi i procesów wspomagających.
Tip
Stwórz inwentarz obiektów do migracji i dokumentuj proces migracji od początku do końca, aby móc powtórzyć go dla innych dedykowanych pul SQL lub obciążeń.
Objętość przeniesionych danych podczas początkowej migracji powinna być wystarczająco duża, aby pokazać możliwości i korzyści środowiska Fabric Data Warehouse, ale nie zbyt duża, by szybko wykazać wartość. Typowy jest rozmiar zakresu 1–10 terabajtów.
Migracja za pomocą usługi Fabric Data Factory
Ta sekcja opisuje opcje Data Factory dla użytkowników zaznajomionych z potokami Azure Data Factory i Synapse. Interfejs typu „przeciągnij i upuść” umożliwia łatwą konwersję DDL i migrację danych.
Usługa Fabric Data Factory może wykonywać następujące zadania:
- Przekonwertuj schemat (DDL) na składnię Fabric Data Warehouse.
- Stwórz schemat (DDL) na Fabric Data Warehouse.
- Przenieś dane do Fabric Data Warehouse.
Opcja 1. Migracja schematu i danych — Asystent kopiowania danych oraz działanie ForEach Copy
Ta metoda wykorzystuje asystenta Copy data w usłudze Data Factory do nawiązania połączenia ze źródłową dedykowaną pulą SQL, przekonwertowania składni DDL dedykowanej puli SQL do składni Fabric oraz skopiowania danych do magazynu danych Fabric. Można wybrać co najmniej jedną tabelę docelową (dla zestawu danych TPC-DS istnieje 22 tabele). Generuje pętlę ForEach, aby przejść przez listę tabel wybranych w interfejsie użytkownika i tworzenia 22 równoległych wątków procesu kopiowania.
- W dedykowanej puli SQL generowane są i wykonywane 22
SELECTzapytania (po jednym dla każdej wybranej tabeli). - Upewnij się, że masz odpowiednie DWU i klasę zasobu, aby generowane zapytania mogły się wykonać. W tym przypadku potrzebujesz co najmniej DWU1000 z
staticrc10, aby umożliwić obsługę maksymalnie 32 zapytań przy 22 przesłanych zapytaniach. - Kopiowanie danych bezpośrednio z dedykowanej puli SQL do Fabric Data Warehouse przy użyciu usługi Data Factory wymaga obszaru przejściowego. Proces przyjmowania ma dwie fazy:
- Pierwsza faza wyodrębnia dane z dedykowanej puli SQL do ADLS. Ten etap nazywa się przygotowaniem.
- Druga faza ładuje dane przejściowe do magazynu danych Fabric Data Warehouse. Większość czasu ładowania danych przypada na etap przygotowania, więc ten etap ma istotny wpływ na wydajność.
Zalecane użycie
Użycie asystenta kopiowania do generowania aktywności ForEach zapewnia prosty interfejs do konwersji DDL i pobierania wybranych tabel z dedykowanej puli SQL na Fabric Data Warehouse w jednym kroku.
Jednak ta opcja nie zapewnia optymalnej przepustowości. Etapowanie oraz potrzeba równoległości odczytów i zapisów podczas fazy źródło-etap to główne źródła opóźnień. Użyj tej opcji tylko dla tabel wymiarowych.
Opcja 2. Migracja DDL/Data – przepływ danych z opcją partycjonowania
Aby poprawić przepustowość podczas ładowania większych tabel faktów za pomocą potoku Fabric, użyj działania Kopiowanie dla każdej tabeli faktów i włącz partycjonowanie. Ta konfiguracja zapewnia najlepszą wydajność działanie Kopiuj.
Używaj fizycznych partycji tabeli źródłowej, gdy są dostępne. Jeśli tabela nie jest fizycznie podzielona, określ kolumnę partycji oraz minimalne i maksymalne wartości dla dynamicznego partycjonowania. Na poniższym zrzucie ekranu opcje Source potoku określają dynamiczny zakres partycji na podstawie kolumny ws_sold_date_sk.

Partycjonowanie może zwiększyć przepustowość środowiska przejściowego. Weź pod uwagę następujące wskazówki podczas konfiguracji:
- W zależności od zakresu partycji, operacja może generować ponad 128 zapytań i wykorzystywać wszystkie sloty współbieżności w dedykowanej puli SQL.
- Musisz zwiększyć skalę do co najmniej DWU6000, aby można było wykonać wszystkie zapytania.
- Na przykład w przypadku tabeli TPC-DS
web_salesdo dedykowanej puli SQL przesłano 163 zapytania. Przy DWU6000 wykonano 128 zapytań, podczas gdy 35 zostało w kolejce. - Partycja dynamiczna automatycznie wybiera partycję przedziałową. W tym przypadku 11-dniowy zakres dla każdego zapytania SELECT przesłanego do dedykowanej puli SQL. Na przykład:
WHERE [ws_sold_date_sk] > '2451069' AND [ws_sold_date_sk] <= '2451080')
...
WHERE [ws_sold_date_sk] > '2451333' AND [ws_sold_date_sk] <= '2451344')
Zalecane użycie
Dla tabel faktów użyj Data Factory z opcją partycjonowania, aby zwiększyć przepustowość.
Jednak odczyty równoległe wymagają zwiększenia dedykowanej puli SQL do wyższego poziomu DWU, aby można było wykonywać zapytania ekstrakcyjne. Partycjonowanie poprawia wydajność dziesięciokrotnie w porównaniu z jego brakiem. Możesz zwiększyć DWU dla większej przepustowości, ale dedykowana pula SQL pozwala maksymalnie na 128 aktywnych zapytań.
Więcej informacji na temat mapowania jednostek DWU usługi Synapse na usługę Fabric znajdziesz tutaj: Blog: Mapowanie dedykowanych pul SQL usługi Azure Synapse na moc obliczeniową usługi Fabric Data Warehouse.
Opcja 3. Migracja DDL - Asystent kopiowania danych dla każdej aktywności kopiowania
Dwie poprzednie opcje nadają się do mniejszych baz danych. Jeśli potrzebujesz wyższej przepustowości, skorzystaj z tej alternatywy:
- Wyeksportuj dane z dedykowanej puli SQL do usługi ADLS, aby zmniejszyć narzut związany z magazynowaniem pośrednim.
- Użyj Data Factory lub polecenia COPY, aby pobrać dane do swojego magazynu.
Zalecane użycie
Możesz nadal używać usługi Data Factory do konwertowania schematu (DDL). Korzystając z Asystenta Kopiowania danych, możesz wybrać konkretną tabelę lub Wszystkie tabele. Z założenia ta metoda migruje schemat w jednym kroku, wyodrębniając go bez żadnych wierszy przy użyciu warunku fałszywego, TOP 0, w instrukcji zapytania.
Poniższy przykładowy kod obejmuje migrację schematu (DDL) z usługą Data Factory.
Przykład kodu: migracja schematu (DDL) za pomocą usługi Data Factory
Możesz użyć Fabric Pipelines do łatwej migracji DDL (schematów) dla obiektów tabel z dowolnego źródła Azure SQL Database lub dedykowanej puli SQL. Ten potok migruje schemat (DDL) dla dedykowanych tabel puli SQL źródłowej na Fabric Data Warehouse.

Projekt potoku: parametry
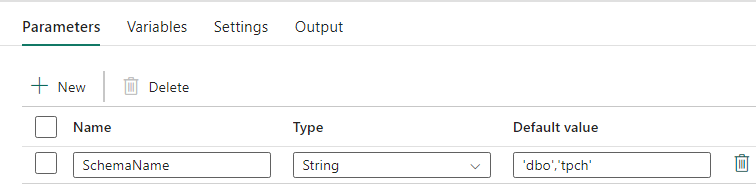
Ten potok przetwarzania przyjmuje parametr SchemaName, którego używa się do określenia, które schematy mają zostać zmigrowane. Domyślny schemat to dbo.
W polu domyślna wartość wprowadź listę schematów tabeli rozdzieloną przecinkami, wskazując, które schematy mają być migrowane: aby udostępnić dwa schematy, 'dbo','tpch'dbo i tpch.
Projektowanie potoku: aktywność wyszukiwania
Utwórz aktywność wyszukiwania i ustaw połączenie, aby wskazywało na twoją źródłową bazę danych.
Na karcie Ustawienia:
Ustaw typ magazynu danych na Zewnętrzny.
Połączenie to Twoja dedykowana pula SQL w Azure Synapse. Typ połączenia to Azure Synapse Analytics.
Użycie zapytania jest ustawione na Zapytanie.
Zbuduj pole Zapytania , używając wyrażenia dynamicznego, aby móc użyć parametru
SchemaNamew zapytaniu zwracającym listę docelowych tabel źródłowych. Wybierz Zapytanie , a następnie Dodaj dynamiczną treść.To wyrażenie w działaniu LookUp generuje instrukcję SQL w celu wykonywania zapytań względem widoków systemowych w celu pobrania listy schematów i tabel. Odwołuje się do parametru
SchemaName, umożliwiając filtrowanie schematów SQL. Wynik tego wyrażenia to tablica schematów SQL i tabel, które Aktywność ForEach wykorzystuje jako wejście.Użyj poniższego kodu, aby zwrócić listę wszystkich tabel użytkowników z nazwą schematu.
@concat('
SELECT s.name AS SchemaName,
t.name  AS TableName
FROM sys.tables AS t
INNER JOIN sys.schemas AS s
ON t.type = ''U''
AND s.schema_id = t.schema_id
AND s.name in (',coalesce(pipeline().parameters.SchemaName, 'dbo'),')
')

Projekt potoku danych: Pętla ForEach
W przypadku pętli ForEach skonfiguruj następujące opcje na karcie Ustawienia :
- Wyłącz Sequential, aby umożliwić jednoczesne uruchamianie wielu iteracji.
- Ustaw Liczba partii na
50, ograniczając maksymalną liczbę współbieżnych iteracji. - Użyj treści dynamicznej w polu Elementy , aby odwołać się do wyników aktywności LookUp. Użyj następującego fragmentu kodu:
@activity('Get List of Source Objects').output.value

Projekt potoku danych: Aktywność kopiowania wewnątrz pętli ForEach
Wewnątrz działania ForEach dodaj działanie kopiowania. Ta metoda wykorzystuje język wyrażeń dynamicznych w ramach potoków do utworzenia instrukcji SELECT TOP 0 * FROM <TABLE>, służącej do migracji samego schematu, bez danych, do hurtowni danych.
Na karcie Źródło:
- Ustaw typ magazynu danych na Zewnętrzny.
- Połączenie to Twoja dedykowana pula SQL w Azure Synapse. Typ połączenia to Azure Synapse Analytics.
- Ustaw opcję Użyj zapytania na Zapytanie.
- W polu Zapytania wklej zapytanie o zawartość dynamiczną i użyj tego wyrażenia, które zwraca zero wierszy, ale zawiera schemat tabeli:
@concat('SELECT TOP 0 * FROM ',item().SchemaName,'.',item().TableName)

Na karcie Miejsce docelowe:
- Ustaw Typ magazynu danych na Obszar roboczy.
- Ustaw typ magazynu danych obszaru roboczego na Data Warehouse i ustaw Data Warehouse jako magazyn danych.
- Schemat i nazwa tabeli docelowej są definiowane przy użyciu zawartości dynamicznej.
- Schemat odnosi się do pola aktualnej iteracji,
SchemaNamez fragmentem:@item().SchemaName - Odniesienia
TableNamedo tabeli wraz z fragmentem:@item().TableName
- Schemat odnosi się do pola aktualnej iteracji,

Projekt rurociągu: zlew
Dla Sink wskaż swój Magazyn i odnieś się do Schemy Źródłowej i nazwy Tabeli.
Gdy uruchamiasz ten pipeline, widzisz magazyn wypełniony każdą tabelą w twoim źródle, używając właściwego schematu.
Migracja z użyciem procedur przechowywanych w dedykowanej puli SQL w Synapse
Ta opcja wykorzystuje procedury przechowywane do przeprowadzenia migracji do Fabric Data Warehouse.
Przykłady kodu można pobrać w witrynie microsoft/fabric-migration on GitHub.com. Ten kod jest udostępniany jako open source, dlatego możesz współtworzyć współpracę i pomóc społeczności.
Co potrafią procedury przechowywane Fabric Migration:
- Przekonwertuj schemat (DDL) na składnię Fabric Data Warehouse.
- Stwórz schemat (DDL) na Fabric Data Warehouse.
- Wyodrębnianie danych z dedykowanej puli SQL usługi Synapse do usługi ADLS.
- Oznacz nieobsługiwaną składnię Fabric dla kodów T-SQL (procedury przechowywane, funkcje, widoki).
Zalecane użycie
Ta opcja jest dla Ciebie świetna, jeśli:
- Znasz język T-SQL.
- Chcę korzystać ze zintegrowanego środowiska programistycznego do tworzenia T-SQL.
- Chcesz mieć bardziej szczegółową kontrolę nad tym, nad którymi zadaniami pracujesz.
Można wykonać określoną procedurę składowaną dla konwersji schematu (DDL), wyodrębniania danych lub oceny kodu T-SQL.
Do migracji danych użyj COPY INTO lub Fabric Data Factory, aby wprowadzić dane do swojego magazynu.
Migrowanie przy użyciu projektów bazy danych SQL
Fabric Data Warehouse obsługuje rozszerzenie SQL Database Projects dostępne w Visual Studio Code.
To rozszerzenie jest dostępne w programie Visual Studio Code. Ta funkcja umożliwia korzystanie z funkcji kontroli źródła, testowania bazy danych i sprawdzania poprawności schematu.
Więcej informacji na temat kontroli wersji można znaleźć w przeglądzie rozwoju i wdrożenia.
Zalecane użycie
Użyj tej opcji, jeśli wolisz używać SQL Database Project do wdrożenia. Ta opcja integruje procedury przechowywane Fabric Migration z projektem bazy danych SQL, zapewniając płynne doświadczenie migracji.
Projekt usługi SQL Database może wykonywać następujące czynności:
- Przekonwertuj schemat (DDL) na składnię Fabric Data Warehouse.
- Stwórz schemat (DDL) na Fabric Data Warehouse.
- Wyodrębnianie danych z dedykowanej puli SQL usługi Synapse do usługi ADLS.
- Oznaczanie niewspieranej składni dla kodów T-SQL (procedury składowane, funkcje, widoki).
Do migracji danych użyj COPY INTO lub Data Factory, aby pobrać dane do swojego magazynu.
Zespół Microsoft Fabric CAT dostarcza skrypty PowerShell do wyodrębniania, tworzenia i wdrażania schematu (DDL) oraz kodu bazy danych (DML) za pośrednictwem projektu bazy danych SQL. Instrukcję znajdziesz w microsoft/fabric-migration w serwisie GitHub.
Aby uzyskać więcej informacji na temat projektów usługi SQL Database, zobacz Rozpoczynanie pracy z rozszerzeniem projektów usługi SQL Database i Tworzenie projektu bazy danych z wiersza polecenia.
Migracja danych za pomocą instrukcji CETAS
Polecenie T-SQL CREATE EXTERNAL TABLE AS SELECT (CETAS) zapewnia najbardziej opłacalną i optymalną metodę wyodrębnienia danych z dedykowanych pul SQL Azure Synapse do Azure Data Lake Storage (ADLS) Gen2.
Co może zrobić CETAS:
- Wyodrębnij dane do usługi ADLS.
- Ta opcja wymaga utworzenia schematu (DDL) w magazynie przed wejściem danych. Zapoznaj się z opcjami w tym artykule, aby przeprowadzić przeniesienie schematu (DDL).
Zalety tej opcji to:
- Migracja wysyła tylko jedno zapytanie na tabelę względem dedykowanej puli SQL Synapse źródłowej. To zapytanie nie wykorzystuje wszystkich slotów współbieżnego przetwarzania i nie blokuje produkcyjnych procesów ETL klienta ani jego równoległych zapytań.
- Nie musisz skalować do DWU6000, ponieważ dla każdej tabeli używany jest tylko jeden slot współbieżności, więc możesz używać mniejszych wartości DWU.
- Ekstrakt działa równolegle we wszystkich węzłach obliczeniowych, co poprawia wydajność.
Zalecane użycie
Użyj CETAS, aby wyodrębnić dane do usługi ADLS w formacie plików Parquet. Pliki Parquet zapewniają wydajne przechowywanie danych dzięki kompresji kolumnowej, która wymaga mniejszej przepustowości podczas przesyłania przez sieć. Ponieważ platforma Fabric przechowuje dane w formacie Delta Parquet, pozyskiwanie danych jest 2,5 raza szybsze w porównaniu z formatem plików tekstowych, ponieważ podczas pozyskiwania danych nie występuje narzut związany z konwersją do formatu Delta.
Aby zwiększyć przepływność CETAS:
- Dodaj równoległe operacje CETAS, zwiększając wykorzystanie slotów współbieżności, ale umożliwiając większą przepustowość.
- Skaluj DWU w dedykowanej puli SQL Synapse.
Migracja za pomocą dbt
Ta sekcja opisuje opcję dbt dla klientów, którzy już korzystają z dbt w swoim dedykowanym środowisku pulowym SQL w Synapse.
Co dbt może zrobić:
- Przekonwertuj schemat (DDL) na składnię Fabric Data Warehouse.
- Stwórz schemat (DDL) na Fabric Data Warehouse.
- Przekonwertuj kod bazy danych (DML) na składnię Fabric.
Platforma dbt generuje DDL i DML (skrypty SQL) na bieżąco z każdym wykonaniem. Dzięki użyciu plików modeli zapisanych jako instrukcje SELECT, dbt natychmiast przekłada instrukcje DDL/DML na dowolną platformę docelową po zmianie profilu (parametrów połączenia) i typu adaptera.
Zalecane użycie
Framework dbt stosuje podejście oparte na kodowaniu na pierwszym miejscu. Migruj dane, korzystając z opcji wymienionych w tym dokumencie, takich jak CETAS lub COPY/Data Factory.
Korzystając z adaptera dbt do Microsoft Fabric Data Warehouse, możesz migrować istniejące projekty dbt skierowane do różnych platform, takich jak Azure Synapse dedykowane pule SQL, Snowflake, Databricks, Google BigQuery czy Amazon Redshift, do magazynu przy prostej zmianie konfiguracji.
Aby rozpocząć pracę z projektem dbt przeznaczonym dla usługi Fabric Data Warehouse, zobacz Samouczek: Konfigurowanie dbt dla usługi Fabric Data Warehouse. W dokumencie wymieniono również opcję przemieszczania się między różnymi magazynami i platformami.
Pobieranie danych do Fabric Data Warehouse
Do pobierania danych do Fabric Data Warehouse użyj COPY INTO lub Fabric Data Factory, w zależności od preferencji. Obie metody są zalecane i najlepiej działające, ponieważ mają równoważną przepustowość wydajności, pod warunkiem wcześniejszego rozpakowania plików do Azure Data Lake Storage (ADLS) Gen2.
Zaprojektuj swój proces pod kątem maksymalnej wydajności, uwzględniając następujące czynniki:
- Dzięki Fabric nie ma konkurencji zasobów podczas ładowania wielu tabel z ADLS do Fabric Data Warehouse jednocześnie. W związku z tym podczas ładowania wątków równoległych nie występuje spadek wydajności. Maksymalna przepustowość pozyskiwania danych jest ograniczona wyłącznie mocą obliczeniową jednostki Fabric.
- Zarządzanie obciążeniem w ramach architektury zapewnia rozdzielenie zasobów przydzielonych do przetwarzania danych i wykonywania zapytań. Nie ma konkurencji o zasoby, gdy zapytania i ładowanie danych działają jednocześnie.
Powiązana zawartość
- Asystent Migracji Tkaniny dla Hurtowni Danych
- Tworzenie magazynu w usłudze Microsoft Fabric
- Wytyczne dotyczące wydajności magazynu danych fabryki
- Bezpieczeństwo w Fabric Data Warehouse
- Blog: Mapowanie dedykowanych pul SQL usługi Azure Synapse na moc obliczeniową usługi Fabric Data Warehouse
- Omówienie migracji usługi Microsoft Fabric