Observação
O acesso a essa página exige autorização. Você pode tentar entrar ou alterar diretórios.
O acesso a essa página exige autorização. Você pode tentar alterar os diretórios.
Azure NetApp Files
Microsoft Fabric
Pesquisa de IA do Azure
Fábrica da Microsoft
Azure Machine Learning
Ideias de soluções
Este artigo descreve uma ideia de solução. Seu arquiteto de nuvem pode usar essa orientação para ajudar a visualizar os principais componentes para uma implementação típica dessa arquitetura. Use este artigo como ponto de partida para projetar uma solução bem arquitetada que se alinhe aos requisitos específicos da sua carga de trabalho.
Essa ideia da solução descreve como a API REST do Azure NetApp Files Object ajuda as organizações a usar dados de arquivo corporativo existentes para análise e IA sem antes copiá-los para um repositório de objetos separado. Os aplicativos compatíveis com o Amazon S3 podem dar suporte à pesquisa de documentos e à análise assistida por IA, enquanto os fluxos de trabalho NFS e SMB existentes continuam acessando esses dados. Evitar uma cópia separada de dados de origem pode reduzir o tempo para colocar cargas de trabalho analíticas em operação, reduzir os custos de armazenamento duplicados e remover os pipelines de sincronização que as equipes criariam, monitorariam e solucionariam problemas. Ter menos repositórios de dados de origem também significa ter menos cópias para governar e proteger. Essa abordagem dá suporte à modernização incremental sem exigir que as organizações substituam seus aplicativos baseados em arquivo existentes.
Architecture
Essa arquitetura se concentra na integração do Microsoft Fabric com o Azure NetApp Files por meio da API REST de objetos. O diagrama também mostra o Azure Databricks como um consumidor alternativo para análise dos mesmos dados do Azure NetApp Files. Você não precisa implantar ambas as plataformas. Os aplicativos existentes continuam acessando os dados por meio de NFS ou SMB, dependendo da configuração do volume e dos requisitos do cliente.
A computação do Azure Databricks acessa o ponto de extremidade da API REST de objeto do Azure NetApp Files por meio de solicitações compatíveis com S3 usando o conector S3A do Hadoop. Esse caminho alternativo de análise não usa o gateway de dados on-premises nem o Microsoft OneLake.
Os serviços de IA downstream no diagrama são ilustrativos. A integração de ingestão não é mostrada.
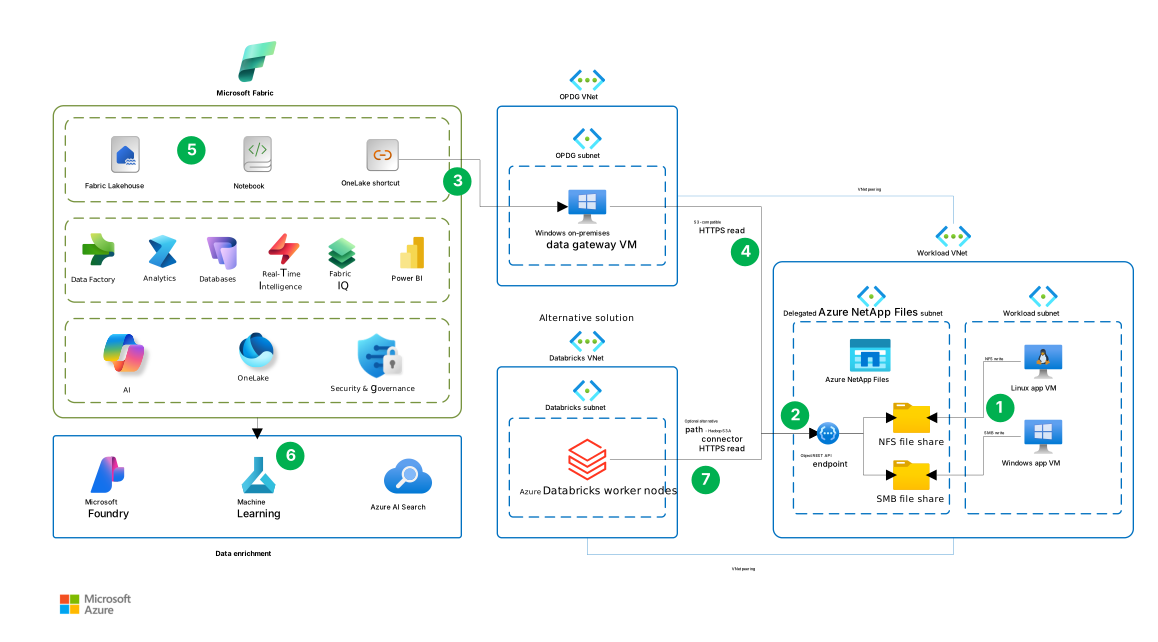
Carrege um arquivo Visio desta arquitetura.
Fluxo de dados
Estas interações numeradas a seguir descrevem o diagrama de arquitetura. As etapas 1 a 5 descrevem o caminho primário do Microsoft Fabric. A etapa 6 representa o enriquecimento opcional de dados a jusante. A etapa 7 é um caminho de análise alternativo, não uma continuação do fluxo do Fabric. As setas rotuladas HTTPS read mostram solicitações em direção ao ponto de extremidade da API REST do objeto; os dados solicitados retornam ao consumidor.
Os aplicativos gravam dados em arquivos. Na sub-rede carga de trabalho, a VM do aplicativo Linux grava no compartilhamento de arquivos NFS e a VM do aplicativo Windows grava no compartilhamento de arquivos SMB. Azure NetApp Files hospeda ambos os compartilhamentos na sub-rede delegada.
A API REST de objeto disponibiliza os dados do arquivo. O ponto de extremidade na sub-rede ANF delegada fornece acesso compatível com o S3 a diretórios configurados nos volumes do Azure NetApp Files. As conexões do ponto de extremidade para os compartilhamentos NFS e SMB representam o acesso aos dados existentes, não uma cópia em um repositório de objetos separado.
O Fabric acessa os dados usando um atalho do OneLake. O atalho faz referência aos dados do Azure NetApp Files por meio de uma conexão que usa a VM do gateway de dados local do Windows na sub-rede OPDG (gateway de dados local). O atalho do OneLake está conectado a esse gateway.
O gateway lê da API REST de Objetos. O gateway usa o emparelhamento entre a VNet OPDG e a VNet de Carga de Trabalho para chegar ao endpoint. O caminho de leitura HTTPS compatível com S3 conecta o gateway ao ponto de extremidade, que acessa os dados de arquivo referenciados para Fabric. Para obter os requisitos de conexão, consulte Conectar o OneLake a um volume de Azure NetApp Files.
Fabric processa e analisa os dados. Cargas de trabalho de Fabric com suporte consomem os dados por meio do Shortcut. Por exemplo, os notebooks leem os arquivos referenciados e gravam resultados derivados em tabelas lakehouse para análise e relatórios do Power BI. A caixa Fabric no diagrama mostra esses recursos de processamento e análise.
Serviços downstream opcionais enriquecem os dados. A seta abaixo de Fabric leva ao grupo de enriquecimento de dados, que contém Microsoft Foundry, Azure Machine Learning e Pesquisa de IA do Azure . Esta etapa representa o processamento downstream opcional. O diagrama não mostra a ingestão ou orquestração necessária para conectar esses serviços e o atalho do OneLake não estabelece essas integrações.
Como alternativa, Azure Databricks lê os dados do arquivo diretamente. Os nós de trabalho na sub-rede do Databricks usam o conector S3A do Hadoop para enviar solicitações de leitura HTTPS para o mesmo ponto de extremidade da API REST de objeto pelas redes virtuais emparelhadas. Esse caminho substitui o caminho de acesso e processamento do Fabric nas etapas de 3 a 5. Ele não passa pelo gateway de dados local nem pelo OneLake.
Escolha o local do atalho com base em como você pretende consumir os dados:
- Tabelas Delta existentes compatíveis. Crie um atalho de tabela na seção Tables do lakehouse, apontando para a tabela Delta completa, incluindo seu log de transações. Fabric reconhece o destino como uma tabela que você pode consultar por meio do Spark e do endpoint de análise SQL, enquanto os dados de origem permanecem no Azure NetApp Files.
- Arquivos para acesso direto ou processamento. Crie atalhos na seção Arquivos do lakehouse. Cargas de trabalho compatíveis podem ler arquivos Parquet, CSV e JSON autônomos, além de documentos, sem primeiro copiar os arquivos de origem para o OneLake. Quando a análise downstream exigir tabelas lakehouse, transforme ou carregue os dados de origem em tabelas Delta derivadas no OneLake.
Os arquivos Parquet autônomos não são automaticamente tabelas Delta. Um atalho em Files não registra automaticamente seu destino como uma tabela. Para obter mais informações, consulte Onde colocar atalhos em um lakehouse.
Components
Os componentes a seguir dão suporte à arquitetura centrada no Fabric e à alternativa opcional do Azure Databricks.
Azure NetApp Files é um serviço de armazenamento de arquivos, totalmente gerenciado, baseado na tecnologia NetApp. Nessa arquitetura, armazena o conjunto de dados corporativos e fornece acesso via NFS e SMB, além de acesso a objetos compatível com S3 por meio da API REST de objetos. Também oferece recursos de snapshot e replicação.
Azure NetApp Files API REST de Objeto expõe dados de arquivo existentes por meio de uma interface compatível com S3. Nessa arquitetura, permite que aplicativos de análise e IA compatíveis acessem os dados sem primeiro criar uma cópia separada em armazenamento de objetos. A interface oferece suporte a um subconjunto de operações do Amazon S3. Confirme se as operações com suporte atendem aos requisitos do aplicativo antes de escolher essa integração.
Microsoft Fabric é uma plataforma analítica que unifica a movimentação de dados, o processamento de dados, a ingestão, a transformação, o processamento de streaming por meio do Real-Time Intelligence e a criação de relatórios. Nessa arquitetura, ela fornece a plataforma de análise para processar e analisar dados de Azure NetApp Files por meio de atalhos do OneLake.
OneLake é o data lake lógico unificado para Fabric. Nessa arquitetura, os atalhos do OneLake disponibilizam os dados de Azure NetApp Files referenciados para cargas de trabalho de Fabric com suporte.
Rede Virtual do Azure fornece conectividade privada entre os recursos do Azure nessa arquitetura. O emparelhamento de rede virtual permite que a máquina virtual de gateway e o recurso de computação opcional do Azure Databricks acessem o ponto de extremidade da API REST de Objetos do Azure NetApp Files.
Um gateway de dados local conecta atalhos do OneLake ao ponto de extremidade do bucket Azure NetApp Files. Apesar do nome, nessa arquitetura, o gateway é executado no modo padrão em uma máquina virtual do Azure com um sistema operacional Windows compatível. Escolha uma imagem que atenda aos requisitos de instalação do gateway. As instalações do Server Core e os contêineres do Windows não têm suporte. O gateway inicia conexões de saída por meio de Retransmissão do Azure para se comunicar com Fabric. Não são necessárias conexões de entrada de Fabric. Configure o firewall ou proxy para permitir os endpoints de saída descritos em Ajuste as configurações de comunicação para o gateway de dados local.
Azure Databricks é uma plataforma analítica opcional e alternativa para cargas de trabalho de engenharia de dados e aprendizado de máquina. Seus trabalhos do Spark usam o conector S3A do Hadoop configurado para o endpoint da API REST de Objetos para acessar o conjunto de dados do Azure NetApp Files, em vez de usar o caminho de integração do Fabric.
Alternatives
Essa arquitetura inclui vários componentes que você pode substituir por outros serviços ou abordagens do Azure, dependendo dos requisitos funcionais e não funcionais da carga de trabalho. Considere as alternativas a seguir e suas compensações.
Armazenamento
Considere os requisitos de protocolo dos aplicativos e o desempenho medido quando você escolhe entre Armazenamento de Blobs do Azure e Azure NetApp Files:
Escolha Armazenamento de Blobs quando os clientes puderem usar a API REST do Armazenamento de Blobs ou NFS 3.0 e não exigirem SMB ou NFS 4.1. Ambas as interfaces podem acessar os mesmos dados. O caminho de acesso NFS 3.0 do Armazenamento de Blobs é otimizado para cargas de trabalho sequenciais com predominância de leitura e alta taxa de transferência, em que a taxa de transferência é mais importante do que a baixa latência.
Escolha Azure NetApp Files quando os aplicativos e cargas de trabalho de análise precisarem acessar os mesmos arquivos por meio do SMB ou NFS 4.1 e da API REST de Objeto compatível com S3, ou quando os aplicativos de arquivo exigirem E/S aleatória de baixa latência. Para dados já no Azure NetApp Files, a API REST de Objeto adiciona acesso à análise sem migrar aplicativos de origem ou dados de origem.
Em qualquer uma das opções, meça a latência de ponta a ponta e a vazão sob carga simultânea do aplicativo de origem e da análise. O desempenho de NFS ou SMB não representa o desempenho da Object REST API nem do Fabric; portanto, teste o caminho de acesso pretendido em relação aos requisitos da carga de trabalho. Compare os custos totais, incluindo alterações no aplicativo, migração e qualquer duplicação e sincronização em andamento. Para obter uma comparação entre protocolos e cargas de trabalho, consulte Comparar os serviços de armazenamento do Azure.
Integration
Os trabalhos do Azure Databricks podem usar o conector do Hadoop S3A para ler dados do Azure NetApp Files por meio da API REST de Objeto, sem o OneLake ou o gateway de dados local. Configure a confiança em TLS e as credenciais armazenadas de forma segura, e valide as operações de escrita necessárias antes de depender da gravação de retorno. Se você precisar de scripts de inicialização, use scripts no escopo do cluster armazenados em volumes do Unity Catalog em recursos de computação compatíveis, seguindo a orientação atual sobre scripts de inicialização do Azure Databricks.
Detalhes do cenário
Use esse padrão quando o mesmo conjunto de dados deve atender a aplicativos que esperam um sistema de arquivos montado e serviços de análise ou IA que esperam uma interface de objeto compatível com S3.
Aplicações em execução em máquinas virtuais ou em contêineres podem continuar a usar o Azure NetApp Files via NFS ou SMB. Por exemplo, eles podem usar código de acesso a arquivos, compartilhamentos montados e estruturas de diretório existentes. A API REST do objeto Azure NetApp Files mapeia o diretório raiz de um volume ou um subdiretório para um bucket compatível com S3 para que os clientes de objeto compatíveis possam acessar os mesmos arquivos subjacentes.
Essa abordagem é útil quando você deseja adicionar recursos de análise ou IA a cargas de trabalho baseadas em arquivo existentes sem alterar os aplicativos de origem para usar o armazenamento de objetos. Fluxos de trabalho downstream ainda podem criar dados derivados, como conjuntos de dados transformados, índices, embeddings e caches, conforme necessário.
Quando os clientes de arquivos e de objetos acessarem os mesmos dados, leve em conta as diferenças de identidade, permissões, bloqueio e requisitos de consistência da aplicação. Defina como os produtores sinalizam que um arquivo ou lote está concluído antes que os consumidores de objetos o processem. Os produtores devem terminar de gravar os dados e fechar arquivos antes de sinalizar que estão prontos e deixar esses arquivos inalterados enquanto os consumidores os processam. Teste esta transferência quanto a gravações interrompidas e tentativas de reprocessamento.
Os modelos de identidade e autorização também diferem entre os métodos de acesso. As permissões originais de arquivo por usuário não são automaticamente transferidas para o Fabric. Configure as permissões do Fabric para os consumidores previstos e verifique se a identidade usada pela API REST do Object tem acesso somente aos dados de origem necessários. Para obter mais informações, consulte Segurança.
Mapear diretórios para buckets separados quando os consumidores exigirem níveis diferentes de acesso. Classificação de dados, retenção, autorização posterior e governança de dados derivados continuam sendo responsabilidades da carga de trabalho. Para obter mais informações, consulte Criar um bucket.
Possíveis casos de uso
Essa arquitetura pode dar suporte a cargas de trabalho que precisam analisar dados estruturados ou não estruturados já armazenados no Azure NetApp Files. Os exemplos a seguir ilustram diferentes maneiras que Fabric pode consumir esses dados.
Processamento de documentos
Os aplicativos podem salvar documentos, imagens ou outros arquivos não estruturados no Azure NetApp Files usando NFS ou SMB. Um notebook do Fabric pode ler arquivos concluídos usando um atalho do OneLake e enviar seu conteúdo para um serviço de processamento de documentos, como a Inteligência de Documentos do Azure, para extração. Armazene os dados estruturados resultantes em tabelas lakehouse para validação, análise e relatório.
Para obter orientações de integração, consulte integração do Document Intelligence via SynapseML.
Análise de dados
Os aplicativos podem gravar dados estruturados, como arquivos CSV ou Parquet, em um compartilhamento do Azure NetApp Files. Os notebooks do Fabric podem ler arquivos finalizados usando o atalho do OneLake, combiná-los com outros dados do lakehouse e gravar resultados derivados em tabelas do lakehouse.
Esse padrão pode oferecer suporte a cenários como engenharia e análise de qualidade, análise de dados de sensores e relatórios operacionais, sem exigir que os aplicativos de origem mudem a forma como armazenam seus arquivos.
Para conjuntos de dados Delta compatíveis existentes, crie um atalho onelake na seção Tabelas do lakehouse que tem como destino a tabela Delta completa, incluindo seu log de transações. O Fabric pode então identificar o destino como uma tabela, e os dados de origem podem permanecer no Azure NetApp Files. Para obter mais informações, consulte Onde colocar atalhos em um lakehouse.
Pesquisa e recuperação por IA
Documentos armazenados em Azure NetApp Files também podem servir como conteúdo de origem para cargas de trabalho de IA. Por exemplo, um fluxo de trabalho de processamento pode ler documentos por meio do atalho do OneLake e usá-los para criar um índice Pesquisa de IA do Azure para RAG (geração aumentada por recuperação).
O índice de pesquisa e quaisquer embeddings são dados derivados e são armazenados separadamente dos arquivos de origem. Projete o fluxo de trabalho para manter o conteúdo indexado sincronizado com atualizações de origem, renomeações e exclusões. Além disso, imponha os controles de acesso apropriados ao recuperar conteúdo indexado porque as permissões SMB e NFS originais não se tornam automaticamente permissões de busca por usuário.
O mesmo padrão pode ser estendido para outras cargas de trabalho de IA. Por exemplo, Fabric notebooks podem preparar conjuntos de dados de arquivos de origem e armazenar os dados preparados no OneLake para consumo pelo Azure Machine Learning. Para obter opções e limitações de integração, consulte Integração do OneLake com o Azure Machine Learning.
Considerations
Essas considerações implementam os pilares do Azure Well-Architected Framework, que é um conjunto de princípios orientadores que você pode usar para melhorar a qualidade de uma carga de trabalho. Para obter mais informações, consulte Well-Architected Framework. Para obter mais diretrizes, consulte as recomendações do Well-Architected Framework para Azure NetApp Files.
Reliability
A confiabilidade ajuda a garantir que seu aplicativo possa cumprir os compromissos que você faz aos seus clientes. Para obter mais informações, consulte Lista de verificação da revisão de projeto para Confiabilidade.
Azure NetApp Files é executado em uma frota bare-metal tolerante a falhas alimentada pelo ONTAP e fornece um SLA de alta disponibilidade. Para proteção adicional contra interrupções em zonas de disponibilidade ou regionais, você pode opcionalmente configurar a replicação entre zonas ou entre regiões. Essa replicação é assíncrona e requer failover iniciado pelo cliente para o volume de destino. Escolha a opção de replicação e agende de acordo com os objetivos de recuperação da carga de trabalho. Para obter mais informações, consulte confiabilidade do Azure NetApp Files.
O compartilhamento de um conjunto de dados também torna a disponibilidade de armazenamento uma dependência comum para aplicativos de arquivos e análise. Esses recursos de armazenamento não estabelecem disponibilidade de ponta a ponta para o gateway, o pipeline de indexação ou os aplicativos consumidores. Alinhe os objetivos de recuperação com a carga de trabalho completa, incluindo o gateway, o processamento downstream e os dados derivados.
Uma única máquina virtual de gateway é um único ponto de falha para o caminho de integração do Fabric. Para cargas de trabalho comercialmente críticas, implante pelo menos dois membros de gateway em máquinas virtuais separadas em um cluster de gateway. Verifique se cada membro consegue acessar o endpoint da API REST de objetos e estabelecer as conexões de saída necessárias. Teste o comportamento da carga de trabalho quando um membro do gateway fica indisponível.
- Há suporte para recuperação de arquivo e volume por meio de instantâneos pontuais e eficientes em espaço. O Teams pode restaurar um arquivo individual, reverter um volume completo ou criar um novo volume de um ponto de recuperação após exclusão acidental, corrupção ou um processo de análise com falha. Para as operações de recuperação disponíveis, consulte proteção de dados baseada em instantâneos do Azure NetApp Files.
Segurança
A segurança fornece garantias contra ataques deliberados e o uso indevido de seus valiosos dados e sistemas. Para obter mais informações, consulte Lista de verificação para revisão de design de segurança.
Manter menos cópias de dados de origem pode reduzir o número de repositórios a serem protegidos. Azure NetApp Files criptografa dados em repouso e a API REST de Objeto usa TLS para proteger dados em trânsito. As permissões de acesso ao arquivo dependem do protocolo:
Os clientes SMB e NFS continuam a usar seus modelos de autenticação e autorização existentes. As ACLs (listas de controle de acesso) do NTFS existentes, as permissões NFS e as regras de mapeamento de identidade permanecem em vigor para esses clientes.
Os clientes da API REST do objeto são autenticados usando uma chave de acesso S3. As permissões de bucket definem se o cliente tem acesso somente leitura ou leitura/gravação no diretório mapeado. As solicitações de objeto não incluem a identidade do usuário individual de SMB, NFS ou downstream. O Azure NetApp Files executa cada operação em objetos usando a identidade de sistema de arquivos personificada configurada no bucket. As permissões de arquivo existentes e as ACLs são avaliadas apenas com base nessa identidade.
A identidade de sistema de arquivos usada para personificação é um ID de usuário (UID) e um ID de grupo (GID) para volumes NFS, ou uma conta de usuário para volumes SMB. Os volumes de protocolo duplo usam o tipo de identidade que corresponde ao estilo de segurança configurado. Essa identidade determina as permissões de acesso ao arquivo. A chave de acesso S3 autentica o cliente de objeto. Para obter mais informações, consulte a segurança e as permissões da API REST do objeto.
Um atalho compatível com o OneLake S3 se autentica no bucket usando uma ID de chave de acesso e uma chave de acesso secreta. As ACLs NTFS de origem, as permissões NFS e as identidades dos proprietários individuais dos arquivos não são copiadas nem mapeadas no OneLake. Os usuários do Fabric são autorizados por meio do OneLake e das permissões do Fabric. Eles podem acessar apenas o conteúdo exposto ao atalho por meio do bucket e sua identidade representada, mas o OneLake não impõe as permissões originais de arquivo por usuário. Não há suporte para OAuth baseado em Microsoft Entra, principais de serviço e RoleArn para esse tipo de atalho.
Por exemplo, um usuário do Fabric pode ser capaz de ler um documento usando o atalho mesmo quando sua conta SMB pessoal não puder lê-lo diretamente, se as permissões do Fabric permitirem o acesso e a identidade representada do bucket puder ler o documento. Antes de expor um diretório, verifique se o público-alvo Fabric pretendido está autorizado a acessar seu conteúdo.
Configure a identidade representada do bucket com apenas as permissões de origem necessárias para a carga de trabalho. Restrinja o acesso ao atalho e ao lakehouse. Use o fluxo de trabalho de certificado baseado em Azure Key Vault e o armazenamento de credenciais para gerenciar certificados TLS e chaves de acesso S3. Defina e teste um procedimento de rotação que coordena as alterações de certificado e credencial com atualizações das conexões do Fabric e de outros consumidores. A geração de novas credenciais de bucket invalida imediatamente o par existente, portanto, planeje a interrupção enquanto atualiza os consumidores e verifique o acesso após a rotação.
Se você usar um certificado TLS autoassinado, verifique se cada host de gateway confia nele. Para obter mais informações, consulte Pré-requisitos do gateway do OneLake.
A segurança e a conformidade dependem da configuração do armazenamento, do acesso e dos serviços downstream. Inclua o processamento downstream e os dados derivados em seu escopo de governança e conformidade. Requisitos como GDPR e HIPAA se aplicam a todo o ambiente, quando se aplicarem. Para obter mais informações, consulte Segurança e permissões da API REST de objetos e Criar um atalho compatível com Amazon S3 no OneLake.
Otimização de custos
A Otimização de Custos concentra-se em maneiras de reduzir despesas desnecessárias e melhorar a eficiência operacional. Para obter mais informações, consulte a Lista de verificação para revisão de design para Otimização de Custos.
Evitar uma cópia separada dos dados de origem pode reduzir os custos com armazenamento duplicado e sincronização. Compare essas economias com os custos de capacidade e desempenho do Azure NetApp Files, a computação de gateway, a capacidade do Fabric e o processamento e armazenamento subsequentes.
Esta estimativa de preço de exemplo inclui um pool de capacidade Standard do Azure NetApp Files de 1 TiB, uma máquina virtual Windows D8s_v5 para o gateway de dados local, dois discos gerenciados P10 de 128 GiB, um gateway NAT com um endereço IP público e processamento de dados de saída, capacidade F2 do Fabric e 100 GB de armazenamento nativo do OneLake.
A configuração de gateway único não tem alta disponibilidade. A Pesquisa de IA opcional, os serviços de embeddings e os custos do Azure Databricks são excluídos. Ajuste os recursos para atender aos requisitos de capacidade, conectividade de rede e disponibilidade da sua carga de trabalho.
Acesso frio: Mova blocos de dados inativos, incluindo dados de snapshot, para um armazenamento de menor custo, mantendo o acesso a arquivos e objetos. Avalie os encargos de recuperação, a latência e as alterações de taxa de transferência específicas do nível de serviço em relação ao padrão de acesso da carga de trabalho.
Níveis de serviço e dimensionamento adequado: Escolha um nível de serviço Azure NetApp Files que corresponda aos requisitos de capacidade e taxa de transferência do conjunto de dados. O nível de serviço Flexible permite provisionar a capacidade e a taxa de transferência do pool de forma independente. Analise a capacidade faturável do pool e a taxa de transferência conforme a demanda muda para evitar o superprovisionamento persistente.
Excelência operacional
A Excelência Operacional abrange os processos de operações que implantam um aplicativo e o mantêm em execução em produção. Para obter mais informações, consulte Lista de verificação da revisão de projeto para Excelência Operacional.
Os atalhos do OneLake reduzem a complexidade operacional evitando um pipeline que mantém uma cópia de dados de origem separada para análise. Sem um pipeline de cópia separado, as equipes não precisam agendar trabalhos de cópia, recuperar-se de falhas de transferência ou reconciliar dados de origem e copiados como parte das operações de rotina.
As equipes da aplicação de origem e de análise devem coordenar alterações e resposta a incidentes para o conjunto de dados compartilhado do Azure NetApp Files. Defina a responsabilidade pelo monitoramento, pelo tratamento de falhas de processamento e pelo gerenciamento de credenciais e certificados da API REST de objetos.
Monitore o desempenho de armazenamento, gateway e Fabric para identificar restrições e ajustar a capacidade ou a taxa de transferência:
Use o Azure Monitor para acompanhar a taxa de transferência de leitura e gravação de volume, IOPS de leitura e gravação, outros IOPS, latência média de leitura e gravação, consumo de capacidade e o indicador de limite de taxa de transferência atingido. Alerta sobre aumentos de latência sustentados, limitação de QoS repetida e limites de capacidade em vez de picos isolados; as métricas do Azure NetApp Files são agregadas em intervalos e a latência de armazenamento não inclui todos os componentes REST do lado do cliente.
Correlacionar métricas de armazenamento com medidas do lado do cliente, como percentis de latência de solicitação, tamanho do objeto, simultaneidade, repetições, códigos de status HTTP, CPU, memória e taxa de transferência de rede. Isso distingue um limite de throughput do volume de um cliente de computação subdimensionado, configurações ineficientes do SDK, sobrecarga de objeto pequeno ou distância de rede.
Monitore a CPU, a memória, o espaço em disco disponível e a taxa de transferência de rede de cada máquina virtual de gateway, juntamente com erros de gateway e tempos de conclusão das cargas de trabalho. Configure alertas para pressão sustentada sobre os recursos e pouco espaço em disco, usando limiares estabelecidos durante testes com cargas de trabalho representativas. Use logs de diagnóstico do gateway ao solucionar erros ou lentidão no acesso. Monitore a máquina virtual e a rede separadamente porque o diagnóstico de gateway não fornece cobertura completa de infraestrutura.
Monitore a utilização da capacidade do Fabric e a limitação de taxa com o aplicativo Fabric Capacity Metrics. Configure notificações de utilização de capacidade para os administradores responsáveis. Correlacione o uso da capacidade com as métricas do gateway e de armazenamento para determinar se os atrasos se originam no acesso à fonte ou no processamento no Fabric antes de alterar a capacidade.
Eficiência de desempenho
A Eficiência de Desempenho refere-se à capacidade da carga de trabalho de dimensionar para atender às demandas do usuário com eficiência. Para obter mais informações, consulte a Lista de Verificação de Design para Eficiência de Desempenho.
Azure NetApp Files podem dar suporte a aplicativos NFS ou SMB sensíveis à latência e a análises compatíveis com S3 ou consumidores de IA usando o mesmo conjunto de dados. Manter os dados de origem em um volume pode remover o estágio de cópia que, de outra forma, atrasaria a indexação, o treinamento ou o processamento em lote e consumiria largura de banda de cliente, rede e armazenamento de destino.
A latência de armazenamento abaixo de um milissegundo nos níveis de serviço compatíveis do Azure NetApp Files é mais diretamente relevante para cargas de trabalho de NFS e SMB. Não garante a latência de ponta a ponta para solicitações à API REST de objetos via HTTPS. Faça o benchmark do caminho de acesso compatível com S3 com objetos representativos e concorrência antes de definir um objetivo de latência.
Dimensionamento de armazenamento: Dimensione a taxa de transferência para a demanda combinada de aplicativos de arquivo e consumidores de objetos. O QoS automático vincula a taxa de transferência de volume à cota de volume. QoS manual permite alocação separada dentro do orçamento de taxa de transferência do pool. Execute benchmarks de cargas de trabalho representativas antes de ajustar o desempenho.
Dimensionamento de gateway: Dimensione as máquinas virtuais de gateway para a demanda combinada de cargas de trabalho que acessam o Azure NetApp Files por meio de atalhos do OneLake. Use as diretrizes de dimensionamento e escalabilidade do gateway como ponto de partida. Valide o dimensionamento com volumes de dados representativos e acesso simultâneo pelos atalhos. Medir a taxa de transferência de CPU, memória e rede do gateway juntamente com os tempos de conclusão da carga de trabalho para determinar se deve aumentar os recursos da máquina virtual ou adicionar membros do gateway.
Dimensionamento da capacidade do Fabric: Dimensione a capacidade do Fabric para a carga de trabalho combinada de processamento e relatórios, incluindo o Power BI. Siga as diretrizes no guia de planejamento de capacidade do Fabric para estimar a capacidade inicial, testar com um piloto representativo e ajustar a capacidade com base na utilização e limitação medidas.
Coloque a computação perto do volume de armazenamento, dimensione a rede do cliente adequadamente e teste com a carga de trabalho real. Aumente o paralelismo e use solicitações adequadamente grandes para análise sequencial, mas limite a concorrência quando a latência ou erros aumentarem. Para NFS ou SMB, valide a montagem, o protocolo e as configurações do aplicativo. Para REST, verifique o suporte para as operações de API necessárias do cliente e teste a reutilização da conexão, o comportamento de upload, as repetições e a listagem de objetos.
Valide a taxa de transferência e a latência de ponta a ponta sob carga concorrente, e equilibre a demanda por análises com os requisitos de desempenho da aplicação de origem.
Contributors
A Microsoft mantém este artigo. Os colaboradores a seguir escreveram este artigo.
Autores principais:
- Dan Jackson | Arquiteto de Soluções de Nuvem, NetApp
- Anthony Mashford | Arquiteto de Soluções de Nuvem, NetApp
- Daniel Söderholm | Engenheiro sênior de soluções, plataformas de nuvem + IA, Microsoft
Outros colaboradores:
- Heather Grandy | Engenheira sênior de soluções, plataformas de dados, Microsoft
Para ver perfis de LinkedIn não públicos, entre em LinkedIn.
Próximas Etapas
- Introdução à API REST de objeto para Azure NetApp Files
- Conectar o OneLake a um volume de Azure NetApp Files
- Scripts de inicialização no Azure Databricks
- Integrar o OneLake ao Azure Machine Learning