Nota
O acesso a esta página requer autorização. Pode tentar iniciar sessão ou alterar os diretórios.
O acesso a esta página requer autorização. Pode tentar alterar os diretórios.
Importante
Este recurso está em versão Beta.
A memória do agente dá aos seus agentes memória de longo prazo que persiste através das conversas. O Azure Databricks armazena a memória no Lakebase e gere o armazenamento, indexação e pesquisa por si, para que os seus agentes possam memorizar as preferências dos utilizadores, decisões passadas e contexto acumulado sem que tenha de operar uma base de dados.
Note
Durante a versão de pré-visualização, ser-lhe-á cobrada a instância subjacente de Lakebase que armazena os seus registos de memória. Não se aplicam custos adicionais pela memória do agente em si. Os preços podem variar à medida que a pré-visualização avança.
Use a memória dos agentes quando quiser que os seus agentes façam o seguinte:
- Lembre-se das preferências, factos e decisões dos utilizadores em conversas separadas.
- Personalize as respostas com base no que o agente aprendeu em sessões anteriores.
- Partilhe o conhecimento acumulado entre agentes e projetos.
- Melhorar a precisão e eficiência ao longo do tempo.
A memória de agentes funciona com agentes construídos em qualquer framework. Para um histórico de conversas de curto prazo dentro de uma única interação, use sessões do agente.
Requerimentos
- Instale Python 3.10 ou superior para usar o AgentKit SDK. O SDK AgentKit é o cliente Python do Databricks para APIs de agentes, que os exemplos abaixo utilizam. Também podes chamar a API REST diretamente de qualquer linguagem, sem necessidade de Python.
- Para usar
memory_store.put()oumemory_store.list(path=...), instaledatabricks-agentbricksversão 0.6.0 ou superior.
Como funciona a memória do agente
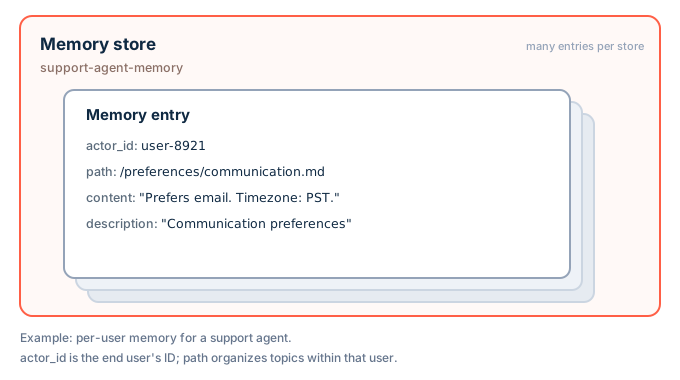
A memória do agente tem dois níveis:
- Um repositório de memória é o contentor associado ao espaço de trabalho das memórias de um agente. Criar um armazenamento provisiona automaticamente o armazenamento Lakebase de suporte. Refere-se a uma loja pelo respetivo ID de loja, que escolhe ao criar a loja.
- Uma entrada de memória é um conteúdo individual numa loja. Cada entrada tem um texto livre
content, uma brevedescriptionutilizada para recuperação e um conjunto de campos que a organizam e particionam:-
actor_id(obrigatório): a quem pertence a memória, como um utilizador final ou outro agente. -
session_id(opcional): a sessão a que o conteúdo de memória pertence. Deixe-o sem definir para memória que se aplique ao longo das sessões do ator. -
path(obrigatório): um caminho semelhante a um sistema de ficheiros que organiza entradas dentro de um ator, como/preferences/response-style.md.
-
Uma entrada é identificada de forma única pela combinação de actor_id, session_id, e path. O mesmo caminho sob duas sessões diferentes, ou sob uma sessão e sem uma, contém duas entradas separadas.
Os registos chegam a um armazenamento de duas formas: o seu agente ou aplicação escreve-os diretamente, ou um pipeline de memória destila-os das conversas num armazenamento de sessões.
Recuperação
Recuperar memória de duas formas:
-
Listar entradas para um ator, opcionalmente filtradas por
session_id, umpathprefixo, ou um exatopath. Use isto para navegar ou renderizar um índice do que um agente sabe. - Pesquise entradas de um ator utilizando uma consulta em linguagem natural. A pesquisa devolve as entradas mais relevantes, classificadas por pontuação de relevância.
Um session_id filtro em qualquer uma das operações devolve apenas as entradas guardadas nessa sessão. Não devolve registos guardados sem uma sessão.
Introdução
Os exemplos do SDK AgentKit e da API REST configuram memória de agente para um agente de suporte: criam um armazenamento de memória, guardam a preferência do utilizador e recuperam-na numa conversa posterior. O exemplo da CLI Agent Bricks liga um armazenamento de memória a um agente que se constrói e implementa com a CLI. Escolha o cliente que se encaixe no seu projeto. Um ID de armazenamento de memória deve ter entre 3 e 56 caracteres, começar com uma letra minúscula, terminar com uma letra ou número, e conter apenas letras minúsculas, números e hífens.
AgentKit SDK
O SDK AgentKit é o cliente Python do Databricks para APIs de agentes, distribuído no databricks-agentbricks pacote. Autentica-se com o WorkspaceClient SDK da Databricks.
Instale o SDK AgentKit:
pip install databricks-agentbricksCrie um armazenamento de memórias para o seu agente.
AgentKitClientAutentica-se com as tuasWorkspaceClientcredenciais:from databricks.sdk import WorkspaceClient from databricks_agentkit import AgentKitClient client = AgentKitClient(WorkspaceClient()) memory_store = client.memory_stores.create("support-agent-memory")Guarde uma memória depois de o agente aprender algo duradouro sobre um utilizador.
actor_idindica de quem é esta memória,pathorganiza-a nesse ator edescriptionmelhora a sua recuperação:memory_store.add( actor_id="user-123", path="/preferences/communication.md", content="Prefers email over phone. Timezone: PST. Enterprise subscription.", description="User 123 communication preferences", )add()falha comALREADY_EXISTSse já existir uma entrada nesse caminho. Para criar a entrada ou atualizar a existente, chamememory_store.put()com os mesmos argumentos.Recorde as memórias do utilizador numa conversa posterior com uma pesquisa em língua natural:
results = memory_store.search(actor_id="user-123", query="communication preferences", limit=10)
API REST
Os clientes invocam a API REST em /api/2.0/agents/memory-stores. Chame-o diretamente em linguagens diferentes de Python.
Gerar um token de OAuth com a CLI do Databricks:
databricks auth login --host ${DATABRICKS_HOST}
export DATABRICKS_TOKEN=$(databricks auth token | jq -r .access_token)
Crie um armazenamento de memórias para o seu agente:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores?managed_memory_store_id=support-agent-memory" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"description": "Support agent memory"}'
Guardar uma entrada de memória para um utilizador.
actor_idé de quem é esta memória,pathorganiza-a edescriptionmelhora a recuperação:curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \ -d '{"actor_id": "user-123", "path": "/preferences/communication.md", "content": "Prefers email over phone.", "description": "Communication preferences"}'Se já existir uma entrada nesse caminho, o pedido falha com
ALREADY_EXISTS(HTTP 409). Para atualizar a entrada existente, procure-a por caminho. A consulta devolve as entradas do caminho para cada sessão, por isso escolhe aquela em quesession_idcorresponde. O último segmento do seunameé o ID de entrada:curl -G "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" \ --data-urlencode "actor_id=user-123" --data-urlencode "path=/preferences/communication.md"Depois atualiza o conteúdo da entrada pelo seu ID:
curl -X PATCH "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries/<entry-id>?update_mask=content" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"content": "Prefers email over phone. Timezone: PST."}'
Recorde as memórias do utilizador com uma pesquisa em linguagem natural:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries:search" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"actor_id": "user-123", "query": "communication preferences"}'
Agente Bricks
Se construir o seu agente com a CLI do Agent Bricks, agentbricks init declare um armazenamento de memória em agent.toml.
agentbricks deploy Cria a loja se esta ainda não existir e concede ao agente implementado acesso à loja.
Escolha um caminho:
Início vazio (a maioria dos agentes): Implemente o agente.
agentbricks deploycria o armazenamento de memória queagentbricks initdeclarou. Para implementar um agente chamadomy-agent, execute o seguinte:agentbricks deploy my-agentComece com memórias já existentes no store: crie primeiro o store, adicione entradas, depois associe o store ao agente e publique.
Para criar uma loja chamada
my-agent-memory, execute o seguinte. A saída inclui o ID da loja, um identificador gerado que é separado do nome da loja:agentbricks memory stores create --name my-agent-memoryPara adicionar uma entrada, execute o seguinte, substituindo
<store-id>pelo ID da loja do passo anterior:agentbricks memory entries create --store <store-id> --actor-id you@example.com \ --path /preferences/style.md --content "Prefers Python and concise answers with code examples."Para vincular a store e instalar o agente, execute o seguinte.
agentbricks memory bindsubstitui o nome da loja emagent.toml, eagentbricks deployencontra a loja existente pelo nome e usa-a em vez de criar uma nova:agentbricks memory bind my-agent-memory agentbricks deploy my-agent
--path é a chave da entrada dentro do armazenamento, não um ficheiro na sua máquina.
--actor-id é o utilizador a quem a memória pertence. Um agente implementado usa o email do utilizador com sessão iniciada como ID do ator, por isso preenche cada entrada com o email do utilizador que conversa com o agente.
No Agent Bricks CLI, memory bind e agentbricks deploy referem-se a uma loja pelo seu nome. Comandos que atuam sobre uma única store, como memory entries create, recebem o ID gerado da store.
Dê ao seu agente ferramentas de memória
Para permitir que um agente decida quando guardar e recuperar memória, encapsule as operações do cliente como ferramentas e instrua o agente sobre quando deve usá-las no prompt de sistema. Defina o actor_id no código de aplicação fidedigno a partir da identidade verificada do utilizador final. Nunca deixes que o modelo escolha de que memória deve ler ou em que memória deve escrever.
O exemplo seguinte encapsula o SDK AgentKit memory_store de Get started como ferramentas para o SDK de Agentes da OpenAI.
from agents import Agent, function_tool

def make_memory_tools(memory_store, actor_id: str):
    @function_tool
    def search_memory(query: str) -> str:
        """Search long-term memory for relevant facts about the user."""
        results = memory_store.search(actor_id=actor_id, query=query, limit=10)
        return "\n\n".join(f"{r.memory.path}: {r.memory.content}" for r in results) or "No memory found."

    @function_tool
    def save_memory(path: str, content: str, description: str = "") -> str:
        """Save a durable, long-term memory about the user, replacing any memory at the same path."""
        memory_store.put(actor_id=actor_id, path=path, content=content, description=description or None)
        return f"Saved memory at {path}"

    @function_tool
    def list_memories() -> str:
        """List the paths and descriptions of the user's long-term memories."""
        memories = memory_store.list(actor_id=actor_id)
        return "\n".join(f"{m.path}: {m.description}" if m.description else m.path for m in memories) or "No memory found."

    @function_tool
    def forget_memory(path: str) -> str:
        """Delete the long-term memory at a path, such as when the user asks you to forget it."""
        memories = list(memory_store.list(actor_id=actor_id, path=path))
        for memory in memories:
            memory.delete()
        return f"Forgot memory at {path}" if memories else f"No memory at {path}"

    return [search_memory, save_memory, list_memories, forget_memory]

agent = Agent(
    name="Support agent",
    instructions="Save durable user preferences, recall them when relevant, and forget them when the user asks.",
    tools=make_memory_tools(memory_store, actor_id="user-123"),
)
put() cria a entrada, ou substitui o conteúdo da entrada que já está nesse caminho especificado. Para adicionar o conteúdo como novas linhas, passe append=True.
put() não é atómica, por isso escritas concorrentes no mesmo caminho podem sobrescrever-se umas às outras.
list(path=...) retorna as entradas exatamente nesse caminho em cada sessão, por isso forget_memory também apaga qualquer entrada guardada no caminho sob uma sessão.
O mesmo padrão funciona com o Claude Agent SDK e outros frameworks: encapsular as operações de pesquisa, put, lista e eliminação do armazenamento como o tipo de ferramenta do framework.
Se também executares um memory pipeline no mesmo armazenamento de memória, o pipeline pode reescrever, misturar, separar ou eliminar as entradas que o agente guarda para qualquer ator que processe.
Partição e memória segura
Dentro de uma loja, actor_id é como se separa de quem pertencem as memórias. Cada lista e cada pesquisa está limitada a um único actor_id, por isso escolha a estratégia que corresponde àquilo de que o seu agente precisa de se lembrar:
-
Memória privada para cada utilizador: Definir
actor_idpara a identidade verificada do utilizador final. Cada utilizador recebe a sua própria partição, e o agente apenas recupera as entradas desse utilizador.- Exemplo: Um agente de suporte lembra-se das preferências de comunicação de um utilizador e dos tickets anteriores.
-
Memória partilhada para um grupo: Defina
actor_idpara uma chave fixa que escolha, como um ID de equipa, projeto ou organização. Todos lêem e escrevem as mesmas memórias.- Exemplo: Um agente de equipa lembra-se de um glossário partilhado de termos da empresa e convenções internas.
-
Memória dividida por outra coisa: Crie
actor_ida partir dos seus próprios valores, como um ID de inquilino ou umuser:projectcomposto.-
Exemplo: Uma aplicação multi-tenant define
actor_idcomo{tenant}:{user}, para que os utilizadores de cada cliente fiquem isolados uns dos outros.
-
Exemplo: Uma aplicação multi-tenant define
Defina actor_id no seu código de aplicação a partir do contexto do chamador confiável: a identidade verificada do utilizador final para memória por utilizador, ou uma chave de equipa ou projeto confiável para memória partilhada. Nunca deixes o modelo escolhê-lo. Se a sua estratégia assentar numa identidade de utilizador final, rejeite os pedidos que não incluam essa identidade, em vez de recorrer a uma identidade partilhada actor_id.
Warning
actor_id separa memórias, mas não é um controlo de acesso. Os armazenamentos de memória estão limitados ao espaço de trabalho, pelo que qualquer principal que consiga aceder a um armazenamento pode ler e escrever todas as entradas em todos os atores. A loja, não o ator, é o limite de segurança. Para isolamento rigoroso entre inquilinos ou utilizadores, crie um armazenamento de memória separado por limite.
Para permitir que outro principal, como o principal de serviço do seu agente, use uma loja, conceda-lhe acesso através da operação de concessão de permissão da loja (memory_store.grant_permission(principal_id) no SDK AgentKit). Só o criador da loja ou um administrador do espaço de trabalho pode conceder acesso.
Limitations
- A memória do agente fornece apenas memória de longo prazo. Para o histórico de conversas de curto prazo, veja as sessões do agente.
- A pesquisa classifica as entradas por relevância, combinando texto integral (BM25) e correspondência semântica sobre o conteúdo e descrição de cada entrada. Retorna até 100 entradas e não suporta paginação.
- O controlo de acesso é aplicado ao nível da loja. O controlo de acesso por entrada e por ator não está disponível.
- O controlo de acesso à loja cobre as entradas da loja. Qualquer utilizador do workspace pode listar e obter armazenamentos de memória, incluindo os seus IDs e descrições.
- Não podes alterar o ID de uma loja depois de a criares. Só
descriptionpode ser atualizado.