Nota
O acesso a esta página requer autorização. Pode tentar iniciar sessão ou alterar os diretórios.
O acesso a esta página requer autorização. Pode tentar alterar os diretórios.
Importante
Este recurso está em versão Beta.
As sessões geridas de agentes dão aos seus agentes um armazenamento persistente e independente de qualquer framework para o estado de sessão: o estado que um agente ou framework mantém para uma interação. Na maioria dos casos, trata-se do histórico da conversa, a transcrição ordenada de mensagens, invocações de ferramentas e resultados que um agente lê no início de um turno e ao qual vai acrescentando conteúdo à medida que executa esse turno. Pode também ser qualquer outro estado que uma framework mantém durante a interação, como um grafo LangGraph. O Azure Databricks armazena-o no Lakebase e gere o armazenamento por ti, por isso não constroes nem operas a base de dados.
Note
Durante a pré-visualização, ser-lhe-á cobrada a instância subjacente de Lakebase que armazena as suas sessões. Não se aplicam custos adicionais pelas sessões de agentes geridos em si. Os preços podem variar à medida que a pré-visualização avança.
Use sessões geridas quando quiser:
- Persista o histórico de conversas do agente para que sobreviva a reinicios e possa ser retomado mais tarde.
- Reconstrua o contexto completo (incluindo chamadas de ferramentas e raciocínio) numa mensagem de seguimento.
- Liste, retome e ramifique conversas anteriores a partir da tua própria interface.
As sessões geridas mantêm o estado de uma única interação (estado de curto prazo, durante a sessão). Para memória duradoura e de longo prazo que persiste em todas as conversas, use memória de agente gerida.
Requisitos
- Instale Python 3.10 ou superior para usar o AgentKit SDK. O SDK AgentKit é o cliente Python do Databricks para APIs de agentes, que os exemplos abaixo utilizam. Também podes chamar a API REST diretamente de qualquer linguagem, sem necessidade de Python.
Como funcionam as sessões geridas
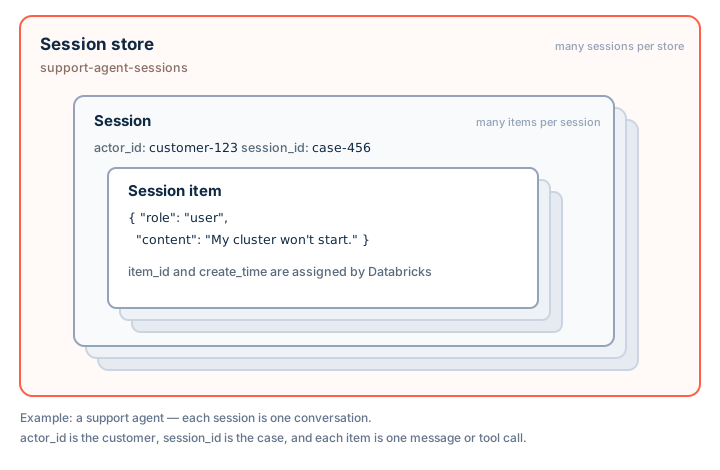
As sessões geridas têm três níveis:
- Um repositório de sessões é o contentor associado ao espaço de trabalho das sessões de um agente. Criar um armazenamento provisiona automaticamente o armazenamento Lakebase de suporte. Escolhe um espaço de trabalho único
session_store_name. - Uma sessão é uma interação duradoura (normalmente um fio de conversa) dentro de uma loja. Uma sessão é identificada por:
-
actor_id(obrigatório): a quem pertence a sessão, como um utilizador final ou outro agente. Agrupa todas as sessões de uma disciplina para que possas listá-las e filtrá-las juntas. Quando constróis uma aplicação por utilizador, defineactor_idpara o ID do utilizador (por exemplo, a identidade verificada do utilizador final pela autenticação da tua app) para que as sessões de cada utilizador permaneçam agrupadas. Defina-o a partir do contexto da aplicação confiável, nunca de um valor fornecido pelo modelo ou pelo utilizador. -
session_id(opcional): um ID escolhido pelo chamador para a interação. O serviço gera um quando o omites. -
parent_session_id(opcional): associa uma sessão à sessão de origem, para representar conversas derivadas.
-
- Um item de sessão é uma entrada no histórico ordenado de uma sessão. Cada item contém um valor opaco compatível
datacom JSON, como uma mensagem, chamada de ferramenta, resultado de ferramenta ou bloco de raciocínio. O Azure Databricks atribui a cada item umitem_ide umcreate_timee não inspeciona nem valida o seu conteúdo. Os itens tornam-se imutáveis depois de anexados.
O serviço mantém uma ordem determinística dos itens de uma sessão e autoriza cada operação no armazenamento da sessão.
Introdução
Estes exemplos configuram sessões geridas para um agente de suporte: criam um armazenamento de sessões, iniciam uma sessão para uma conversa, acrescentam os turnos dessa conversa e leem o histórico num pedido posterior. Escolha o cliente que se encaixe no seu projeto.
AgentKit SDK
O SDK AgentKit é o cliente Python do Databricks para APIs de agentes, distribuído no databricks-agentbricks pacote. Autentica-se com o WorkspaceClient SDK da Databricks.
Instale o SDK AgentKit:
pip install databricks-agentbricksCrie um armazenamento de sessões e, em seguida, inicie uma sessão para uma conversa específica.
actor_idé a quem pertence a conversa; o opcionalsession_ididentifica esta conversa de forma única:from databricks.sdk import WorkspaceClient from databricks_agentkit import AgentKitClient client = AgentKitClient(WorkspaceClient()) session_store = client.session_stores.create("support-agent-sessions") session = session_store.add(actor_id="customer-123", session_id="case-456")Acrescenta os turnos da conversa enquanto o agente corre. Cada item é qualquer valor compatível com JSON:
session.append_items(
    [
        {"type": "message", "role": "user", "content": "I need help with my cluster."},
        {"type": "message", "role": "assistant", "content": "Let's take a look."},
    ]
)
Num pedido de seguimento, recarregue a sessão e leia o seu histórico completo para reconstruir o contexto:
session = session_store.get("case-456")
# Request chronological order; list_items defaults to newest-first and auto-pages.
history = [item.data for item in session.list_items(order_by="create_time asc")]
API REST
Os clientes invocam a API REST em /api/2.0/agents/session-stores. Chame-o diretamente em linguagens diferentes de Python.
Gerar um token de OAuth com a CLI do Databricks:
databricks auth login --host ${DATABRICKS_HOST}
export DATABRICKS_TOKEN=$(databricks auth token | jq -r .access_token)
Crie um armazenamento de sessões para o seu agente:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores?session_store_name=support-agent-sessions" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"description": "Support agent conversation history"}'
Iniciar uma sessão para uma única conversa.
actor_idé a quem pertence;session_ididentifica esta conversa de forma única:curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores/support-agent-sessions/sessions?session_id=case-456" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \ -d '{"actor_id": "customer-123"}'Adicione um turno de conversa enquanto o agente corre:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores/support-agent-sessions/sessions/case-456/items:append" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"items": [{"data": {"type": "message", "role": "user", "content": "I need help with my cluster."}}]}'
Leia a história por ordem cronológica para reconstruir o contexto:
curl -G "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores/support-agent-sessions/sessions/case-456/items" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" --data-urlencode "order_by=create_time asc"
Os clientes também apoiam a remoção do item mais recente, a eliminação dos itens de uma sessão e a integração de uma conversa numa cópia independente (opcionalmente até um item específico). Eliminar uma sessão que tenha sessões filhos requer uma opção forçada para encadear a eliminação para elas (por exemplo, session.delete(force=True)).
Suportar a sessão de um framework de agentes com sessões geridas
Frameworks de agentes como o OpenAI Agents SDK e o Claude Agent SDK leem o histórico de conversas no início de uma execução e acrescentam novos itens no final. O armazenamento de sessões corresponde diretamente a esse padrão:
| Funcionamento do framework | Chamada ao armazenamento de sessão |
|---|---|
| Ler história |
list_items por ordem cronológica (order_by="create_time asc") |
| Adicionar itens de turno |
append Os Novos Itens |
| Desfazer o último item |
pop O item mais recente |
| Limpar o tópico |
clear Os itens da sessão |
Âmbito e acesso
As sessões geridas armazenam os itens de uma sessão como valores opacos e compatíveis com JSON: o serviço persiste e devolve tudo o que o seu agente ou framework adiciona, sem o interpretar. Não adiciona recursos de controlo da execução, como execuções, checkpoints ou aprovações, como conceitos de primeira classe, embora uma estrutura que serialize esse estado possa persisti-lo como itens.
Os armazenamentos de sessão estão circunscritos ao espaço de trabalho, e o acesso é autorizado ao nível do armazenamento. Os actor_id campos and metadata suportam apenas agrupamento e filtragem; não concedem nem restringem o acesso. Defina o actor_id a partir do contexto de uma aplicação de confiança, em vez de um valor fornecido pelo modelo ou pelo utilizador.
Para permitir que outro principal, como o principal de serviço do seu agente, use uma loja, conceda-lhe acesso através da operação de concessão de permissão da loja (session_store.grant_permission(principal_id) no SDK AgentKit).
Sessões geridas e memória gerida são independentes. Eliminar uma sessão ou um repositório de sessões não elimina a memória armazenada num repositório de memória.