Nota
O acesso a esta página requer autorização. Pode tentar iniciar sessão ou alterar os diretórios.
O acesso a esta página requer autorização. Pode tentar alterar os diretórios.
Migre as suas cargas de trabalho da computação clássica para a computação serverless. A computação serverless faz a gestão automaticamente do provisionamento, escalonamento, atualizações de runtime e otimização.
A maioria das cargas de trabalho clássicas pode migrar com alterações mínimas ou nenhumas no código. Esta página foca-se nessas cargas de trabalho. Algumas funcionalidades, como df.cache, ainda não são suportadas em serverless, mas não exigirão alterações de código assim que estiverem disponíveis. Certas cargas de trabalho que dependem de blocos de notas R ou Scala requerem recursos de computação clássicos e não poderão migrar para sem servidor. Para uma lista completa das limitações atuais, veja Limitações de computação sem servidor.
Migrar com o agente de migração
Important
Este recurso está em versão Beta. Os administradores do espaço de trabalho podem ativá-lo a partir da página de Pré-visualizações , optando pela pré-visualização do Compute Agent . Ver Gerir as pré-visualizações de Azure Databricks.
Pode usar um agente de migração para migrar um único notebook ou tarefa para computação sem servidor. O agente revê o ambiente da carga de trabalho, bibliotecas, configurações do Spark, etiquetas e código, e depois propõe cada alteração como uma sugestão individual para aceitar ou rejeitar. As alterações aceites são aplicadas e podem ser revertidas.
O que o agente revê e altera
| Area | O que o agente faz |
|---|---|
| Ambiente e bibliotecas | Traduz instalações de bibliotecas numa especificação de ambiente sem servidor, incluindo instalações de %pip, scripts de inicialização do cluster, bibliotecas de cluster em tarefas e referências a um índice privado de pacotes. |
| Variáveis ambientais | Traduz as variáveis de ambiente do cluster para os seus equivalentes sem servidor, preservando as referências a segredos da área de trabalho e omitindo os valores geridos pela plataforma. |
| Acesso a dados e armazenamento | Reescreve caminhos incompatíveis com ambientes sem servidor, como disco local, dbfs:/ e caminhos de montagem, em volumes do Unity Catalog. O agente aplica reescritas inequívocas automaticamente e pede-lhe que escolha um volume quando o destino é ambíguo. |
| Configurações do Apache Spark | Classifica cada configuração do Spark, comenta as configurações que são seguras para descartar, e sinaliza e remove configurações que o serverless não suporta. Abrange tanto configurações ligadas a um cluster como configurações no caderno. |
| Código de carga de trabalho | Reescreve código que o serverless não suporta em equivalentes compatíveis, como operações RDD reescritas para operações DataFrame, e ajusta o código para comportamento SQL em modo ANSI em serverless. |
| Tags | Traduz etiquetas personalizadas de cluster, como uma etiqueta de centro de custos, para os seus equivalentes serverless. |
| Modo de desempenho | Sugere um modo de desempenho baseado na configuração do cluster. Veja Escolher um modo de desempenho. |
Requisitos
Recomenda-se o acesso administrativo ao espaço de trabalho para garantir uma migração completa. Isto acontece porque o agente também inspeciona scripts globais de inicialização ao nível do espaço de trabalho, além da carga de trabalho de destino. Poderás conseguir migrar se tiveres a permissão
CAN MANAGEna carga de trabalho, mas, sem permissões de administrador, isso pode resultar na falta de bibliotecas, definições de ambiente ou etiquetas.Confirma que tens acesso ao agente. Escreve
/computeo código Génio./computeDeverá aparecer no menu de autocompletamento. Se não aparecer, um administrador do espaço de trabalho deve ativar a pré-visualização no seu espaço de trabalho.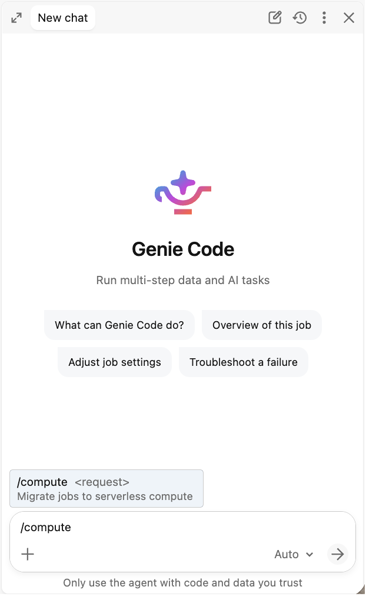
Migrar um bloco de notas
- Abra o bloco de notas que pretende migrar.
- Abre o Código Genie e executa
/compute migrate to serverlessa partir da/paleta de comandos. - Analise as conclusões do agente. O agente analisa o ambiente, as bibliotecas e o código do caderno, e propõe uma alteração para cada item que necessite de uma, como mover a instalação de uma biblioteca para uma especificação de ambiente ou reescrever uma célula de código para ser executada num ambiente sem servidor.
- Aceite ou rejeite cada alteração proposta.
- Aplica as alterações que aceitaste. São gravadas diretamente no bloco de notas.
- Liga o portátil ao serverless e executa-o para confirmar se se comporta como esperas. Veja Verificar uma carga de trabalho migrada.
Migrar um emprego
- Abra o emprego para onde quer migrar.
- Abre o Código Genie e executa
/compute migrate to serverlessa partir da/paleta de comandos. - O agente clona a tua tarefa e tenta migrar a tarefa clonada para um ambiente sem servidor.
- Analise as conclusões do agente. Para um trabalho multitarefa, o agente enumera todas as tarefas e a sua configuração de cluster por tarefa, e propõe alterações para cada uma enquanto preserva o cronograma do trabalho.
- Aceitar ou rejeitar cada alteração proposta na superfície de migração: ambiente e bibliotecas, configurações do Spark e qualquer código de carga de trabalho que precise de mudar.
- Aplica as alterações que aceitaste. A computação da tarefa passa a ser sem servidor.
- Execute a tarefa em sem servidor e confirme os resultados. Veja Verificar uma carga de trabalho migrada.
- Opcionalmente, como passo final, o agente promove o clone migrado. Copia a configuração e os cadernos do clone de volta para o teu trabalho original no local (mantendo o mesmo ID do trabalho, horário e permissões), e depois apaga o clone. Se ignorar a promoção e mantiver ambas as tarefas, coloque em pausa o agendamento da tarefa que não estiver em execução; caso contrário, o mesmo acionador será executado para ambas e poderá duplicar operações de escrita ou outros efeitos secundários.
Verificar uma carga de trabalho migrada
O agente propõe e aplica alterações, mas não executa a sua carga de trabalho nem verifica a sua saída. Executar sempre uma carga de trabalho migrada num ambiente serverless e confirmar os resultados antes de confiar nela, especialmente no caso de cargas de trabalho que escrevem em tabelas de produção. Se o agente propor uma alteração que pareça errada, rejeite-a e envie-nos feedback para podermos melhorar o agente. Consulte Enviar feedback sobre o produto.
Tip
Enquanto valida uma carga de trabalho migrada, execute-a em modo otimizado para desempenho. Arranca mais rápido do que o modo padrão, por isso recebes feedback mais rápido ao confirmar os resultados. Muda para o modo que melhor se adequa à carga de trabalho antes de o executares em produção. Veja Escolher um modo de desempenho.
Quando o agente encontra algo que não consegue migrar em segurança, assinala um impedimento e para por predefinição. Pode instruí-lo explicitamente a prosseguir apesar de alguns bloqueios de compatibilidade ou de dependências, mas, ao fazê-lo, aceita o risco de essas dependências, a atribuição de custos ou o comportamento em tempo de execução não se manterem, e a carga de trabalho pode falhar num ambiente sem servidor.
Anular alterações da migração
As alterações que o agente aplica são reversíveis.
Para um bloco de notas, abra-o e restaure a revisão imediatamente anterior à migração. Ver histórico de versões nos cadernos Databricks.
Para uma tarefa, se não tiver promovido o clone migrado, a sua tarefa original nunca foi alterada: execute-a como antes e elimine o clone. Se promoveste o clone, restaura a partir do backup que o agente escreveu antes de fazer qualquer alteração:
- Abra a pasta de cópia de segurança no diretório pessoal da sua área de trabalho:
/Workspace/Users/<your-username>/serverless-migration/backups/job-<job-id>/<timestamp>/. O agente mostrou este caminho durante a migração. Se houver vários carimbos de data, escolha aquele de pouco antes da migração. - Abra
job.yaml, que contém as definições da tarefa anteriores à migração, e aplique essas definições novamente à mesma tarefa com um pedidoPOST /api/2.2/jobs/reset, que substitui as definições da tarefa pelas que fornecer. Também podes colá-los na definição JSON do trabalho na interface. Isto devolve o trabalho à computação clássica. - Open
mapping.yaml, que lista cada ficheiro de backup e o caminho original de onde veio. Copie cada ficheiro de backup de volta pelo seu caminho original para desfazer as reescritas do código. - Execute a tarefa para confirmar que continua a comportar-se da mesma forma que antes da migração.
A migração nunca apaga este backup. As tarefas que o agente não modificou, como tarefas provenientes do Git, SQL ou dbt, são registadas em job.yaml, mas os seus ficheiros não são copiados para a cópia de segurança, por isso, se necessário, restaure-as a partir da sua fonte fidedigna.
Limitações conhecidas
- Os seguintes elementos são identificados como bloqueadores: imagens personalizadas, variantes do ML Runtime, versões do Databricks Runtime anteriores à versão 13, configurações do Spark que não podem ser ignoradas com segurança em ambientes sem servidor e dependências como ficheiros egg, JARs e bibliotecas Maven. Um bloqueador significa que o agente para em vez de migrar esse item. Pode resolver o problema por si e executar novamente a migração, ou dizer ao agente para prosseguir com a migração mesmo assim, deixando esse item por resolver, o que pode fazer com que a carga de trabalho falhe num ambiente sem servidor.
- O agente lê scripts de init armazenados em ficheiros de workspace ou volumes do Unity Catalog. Scripts de init armazenados em ABFSS ou DBFS não podem ser lidos e são reportados como bloqueadores.
- O agente não inspeciona todos os atributos clássicos de computação. A entrega de logs do cluster e as chaves SSH não são modeladas e, embora detete muitas dependências de montagens DBFS a partir do código da carga de trabalho, não enumera nem resolve todas as montagens.
- As APIs de cache e checkpoint, as vistas temporárias globais, as chamadas de gestão de montagens do DBFS e o código Scala ou R constituem, por defeito, impedimentos absolutos. Pode instruir o agente a prosseguir, mas a funcionalidade não resolvida permanece inalterada e pode falhar no serverless.
- Empregos com mais de 10 tarefas migráveis não podem atualmente ser migrados.
- O agente migra uma carga de trabalho de cada vez. Não existe deteção ao nível de toda a frota, migração em massa nem fluxo de aprovação por administradores.
- O agente propõe alterações e aplica as que aceita, mas não executa a sua carga de trabalho nem verifica a correção da saída. Verifique uma carga de trabalho migrada antes de depender dela para dados de produção.
- Se a fonte de verdade da sua carga de trabalho for um Databricks Asset Bundle ou uma pasta Git, o agente aplica alterações ao objeto workspace existente. Reconcilie essas alterações com o seu bundle ou repositório para que uma implementação posterior não sobreescreva a migração.
Migrar manualmente para uma arquitetura sem servidor
Para migrar as suas cargas de trabalho da computação clássica para a computação serverless, siga estes passos:
- Verifique os pré-requisitos: Verifique se o seu espaço de trabalho, redes e acesso ao armazenamento na cloud cumprem os requisitos. Consulte Pré-requisitos.
- Atualizar código: Faça quaisquer alterações necessárias no código e configuração. Veja Atualizar o seu código.
- Teste as suas tarefas de processamento: Valide a compatibilidade e correção antes de fazer a transição. Veja Teste as suas cargas de trabalho.
- Escolha um modo de desempenho: Selecione o modo de desempenho que melhor se adequa às suas necessidades de carga de trabalho. Veja Escolher um modo de desempenho.
- Migre em fases: Implemente o serverless de forma incremental, começando com cargas de trabalho novas e de baixo risco. Ver Migrar em fases.
- Monitorizar custos: Monitorizar o consumo de DBUs serverless e configurar alertas. Ver Monitorizar custos.
Prerequisites
Antes de começares a migrar, podes precisar de atualizar algumas configurações legadas no teu espaço de trabalho.
| Pré-requisito | Action | Detalhes |
|---|---|---|
| O Workspace está ativado para o Unity Catalog | Migrar da Metastore Hive se necessário | Atualize um espaço de trabalho Azure Databricks para o Unity Catalog |
| Rede configurada | Substituir o peering da VPC por NCCs, Private Link ou por regras de firewall | Arquitetura de rede em plano de computação sem servidor |
| Acesso ao armazenamento na nuvem | Substituir padrões de acesso a dados legados por localizações externas do Unity Catalog | Ligar ao armazenamento de objetos na cloud utilizando o Unity Catalog |
Confirma que o teu espaço de trabalho está numa região suportada.
Atualize o seu código
As secções seguintes listam o código e as alterações de configuração necessárias para tornar as suas cargas de trabalho compatíveis com serverless.
Acesso a dados
Os padrões de acesso a dados legados não são suportados em ambientes *serverless*. Atualize o seu código para usar o Unity Catalog em vez disso.
| Padrão clássico | Substituição sem servidor | Detalhes |
|---|---|---|
Caminhos DBFS (dbfs:/...) |
Volumes do catálogo Unity | O que são volumes do Catálogo Unity? |
| Tabelas do Metastore Hive | Tabelas do Catálogo Unity (ou HMS Federation) | Atualize um espaço de trabalho Azure Databricks para o Unity Catalog |
| Credenciais da conta de armazenamento | Localizações externas do Unity Catalog | Ligar ao armazenamento de objetos na cloud utilizando o Unity Catalog |
| JARs JDBC personalizados | Federação Lakehouse | O que é federação de consultas? |
Advertência
O acesso ao DBFS é limitado em ambientes sem servidor. Atualize todos os caminhos dbfs:/ para os volumes do Catálogo Unity antes de migrar. Para mais informações, consulte Migrar ficheiros armazenados no DBFS.
Exemplo: Substituir os caminhos do DBFS e as referências do Hive Metastore
# Classic
df = spark.read.csv("dbfs:/mnt/datalake/data.csv", header=True)
df.write.parquet("dbfs:/mnt/output/results")
df = spark.table("my_database.my_table")

# Serverless
df = spark.read.csv("/Volumes/main/sales/raw_data/data.csv", header=True)
df.write.parquet("/Volumes/main/analytics/output/results")
df = spark.table("main.my_database.my_table")  # three-level namespace
APIs e código
Certas APIs e padrões de código não são suportados em serverless. Consulte esta tabela para ver se o seu código precisa de ser atualizado.
| Padrão clássico | Substituição sem servidor | Detalhes |
|---|---|---|
APIs RDD (sc.parallelize, rdd.map) |
DataFrame APIs | Compare o Spark Connect com o Spark Classic |
df.cache(), df.persist() |
Remover chamadas de cache | Limitações de computação sem servidor |
spark.sparkContext, sqlContext |
Use spark (SparkSession) diretamente |
Compare o Spark Connect com o Spark Classic |
Variáveis do Hive (${var}) |
SQL DECLARE VARIABLE ou Python f-strings |
DECLARE VARIABLE |
| Configurações Spark não suportadas | Remove as configurações não suportadas. Serverless otimiza automaticamente a maioria das definições. | Configurar propriedades do Spark para notebooks e tarefas sem servidor |
Exemplo: Substituir operações RDD por DataFrames
from pyspark.sql import functions as F

# sc.parallelize + rdd.map
# Classic:  rdd = sc.parallelize([1, 2, 3]); rdd.map(lambda x: x * 2).collect()
df = spark.createDataFrame([(1,), (2,), (3,)], ["value"])
result = df.select((F.col("value") * 2).alias("value")).collect()

# rdd.flatMap
# Classic:  sc.parallelize(["hello world"]).flatMap(lambda l: l.split(" ")).collect()
df = spark.createDataFrame([("hello world",)], ["line"])
words = df.select(F.explode(F.split("line", " ")).alias("word")).collect()

# rdd.groupByKey
# Classic:  rdd.groupByKey().mapValues(list).collect()
df = spark.createDataFrame([("a", 1), ("b", 2), ("a", 3)], ["key", "value"])
grouped = df.groupBy("key").agg(F.collect_list("value").alias("values")).collect()

# rdd.mapPartitions → applyInPandas
import pandas as pd
def process_group(pdf: pd.DataFrame) -> pd.DataFrame:
    return pd.DataFrame({"total": [pdf["id"].sum()]})
result = (spark.range(100).repartition(4)
    .groupBy(F.spark_partition_id())
    .applyInPandas(process_group, schema="total long").collect())

# sc.textFile → spark.read.text
df = spark.read.text("/Volumes/catalog/schema/volume/file.txt")
Exemplo: Substituir o SparkContext e a cache
from pyspark.sql.functions import broadcast

# sc.broadcast → broadcast join
result = main_df.join(broadcast(lookup_df), "key")

# sc.accumulator → DataFrame aggregation
total = df.agg(F.sum("amount")).collect()[0][0]

# sqlContext.sql → spark.sql
result = spark.sql("SELECT * FROM main.db.table")

# df.cache() → remove caching calls
# Materialize expensive intermediate results to Delta as a workaround:
df = spark.read.parquet(path)
result = df.filter("status = 'active'")
expensive_df.write.format("delta").mode("overwrite").saveAsTable("main.scratch.temp")
result = spark.table("main.scratch.temp")
Diferenças de comportamento SQL
A computação serverless ativa o modo ANSI por defeito. O Databricks Runtime ativa o modo ANSI por defeito na versão 17.0 e superior. Se o seu classic compute correr uma versão anterior, algumas consultas que têm sucesso aí geram erros de runtime no serverless.
O agente de migração ajusta automaticamente o código para o comportamento do modo ANSI. Se migrar manualmente, reveja as seguintes operações, que mais frequentemente mudam de comportamento:
| Operação | Computação clássica com modo ANSI desativado | Computação sem servidor |
|---|---|---|
Conversão inválida, como CAST('abc' AS INT) |
Devoluções NULL |
Gera CAST_INVALID_INPUT |
| overflow aritmético de inteiros | Envolve. Por exemplo, 2147483647 + 1 retorna -2147483648. |
Gera ARITHMETIC_OVERFLOW |
| Overflow aritmético decimal | Devoluções NULL |
Gera NUMERIC_VALUE_OUT_OF_RANGE |
| Divisão por zero | Devoluções NULL |
Gera DIVIDE_BY_ZERO |
| URL mal formado em parse_url | Devoluções NULL |
Aumenta INVALID_URL |
Para devolver NULL em vez de gerar um erro, substitua a operação pelo seu try_* equivalente, como try_cast, try_add, try_divide ou try_parse_url. A Databricks recomenda esta abordagem em vez de desativar o modo ANSI, porque o modo ANSI revela problemas de qualidade dos dados que um erro silencioso que NULL oculta.
Para desativar o modo ANSI para casts, aritmética e análise sintática, defina spark.sql.ansi.enabled para false. A computação serverless aplica regras ANSI a casts implícitos em inserts de tabela independentemente desta configuração, porque spark.sql.storeAssignmentPolicy não pode ser alterada na computação serverless. Para uma descrição completa do comportamento ANSI, veja conformidade ANSI em Databricks Runtime.
Bibliotecas e ambientes
Pode gerir bibliotecas e ambientes a nível de workspace usando ambientes base e a nível de notebook usando o ambiente serverless do notebook.
| Padrão clássico | Substituição sem servidor | Detalhes |
|---|---|---|
| Scripts de inicialização | Ambientes sem servidor | Configurar o ambiente sem servidor |
| Bibliotecas com âmbito de cluster | Bibliotecas com âmbito de notebook ou de ambiente | Configurar o ambiente sem servidor |
| Bibliotecas Maven/JAR | Suporte para tarefas JAR; PyPI para notebooks | Tarefa JAR para trabalhos |
| Contentores Docker | Ambientes serverless para necessidades de bibliotecas | Configurar o ambiente sem servidor |
Fixar pacotes Python em requirements.txt para criar ambientes reproduzíveis. Veja Especificar versões de pacotes Python.
Serviço de streaming
Cargas de trabalho de streaming são suportadas em serverless, mas certos gatilhos não são suportados. Atualiza o teu código para usar os gatilhos suportados.
| Gatilho de faísca | Suportado | Notes |
|---|---|---|
Trigger.AvailableNow() |
Sim | Recomendado |
Trigger.Once() |
Sim | Isso está obsoleto. Utilize Trigger.AvailableNow() em substituição. |
Trigger.ProcessingTime(interval) |
No | Devoluções INFINITE_STREAMING_TRIGGER_NOT_SUPPORTED |
Trigger.Continuous(interval) |
No | Utilize o modo contínuo dos pipelines do Lakeflow em vez disso |
Padrão (não definido .trigger()) |
No | Omissão de .trigger() implica o padrão ProcessingTime("0 seconds"), que não é suportado em ambientes serverless. Define .trigger(availableNow=True) sempre explicitamente. |
Para streaming contínuo, migre para os Pipelines Declarativos Spark em modo contínuo ou use tarefas de agendamento contínuo com AvailableNow. Para fontes grandes, defina maxFilesPerTrigger ou maxBytesPerTrigger para evitar erros de falta de memória.
Exemplo: Corrigir gatilhos de streaming
# Classic (not supported on serverless — default trigger is ProcessingTime)
query = df.writeStream.format("delta").outputMode("append").start()

# Serverless (explicit AvailableNow trigger)
query = (df.writeStream.format("delta").outputMode("append")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
query.awaitTermination()

# With OOM prevention for large sources
query = (spark.readStream.format("delta")
    .option("maxFilesPerTrigger", 100)
    .option("maxBytesPerTrigger", "10g")
    .load(input_path)
    .writeStream.format("delta")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
Testa as tuas cargas de trabalho
- Teste rápido de compatibilidade: Execute a carga de trabalho em computação clássica com modo de acesso Standard e Databricks Runtime 14.3 ou superior. Se a execução for bem-sucedida, a carga de trabalho pode migrar para serverless sem quaisquer alterações de código.
- Comparação A/B (recomendada para produção): Execute a mesma tarefa nos ambientes clássico (controlo) e sem servidor (experimento). Tabelas de saída do diff e verifique a correção. Iterar até que os resultados coincidam.
- Configurações temporárias: Pode definir temporariamente as configurações suportadas do Spark durante os testes. Remova-os quando estiver estável.
Escolha um modo de performance
Os trabalhos e pipelines sem servidor suportam dois modos de desempenho: padrão e otimizado para performance. O modo de desempenho que escolhes depende das tuas necessidades de carga de trabalho.
| Mode | Availability | Startup | Melhor para |
|---|---|---|---|
| Standard | Empregos, oleodutos Lakeflow | 4-6 minutos | Lote sensível ao custo |
| Otimizado para desempenho | Cadernos, Empregos, Oleodutos Lakeflow | Segundos | Interativo, sensível à latência |
Migrar em fases
- Novas cargas de trabalho: Inicia todos os novos cadernos e trabalhos em serverless.
- Cargas de trabalho de baixo risco: migrar cargas de trabalho PySpark/SQL já em modo de acesso padrão e Databricks Runtime 14.3 ou superior.
- Cargas de trabalho complexas: Migrar cargas de trabalho que necessitam de alterações de código (reescritas RDD, atualizações de DBFS, correções de triggers).
- Cargas de trabalho restantes: Revise periodicamente à medida que as capacidades se expandem.
Monitorizar os custos
A faturação serverless baseia-se no consumo da DBU, não no tempo de funcionamento do cluster. Valide expectativas de custos com cargas de trabalho representativas antes de migrar em escala. Para monitorizar os custos serverless com ferramentas e estratégias, consulte Monitorizar o custo da computação serverless.
Recursos adicionais
- Boas práticas para computação sem servidor: dicas de otimização para workloads sem servidor
- Limitações de computação serverless: Lista completa de limitações atuais e funcionalidades não suportadas
- Configurar o ambiente serverless: Gerir bibliotecas e dependências
- Configurações Spark suportadas: Configurações Spark disponíveis em serverless
- Spark Connect vs. Spark clássico: Diferenças comportamentais na arquitetura serverless
- Segurança de rede serverless: NCCs, Private Link e configuração de firewalls
- Notas de lançamento de computação serverless: Acompanhe as novas capacidades conforme são lançadas
- Guia de atualização do Unity Catalog: Migrar da Hive Metastore para o Unity Catalog
Pode também consultar os seguintes artigos do blogue para mais informações:
- O que é computação serverless?: Visão geral das capacidades serverless e resultados dos clientes
- Evolução da engenharia de dados: Como a computação serverless está a transformar os notebooks e as tarefas Lakeflow: Como a computação serverless impulsiona as tarefas e os pipelines Lakeflow