Nota
O acesso a esta página requer autorização. Pode tentar iniciar sessão ou alterar os diretórios.
O acesso a esta página requer autorização. Pode tentar alterar os diretórios.
Antes de poder utilizar de forma eficaz a capacidade de mineração de processos no Power Automate, tem de compreender:
- Requisitos de dados.
- Onde obter dados de registo da sua aplicação.
- Como ligar a uma origem de dados.
Aqui está um pequeno vídeo sobre como carregar dados para utilizar com a funcionalidade de process mining:
Requisitos de dados
Os registos de eventos e os registos de atividade são tabelas armazenadas no seu sistema de registo que documentam quando ocorre um evento ou uma atividade. Por exemplo, as atividades que executa na sua aplicação de gestão das relações com os clientes (CRM) são guardadas como um registo de eventos na sua aplicação CRM. Para que a mineração de processos analise o registo de eventos, são necessários os seguintes campos:
ID do caso
O ID de Caso deve representar uma instância do seu processo e muitas vezes é o objeto sobre o qual o processo atua. Pode ser um "ID do paciente" para um processo de entrada de paciente internado, um "ID da encomenda" para um processo de submissão de encomendas ou um "ID do pedido" para um processo de aprovação. Este ID tem de estar presente em todas as atividades no registo.
Nome da Atividade
As atividades são os passos do seu processo e os nomes das atividades descrevem cada passo. Num processo de aprovação típico, os nomes das atividades poderão ser "submeter pedido", "pedido aprovado", "pedido rejeitado" e "rever pedido".
Carimbo de Data/Hora de Início e Carimbo de Data/Hora de Fim
Os carimbos de data/hora indicam a hora exata em que ocorreu um evento ou atividade. Os registos de eventos têm apenas uma marca temporal. Este carimbo temporal indica a hora em que ocorreu um evento ou atividade no sistema. Os registos de atividade têm duas marcas temporais: uma marca temporal de início e uma marca temporal de fim. Estes carimbos de data indicam o início e o fim de cada evento ou atividade.
Também pode expandir a análise ao ingerir tipos de atributo opcionais:
Recurso
Um recurso humano ou técnico que executa um evento específico.
Atributo ao Nível do Evento
Um atributo analítico que tem um valor diferente para cada evento, como o departamento que realiza a atividade.
Atributo ao nível do caso (primeiro evento)
Um atributo analítico que tem um único valor por caso, como o montante de uma fatura em USD. No entanto, o registo de eventos ingerido não necessita de ter o mesmo valor para todos os eventos no caso. Pode não ser possível garantir consistência ao usar atualização incremental de dados. O Power Automate Process Mining ingere os dados tal como estão, armazenando todos os valores fornecidos no registo de eventos, mas utiliza um mecanismo de interpretação de atributos ao nível do caso para trabalhar com os atributos ao nível do caso.
Por outras palavras, sempre que o atributo é usado para uma função específica que requer valores ao nível do evento, como filtragem ao nível do evento, o produto utiliza os valores do nível do evento. Sempre que é necessário um valor ao nível do caso, como num filtro ao nível do caso ou numa análise de causa raiz, utiliza o valor interpretado, que é retirado do primeiro evento cronologicamente do caso.
Atributo ao nível do caso (último evento)
O mesmo que o Atributo ao Nível do Caso (primeiro evento), mas quando interpretado ao nível do caso, o valor é retirado do último evento cronológico no caso.
Finanças por Evento
Um custo fixo, receita ou valor numérico que muda para cada atividade realizada, como custos de serviços de estafeta. O valor financeiro é calculado como uma soma, média, mínimo ou máximo dos valores financeiros de cada evento.
Valor financeiro por caso (primeiro evento)
Um atributo analítico que tem um único valor por caso, como o montante de uma fatura em USD. No entanto, o registo de eventos ingerido não necessita de ter o mesmo valor para todos os eventos no caso. Pode não ser possível garantir consistência ao usar atualização incremental de dados. O Power Automate Process Mining ingere os dados tal como estão, armazenando todos os valores fornecidos no registo de eventos, mas utiliza um mecanismo de interpretação de atributos ao nível do caso para trabalhar com os atributos ao nível do caso.
Por outras palavras, sempre que o atributo é usado para uma função específica que requer valores ao nível do evento, como filtragem ao nível do evento, o produto utiliza os valores do nível do evento. Sempre que é necessário um valor ao nível do caso, como num filtro ao nível do caso ou numa análise de causa raiz, utiliza o valor interpretado, que é retirado do primeiro evento cronologicamente do caso.
Valor financeiro por caso (último evento)
O mesmo que Financeiro Por Caso (primeiro evento), mas quando interpretado ao nível do caso, o valor é retirado do último evento cronológico no caso.
Onde obter dados de registo da sua aplicação
A funcionalidade de process mining necessita de dados de registo de eventos para executar o process mining. Embora muitas tabelas na base de dados da sua aplicação contenham o estado atual dos dados, podem não conter um registo histórico dos eventos que ocorreram, que é o formato exigido do registo de eventos. Felizmente, em muitas aplicações de maior dimensão, este registo histórico ou diário de registo é frequentemente armazenado numa tabela específica. Por exemplo, muitas aplicações Dynamics mantêm este registo na tabela de Atividades. Outras aplicações, como SAP ou Salesforce, têm conceitos semelhantes, mas o nome poderá ser diferente.
Nestas tabelas que registam registos históricos, a estrutura dos dados pode ser complexa. Poderá ter de juntar a tabela de registos a outras tabelas na base de dados da aplicação para obter IDs ou nomes específicos. Além disso, nem todos os eventos que lhe interessam estão registados. Pode ser necessário determinar que eventos devem ser mantidos ou filtrados. Se precisar de ajuda, contacte a equipa de TI que gere esta aplicação para saber melhor.
Ligar a uma origem de dados
O benefício de ligar diretamente a uma base de dados é manter o relatório de processos atualizado com os dados mais recentes da origem de dados.
O Power Query suporta uma grande variedade de conectores que permitem que a capacidade de mineração de processos se ligue e importe dados da origem de dados correspondente. Os conectores comuns incluem Texto/CSV, Microsoft Dataverse e base de dados SQL Server. Se estiver a utilizar uma aplicação como SAP ou Salesforce, poderá ser capaz de se ligar diretamente a essas origens de dados através dos respetivos conectores. Para informações sobre conectores suportados e como os utilizar, consulte Conectores no Power Query.
Experimenta a capacidade de mineração de processos com o conector Text/CSV
Uma forma simples de experimentar a capacidade de mineração de processos, independentemente de onde a tua fonte de dados esteja localizada, é usar o conector Text/CSV. Poderá ter de trabalhar com o admin da sua base de dados para exportar uma pequena amostra do registo de eventos como um ficheiro CSV. Quando tiver o ficheiro CSV, importe-o para a capacidade de mineração de processos usando os seguintes passos no ecrã de seleção da fonte de dados.
Nota
Tem de utilizar o OneDrive para Empresas para utilizar o conector de Texto/CSV. Se não tiver o OneDrive para Empresas, considere usar uma tabela em branco em vez de texto/CSV, como no passo 3 seguinte. Não poderá importar tantos registos na Tabela em branco.
Na página inicial da mineração de processos, crie um processo selecionando Começar aqui.
Introduza um nome do processo e selecione Criar.
No ecrã Escolher origem de dados, selecione Todas as categorias>Texto/CSV.
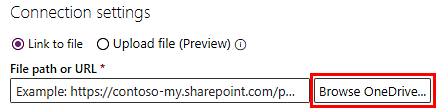
Selecione Procurar OneDrive. Talvez precise de autenticar.
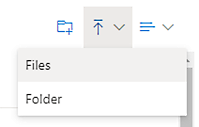
Carregue o seu registo de eventos selecionando o ícone Carregar no canto superior direito e, em seguida, selecionando Ficheiros.
Carregue o seu registo de eventos, selecione o seu ficheiro da lista e, em seguida, selecione Abrir para utilizar esse ficheiro.
Utilize o conector Dataflow
A Microsoft Power Platform não suporta o conector Dataflow. Não pode usar o Dataflow existente como fonte de dados para o Power Automate Process Mining.
Utilizar o conector do Dataverse
A Microsoft Power Platform não suporta o conector Dataverse. Liga-te a ele usando o conector OData, o que requer mais alguns passos.
Garanta que tem acesso ao ambiente Dataverse.
Obtenha a URL do ambiente do Dataverse ao qual quer ligar-se. Normalmente, tem este aspeto:
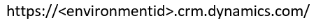
Para saber como encontrar o seu URL, consulte Encontrar o URL do seu ambiente Dataverse.
No Power Query - Escolha fontes de dados, selecione OData.
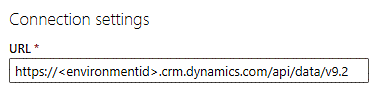
Na caixa de texto do URL, escreva api/data/v9.2 no final do URL para que fique assim:
Em Credenciais de ligação, selecione a Conta organizacional no campo Tipo de autenticação.
Selecione Iniciar sessão e introduza as suas credenciais.
Selecione Seguinte.
Expandir a pasta OData. Vês todas as tabelas do Dataverse nesse ambiente. Por exemplo, a tabela de Atividades chama-se activitypointers.
Selecione a caixa de verificação junto à tabela que pretende importar e, em seguida, selecione Seguinte.