Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
Точная идентификация и классификация данных являются основой надежной безопасности данных. Это позволяет предприятиям уверенно развертывать политики защиты данных в своих цифровых активах. Microsoft Purview поддерживает этот критически важный шаг с помощью типов конфиденциальной информации (SIT) и передовых технологий классификации, таких как точное сопоставление данных (EDM),обучаемые классификаторы и отпечаток документов.
Однако для управления объемом ложноположительных результатов необходимо настроить и применить эти средства в правильных контекстах и сценариях. Ложное срабатывание означает, что система неправильно помечает что-то как совпадение, даже если это не так. Ложные срабатывания:
- Повышение усталости от оповещений. Перегружает группы безопасности и соответствия требованиям, повышая вероятность скольжения реальных рисков.
- Время и ресурсы: проверка ложноположительных результатов приводит к эскалации операционных затрат, особенно для предприятий, обрабатывая большие объемы данных.
- Создание ненужных препятствий. Ограничения доступа, неправильно примененные к содержимому, которое не является конфиденциальным, приводит к затруднениям в рабочих процессах и производительности.
- Снижение доверия пользователей. Снижает общее внедрение продукта.
Поэтому важно иметь четкое представление о полезности и релевантности SIT и расширенных классификаторов для разнообразия бизнес-сценариев на предприятии.
Сведения об этом руководстве
В этом руководстве содержатся следующие статьи:
- Введение (эта статья)
- Шаг 1. Настройка обнаружения конфиденциальных данных на основе шаблона
- Шаг 2. Реализация точного сопоставления данных для точного сопоставления
- Шаг 3. Использование обучаемых классификаторов для сложного содержимого
- Шаг 4. Применение отпечатков документов для шаблонов
Подготовка к работе
Это руководство предназначено для администраторов, которые знакомы с технологиями Защита от потери данных Microsoft Purview (DLP) и классификации. Если вы не знакомы с этими решениями, дополнительные сведения см. в следующих статьях:
- Сведения о типах конфиденциальной информации
- Подробнее о пользовательских типах конфиденциальной информации с точным совпадением данных
- Информация об обучаемых классификаторах
- Сведения об отпечатках документов
Общие сведения о технологиях классификации
| Технология классификации | Типичный вариант использования | Почему? |
|---|---|---|
| Сидит | Определение распространенных типов конфиденциальных данных, которые широко признаны и соответствуют стандартизированным шаблонам. Например, кредитные карта номера, сети SSN. | Возможность быстрого развертывания с минимальной конфигурацией и встроенной поддержкой. |
| Точное соответствие данных | Сценарии, требующие точного сопоставления данных из известного источника данных. Например, обнаружение определенных номеров учетных записей клиентов, идентификаторов сотрудников или пациентов. | Сводит к минимуму ложные срабатывания, помечая только данные, которые точно соответствуют записям в переданной эталонной таблице данных. |
| Обучаемый классификатор | Определение сложных и контекстных данных, документов с разнообразной структурой и непредсказуемым форматом, где не применяются традиционные шаблоны. Например, юридические документы с различными предложениями и форматами. | Предоставляет настраиваемый и интеллектуальный подход к сложным типам данных. |
| Отпечаток документа | Варианты использования, в которых шаблон и форматирование документов согласованы в организации. Например, бизнес-контракты, счета, rfP или стандартные формы, содержащие конфиденциальные данные. | Обеспечивает целевую защиту для критически важных структурированных документов. |
Обзор развертывания
Модель развертывания разбивает подход на четыре этапа, каждый из которых ориентирован на другую технологию классификации:
| Шаг | Технология классификации | Описание |
|---|---|---|
| Шаг 1. Настройка обнаружения конфиденциальных данных на основе шаблона | Типы конфиденциальной информации (SIT) | Выбирайте, настраивайте и уточняйте SIT для точного обнаружения на основе шаблонов. |
| Шаг 2. Реализация точного сопоставления данных для точного сопоставления | Точное соответствие данных (EDM) | Используйте хэшированные эталонные данные для точной идентификации известных конфиденциальных данных. |
| Шаг 3. Использование обучаемых классификаторов для сложного содержимого | Обучаемые классификаторы | Используйте классификаторы на основе ИИ для сложного содержимого, которое не соответствует стандартным шаблонам. |
| Шаг 4. Применение отпечатков документов для шаблонов | Создание отпечатка документа | Обнаружение определенных шаблонов документов и документов фиксированного формата. |
Схема развертывания Microsoft Purview
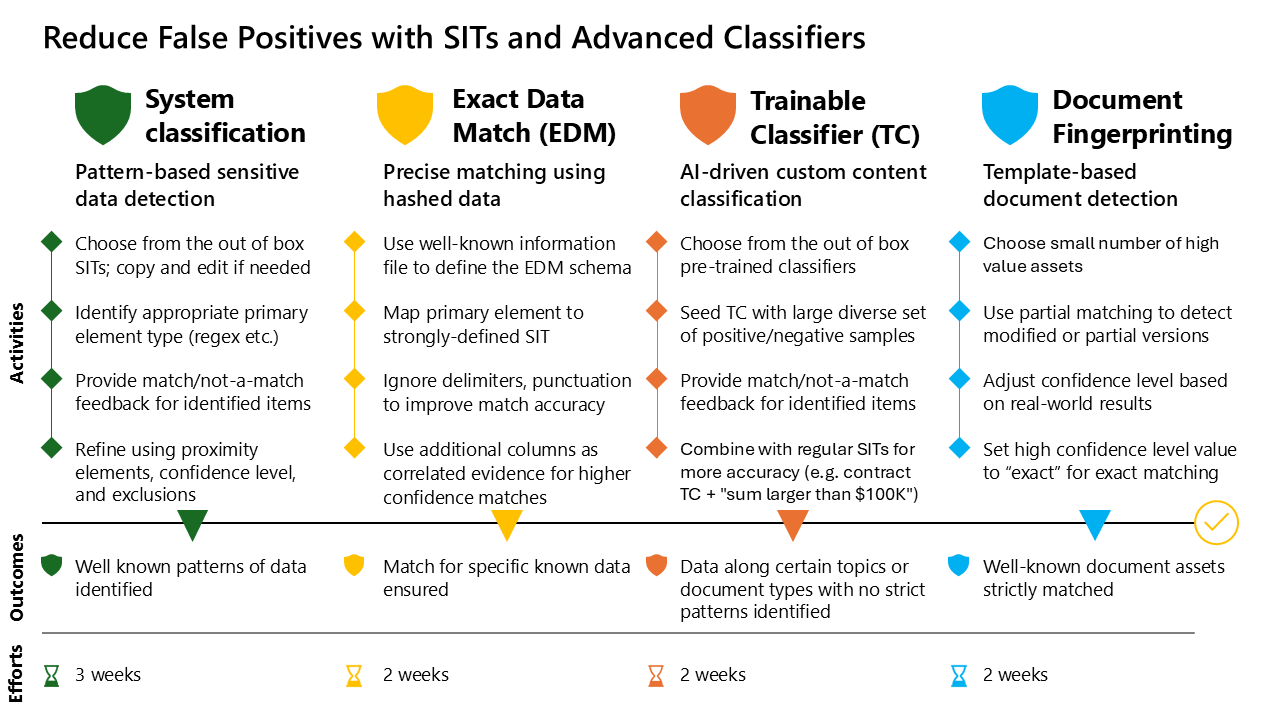
Стратегии классификации данных на основе сценариев
В следующей таблице приведены рекомендации по развертыванию с примерами рекомендуемых методов классификации данных для различных сценариев.
| Сценарий | Предпочтительный метод | Альтернативные методы | Методы уменьшения ложноположительных результатов |
|---|---|---|---|
| Обнаружение PII/PHI для известных лиц (клиентов или пациентов) | EDM для извлечения данных из бизнес-приложения | Пользовательские SIT, включая идентификатор сотрудника и общие личные коды (например, SSN) | Если вы используете обычные sit, рекомендуется требовать наличия всех полных имен и ограничить правила документами с более чем определенным минимальным числом совпадений. |
| Обнаружение piI/PHI для сотрудников или подрядчиков | EDM для данных из извлечения системы управления персоналом | Пользовательские sit, включая идентификатор сотрудника + именованные сущности (например, все полные имена) + общие ЛИЧНЫЕ коды SIT | Если вы используете обычные sit, рекомендуется требовать наличия всех полных имен и ограничить правила документами с более чем определенным минимальным числом совпадений. |
| Обнаружение форм с личными данными | Формирование отпечатков пальцев + стандартные SIT или отпечатки пальцев + пользовательские SIT | Пользовательские SIT + OCR (для отсканированных форм) | Используйте EDM вместо пользовательских SIT, если не используется отпечаток. |
| Контракты, юридические документы или другие формы бизнеса | Настраиваемые обучаемые классификаторы (+ OCR) | Встроенные обучаемые классификаторы + OCR | Определите документы в организации, которые правильно идентифицирует встроенный TC, скопируйте их в репозиторий и используйте для обучения пользовательского TC. |
| Важные контракты или другие документы | Обучаемый классификатор + метка конфиденциальности | Обучаемый классификатор + пользовательский SIT (например, регулярный счет для обнаружения денежных сумм свыше 100 тыс. долл. США) | Объедините несколько TC в одном правиле, например "Контракты" и "Документы о Project X". |
| Общая piI или PHI неизвестных лиц | Встроенные SIT,если они доступны, или настраиваемые SIT | Ручная маркировка | Скопируйте и измените существующий sit для точной настройки требований к ключевое слово. Добавьте требования для именованных сущностей, таких как Все полные имена. |
| Отсканированные удостоверения личности (или аналогичные) | Встроенные или настраиваемые SIT+OCR | Настраиваемый SIT со списками ключевое слово + OCR | Добавьте требования к именованным сущностям (именам или адресам), если ожидается запись в одной строке. |
| Данные проекта | Метка на основе расположения (например, метка по умолчанию для библиотеки) | Маркировка вручную или настраиваемые обучаемые классификаторы | Когда метки на основе расположения идентифицируют достаточно релевантных документов, используйте их для обучения пользовательского TC. |
Оптимизация конфигурации политики защиты от потери данных
При использовании классификаторов в политиках защиты от потери данных (DLP) измените число экземпляров, чтобы уменьшить количество ложных срабатываний. Оставьте минимальное пороговое значение для числа экземпляров более высоким, если небольшие или тривиальные вхождения конфиденциальных данных не требуют действий. Однако если бизнес-контекст требует ужесточения безопасности данных, используйте меньшее число экземпляров, чтобы заблокировать даже одно вхождение. Настройка количества экземпляров в соответствии с уровнем конфиденциальности данных.
Содержимое Обозреватель — это центральный центр для обнаружения конфиденциального содержимого в пространстве данных. Он обеспечивает исчерпывающую видимость типов и расположений конфиденциальных данных. Настроив пороговые значения экземпляров и задав соответствующие уровни достоверности для обнаружения, вы можете убедиться, что оповещения активируются только в том случае, если контекст соответствует уровню риска организации.