Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
Это руководство состоит из четырех этапов:
- Введение
- Шаг 1. Настройка обнаружения конфиденциальных данных на основе шаблона
- Шаг 2. Реализация точного сопоставления данных для точного сопоставления
- Шаг 3. Использование обучаемых классификаторов для сложного содержимого (эта статья)
- Шаг 4. Применение отпечатков документов для шаблонов
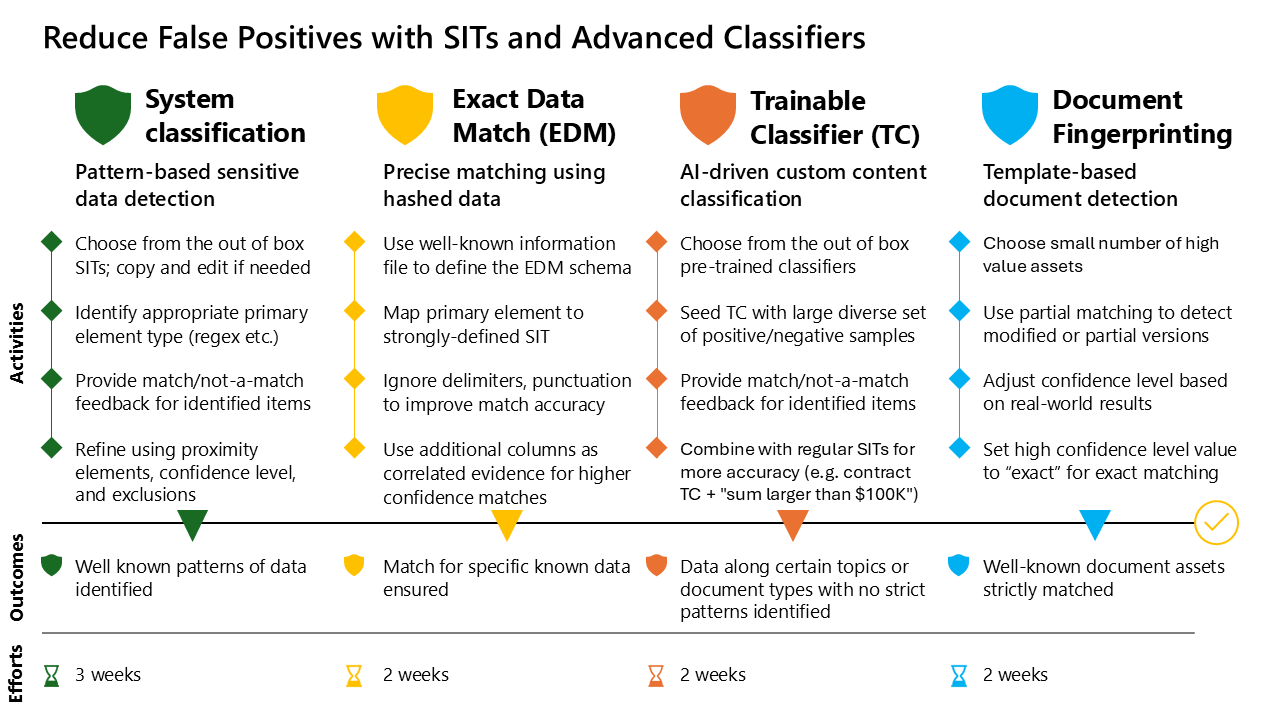
Используйте обучаемые классификаторы, когда необходимо определить содержимое, относящееся к конкретной организации или проприетарное содержимое, которое не могут надежно обнаружить встроенные типы конфиденциальной информации (SIT) или классификаторы, предварительно обученные корпорацией Майкрософт. Обучаемые классификаторы используют машинное обучение для идентификации шаблонов документов, обеспечивая настраиваемый и интеллектуальный подход к сложным типам данных.
Выбор из встроенных предварительно обученных классификаторов
Используйте готовые обучаемые классификаторы, предоставляемые корпорацией Майкрософт. Определите, какой обучаемый классификатор подходит для вашего варианта использования, протестируйте его с помощью примера данных, чтобы убедиться, что он соответствует вашим требованиям, и начните использовать его в своих политиках без дополнительных усилий по ручной настройке и точной настройке.
Если встроенные обучаемые классификаторы не соответствуют вашим потребностям, создайте собственные пользовательские классификаторы на основе соответствующих документов вашей организации.
Дополнительные сведения см. в статье Сведения о обучаемых классификаторах.
Начальные пользовательские классификаторы с большим, разнообразным набором примеров
Обучите пользовательский классификатор с достаточным количеством положительных и отрицательных выборок типа содержимого, который он будет обнаруживать. Если некоторые обучаемые классификаторы, предоставляемые корпорацией Майкрософт в Microsoft Purview, соответствуют вашим потребностям, но не обеспечивают необходимую точность в вашей среде, используйте их для обнаружения большого набора документов, которые соответствуют требованиям. Соберите их в одном расположении (удаление ложноположительных результатов и добавление соответствующих документов, идентифицированных вручную). Используйте несвязанные документы и документы, которые были неправильно сопоставлены исходным классификатором в качестве отрицательных примеров.
Такой подход гарантирует, что обучающий набор учитывает ваш конкретный жаргон, имена и другие важные аспекты вашей информации.
Дополнительные сведения см. в статье Начало работы с обучаемыми классификаторами.
Предоставление соответствия и несогласованного отзыва для определенных элементов
Как и в случае с SIT, предоставьте регулярные отзывы по каждому элементу, сопоставленным с обучаемым классификатором, чтобы повысить точность классификатора. Если классификатор обнаруживает много ложных срабатываний, удалите пользовательский классификатор и создайте его заново с большим и точным набором данных.
Объединение обучаемых классификаторов с SIT для повышения точности
Используйте гибридный подход, сочетающий машинное обучение (с обучаемым классификатором) и сопоставление шаблонов на основе правил (с sit) для достижения более высокой точности. Например, чтобы определить конфиденциальные бизнес-контракты, превышающие 100 тыс. долл. США, свяжите предварительно обученный Business Context классификатор с пользовательским sit, который обнаруживает суммы контракта более 100 тыс. долл. США. Эти классификаторы можно использовать в политиках защиты от потери данных для комплексной защиты данных.
Сводка
В конце этого шага в вашей организации будет реализовано следующее:
- Встроенные предварительно обученные классификаторы вычисляются и развертываются там, где это возможно.
- Пользовательские обучаемые классификаторы, созданные с разнообразным набором положительных и отрицательных выборок.
- Цикл обратной связи, установленный для непрерывного повышения точности классификатора.
- Гибридный подход, сочетающий обучаемые классификаторы с SIT для повышения точности.