Примечание.
Для доступа к этой странице требуется авторизация. Вы можете попробовать войти или изменить каталоги.
Для доступа к этой странице требуется авторизация. Вы можете попробовать изменить каталоги.
Агент данных Fabric позволяет организациям создавать диалоговые системы с помощью генерируемого ИИ. Подключив семантические модели Power BI в качестве источников данных, команды могут задавать вопросы естественного языка и получать точные, расширенные контекстные ответы без написания сложных запросов DAX или SQL.
Однако качество ответов ИИ сильно зависит от того, насколько хорошо вы подготавливаете источники данных. Хотя агент данных Fabric поддерживает несколько типов источников данных, включая lakehouses, склады, центры событий и онтологии, в этом руководстве рассматриваются конкретные модели семантики Power BI и рассматриваются рекомендации по их настройке для повышения точности и релевантности.
Как работает агент данных Fabric
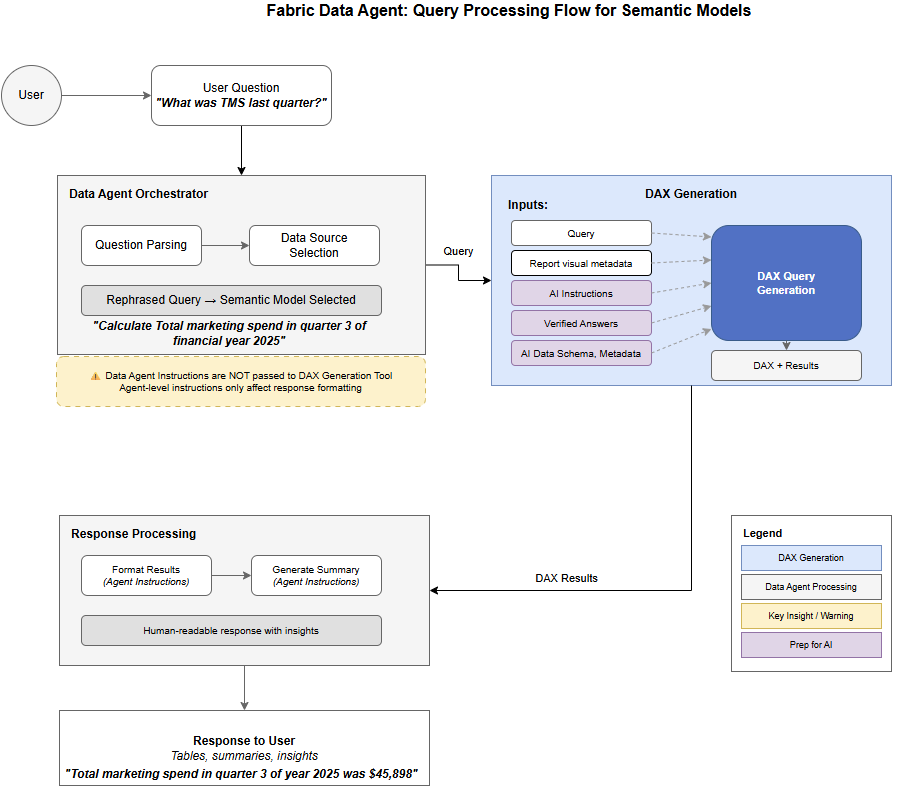
Агент данных использует многоуровневую архитектуру, в которой вопросы пользователя передаются через Orchestrator. Orchestrator определяет соответствующий источник данных и вызывает специализированные средства, включая средство создания DAX для семантических моделей Power BI для создания, проверки и выполнения запросов.
Поток обработки запросов
Анализ вопросов: Агент обрабатывает вопросы пользователей с помощью Azure OpenAI, обеспечивая соответствие протоколам безопасности и разрешениям и соблюдение принципов ответственного искусственного интеллекта Майкрософт.
Выбор источника данных: Система оценивает вопрос по доступным источникам, используя сведения о схеме и инструкции по ИИ, которые вы предоставляете.
Создание запросов: Для семантических моделей средство создания DAX создает запросы DAX на основе схемы, метаданных (синонимов, минимальных и максимальных значений числовых столбцов, метаданных визуального отчета и т. д.), контекста, настроенного в данных подготовки для искусственного интеллекта и журнала бесед.
Форматирование ответа: Агент форматирует результаты в читаемые человеком ответы с таблицами, сводками или аналитическими данными на основе инструкций агента.
Расширенная генерация DAX (предварительная версия)
Для агентов данных в среде выполнения предварительной версии доступен продвинутый инструмент для генерации DAX. В отличие от стандартной генерации DAX, которая генерирует запрос за один проход, расширенная генерация DAX использует несколько этапов рассуждения для анализа метаданных модели, интерпретации вопроса, устранения неоднозначности и генерации запроса DAX.
Преимущества передовой генерации DAX включают:
- Более точные ответы на сложные вопросы: Он рассуждает итеративно, анализирует результаты, устраняет неоднозначность и совершенствует свой подход на нескольких этапах.
- Индексация значения экземпляра: Он ищет значения внутри столбцов семантической модели для создания более точных и надёжных фильтров.
- Последовательные ответы во всех продуктах Microsoft: Для этого используются общие возможности, которые повышают согласованность ответов в агенте данных Fabric, навыках Fabric, Power BI, Microsoft 365 Copilot и плагине Fabric IQ.
- Улучшенная задержка в некоторых случаях: Хотя инструмент может выполнять несколько этапов рассуждения, его способность более эффективно определять релевантные объекты и значения модели может снизить задержку ответа на некоторые вопросы.
Используйте продвинутую генерацию DAX
Чтобы включить функцию, переключите агент данных на режим предварительного просмотра.
Продвинутая генерация DAX использует метаданные семантической модели и подготовку к конфигурациям ИИ, описанные в этой статье. Следуйте лучшим практикам, описанным в этой статье, чтобы максимизировать точность и эффективность ответа.
Индексирование значений экземпляров в настоящее время требует, чтобы в семантической модели был включён параметр Q&A. Эта настройка по умолчанию включена для моделей Import и Direct Lake. Поскольку Q&A будет выведен из эксплуатации в декабре 2026 года, параметр, который придёт ему на замену, будет поддерживать индексирование значений экземпляров после вывода из эксплуатации, и эта статья будет обновлена с указанием новых шагов настройки.
Подготовка для искусственного интеллекта: подготовка семантической модели ИИ
Функция Prep for AI в Power BI предоставляет три компонента настройки, которые непосредственно влияют на интерпретацию семантической модели агентом данных Fabric. Эти компоненты можно получить как в Power BI Desktop, так и в службе Power BI. Power BI Copilot также использует подготовку для настройки ИИ-конфигураций, поэтому вложение времени в их настройку приносит пользу как для Copilot, так и для ответов агента данных.
Это важно
При запросе семантических моделей средство создания DAX, используемое агентом данных, зависит исключительно от метаданных семантической модели и конфигураций для подготовки к работе с ИИ. Средство создания DAX игнорирует все инструкции, которые вы добавляете на уровне агента данных для создания запросов DAX. Правильная подготовка конфигурации ИИ необходима для точных результатов.
Схемы данных ИИ
Схемы данных ИИ позволяют определить ориентированное подмножество модели для определения приоритета ИИ. Хотя агент данных также имеет собственный выбор таблицы при добавлении семантической модели в качестве источника данных, сначала настройте схему в предварительной версии для ИИ. Средство создания DAX использует эту схему для создания запросов DAX.
Эту схему можно настроить в Power BI Desktop или службе Power BI, выбрав данные подготовки для ИИ на ленте "Главная". Затем перейдите на вкладку "Упрощение схемы данных ". Оттуда выберите таблицы, столбцы и меры, которые ИИ должны использовать при создании ответов. Подробные инструкции по настройке см. в разделе "Настройка схемы данных ИИ".
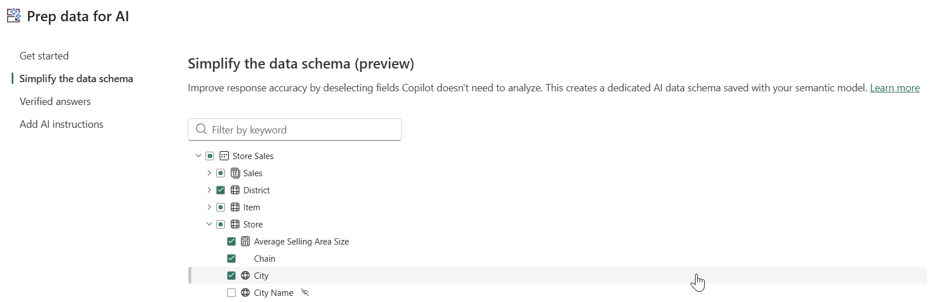
При добавлении семантической модели в агент данных выберите те же таблицы, которые вы определили в prep для ИИ, чтобы обеспечить согласованное поведение. Сначала определите область действия агента данных (типы вопросов, которые он должен ответить). Затем выберите только соответствующие объекты. Этот подход снижает неоднозначность, повышает точность и уменьшает задержку отклика.
Средство создания DAX использует метаданные модели для интерпретации вопросов. Используйте четкие, понятные для бизнеса имена таблиц, столбцов и мер, которые отражают, как пользователи естественно ссылаются на данные. Например, вместо "TR_AMT" или "Регион продаж" вместо "DIM_GEO_01" используйте "Общий доход". Это руководство особенно важно для крупных моделей с перекрывающимися или схожими по названию полями, где неоднозначные имена могут привести к неверной генерации запросов.
Пример: разрешение неоднозначности поля
| Без схемы данных искусственного интеллекта | Схема данных искусственного интеллекта |
|---|---|
Пользователь спрашивает: семантическая модель содержит несколько мер, связанных с продажами: "What were our sales last quarter?" Total Revenue, Gross Sales, Net Sales и Sales After Returns. ИИ возвращает валовые продажи, но ваша команда обычно использует Net Sales для квартальных отчетов. |
После настройки схемы данных ИИ, чтобы включить только чистые продажи и исключить другие метрики, которые не имеют отношения, тот же вопрос теперь приводит к ожидаемой метрике. ИИ больше не должен догадываться, какое значение "продаж" имел в виду пользователь. |
Советы по схемам данных ИИ
Для согласованных и точных результатов убедитесь, что вы выбираете те же таблицы в агенте данных Fabric, которые также определяются с помощью схем данных ИИ в предварительной версии для ИИ.
При выборе схемы также включите зависимые объекты. Например, если мера Total Revenue ссылается на две другие меры, зависящие от дополнительных столбцов, включите все эти зависимые объекты в схему. Чтобы определить зависимости, используйте функцию get_measure_dependencies из библиотеки "Семантические лаборатории связей ".
Если у вас есть семантическая модель больших размеров, переименование всех объектов вручную может быть утомительным. Используйте сервер Power BI Modeling MCP для генерации понятных для бизнеса имен для ваших таблиц, столбцов и мер. Проверьте изменения перед сохранением, чтобы убедиться, что они не нарушают выражения DAX, связи или другие зависимые объекты.
Проверенные ответы
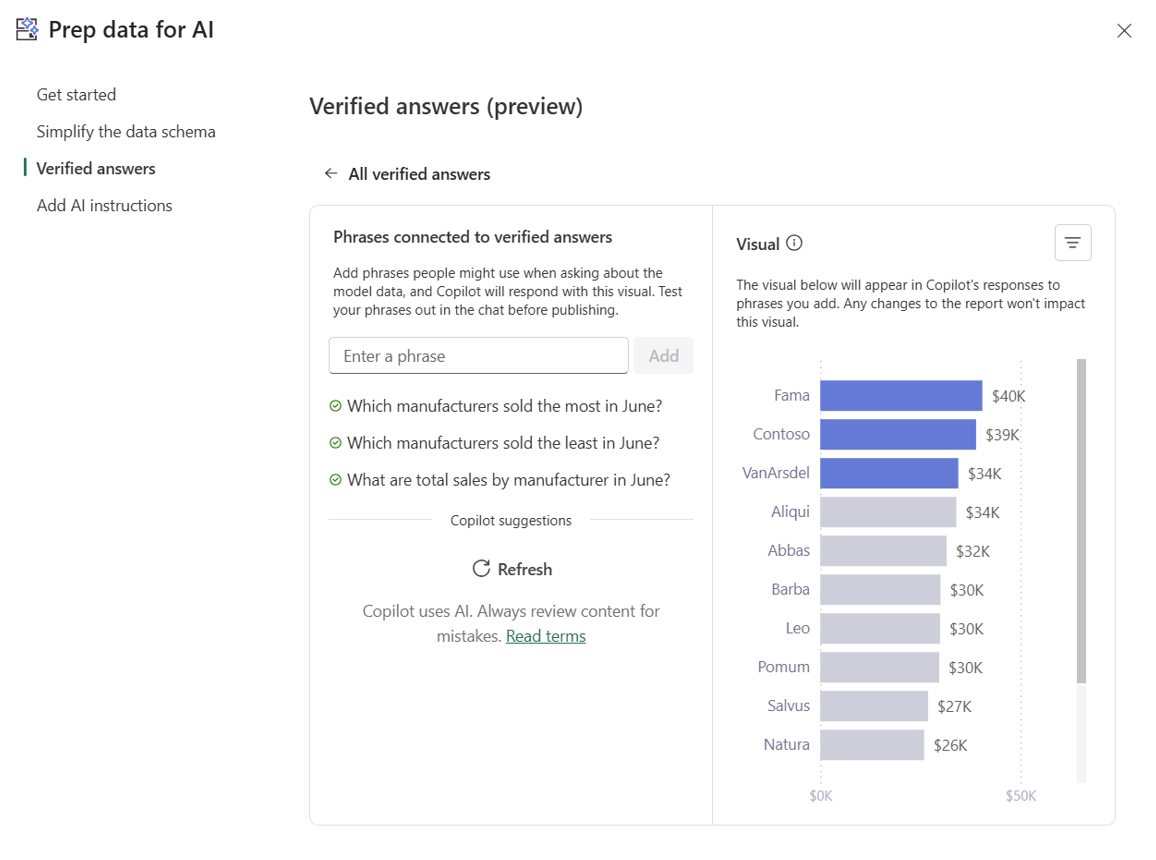
Проверенные ответы — это утвержденные пользователями визуальные ответы, которые запускаются конкретными вопросами. Они предоставляют согласованные, надежные ответы на распространенные или сложные вопросы, которые в противном случае могут быть неправильно интерпретированы. Так как вы храните проверенные ответы на уровне семантической модели (а не на уровне отчета), они работают в любом агенте данных, использующего ту же модель. Дополнительные сведения см. в статье "Подготовка данных для ИИ— проверенные ответы".
При использовании проверенных ответов с агентом данных система не возвращает визуализацию Power BI. Вместо этого он использует пользовательские вопросы и свойства визуального элемента (столбцы, меры, фильтры) для влияния на создание запросов DAX. Этот подход означает, что проверенные ответы повышают точность, направляя средство генерации DAX к правильной структуре запроса. Когда пользователь задает вопрос агенту данных, система сначала проверяет точное или семантическое совпадение с запросом, определенным в проверенном ответе перед созданием нового ответа.
Пример. Обработка региональной терминологии
| Без проверенного ответа | С проверенным ответом |
|---|---|
Пользователь спрашивает: "Show me performance by territory" ИИ интерпретирует "территорию" как категорию продуктов, так как в таблице Products есть столбец "Территория". Пользователь фактически имел в виду регионы продаж. |
Вы создаете проверенный ответ с помощью регионального визуального элемента продаж с такими вопросами, как "What is the sales performance by territory?""Показать мне продажи, разбитые по территории", и "Как распределяются продажи по регионам?" Теперь, когда пользователи спрашивают о производительности территории, они постоянно получают точные ответы на основе объектов, используемых в визуальном элементе региональных продаж. |
Советы по настройке проверенных ответов
- Используйте пять-семь вопросов-триггеров для каждого проверенного ответа, чтобы покрыть естественные вариации.
- Включите как формальные, так и разговорные фразы, которые могут попробовать пользователи.
- Настройте до трех фильтров для гибкого среза, избегая создания нескольких проверенных ответов.
- Если вы переименовываете таблицы, столбцы или меры, на которые ссылается проверенный ответ, обновите проверенный ответ и сохраните его еще раз, чтобы изменения вступили в силу.
Инструкции по ИИ
В Prep for AI инструкции по ИИ предоставляют контекст, бизнес-логику и рекомендации непосредственно по семантической модели. Они помогают уточнить терминологию, направлять подходы к анализу и обеспечивать критически важный бизнес-контекст и семантический контекст, которые ИИ в противном случае не смог бы понять.
Эти инструкции можно настроить в Power BI Desktop или службе Power BI, выбрав данные подготовки для искусственного интеллекта на ленте "Главная", а затем перейдите на вкладку "Добавление инструкций ИИ". Подробные инструкции по настройке см. в документации по ИИ.
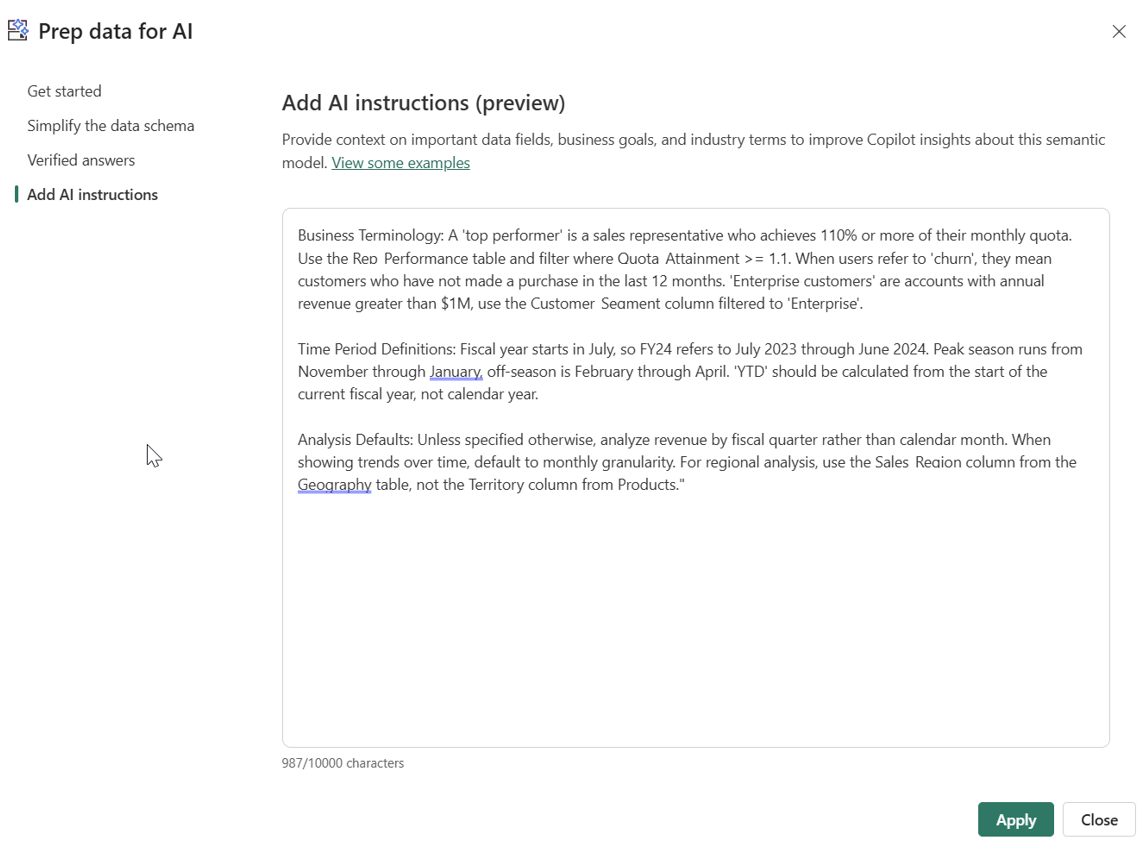
Инструкции по ИИ являются неструктурированными рекомендациями, которые LLM интерпретирует, но нет никакой гарантии, что она следует им точно. Четкие, конкретные инструкции более эффективны, чем сложные или конфликтующие.
Как упоминалось ранее, средство создания DAX относится только к инструкциям ИИ, настроенным в Prep for AI семантической модели. Инструкции агента данных не передаются в средство и игнорируются при запросе семантических моделей. По этой причине не добавляйте конкретные инструкции по семантической модели на уровне агента данных. Вместо этого сохраните все инструкции по семантической модели в Prep для ИИ, где средство создания DAX может использовать их. Инструкции агента данных должны включать только рекомендации, которые применяются ко всем источникам данных, настроенным в агенте, таким как общие параметры форматирования ответа, правила маршрутизации между источниками, общие сокращения, тон и т. д. Кроме того, обратите внимание, что в отличие от других источников данных агент данных не поддерживает инструкции или описания источников данных для семантических моделей.
Пример. Определение терминологии бизнеса
| Без инструкций по искусственному интеллекту | Инструкции по искусственному интеллекту |
|---|---|
| Пользователь спрашивает: "Кто были лучшими исполнителями в прошлом месяце?" ИИ не понимает, что означает "главный исполнитель" в вашей организации и возвращает ошибку или запрашивает уточнение. | Вы добавите инструкцию: "Главный исполнитель является представителем продаж, который достигает 110% или более своей ежемесячной квоты. Используйте таблицу Rep_Performance и фильтр, где Quota_Attainment >= 1.1" Теперь ИИ правильно интерпретирует вопрос и возвращает правильные результаты. |
Эффективные шаблоны инструкций
- Определения периодов времени: "Пиковый сезон работает с ноября по январь. Межсезонье – февраль до апреля".
- Параметры метрики: "Когда пользователи спрашивают о прибыльности, используйте меру Contribution_Margin, а не Gross_Profit".
- Маршрутизация источников данных: "Для вопросов инвентаризации определите приоритет таблицы Warehouse_Inventory по сравнению с Sales_Orders".
- Группы по умолчанию: "Если не указано иное, анализ доходов по финансовому кварталу, а не календарному месяцу".
Помимо подготовки для ИИ средство создания запросов DAX также использует метаданные из визуальных элементов отчета, таких как название визуальных элементов, столбцы, меры, фильтры и т. д. для повышения точности запросов.
Рекомендуемый рабочий процесс реализации
Оптимизация семантической модели: Начните с оптимизации семантической модели для производительности. Низкая производительность агента данных часто происходит из плохо разработанной семантической модели, неэффективных мер DAX или сочетания двух. Когда пользователь задает вопрос, агент данных создает запрос DAX и запускает его в модели. Хорошо оптимизированная модель использует меньше ресурсов и обеспечивает более быстрое выполнение запросов. В диалоговом интерфейсе пользователи ожидают быстрых ответов, поэтому низкая производительность непосредственно влияет на взаимодействие с пользователем и внедрение.
Кроме того, чрезмерно раздутая модель с ненужными столбцами, таблицами и мерами создает больше шума для средства генерации DAX для разбора, что может снижать точность отклика. Оптимизируя модель рано, вы также предотвращаете проблемы с производительностью по мере роста данных, а модель становится более сложной. Дополнительные сведения см. в разделе "Оптимизация модели для повышения производительности" в курсе Power BI .
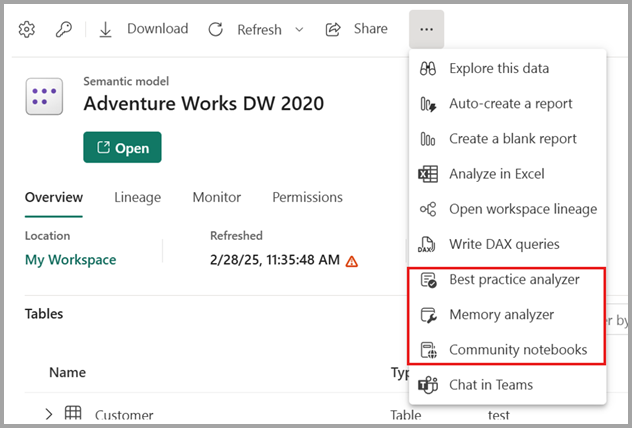
Используйте анализатор лучших практик и анализатор памяти семантической модели в записной книжке Fabric для выявления таких проблем, как неправильные типы данных, ненужные столбцы, столбцы с высокой кардинальностью и неэффективные шаблоны DAX. Добавьте описания в таблицы, столбцы и меры, чтобы помочь LLM понять назначение каждого объекта, включенного в схему данных ИИ.
Настройка подготовки для ИИ > Схема данных ИИ: в зависимости от назначения вашего агента данных настройте схему данных ИИ в разделе Подготовка к ИИ, выбрав только таблицы, столбцы и метрики, относящиеся к вопросам, на которые должен отвечать ваш агент.
Создайте в Prep для ИИ > проверенные ответы. Определите наиболее распространенные вопросы и настройте проверенные ответы в Prep для ИИ с помощью соответствующих визуальных элементов. Используйте полные, надежные вопросы в качестве триггеров (не частичных фраз) для повышения точности сопоставления.
Добавьте Семантическую модель в агент данных: Прежде чем добавлять инструкции ИИ в Prep for AI, протестируйте и проверьте ответы агента данных. Этот шаг помогает понять, где необходимы инструкции по искусственному интеллекту для улучшения создания запросов DAX.
Добавить подготовку для ИИ > Инструкции по искусственному интеллекту. На основе результатов проверки определите бизнес-терминологию, предпочтения анализа и приоритеты источников данных в инструкциях по подготовке для ИИ (а не в инструкциях агента данных).
Подготовка визуальных элементов отчета: Просмотрите отчеты, подключенные к семантической модели, включая скрытые визуальные элементы и страницы, чтобы обеспечить описательное название визуальных элементов. Хорошо структурированные визуальные элементы помогают ИИ заземлить ответы с помощью визуальных метаданных, таких как название визуального элемента, таблица, столбец, меры, используемые, фильтры и многое другое.
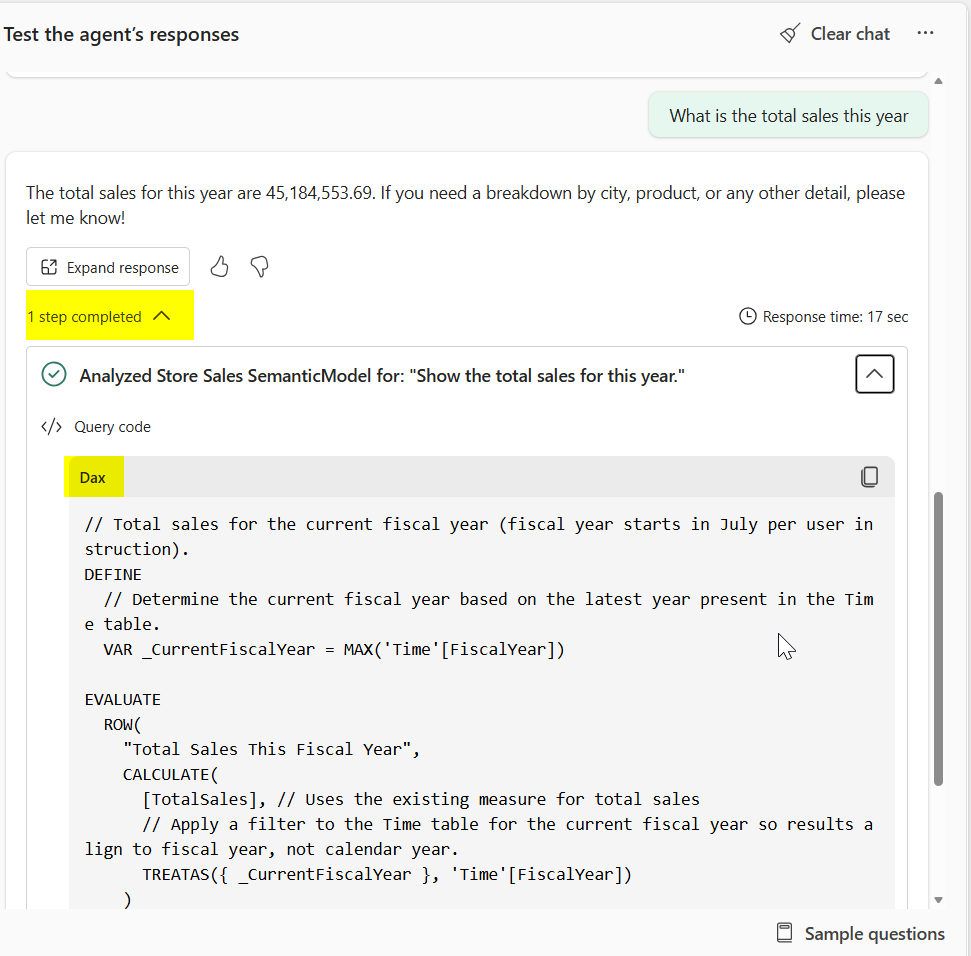
Проверьте и протестируйте DAX: Точность ответа зависит от сформированного запроса DAX. При тестировании агента данных просмотрите запрос DAX в каждом ответе, чтобы убедиться, что он действителен и правильно отвечает на этот вопрос. Если результаты неверны, проанализируйте DAX, чтобы определить, какие конфигурации (семантическая модель, схема данных ИИ, проверенные ответы или инструкции по ИИ) требуют корректировки.
Настройка инструкций агента данных: Добавьте инструкции на уровне агента данных только для рекомендаций, применимых ко всем источникам данных, настроенным в агенте. Это руководство включает общие параметры форматирования ответа, правила маршрутизации между источниками, общие сокращения и тон. Не добавляйте инструкции по семантической модели здесь, так как они не передаются в средство создания DAX. Инструкции по настройке инструкций агента см. в рекомендациях по настройке.
Проверка и итерация: LLM-модели могут давать неправильные результаты без правильного контекста. Вы должны непрерывно совершенствовать свою конфигурацию и проверять ответы, чтобы создать доверие к вашему агенту данных. Для программной оценки ответов можно использовать Python SDK агента данных Fabric для проведения автоматических оценок по проверочным парам вопрос-ответ и анализа метрик точности. Обратите внимание, что пакет SDK предназначен только для оценки в этом случае и не может изменять предварительную версию семантической модели для конфигураций ИИ. Дополнительные сведения см. в разделе "Оценка агента данных". Кроме того, необходимо включить заинтересованных лиц и конечных пользователей в процесс оценки. Их отзывы гарантируют, что ответы соответствуют реальным ожиданиям и удобствам использования, помогая выявлять пробелы, которые могут пропустить автоматические проверки.
Реализуйте управление исходным кодом и конвейеры развертывания: Используйте интеграцию с Git и конвейеры развертывания для управления конфигурациями агента данных в средах разработки, тестирования и производства. Эта практика гарантирует, что изменения конфигурации проходят тестирование и валидацию перед внедрением в производственную среду, где конечные пользователи имеют к ним доступ. Для получения подробной информации см. Управление версиями, CI/CD и ALM для агента данных Fabric.
Подсказка
Вы можете использовать ресурсы в репозитории fabric-toolbox в качестве ориентира, чтобы помочь вам в этой рабочей схеме. Этот репозиторий содержит следующее:
- Контрольный список для подготовки и настройки семантической модели в качестве источника данных
- Записная книжка агента данных с полезными фрагментами кода и вспомогательными функциями
Распространенные ловушки, которых следует избегать
Не используется схема звезды: Семантические модели, использующие плоские, денормализованные таблицы или сводные структуры данных, делают DAX менее эффективным и трудным для правильной записи. DAX оптимизирован для схемы звезд с четкими таблицами фактов и измерений. Преобразуйте широкие таблицы в нормализованные структуры, в которых каждая строка представляет собой одно наблюдение.
Использование скрытых полей: Проверенные ответы не будут работать, если они ссылаются на скрытые столбцы в модели.
Включая ненужные меры: Семантические модели часто содержат вспомогательные меры и промежуточные объекты, используемые для повышения интерактивности отчета. При настройке схемы данных ИИ включите только те меры, которые вычисляют фактические бизнес-метрики. Исключение вспомогательных мер снижает шум и помогает средству создания DAX создавать более точные запросы.
Повторяющиеся или перекрывающиеся меры: Несколько мер, которые вычисляют аналогичные метрики (например, Total Sales, Sales Amount, Revenue), создают неоднозначность. Консолидируйте или четко различайте меры и исключите дубликаты из схемы данных ИИ.
Неописательное именование: Имена объектов, такие как TR_AMT, F_SLS или DIM_GEO_01 не предоставляют контекст для средства создания DAX. Используйте четкие, понятные для бизнеса имена, такие как Total Revenue, Sales или Customer Geography. Если вы не можете переименовать объекты, убедитесь, что описания и синонимы предоставляют необходимый контекст для ИИ, чтобы понять их назначение.
Опираясь на неявные меры: Неявные меры могут привести к непредсказуемым результатам. Создайте явные меры DAX для вычислений, которые пользователи могут запрашивать, и задайте правильную сводку по умолчанию (Сумма, Среднее, Нет и т. д.) для числовых столбцов, чтобы предотвратить непреднамеренные агрегации.
Неоднозначные поля дат: Несколько столбцов дат (дата заказа, дата доставки, дата выполнения, календарь квартал/квартал FY и т. д.) без четкого указания спутают ИИ. Используйте проверенные ответы и инструкции в модуле "Подготовка к ИИ," чтобы указать, какое поле даты следует использовать по умолчанию или для определенных типов вопросов.
Конфликтующие инструкции: Инструкции ИИ, которые противоречат конфигурациям проверенных ответов, создают непредсказуемое поведение.
Пропуск уточнения схемы: Для больших моделей с множеством аналогично названных полей необходимы специализированные схемы данных для искусственного интеллекта.
Слишком сложные инструкции: Делайте инструкции простыми и конкретными. ИИ интерпретирует, но не гарантирует выполнение сложных конфликтующих рекомендаций. Сложные инструкции также могут увеличивать задержку.
Tools
Для выполнения этих рекомендаций можно использовать приведенные ниже средства из репозитория fabric-toolbox на GitHub:
- Контрольный список с рекомендациями. Это рекомендации, а не все элементы в контрольном списке могут быть применимы к вашему сценарию.
- Записная книжка с коллекцией служебных программ в одном месте.
- Сервер Power BI MCP для ускорения разработки и тестирования в VS Code
- Библиотека Semantic Link Labs для программного обновления семантической модели в записной книжке Fabric.
Дополнительные ресурсы
- Документация по основным понятиям агента данных Fabric
- Набор инструментов Fabric с контрольным списком и записными книжками
- Добавление семантической модели в качестве источника данных в агент данных
- Подготовка данных для искусственного интеллекта в Power BI
- Оптимизация семантической модели для Copilot
- Оптимизация модели для повышения производительности в Power BI — обучение
- Вопросы и ответы о подготовке для искусственного интеллекта