Poznámka
Na prístup k tejto stránke sa vyžaduje oprávnenie. Môžete sa skúsiť prihlásiť alebo zmeniť adresáre.
Na prístup k tejto stránke sa vyžaduje oprávnenie. Môžete skúsiť zmeniť adresáre.
Vzťahuje sa na:✅ Fabric Data Engineering a dátová veda
Fabric Data Engineering a Data Science bežia na plne spravovanej výpočtovej platforme Apache Spark. Štartovacie pooly poskytujú rýchly štart relácie, zvyčajne za 5 až 10 sekúnd, bez manuálneho nastavovania. Vlastné Spark pooly vám umožňujú ladiť veľkosť uzlov, škálovacie správanie a ďalšie výpočtové nastavenia pre vašu pracovnú záťaž. Stručne povedané, štartovacie pooly poskytujú rýchly, predkonfigurovaný Spark, zatiaľ čo vlastné Spark pooly poskytujú hlbšiu kontrolu a flexibilitu.
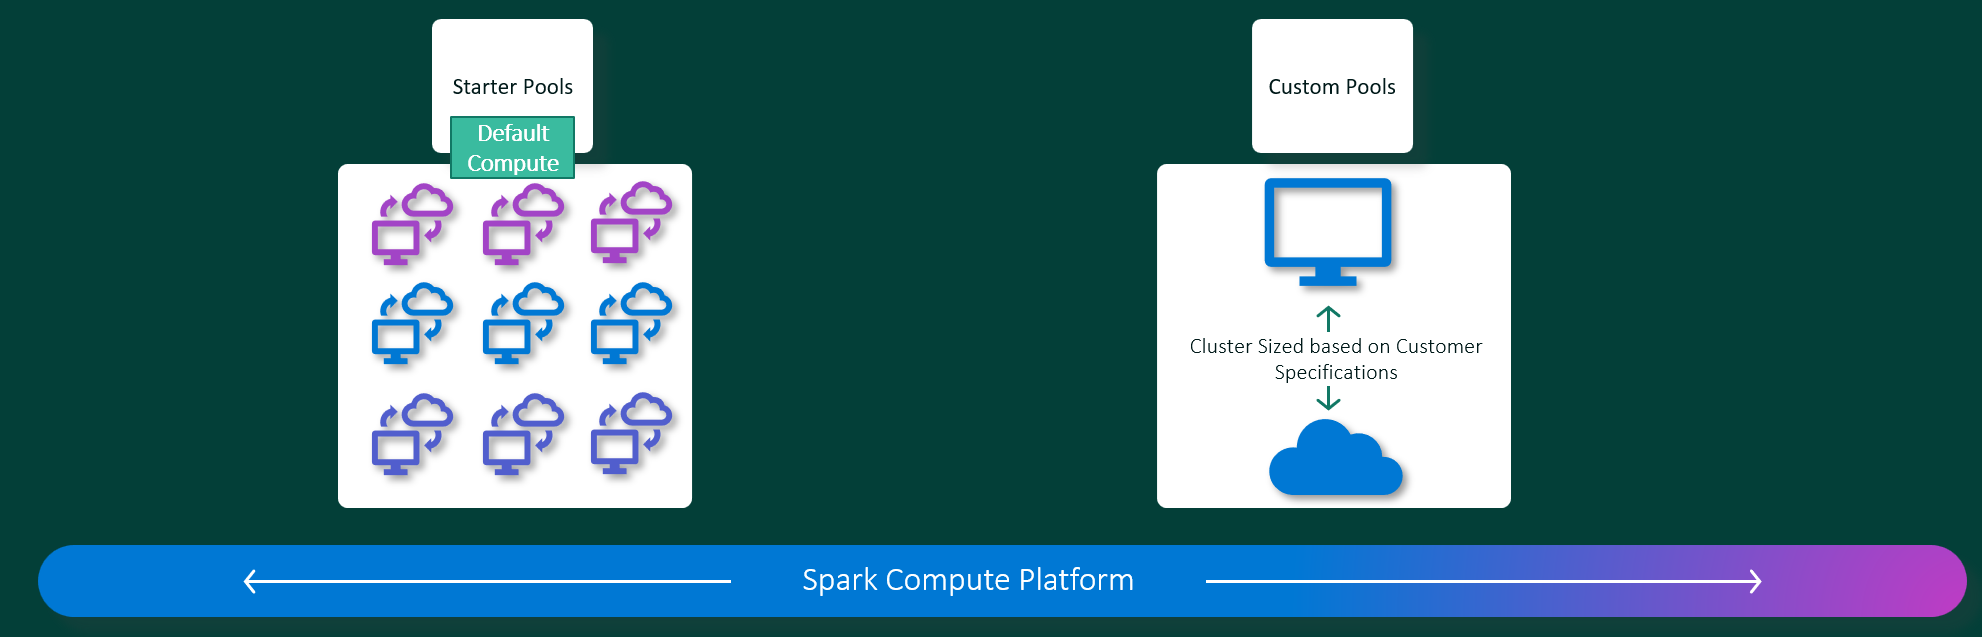
Úvodné bazény
Štartovacie bazény sú rýchly a jednoduchý spôsob, ako použiť Spark na platforme Fabric za pár sekúnd. Relácie služby Spark môžete použiť okamžite namiesto toho, aby ste čakali, kým vám Spark nastaví uzly, čo vám pomôže urobiť viac s údajmi a rýchlejšie získať prehľady.

Úvodné bazény majú klastre Apache Spark s reláciami, ktoré sú vždy zapnuté a pripravené pre vaše požiadavky. Používajú stredne veľké uzly, ktoré sa dynamicky zväčšujú na základe vašich potrieb práce v službe Spark.
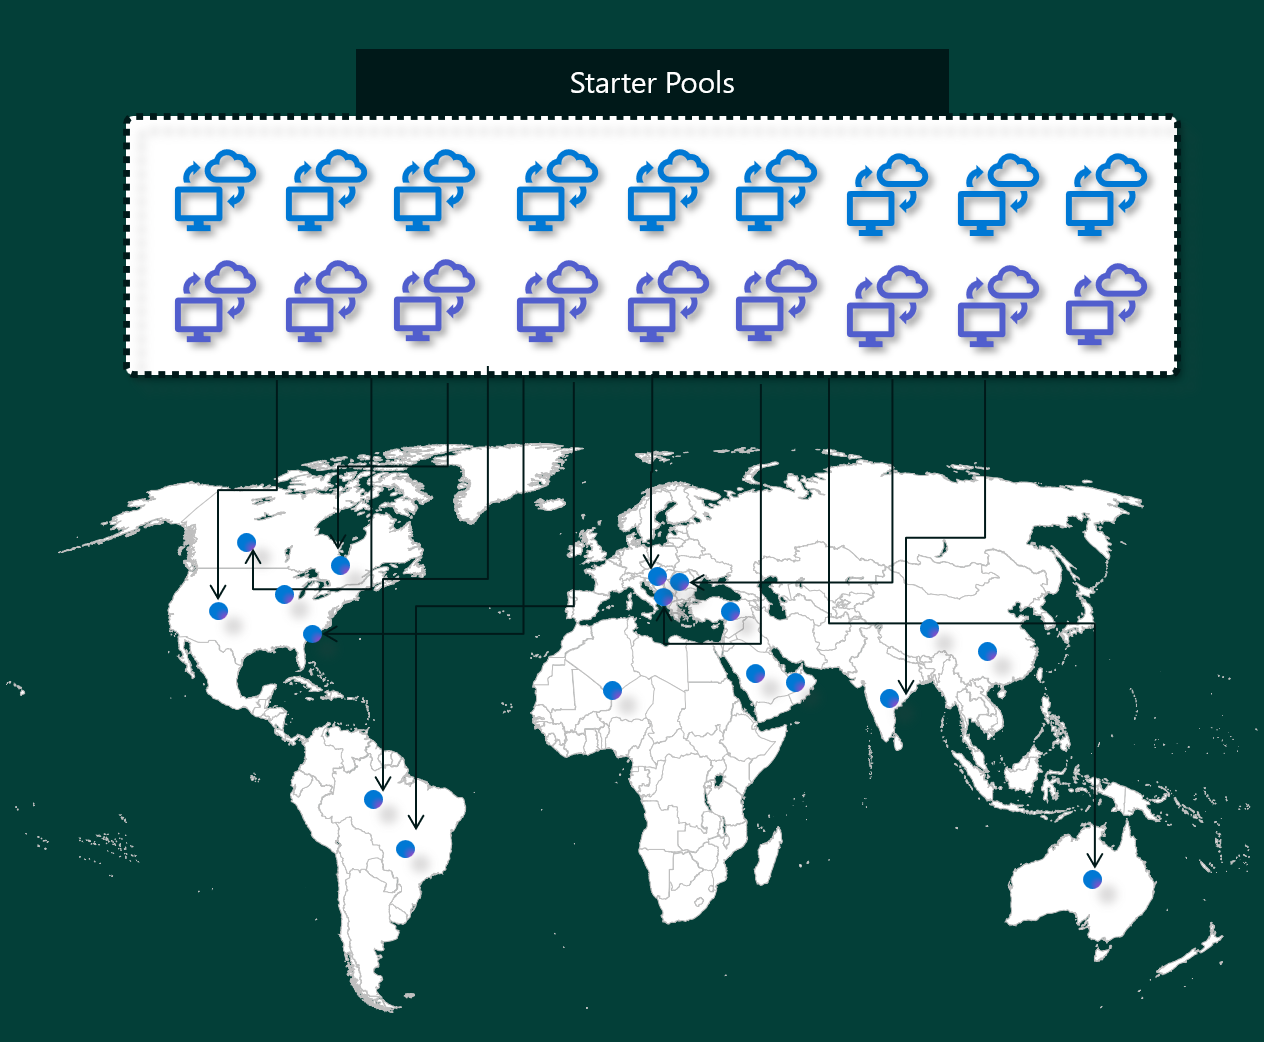
Keď používate štartovací pool bez ďalších knižničných závislostí alebo vlastností Spark, vaša relácia zvyčajne začína za 5 až 10 sekúnd. Tento rýchly startup je možný, pretože klaster je už spustený a nevyžaduje poskytovanie času.
Dôležité
Štartovacie pooly sú optimalizácia založená na najlepšom úsilí spravovaná Microsoftom, ktorá skracuje čas štartu Sparku použitím predhriatej kapacity. Kapacita štartovacieho bazéna nie je zaručená pre každý beh. Keď je k dispozícii predhriata kapacita, sedenia sa zvyčajne môžu začať za pár sekúnd. Keď nie je, Fabric začína reláciu použitím štandardnej kapacity na požiadanie, čo môže trvať dlhšie. Pre záťaže, ktoré vyžadujú konzistentný a predvídateľný začiatok relácie, použite vlastný live pool.
Poznámka
Štartovacie pooly podporujú iba strednú veľkosť uzla. Ak vyberiete inú veľkosť uzla alebo si prispôsobíte výpočtové konfigurácie, Fabric používa spúšťanie relácie na požiadanie, čo môže trvať 2 až 5 minút.
Avšak existuje niekoľko situácií, kedy môže vaša sedenie trvať dlhšie, kým sa začne.
Vlastné knižnice alebo vlastnosti Sparku: Ak ste v prostredí nastavili knižnice alebo nastavenia na vlastné miesto, Spark musí reláciu po vytvorení personalizovať. Dodatočný čas závisí od spôsobu vydávania vo vašej knižnici:
- Rýchly režim: Knižnice sa inštalujú na začiatku relácie. Očakávajte ďalších 30 sekúnd až 5 minút, v závislosti od počtu a veľkosti vašich závislostí.
- Plný režim: Snapshot prostredia sa nasadí na začiatku relácie, zvyčajne pridáva 1 až 3 minúty.
- Plný režim s vlastným živým poolom: Snapshot je už predinštalovaný na hydratovaných klastroch, takže personalizácia knižnice pridáva minimálnu záťaž a relácie môžu začať približne za 5 sekúnd.
Poznámka
Príkazy na inštaláciu priečinka Resources notebooku a inline knižnice (ako %pip installnapríklad ) sú manuálne prístupy pre jednotlivé relácie. Nie sú ovplyvnené publikovaním prostredia a vždy sa inštalujú počas aktívnej relácie.
Štartovacie bazény vo vašom regióne sú plne využité: V zriedkavých prípadoch môžu byť štartovacie pooly regiónu dočasne vyčerpané kvôli vysokej návštevnosti. Keď sa to udeje, fabric roztočí nový klaster, aby vyhovoval vašej žiadosti, čo trvá približne 2 až 5 minút. Keď bude k dispozícii nový klaster, spustí sa vaša relácia. Ak máte aj vlastné knižnice na inštaláciu, pridajte ďalších 30 sekúnd až 5 minút potrebných na personalizáciu.
Pokročilé sieťové alebo bezpečnostné funkcie (súkromné linky alebo spravované VNets): Keď má váš pracovný priestor sieťové funkcie ako Tenant Private Links alebo Managed VNets, štartovacie pooly nie sú podporované. V takejto situácii musí služba Fabric vytvoriť klaster na požiadanie, čo k času spustenia relácie pridá 2 až 5 minút. Ak máte tiež závislosti na knižnici, tento krok personalizácie môže pridať ďalších 30 sekúnd až 5 minút.
Prepitné
Keď potrebujete predvídateľné, rýchle začiatky relácií – napríklad pre plánované definície úloh v Spark alebo iné záťaže citlivé na latenciu – použite vlastný živý pool namiesto spoliehania sa na kapacitu štartovacieho poolu. Vlastné live pooly udržiavajú dedikované klastre teplé podľa harmonogramu, ktorý definujete (aktívne okno), takže relácie začínajú konzistentne približne za 5 sekúnd počas tohto okna. Keďže klastry sú hydratované vopred, vaše knižnice prostredia sú už na klastri predinštalované, čo znižuje čas personalizácie knižníc za každú reláciu.
Tu je niekoľko príkladov scenárov, ktoré znázorňujú potenciálne časy spustenia:
| Scenár | Typický čas spustenia |
|---|---|
| Predvolené nastavenia, žiadne knižnice | 5 – 10 sekúnd |
| predvolených nastavení a závislostí knižnice | 5 – 10 sekúnd + 30 sekúnd – 5 min (pre nastavenie knižnice) |
| veľké prenosy v oblasti, žiadne knižnice | 2 – 5 minút |
| závislostí od vysokej prevádzky a knižnice | 2 – 5 minút + 30 sekúnd – 5 min (pre knižnice) |
| zabezpečenia siete (Private Links/VNet), žiadne knižnice | 2 – 5 minút |
| závislosti zabezpečenia siete a knižnice | 2 – 5 minút + 30 sekúnd – 5 min (pre knižnice) |
Pokiaľ ide o fakturáciu a spotrebu kapacity, za spotrebu kapacity sa účtujú poplatky, keď začnete vykonávať svoj notebook alebo definíciu práce v službe Apache Spark. Za čas, kedy sú klastre nečinné vo fonde, sa vám nebudú účtovať poplatky.
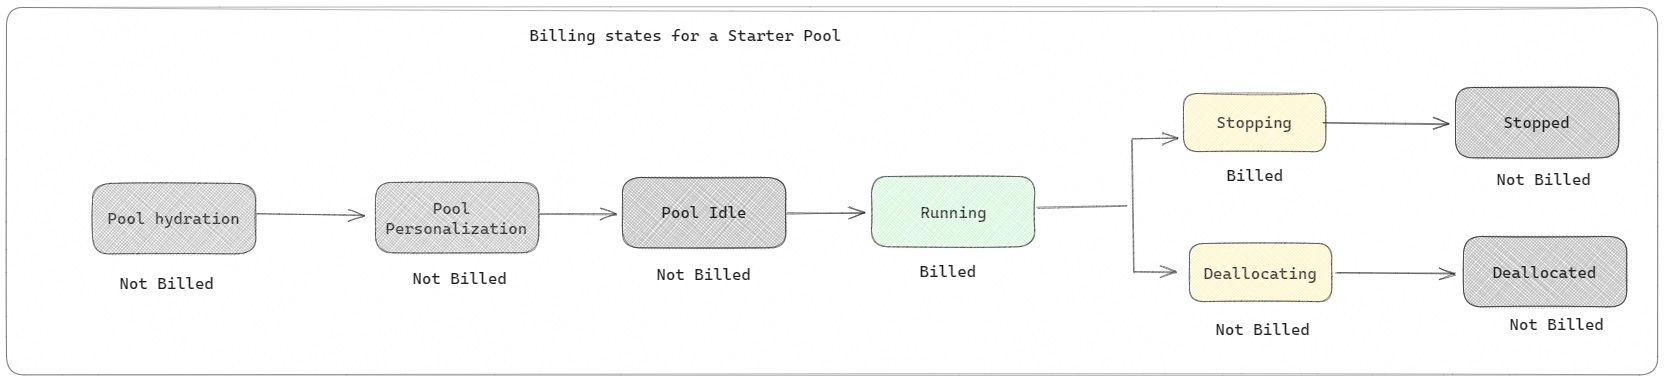
Ak napríklad odošlete úlohu poznámkového bloku do úvodného fondu, účtuje sa len za časové obdobie, počas ktorého je aktívna relácia poznámkového bloku. Fakturovaný čas nezahŕňa voľný čas ani čas potrebný na personalizáciu relácie s kontextom Sparku. Pre viac informácií si pozrite Konfigurácia štartovacích poolov v Fabric.
Bazény Spark
Fond spark je spôsob, ako službe Spark povedať, aký druh zdrojov potrebujete pre svoje úlohy analýzy údajov. Svoj fond Spark môžete pomenovať a vybrať si, koľko a koľko uzlov (pracovné počítače) sú veľké. Službe Spark môžete tiež oznámiť, ako upraviť počet uzlov v závislosti od toho, koľko práce máte. Vytvorenie fondu Spark je bezplatné. Platíte len vtedy, keď spustíte úlohu Spark v bazéne, a potom Spark nastaví uzly za vás.
Ak svoj fond Spark nepoužívate počas 2 minút po uplynutí relácie, váš fond spark sa zruší. Toto predvolené časové obdobie uplynutia platnosti relácie je nastavené na 20 minút a môžete ho podľa potreby zmeniť. Ak ste správcom pracovného priestoru, môžete pre svoj pracovný priestor vytvoriť aj vlastné fondy spark a nastaviť ich ako predvolenú pre ostatných používateľov. Týmto spôsobom môžete ušetriť čas a vyhnúť sa nastaveniu nového fondu Spark zakaždým, keď spustíte poznámkový blok alebo úlohu Spark. Vlastné Spark pooly začínajú asi tri minúty, pretože Spark musí získavať uzly z Azure. Výnimkou je, keď použijete vlastný Spark pool nakonfigurovaný ako vlastný live pool s prostredím plného režimu; V takom prípade môžu relácie začať približne za 5 sekúnd, pretože klaster je už hydratovaný vašou knižnicou.
Môžete dokonca vytvoriť bazény Spark s jedným uzlom nastavením minimálneho počtu uzlov na jeden, takže ovládač a spustiteľný súbor sa spustí v jednom uzle, ktorý je dodávaný s regenerovateľným ha a je vhodný pre malé vyťaženia.
Veľkosť a počet uzlov, ktoré môžete mať vo svojom vlastnom Spark poole, závisí od kapacity vášho Fabric. Kapacita je miera toho, koľko výpočtového výkonu dokážete využiť. Jedným zo spôsobov, ako o tom uvažovať, je, že dve Apache Spark vCore (jednotka výpočtu Sparku) sa rovná jednej kapacitnej jednotke.
Poznámka
V Apache Spark dostanú používatelia dve Apache Spark vCore pre každú kapacitnú jednotku, ktorú si rezervujú ako súčasť svojho SKU. Jedna kapacitná jednotka = dve Spark vCore. Napríklad F64 dáva 128 Spark vCore a 3x burst násobiteľ zvýši túto hodnotu na 384 Spark vCore.
Napríklad kapacita služby Fabric SKU F64 má 64 kapacitných jednotiek, čo zodpovedá 384 spark vcores (64 * 2 * 3x násobok prasknutia). Tieto spark vcores môžete použiť na vytvorenie uzlov rôznych veľkostí pre vlastný fond Spark, ak celkový počet spark vcores nepresiahne 384.
Spark bazény sa účtujú ako štartér bazény; za vlastné fondy Spark, ktoré ste vytvorili, neplatíte, pokiaľ nemáte vytvorenú reláciu služby Spark určenú na spustenie poznámkového bloku alebo definície pracovnej úlohy služby Spark. Účtujete sa len za čas spustenia vašej práce. Po dokončení úlohy sa vám neúčtujú fázy, ako je vytvorenie klastra a kolokácia riešenia.

Ak napríklad odošlete úlohu poznámkového bloku do vlastného fondu Spark, za časové obdobie, keď je relácia aktívna, sa účtuje len. Fakturácia tejto relácie poznámkového počítača sa zastaví alebo uplynie po ukončení alebo uplynutí platnosti relácie služby Spark. Nie ste účtované za čas potrebný na získanie inštancií klastra z cloudu ani za čas potrebný na inicializáciu kontextu služby Spark.
Možné vlastné konfigurácie fondu pre F64 na základe predchádzajúceho príkladu. Menšie veľkosti uzlov majú kapacitu rozmiestnenú na viacerých uzloch, takže maximálny počet uzlov je vyšší. Keďže väčšie uzly sú bohaté na zdroje, preto je potrebných menej uzlov:
| Kapacita tkaniny SKU | Kapacitné jednotky | Max Spark VCores s burst factor | Veľkosť uzla | Maximálny počet uzlov |
|---|---|---|---|---|
| F64 | 64 | 384 | Malé | 96 |
| F64 | 64 | 384 | Stredné | 48 |
| F64 | 64 | 384 | Veľké | 24 |
| F64 | 64 | 384 | X-Large | 12 |
| F64 | 64 | 384 | XX-veľké | 6 |
Poznámka
Na vytvorenie vlastných poolov potrebujete administrátorské oprávnenia pre pracovný priestor. Správca kapacity Fabric musí tiež udeliť oprávnenia, ktoré umožňujú administrátorom pracovného priestoru dimenzovať vlastné Spark pooly. Ak sa chcete dozvedieť viac, pozrite si Začnite s vlastnými Spark bazénmi v Fabric.
Uzly
Inštancia Apache Spark poolu pozostáva z jedného hlavného uzla a jedného alebo viacerých pracovných uzlov. Inštancia Spark môže začať s minimálne jedným uzlom. Hlavný uzol spúšťa manažérske služby ako Livy, YARN Resource Manager, ZooKeeper a ovládač Apache Spark. Všetky uzly spúšťajú služby ako Node Agent a YARN Node Manager. Všetky uzly pracovníkov spúšťajú službu Apache Spark Executor.
Poznámka
V Fabrice je pomer uzlov k exekutorom vždy 1:1. Keď nastavíte fond, jeden uzol je vyhradený pre ovládač a zvyšné uzly sa použijú pre executory. Jedinou výnimkou je konfigurácia s jedným uzlom, kde sú prostriedky pre ovládač aj executor polovičné.
Veľkosti uzla
Fond Spark možno definovať s veľkosťami uzla, ktoré siahajú od malého výpočtového uzla (so 4 virtuálnym jadrom a 32 GB pamäte) až po dvojitý veľký výpočtový uzol navyše (so 64 virtuálnymi jadrami a 512 GB pamäte na uzol). Veľkosti uzla možno zmeniť po vytvorení fondu, hoci by sa aktívna relácia musela reštartovať.
| Veľkosť | virtuálne jadro | Pamäť |
|---|---|---|
| Malé | 4 | 32 GB |
| Stredné | 8 | 64 SK |
| Veľké | 16 | 128 SK |
| X-Large | 32 | 256 SK |
| XX-veľké | 64 | 512 SK |
Poznámka
Veľkosti uzla X-Large a XX-Large sú povolené len pre skladové jednotky SKU nesú skúšobnej verzie služby Fabric.
Automatické škálovanie
Automatické škálovanie pre fondy Apache Spark umožňuje automatické zvýšenie a zníženie výpočtových prostriedkov na základe objemu aktivity. Keď povolíte funkciu automatického škálovania, nastavíte minimálny a maximálny počet uzlov na škálovanie. Keď vypnete funkciu automatického škálovania, počet množiny uzlov zostáva pevný. Toto nastavenie môžete zmeniť po vytvorení fondu, aj keď možno budete musieť reštartovať inštanciu.
Poznámka
V predvolenom nastavení je nastavenie spark.yarn.executor.vyradenie.povolené na hodnotu true. Umožňuje automatickému vypnutiu nedostatočne vytvorených uzlov optimalizovať výpočtovú efektivitu. Ak sa uprednostňuje menej agresívne škálovanie, táto konfigurácia môže byť nastavená na hodnotu false
Dynamická alokácia
Dynamická alokácia umožňuje aplikácii Apache Spark požiadať o viac spúšťačov v prípade, že úlohy presiahnu zaťaženie, ktoré môžu znášať aktuálni vykonávatelia. Po dokončení úloh sa tiež uvoľnia vykonávatelia a ak sa aplikácia Spark presunie do stavu nečinnosti. Pre podnikových používateľov je často ťažké vyladiť konfigurácie vykonávača, pretože sa výrazne líšia v rôznych fázach procesu vykonávania úloh v službe Spark. Tieto konfigurácie závisia aj od objemu spracovaných údajov, ktorý sa z času na čas mení. Možnosť dynamického prideľovania vykonávateľov môžete povoliť ako súčasť konfigurácie fondu, ktorá umožňuje automatické prideľovanie vykonávateľov do aplikácie Spark na základe uzlov dostupných vo fonde spark.
Keď povolíte dynamickú možnosť prideľovania pre každú odoslaovú aplikáciu Spark, systém vyhradzuje vykonávateľov počas kroku odosielania úloh na základe minimálnych uzlov. Ak chcete podporovať úspešné scenáre automatickej škály, zadajte maximálne uzly.