Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Azure NetApp Files
Microsoft Fabric
Azure AI-sökning
Microsoft Foundry
Azure Machine Learning
Lösningsidéer
I den här artikeln beskrivs en lösningsidé. Molnarkitekten kan använda den här vägledningen för att visualisera huvudkomponenterna för en typisk implementering av den här arkitekturen. Använd den här artikeln som utgångspunkt för att utforma en välstrukturerad lösning som överensstämmer med arbetsbelastningens specifika krav.
Den här lösningsidén beskriver hur Azure NetApp Files Object REST API hjälper organisationer att använda befintliga företagsfildata för analys och AI utan att först kopiera dem till ett separat objektlager. Amazon S3-kompatibla program kan stödja dokumentsökning och AI-assisterad analys medan befintliga NFS- och SMB-arbetsflöden fortsätter att komma åt dessa data. Om du undviker en separat kopiering av källdata kan du minska tiden för att driftsätta analysarbetslaster, minska dubbla lagringskostnader och ta bort de synkroniseringspipelines som teamen annars skulle skapa, övervaka och felsöka. Färre källdatalagringsplatser innebär också färre kopior att hantera och skydda. Den här metoden stöder inkrementell modernisering utan att kräva att organisationer ersätter sina befintliga filbaserade program.
Architecture
Den här arkitekturen fokuserar på Microsoft Fabric integrering med Azure NetApp Files via REST API för objekt. Diagrammet visar också Azure Databricks som en alternativ analyskonsument av samma Azure NetApp Files data. Du behöver inte distribuera båda plattformarna. Befintliga program fortsätter att komma åt data via NFS eller SMB, beroende på volymkonfiguration och klientkrav.
Azure Databricks beräkningsresurs har åtkomst till Azure NetApp Files REST API-slutpunkten för objekt via S3-kompatibla begäranden med hjälp av Hadoop S3A-kopplingen. Den här alternativa analyssökvägen använder inte den lokala datagatewayen för lokal installation eller Microsoft OneLake.
AI-tjänsterna nedströms i diagrammet är illustrativa. Deras integrering för import visas inte.
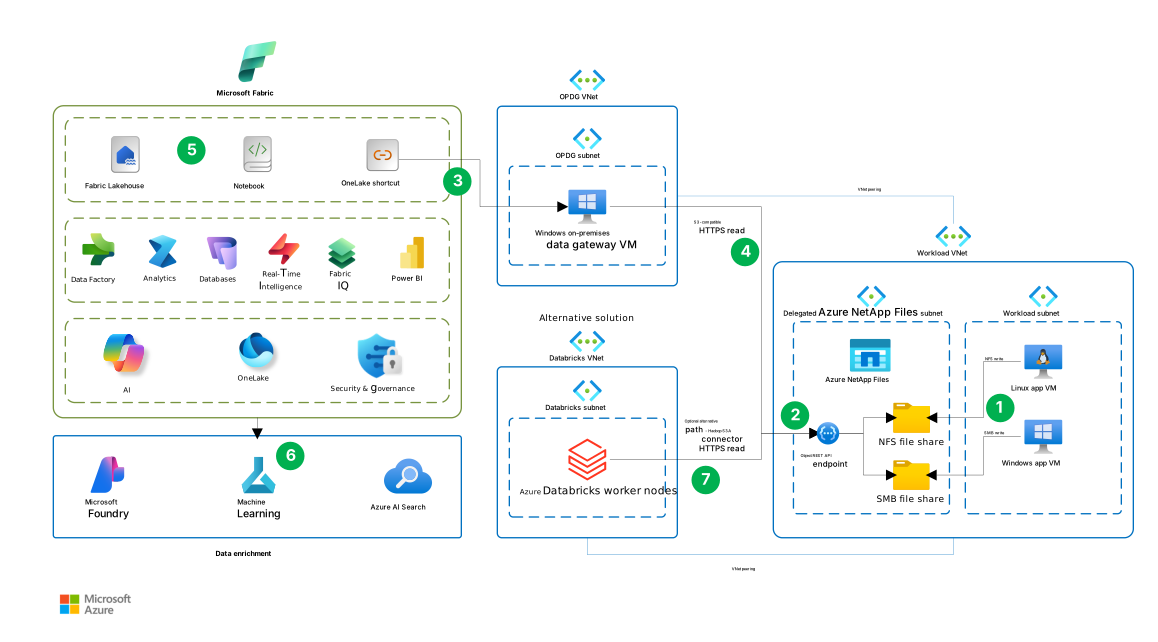
Ladda ned en Visio-fil av den här arkitekturen.
Dataflöde
Följande numrerade interaktioner beskriver arkitekturdiagrammet. Steg 1 till och med 5 beskriver den primära Microsoft Fabric-vägen. Steg 6 representerar valfri nedströms databerikning. Steg 7 är en alternativ analysväg, inte en fortsättning på Fabric flödet. Pilarna som är märkta HTTPS read visar begäranden mot rest-API-slutpunkten för objekt. De begärda uppgifterna returneras till konsumenten.
Program skriver fildata. I Workload-undernätet skriver Linux-program-VM:n till NFS-filresursen och Windows-program-VM:n skriver till SMB-filresursen. Azure NetApp Files är värd för båda resursdelningarna i det delegerade undernätet.
Rest-API:et för objekt exponerar fildata. Slutpunkten i det delegerade ANF-undernätet ger S3-kompatibel åtkomst till konfigurerade kataloger på Azure NetApp Files volymer. Anslutningarna från slutpunkten till NFS- och SMB-resurserna representerar åtkomst till befintliga data, inte en kopia till ett separat objektlager.
Fabric kommer åt data via en OneLake-genväg. Genvägen refererar till Azure NetApp Files data via en anslutning som använder Windows-VM för lokal datagateway i undernätet OPDG (lokal datagateway). OneLake-genvägen är ansluten till den här gatewayen.
gatewayen läser från Object REST API. Gatewayen använder peering mellan OPDG VNet och Workload VNet för att nå slutpunkten. Den S3-kompatibla HTTPS-läsvägen ansluter gatewayen till slutpunkten, som kommer åt de refererade fildata för Fabric. Se Ansluta OneLake till en Azure NetApp Files volym för anslutningskraven.
Fabric bearbetar och analyserar data. Fabric-arbetsbelastningar som stöds använder data via genvägen. Anteckningsböcker läser till exempel de refererade filerna och skriver härledda resultat till lakehouse-tabeller för analys och Power BI-rapportering. Rutan Fabric i diagrammet visar dessa bearbetnings- och analysfunktioner.
Valbara nedströmstjänster berikar data. Pilen under Fabric leder till gruppen Databerikning, som innehåller Microsoft Foundry, Azure Machine Learning och Azure AI-sökning. Det här steget representerar valfri nedströmsbearbetning. Diagrammet visar inte den datainhämtning eller orkestrering som krävs för att ansluta dessa tjänster, och OneLake-genvägen skapar inte dessa integrationer.
Alternativt kan Azure Databricks läsa fildata direkt. Arbetsnoder i Databricks-undernätet använder Hadoop S3A-anslutningen för att skicka HTTPS-läsbegäranden till samma Object REST API-slutpunkt över peerkopplade virtuella nätverk. Den här vägen ersätter Fabric-vägen för åtkomst och bearbetning i steg 3–5. Den går inte via den lokala datagatewayen eller OneLake.
Välj genvägsplatsen baserat på hur du tänker ta del av data:
- Befintliga kompatibla Delta-tabeller. Skapa en tabellgenväg i avsnittet Tabeller i Lakehouse och rikta in dig på den fullständiga Delta-tabellen, inklusive transaktionsloggen. Fabric identifierar målet som en tabell som du kan köra frågor mot via Spark och SQL-analysslutpunkten, medan källdata finns kvar på Azure NetApp Files.
- Filer för direkt åtkomst eller bearbetning. Skapa genvägar i lakehousets avsnitt Filer. Kompatibla arbetsbelastningar kan läsa fristående Parquet-, CSV- och JSON-filer, utöver dokument, utan att först kopiera källfilerna till OneLake. När nedströmsanalys kräver lakehouse-tabeller omvandlar eller läser du in källdata till härledda Delta-tabeller i OneLake.
Fristående Parquet-filer är inte automatiskt Delta-tabeller. En genväg i Filer registrerar inte automatiskt målet som en tabell. Mer information finns i Var du ska placera genvägar i ett lakehouse.
Components
Följande komponenter stöder den Fabric-fokuserade arkitekturen och det valfria Azure Databricks-alternativet.
Azure NetApp Files är en fullständigt hanterad fillagringstjänst som bygger på NetApp-teknik. I den här arkitekturen lagrar systemet företagets datamängd och tillhandahåller NFS-, SMB- och S3-kompatibel objektåtkomst via Object REST-API:et. Det ger också funktioner för ögonblicksbilder och replikering.
Azure NetApp Files Object REST API exponerar befintliga fildata via ett S3-kompatibelt gränssnitt. I den här arkitekturen gör det möjligt för kompatibla analys- och AI-program att komma åt data utan att först skapa en separat objektlagringskopia. Gränssnittet stöder en delmängd av Amazon S3-åtgärder. Kontrollera att de funktioner som stöds uppfyller applikationens krav innan du väljer den här integrationen.
Microsoft Fabric är en analysplattform som förenar dataflytt, databearbetning, datainhämtning, transformering, dataströmbearbetning via Real-Time Intelligence och rapportskapande. I den här arkitekturen tillhandahåller den en analysplattform för att bearbeta och analysera data från Azure NetApp Files via OneLake-genvägar.
OneLake är den enhetliga logiska datasjön för Fabric. I den här arkitekturen gör OneLake-genvägar att de Azure NetApp Files-data som de refererar till blir tillgängliga för Fabric-arbetsbelastningar som stöds.
Azure Virtual Network tillhandahåller privata anslutningar mellan de Azure resurserna i den här arkitekturen. Med peering för virtuella nätverk kan den virtuella gatewaydatorn och valfria Azure Databricks-beräkningsresurser nå slutpunkten för Azure NetApp Files Object REST API.
En lokal datagateway ansluter OneLake-genvägar till Azure NetApp Files bucketslutpunkt. Trots namnet körs gatewayen i standardläge på en Azure virtuell dator med ett Windows operativsystem som stöds. Välj en image som uppfyller kraven för installation av gatewayen. Server Core-installationer och Windows containrar stöds inte. Gatewayen initierar utgående anslutningar via Azure Relay för att kommunicera med Fabric. Inga inkommande anslutningar från Fabric krävs. Konfigurera brandväggen eller proxyn så att de utgående slutpunkterna som beskrivs i Justera kommunikationsinställningar för den lokala datagatewayen tillåts.
Azure Databricks är ett valfritt alternativ som analysplattform för arbetsbelastningar för datateknik och maskininlärning. Dess Spark-jobb använder Hadoop S3A-anslutningen som konfigurerats för objekt-REST API-slutpunkten för att komma åt Azure NetApp Files-datauppsättningen i stället för att använda Fabric-integrationssökvägen.
Alternatives
Den här arkitekturen innehåller flera komponenter som du kan ersätta med andra Azure-tjänster eller -metoder, beroende på arbetsbelastningens funktionella och icke-funktionella krav. Överväg följande alternativ och deras kompromisser.
Storage
Överväg programmens protokollkrav och uppmätta prestanda när du väljer mellan Azure Blob Storage och Azure NetApp Files:
Välj Blob Storage när klienter kan använda Blob Storage REST API eller NFS 3.0 och inte kräver SMB eller NFS 4.1. Båda gränssnitten har åtkomst till samma data. Åtkomstsökvägen Blob Storage NFS 3.0 är optimerad för hög dataflöde, läsintensiva sekventiella arbetsbelastningar där dataflödet är viktigare än låg svarstid.
Välj Azure NetApp Files när applikationer och analysarbetslaster behöver få åtkomst till samma filer via SMB eller NFS 4.1 och det S3-kompatibla Object REST API:et, eller när filbaserade applikationer kräver slumpmässiga I/O-operationer med låg latens. För data som redan finns på Azure NetApp Files ger REST-API för objekt analysåtkomst utan att migrera källapplikationer eller data.
För båda alternativen, mät latens från slutpunkt till slutpunkt och genomströmning under samtidig belastning från källapplikation och analys. NFS- eller SMB-prestanda är inte representativ för prestandan hos Object REST API eller Fabric, så testa den avsedda åtkomstvägen mot arbetsbelastningens krav. Jämför totala kostnader, inklusive programändringar, migrering och eventuell pågående duplicering och synkronisering. En jämförelse av protokoll och arbetsbelastningar finns i Jämföra Azure lagringstjänster.
Integration
Azure Databricks-jobb kan använda Hadoop S3A-konnektorn för att läsa Azure NetApp Files-data via REST API för objekt, utan OneLake eller den lokala datagatewayen. Konfigurera TLS-förtroende och säkert lagrade autentiseringsuppgifter och verifiera nödvändiga skrivåtgärder innan du förlitar dig på tillbakaskrivning. Om du behöver initieringsskript använder du klusteromfattande skript som lagras i Unity Catalog-volymer på beräkning som stöds, enligt den aktuella vägledningen för init-script i Azure Databricks.
Scenario-information
Använd det här mönstret när samma datauppsättning måste betjäna applikationer som förväntar sig ett monterat filsystem och analys- eller AI-tjänster som förväntar sig ett S3-kompatibelt objektgränssnitt.
Program som körs på virtuella datorer eller i containrar kan fortsätta att använda Azure NetApp Files via NFS eller SMB. De kan till exempel använda befintlig filåtkomstkod, monterade delningar och katalogstrukturer. REST API för Azure NetApp Files-objekt mappar en volyms rotkatalog eller en underkatalog till en S3-kompatibel bucket så att kompatibla objektklienter kan komma åt samma underliggande filer.
Den här metoden är användbar när du vill lägga till analys- eller AI-funktioner i befintliga filbaserade arbetsbelastningar utan att ändra källprogrammen så att de använder objektlagring. Efterföljande arbetsflöden kan fortfarande skapa härledda data, till exempel transformerade datauppsättningar, index, inbäddningar och cacheminnen efter behov.
När fil- och objektklienter får åtkomst till samma data, ta hänsyn till skillnader i krav på identitet, behörigheter, låsning och programkonsistens. Definiera hur producenter signalerar att en fil eller batch är klar innan objektkonsumenterna bearbetar den. Producenter bör skriva klart och stänga filer innan de signalerar att de är redo och lämna filerna oförändrade medan konsumenterna bearbetar dem. Testa det här övertagandet för avbrutna skrivningar och omförsök för bearbetning.
Identitets- och auktoriseringsmodellerna skiljer sig också åt mellan olika åtkomstmetoder. Ursprungliga filbehörigheter per användare överförs inte automatiskt till Fabric. Konfigurera Fabric behörigheter för de avsedda konsumenterna och se till att den identitet som används av rest-API:et för objekt endast har åtkomst till nödvändiga källdata. Mer information finns i Security.
Mappa kataloger till separata buckets när användare behöver olika behörighetsnivåer. Dataklassificering, kvarhållning, nedströmsauktorisering och styrning av härledda data är arbetsbelastningens ansvar. Mer information finns under Skapa en hink.
Potentiella användningsfall
Den här arkitekturen kan stödja arbetsbelastningar som behöver analysera strukturerade eller ostrukturerade data som redan lagras i Azure NetApp Files. Följande exempel illustrerar olika sätt som Fabric kan använda dessa data på.
Dokumentbearbetning
Applikationer kan spara dokument, bilder eller andra ostrukturerade filer i Azure NetApp Files via NFS eller SMB. En Fabric notebook-fil kan läsa slutförda filer med hjälp av en OneLake-genväg och skicka innehållet till en dokumentbearbetningstjänst, till exempel Azure Document Intelligence, för extrahering. Lagra resulterande strukturerade data i lakehouse-tabeller för validering, analys och rapportering.
Information om integrering finns i integrering av Document Intelligence via SynapseML.
Datanalys
Program kan skriva strukturerade data, till exempel CSV- eller Parquet-filer, till en Azure NetApp Files-resursdelning. Fabric-notebookar kan läsa slutförda filer med hjälp av OneLake-genvägen, kombinera dem med andra lakehouse-data och skriva härledda resultat till lakehouse-tabeller.
Det här mönstret kan användas för scenarier som teknisk analys och kvalitetsanalys, analys av sensordata samt driftrapportering, utan att källapplikationerna behöver ändra hur de lagrar sina filer.
För befintliga kompatibla Delta-datauppsättningar skapar du en OneLake-genväg i lakehouse-objektets avsnitt Tabeller som pekar på hela Delta-tabellen, inklusive dess transaktionslogg. Fabric kan sedan identifiera målet som en tabell och källdata kan finnas kvar på Azure NetApp Files. Mer information finns i Var du placerar genvägar i ett lakehouse.
AI-sökning och hämtning
Dokument som finns lagrade på Azure NetApp Files kan också användas som källinnehåll för AI-arbetsbelastningar. Ett arbetsflöde för bearbetning kan till exempel läsa dokument via Genvägen OneLake och använda dem för att skapa ett Azure AI-sökning-index för retrieval-augmented generation (RAG).
Sökindexet och eventuella inbäddningar är härledda data och lagras separat från källfilerna. Utforma arbetsflödet så att indexerat innehåll synkroniseras med källuppdateringar, namnbyten och borttagningar. Tillämpa även lämpliga åtkomstkontroller när du hämtar indexerat innehåll eftersom de ursprungliga SMB- och NFS-behörigheterna inte automatiskt blir sökbehörigheter per användare.
Samma mönster kan utökas till andra AI-arbetsbelastningar. Till exempel kan Fabric-notebooks förbereda datauppsättningar från källfiler och lagra förberedda data i OneLake för förbrukning av Azure Machine Learning. Integreringsalternativ och begränsningar finns i Integrera OneLake med Azure Machine Learning.
Considerations
Dessa överväganden implementerar grundpelarna i Azure Well-Architected Framework, som är en uppsättning vägledande grundsatser som du kan använda för att förbättra kvaliteten på en arbetsbelastning. Mer information finns i Well-Architected Framework. Mer vägledning finns i Well-Architected Framework-rekommendationer för Azure NetApp Files.
Reliability
Tillförlitlighet hjälper till att säkerställa att ditt program kan uppfylla de åtaganden som du gör gentemot dina kunder. Mer information finns i Checklista för designgranskning för tillförlitlighet.
Azure NetApp Files körs på en feltolerant bare metal-flotta som drivs av ONTAP och tillhandahåller ett SLA för hög tillgänglighet. För ytterligare skydd mot driftstörningar i tillgänglighetszoner eller regioner kan du vid behov konfigurera replikering över zoner eller regioner. Den här replikeringen är asynkron och kräver kundinitierad växling vid fel till målvolymen. Välj replikeringsalternativet och schemalägg enligt arbetsbelastningens återställningsmål. Mer information finns i Azure NetApp Files-tillförlitlighet.
Att dela en datauppsättning gör också att lagring är tillgänglig till ett gemensamt beroende för filapplikationer och analys. Dessa lagringsfunktioner etablerar inte tillgänglighet från ände till ände för gatewayen, indexeringspipelinen eller klientprogram. Anpassa återställningsmålen efter den fullständiga arbetsbelastningen, inklusive gatewayen, nedströmsbearbetning och härledda data.
En enskild virtuell gateway-dator är en enkel felpunkt för Fabric-integreringssökvägen. För affärskritiska arbetsbelastningar distribuerar du minst två gatewaymedlemmar på separata virtuella datorer i ett gatewaykluster. Se till att varje medlem kan nå slutpunkten för Object REST API och upprätta de utgående anslutningar som krävs. Testa arbetslastens beteende när en medlem i gatewayen blir otillgänglig.
- Fil- och volymåterställning stöds via utrymmeseffektiva tidpunktsbilder. Teams kan återställa en enskild fil, återställa en hel volym eller skapa en ny volym från en återställningspunkt efter oavsiktlig borttagning, korruption eller en misslyckad analysprocess. Information om tillgängliga återställningsåtgärder finns i Azure NetApp Files ögonblicksbildsbaserade dataskydd.
Security
Säkerhet ger garantier mot avsiktliga attacker och missbruk av dina värdefulla data och system. Mer information finns i Checklista för designgranskning för säkerhet.
Att behålla färre kopior av källdata kan minska antalet repositorier som behöver skyddas. Azure NetApp Files krypterar data i vila, och REST-API för objektlagring använder TLS för att skydda data under överföring. Behörigheter för filåtkomst beror på protokollet:
SMB- och NFS-klienter fortsätter att använda sina befintliga autentiserings- och auktoriseringsmodeller. Befintliga NTFS-åtkomstkontrollistor (ACL:er), NFS-behörigheter och regler för identitetsmappning gäller fortfarande för dessa klienter.
Rest API-objektklienter autentiserar med hjälp av en S3-åtkomstnyckel. Bucketbehörigheter definierar om klienten har skrivskyddad eller läs- och skrivåtkomst i den mappade katalogen. Objektbegäranden innehåller inte identiteten för den enskilda SMB-, NFS- eller nedströmsanvändaren. Azure NetApp Files utför varje objektåtgärd med bucketens konfigurerade personifierade filsystemsidentitet. Befintliga filbehörigheter och ACL:er utvärderas endast för den identiteten.
Den imiterade filsystemidentiteten är ett användar-ID (UID) och grupp-ID (GID) för NFS-volymer eller ett användarkonto för SMB-volymer. Volymer med dubbla protokoll använder den identitetstyp som matchar deras konfigurerade säkerhetsstil. Den här identiteten avgör behörigheter för filåtkomst. S3-åtkomstnyckeln autentiserar objektklienten. Mer information finns i Säkerhet och behörigheter för REST API för objekt.
En OneLake S3-kompatibel genväg autentiserar sig mot bucketen med hjälp av ett åtkomstnyckel-ID och en hemlig åtkomstnyckel. Käll-NTFS-ACL:er, NFS-behörigheter och enskilda filägaridentiteter kopieras inte eller mappas inte till OneLake. Fabric användare auktoriseras via OneLake- och Fabric-behörigheter. De kan bara komma åt innehållet som exponeras för genvägen via bucketen och dess imiterade identitet, men OneLake tillämpar inte de ursprungliga filbehörigheterna per användare. OAuth baserat på Microsoft Entra, tjänstobjekt och RoleArn stöds inte för den här genvägstypen.
Till exempel kanske en Fabric-användare kan läsa ett dokument med hjälp av genvägen även när deras personliga SMB-konto inte kan läsa det direkt, om Fabric-behörigheter tillåter åtkomst och den impersonerade identiteten för bucketen kan läsa dokumentet. Innan du exponerar en katalog kontrollerar du att den avsedda Fabric målgruppen har behörighet att komma åt dess innehåll.
Konfigurera bucketens personifierade identitet med endast de källbehörigheter som arbetsbelastningen kräver. Begränsa åtkomsten till genvägen och lakehouse. Använd Azure Key Vault-baserat certifikatarbetsflöde och Azure Key Vault-baserad lagring av autentiseringsuppgifter för att hantera TLS-certifikat och S3-åtkomstnycklar. Definiera och testa en rotationsprocedur som samordnar ändringar av certifikat och autentiseringsuppgifter med uppdateringar av Fabric anslutningar och andra konsumenter. Om du genererar nya bucketautentiseringsuppgifter ogiltigförklaras det befintliga paret omedelbart, så planera för avbrott när du uppdaterar konsumenter och verifiera åtkomsten efter rotationen.
Om du använder ett självsignerat TLS-certifikat kontrollerar du att alla gatewayvärdar litar på det. Mer information finns i artikeln Förutsättningar för OneLake-gateway.
Säkerhet och efterlevnad beror på konfigurationen av lagring, åtkomst och efterföljande tjänster. Inkludera nedströmsbearbetning och härledda data i omfattningen för styrning och efterlevnad. Krav som GDPR och HIPAA gäller för den fullständiga arbetslasten, i förekommande fall. Mer information finns i Säkerhet och behörigheter för Object REST API och Skapa en Amazon S3-kompatibel genväg i OneLake.
Kostnadsoptimering
Kostnadsoptimering fokuserar på sätt att minska onödiga utgifter och förbättra drifteffektiviteten. Mer information finns i Checklista för designgranskning för kostnadsoptimering.
Om du undviker en separat kopiering av källdata kan du minska kostnaderna för duplicerad lagring och synkronisering. Balansera dessa besparingar mot Azure NetApp Files kapacitets- och prestandakostnader, gateway-beräkning, Fabric kapacitet samt nedströmsbearbetning och lagring.
I prisuppskattningen i det här exemplet ingår en kapacitetspool med 1 TiB Azure NetApp Files Standard, en virtuell Windows D8s_v5-dator för den lokala datagatewayen, två 128-GiB P10-hanterade diskar, en NAT-gateway med en offentlig IP-adress och utgående databearbetning, Fabric F2-kapacitet och 100 GB intern OneLake-lagring.
Konfigurationen med en enda gateway är inte högtillgänglig. Valfria AI-sökningar, inbäddningstjänster och Azure Databricks-kostnader ingår inte. Justera resurserna utifrån arbetsbelastningens krav på kapacitet, nätverk och tillgänglighet.
Lågfrekvent åtkomst: Flytta inaktiva datablock, inklusive ögonblicksbildsdata, till lagring med lägre kostnad samtidigt som fil- och objektåtkomst bevaras. Utvärdera ändringar av hämtningsavgifter, svarstid och servicenivåspecifikt dataflöde mot arbetsbelastningens åtkomstmönster.
Tjänstnivåer och högerstorlek: Välj en Azure NetApp Files tjänstnivå som matchar datauppsättningens kapacitets- och dataflödeskrav. Tjänstnivån Flexible gör att du kan provisionera poolkapacitet och dataflödeskapacitet oberoende av varandra. Granska fakturerbar poolkapacitet och genomströmning när efterfrågan ändras för att undvika beständig överprovisionering.
Operativ skicklighet
Operational Excellence omfattar de driftsprocesser som distribuerar ett program och håller det igång i produktion. Mer information finns i Checklista för designgranskning för Operational Excellence.
OneLake-genvägar minskar driftskomplexiteten genom att undvika en pipeline som underhåller en separat källdatakopia för analys. Utan en separat kopieringspipeline behöver team inte schemalägga kopieringsjobb, återhämta sig från överföringsfel eller stämma av källdata och kopierade data som en del av den löpande driften.
Källapplikations- och analysteam måste samordna ändringar och incidentrespons för den delade datauppsättningen i Azure NetApp Files. Fastställ ansvar för övervakning, bearbetningsfel och hantering av autentiseringsuppgifter och certifikat för Object REST API.
Övervaka lagring, gateway och Fabric-prestanda för att identifiera flaskhalsar och justera kapacitet eller genomströmning:
Använd Azure Monitor för att spåra läs- och skrivgenomströmning för volym, läs- och skriv-IOPS, annan IOPS, genomsnittlig svarstid för läsning och skrivning, kapacitetsförbrukning och indikatorn för att genomströmningsgränsen har nåtts. Avisera vid ihållande ökningar i latenstid, upprepad QoS-begränsning och kapacitetströskelvärden i stället för enstaka toppar; måttvärden för Azure NetApp Files aggregeras över intervall och lagringslatens inkluderar inte alla REST-komponenter på klientsidan.
Korrelera lagringsmått med mätvärden på klientsidan, till exempel percentiler för begärandelatens, objektstorlek, samtidighet, återförsök, HTTP-statuskoder, CPU, minne och nätverksgenomströmning. Detta skiljer en volymgenomflödesgräns från en underdimensionerad beräkningsklient, ineffektiva SDK-inställningar, små objektomkostnader eller nätverksavstånd.
Övervaka varje virtuell gatewaydators CPU, minne, tillgängligt diskutrymme och nätverksdataflöde tillsammans med gatewayfel och arbetsbelastningsavslutstider. Konfigurera aviseringar för ihållande resursbelastning och lågt diskutrymme, med hjälp av tröskelvärden som fastställts under tester med representativa arbetsbelastningar. Använd gatewaydiagnostikloggar vid felsökning av fel eller långsam åtkomst. Övervaka den virtuella datorn och nätverket separat eftersom gatewaydiagnostik inte ger fullständig infrastrukturtäckning.
Övervaka Fabric kapacitetsanvändning och begränsning med Fabric Capacity Metrics-appen. Konfigurera meddelanden om kapacitetsanvändning för ansvariga administratörer. Korrelera kapacitetsanvändning med gateway- och lagringsmätningar för att identifiera om fördröjningar har sitt ursprung i källåtkomst eller Fabric bearbetning innan kapaciteten ändras.
Prestandaeffektivitet
Prestandaeffektivitet syftar på arbetsbelastningens förmåga att skala för att effektivt uppfylla användarnas krav. För mer information, se Designgranskningschecklistan för prestandaeffektivitet.
Azure NetApp Files kan stödja både svarstidskänsliga NFS- eller SMB-program och S3-kompatibla analys- eller AI-arbetslaster som använder samma datauppsättning. Om du behåller källdata på en volym kan du ta bort kopieringssteget som annars skulle fördröja indexering, träning eller batchbearbetning och förbruka bandbredd för klient, nätverk och mållagring.
Lagringsfördröjning på under en millisekund på Azure NetApp Files-tjänstnivåer som stöds är mest relevant för NFS- och SMB-arbetsbelastningar. Den garanterar inte latens från slutpunkt till slutpunkt för REST API-begäranden för HTTPS-objekt. Prestandatesta den S3-kompatibla åtkomstsökvägen med representativa objekt och samtidighet innan du anger ett svarstidsmål.
Dimensionering av lagring: Dimensionera genomströmningen för den kombinerade efterfrågan för filprogram och objektkonsumenter. Automatisk QoS kopplar volymgenomflödet till volymkvoten. Manuell QoS möjliggör separat tilldelning inom poolens genomströmningsbudget. Mät representativa arbetslaster innan du justerar prestandan.
Dimensionering av gateway: Dimensionera de virtuella gateway-datorerna utifrån det sammanlagda behovet från arbetsbelastningar som får åtkomst till Azure NetApp Files via OneLake-genvägar. Använd storleks- och skalningsvägledning för gateway som utgångspunkt. Verifiera dimensioneringen med representativa datavolymer och samtidig åtkomst med hjälp av genvägarna. Mät gatewayens processor-, minnes- och nätverksdataflöde tillsammans med arbetsbelastningens slutförandetider för att avgöra om du vill öka resurserna för virtuella datorer eller lägga till gatewaymedlemmar.
Storleksbestämning av Fabric-kapacitet: Storleksbestäm Fabric-kapaciteten för den kombinerade bearbetnings- och rapporteringsarbetsbelastningen, inklusive Power BI. Följ riktlinjerna i Fabric guide för kapacitetsplanering för att uppskatta den inledande kapaciteten, testa med ett representativt pilottest och justera kapaciteten baserat på uppmätt användning och begränsning.
Placera beräkning nära volymen, dimensionera klientnätverket på lämpligt sätt och testa med den verkliga arbetsbelastningen. Öka parallelliteten och använd lämpligt stora förfrågningar för sekventiell analys, men begränsa samtidigheten när svarstiden eller felen ökar. För NFS eller SMB, verifiera inställningar för montering, protokoll och program. För REST ska du kontrollera stöd för de API-åtgärder som klienten kräver och testa återanvändning av anslutningar, uppladdningsbeteende, återförsök och objektlistning.
Verifiera dataflöde och svarstid från slutpunkt till slutpunkt vid samtidig belastning och balansera analysbehovet med källapplikationens prestandakrav.
Contributors
Microsoft underhåller den här artikeln. Följande bidragsgivare skrev den här artikeln.
Huvudsakliga författare:
- Dan Jackson | Cloud Solutions Architect, NetApp
- Anthony Mashford | Cloud Solutions Architect, NetApp
- Daniel Söderholm | Senior Solution Engineer, Cloud + AI Platforms, Microsoft
Övriga medarbetare:
- Heather Grandy | Senior Solution Engineer, Data Platforms, Microsoft
Om du vill se linkedin-profiler som inte är offentliga loggar du in på LinkedIn.
Nästa steg
- Introduktion till Object REST API för Azure NetApp Files
- Anslut OneLake till en Azure NetApp Files-volym
- Init-skript i Azure Databricks
- Integrera OneLake med Azure Machine Learning