Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Genie Code bygger dokumentbehandlingspipelines från början till slut genom att orkestrera parsing, klassificering, extraktion och validering. Rikta den mot ostrukturerade PDF:er, kontrakt eller fakturor, och den utvärderar kvalitet mot märkt data och itererar för att förbättra den, så att du kan bedöma när en pipeline är produktionsklar.
Requirements
För att använda Genie Code för dokumentbehandling:
- Uppfyller kraven för agentiska kapaciteter i Genie Code.
- Uppfyller kraven för AI-funktioner. Dokumentbehandlingsfunktionerna (
ai_parse_document,ai_extract, ochai_classify) körs på serverless compute eller ett SQL-lager i en stödd region. - Låt Unity Catalog få tillgång till en volym för dina källdokument och ett schema för resultaten.
Bygg en dokumenthanteringspipeline med Genie Code
Öppna Genie Code på sidan Jobs & Pipelines eller i SQL-editorn.
Ange ditt mål och peka på dina källor. Referera till dina volymer, tabeller och filer.
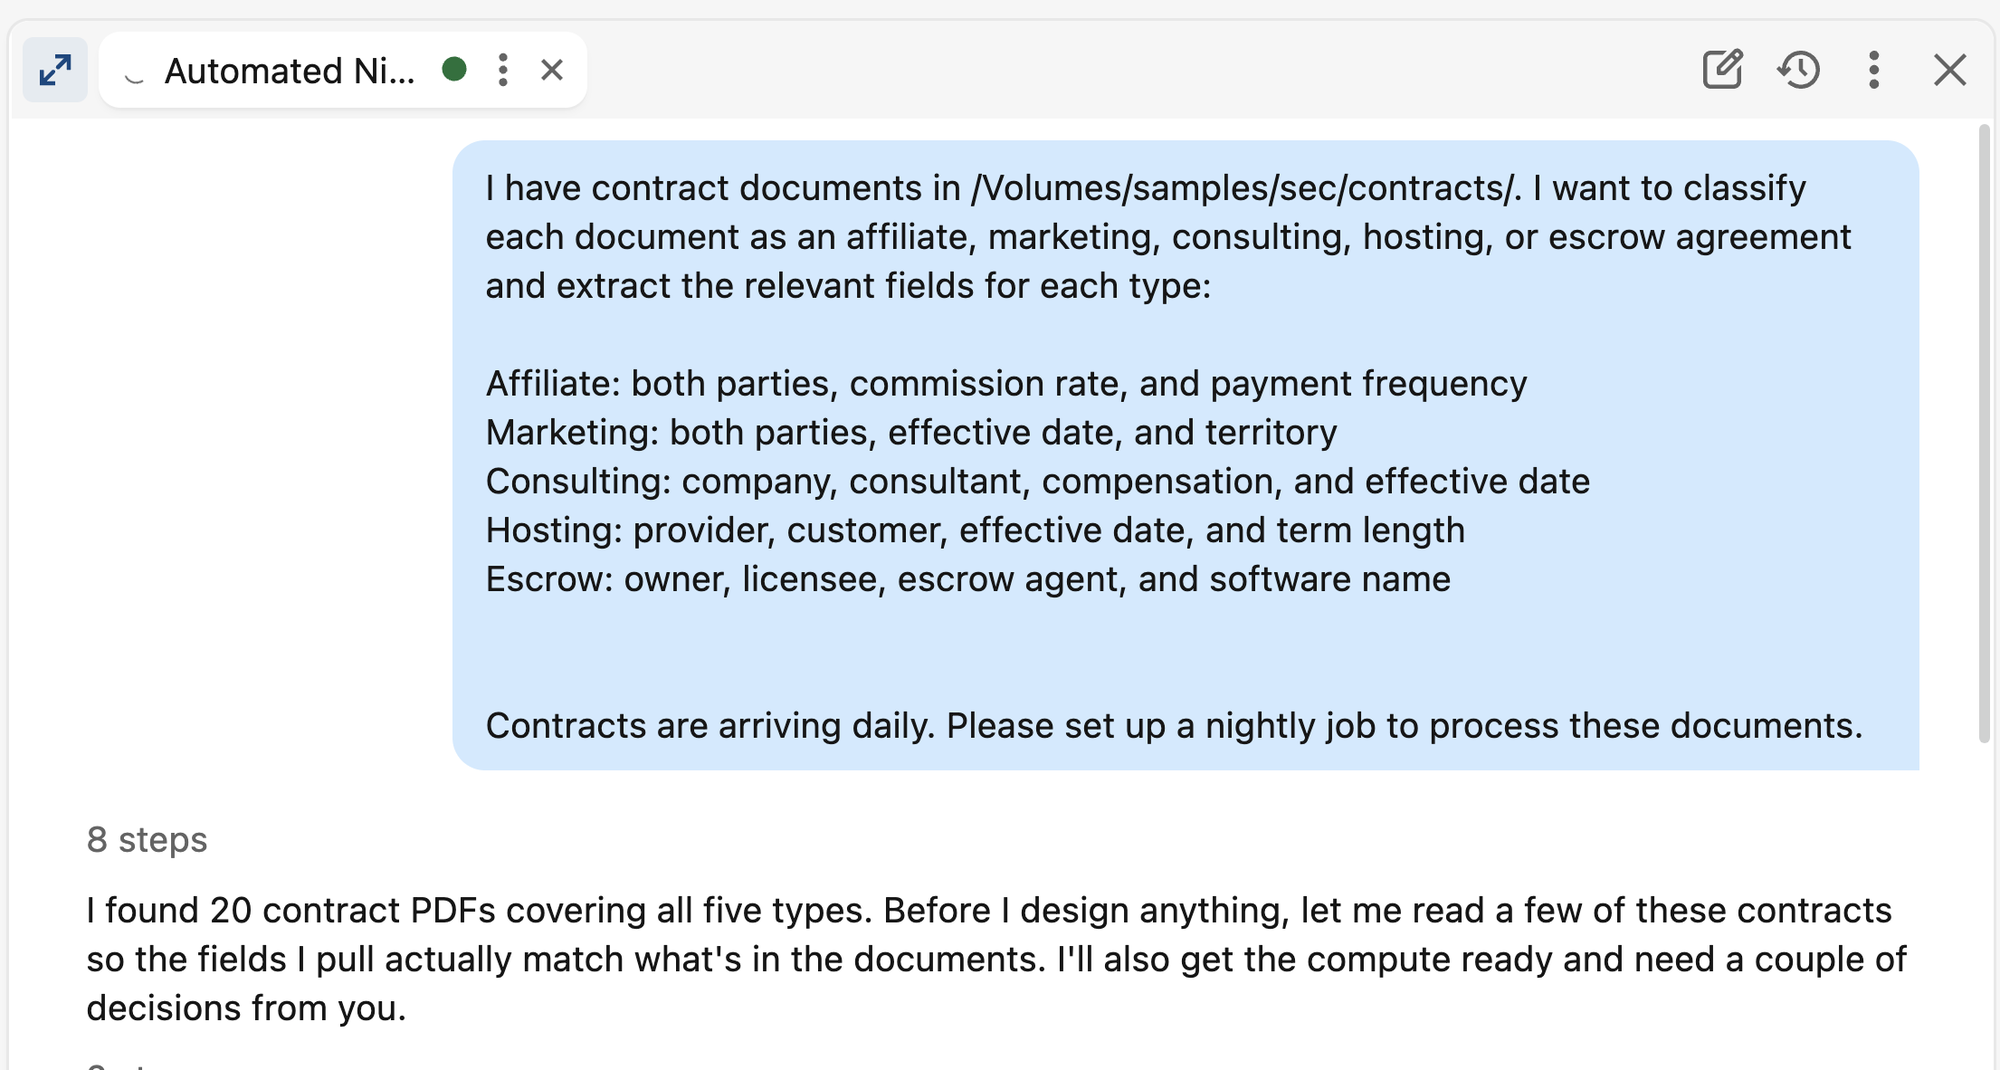
Låt det byggas upp. När Genie Code har tillräckligt att arbeta med bygger de Lakeflow-jobbet med hjälp av bästa praxis.
Granska och kör. Titta över den genererade SQL:n och uppgifterna, redigera vad du vill och kör jobbet när du är redo.
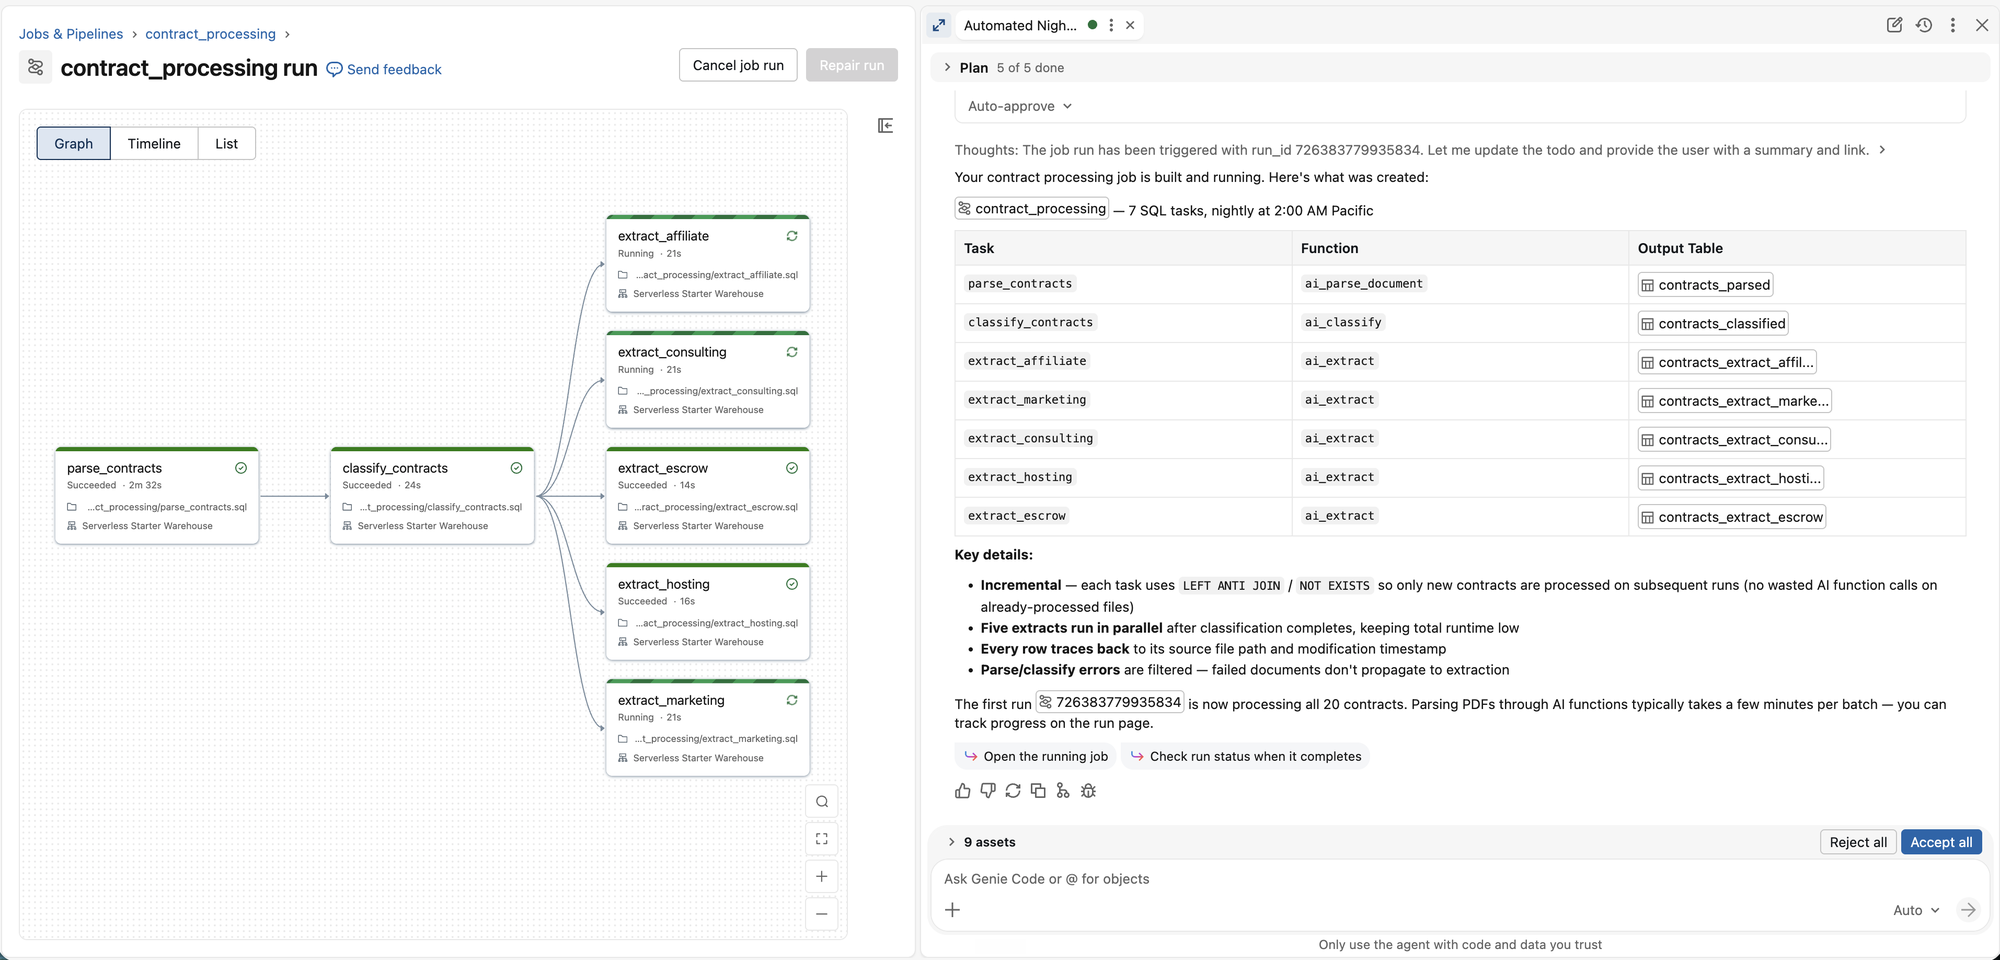
Börja smått, sedan skala upp. Kör på ett prov, granska resultatet, utvärdera kvaliteten och iterera innan du bearbetar hela datamängden.
Vad kan Genie Code hjälpa till med?
Skapa ett heltäckande jobb för dokumentbearbetning
Beskriv resultatet, och Genie Code bygger ett komplett Lakeflow-jobb, med endast de steg som ditt mål behöver:
- Upptäck källfiler i en volym och spåra deras identitet och ändringar.
-
Parsa dokument till strukturerat innehåll med
ai_parse_document(text, tabeller, figurer och sidlayout). -
Klassificera varje dokument i dina egna etiketter (
ai_classifytill exempel affiliate-, marknadsförings- eller konsultkontrakt). -
Extrahera strukturerade fält mot ett schema med
ai_extract, inklusive citater och konfidenspoäng. - Publicera ren, strukturerad utdata till en Unity-katalogtabell.
Varje AI-funktion är en egen uppgift, så jobbet förblir modulärt och du kan köra om, fylla i eller redigera det senare.
Förbättra utvinningskvaliteten med utvärdering och backklättring
Genie Code behandlar kvalitet som något du mäter, inte gissar på. Givet en märkt tabell med förväntade utdata körs en fältnivåutvärdering och stängs sedan loopen:
- Mät. Betygsätt den aktuella extraktionen fält för fält så att du kan se exakt vilka fält som är svaga.
- Förbättra. Genie Code föreslår en lösning, oftast en skarpare fältbeskrivning, som visas som en granskningsbar diff som du godkänner innan den gäller.
- Omvärdera. Varje accepterad ändring kör utvärderingsuppsättningen igen och visar före-och-efter-resultat, så både förbättringar och regressioner är synliga.
Loopen upprepas tills kvaliteten når din nivå, så du bedömer beredskap utifrån poäng och självförtroende, inte utifrån resultat som verkar trovärdigt.
Validera resultat och route-undantag
Genie Code bygger kvalitetsgrindar i pipelinen. Den kombinerar deterministiska kontroller (scheman, obligatoriska fält, totalsummor), modellkonvodit och affärsregler för att avgöra vad som går igenom, och håller misslyckade rader synliga.
Felsök dina dokument visuellt
Genie Code öppnar Document Parsing UI för att visa de renderade sidorna bredvid det parsade innehållet och de extraherade fälten. Använd den för att hitta ett dåligt resultat: om text saknas eller är osammanhängande i den tolkade utdatan är problemet parsen eller källfilen. Om texten tolkades men ett fält är felaktigt, ligger problemet i extraheringen. Oavsett vilket, verifiera med verkliga dokument innan du skalar upp.
Inspektera och felsöka befintliga pipelines
Genie Code fungerar på pipelines du redan har, inte bara nya. Den kan förklara ett jobb, granska dess design och kostnad utan att ändra något, hitta grundorsaken till ett misslyckat eller långsamt steg och göra den minsta lösningen medan de fungerande delarna lämnas ifred.
Exempeluppmaningar
Bygg en heltäckande pipeline
- Avtal hamnar i
@my_catalog.raw.contracts. Skapa ett dagligt jobb som klassificerar varje avtal som partneravtal, marknadsföring, konsultverksamhet, drift eller escrow, extraherar de fält som är viktiga för varje typ av avtal och skriver guldtabeller. - "Jag har en volym med skannade fakturor på
@my_catalog.raw.invoices. Bygg ett jobb som tolkar dem, extraherar leverantör, fakturanummer, radposter och total, och skriver resultaten till en tabell."
Förbättra kvaliteten med utvärdering och backklättring
- "Hur vet jag att det här är tillräckligt bra för att köras på miljontals rader? Utvärdera extraktionen mot min märkta tabell
@my_catalog.default.eval_tableoch säg vilka fält som är svagast." - "Noggrannheten på
invoice_totalfältet kan vara högre. Förbättra schemat och instruktionerna iterativt, kör om utvärderingen och visa mig före och efter." - "Sätt konfidensgränser per fält från utvärderingsresultaten och led lågkonfidensrader till granskning."
Validera resultat och route-undantag
- "Lägg till validering som kontrollerar nödvändiga fält och att radposter summeras till fakturasumman, och behåll raderna som misslyckas."
- "Karantändokument som inte uppfyller en affärsregel (till exempel skatt som betalas högre än lönen) i en separat tabell för mänsklig granskning."
Felsök dina dokument visuellt
- "Visa mig de parsade resultaten för dessa PDF:er bredvid originalsidorna så att jag kan kontrollera de parsade resultaten."
- "Ikraftträdandedatumet är fel på vissa konsultkontrakt. Öppna den tolkade vyn så jag kan se om det är ett parsnings- eller extraktionsfel."
Inspektera och felsöka befintliga pipelines
- "Förklara vad varje uppgift i detta dokumenthanteringsjobb gör och var resultaten skrivs."
- "Den här parsningsuppgiften började misslyckas. Hitta orsaken i utdata från den senaste körningen och rekommendera den minsta möjliga åtgärden.
- "Granska denna dokumenthanteringspipelinedesign mot bästa praxis och säg om den är redo att köras på hela datamängden."