Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Funktionstabeller kan serveras på två sätt:
- Model serving: Distribuera en modell som tränats på featuretabeller. Samma endpoint används både för feature lookup och modellinferens. Endpointen slår automatiskt upp eller beräknar feature-värden, med hjälp av den lineage som följdes när modellen loggades. Använd detta för att hantera modellförutsägelser.
-
Feature Serving: Distribuera
FeatureSpecsom refererar till featuretabeller direkt, utan en modell. Endpointen returnerar de begärda funktionsutdata. Använd detta när ett program behöver funktionsvärden i stället för modellförutsägelser. Om du i slutändan använder funktioner för modellinferens rekommenderar Databricks att använda modellservering direkt.
Båda metoderna stödjer förberäknade och on-demand-funktioner.
Krav
- Databricks Runtime 14.2 ML eller senare.
- För att kunna använda Python-API:et kräver funktionsservern
databricks-feature-engineeringversion 0.1.2 eller senare, som är inbyggd i Databricks Runtime 14.2 ML. För tidigare Databricks Runtime ML-versioner installerar du den version som krävs manuellt med .%pip install databricks-feature-engineering>=0.1.2Om du använder en Databricks-notebook-fil måste du starta om Python kernel genom att köra det här kommandot i en ny cell:dbutils.library.restartPython(). - För att kunna använda Databricks SDK kräver Feature Serving version 0.18.0 eller senare. Om du vill installera den version som krävs manuellt använder du
%pip install databricks-sdk>=0.18.0. Om du använder en Databricks-notebook-fil måste du starta om Python kernel genom att köra det här kommandot i en ny cell:dbutils.library.restartPython().
Databricks-funktionsservern innehåller ett användargränssnitt och flera programmatiska alternativ för att skapa, uppdatera, fråga och ta bort slutpunkter. Den här artikeln innehåller instruktioner för vart och ett av följande alternativ:
- Databricks-användargränssnitt
- REST-API
- Python API
- Databricks SDK
Om du vill använda REST API eller MLflow Deployments SDK måste du ha en Databricks API-token.
Viktigt!
Som bästa säkerhet för produktionsscenarier rekommenderar Databricks att du använder OAuth-token från dator till dator för autentisering under produktion.
För testning och utveckling rekommenderar Databricks att du använder en personlig åtkomsttoken som tillhör tjänstens huvudnamn i stället för arbetsyteanvändare. Information om hur du skapar token för tjänstens huvudnamn finns i Hantera token för tjänstens huvudnamn.
Autentisering för funktionstjänster
Information om autentisering finns i Authorize access to Azure Databricks resources.
Skapa en FeatureSpec
En FeatureSpec är en användardefinierad uppsättning funktioner. Du kan kombinera funktioner i en FeatureSpec.
FeatureSpecs lagras i och hanteras av Unity Catalog och visas i Katalogutforskaren.
Tabellerna som anges i en FeatureSpec måste publiceras till en onlinefunktionsbutik eller en onlinebutik från tredje part. Se Databricks Online Feature Stores.
Du måste använda databricks-feature-engineering paketet för att skapa en FeatureSpec.
Definiera först funktionen:
from unitycatalog.ai.core.databricks import DatabricksFunctionClient

client = DatabricksFunctionClient()

CATALOG = "main"
SCHEMA = "default"

def difference(num_1: float, num_2: float) -> float:
  """
  A function that accepts two floating point numbers, subtracts the second one
  from the first, and returns the result as a float.

  Args:
      num_1 (float): The first number.
      num_2 (float): The second number.

  Returns:
      float: The resulting difference of the two input numbers.
  """
  return num_1 - num_2

client.create_python_function(
  func=difference,
  catalog=CATALOG,
  schema=SCHEMA,
  replace=True
)
Sedan kan du använda funktionen i en FeatureSpec:
from databricks.feature_engineering import (
  FeatureFunction,
  FeatureLookup,
  FeatureEngineeringClient,
)

fe = FeatureEngineeringClient()

features = [
  # Lookup column `average_yearly_spend` and `country` from a table in UC by the input `user_id`.
  FeatureLookup(
    table_name="main.default.customer_profile",
    lookup_key="user_id",
    feature_names=["average_yearly_spend", "country"]
  ),
  # Calculate a new feature called `spending_gap` - the difference between `ytd_spend` and `average_yearly_spend`.
  FeatureFunction(
    udf_name="main.default.difference",
    output_name="spending_gap",
    # Bind the function parameter with input from other features or from request.
    # The function calculates num_1 - num_2.
    input_bindings={"num_1": "ytd_spend", "num_2": "average_yearly_spend"},
  ),
]

# Create a `FeatureSpec` with the features defined above.
# The `FeatureSpec` can be accessed in Unity Catalog as a function.
fe.create_feature_spec(
  name="main.default.customer_features",
  features=features,
)
Ange standardvärden
Om du vill ange standardvärden för funktioner, använd parametern default_values i FeatureLookup. Se följande exempel:
feature_lookups = [
    FeatureLookup(
        table_name="ml.recommender_system.customer_features",
        feature_names=[
            "membership_tier",
            "age",
            "page_views_count_30days",
        ],
        lookup_key="customer_id",
        default_values={
          "age": 18,
          "membership_tier": "bronze"
        },
    ),
]
Om funktionskolumnerna har bytt namn med hjälp av parametern rename_outputsdefault_values måste du använda de omdöpta funktionsnamnen.
FeatureLookup(
  table_name = 'main.default.table',
  feature_names = ['materialized_feature_value'],
  lookup_key = 'id',
  rename_outputs={"materialized_feature_value": "feature_value"},
  default_values={
    "feature_value": 0
  }
)
Lägg till Python-beroenden
Om en användardefinierad funktion (UDF) importerar Python-paket, deklarera dem när du skapar FeatureSpec. Parametern extra_pip_requirements kräver databricks-feature-engineering version 0.17.0 eller högre. Feature Serving installerar MLflow och databricks-feature-lookup paketen automatiskt.
Till exempel, om en UDF i din funktionsspecifikation importerar NumPy, lägg till kravet i specifikationen:
fe.create_feature_spec(
    name="main.default.customer_features_with_dependencies",
    features=features,
    extra_pip_requirements=["numpy==1.26.4"],
)
Använd main.default.customer_features_with_dependencies som specifikationsnamn när du skapar endpointen.
Varje post i extra_pip_requirements måste vara en PyPI-kravsträng, såsom numpy==1.26.4, eller en sökväg till en .whl fil i en Unity Catalog-volym. Till exempel, använd /Volumes/main/libraries/wheels/custom_features-1.0.0-py3-none-any.whl för ett hjul du har laddat upp. Den som skapar slutpunkten måste ha READ VOLUME på volymen och både USE CATALOG och USE SCHEMA på dess överordnade katalog och schema.
För paket från ett privat arkiv, konfigurera arbetsområdets standardpaketarkiv. Sätt inte pip-kommandoalternativ, såsom --index-url, i extra_pip_requirements.
Beroenden i en Unity Catalog UDF:s ENVIRONMENT klausul gäller för offline-exekvering av SQL. Feature Serving kopierar dem inte automatiskt. Deklarera varje paket som behövs av UDF:erna, inklusive UDF:er i överordnade funktioner, i kraven i funktionsspecifikationen.
Om distributionen till slutpunkten misslyckas, granska byggloggarna för fel vid paketinstallation, versionskonflikter eller fel vid åtkomst till wheel-filer. Se Övervaka modellkvalitet och slutpunktshälsa.
För ett exempel med CustomUDF och FeatureViewSource, se Serve CustomUDF-funktioner och deras beroenden. För modellserverande beroenden, se Anpassade UDF-beroenden.
Skapa en slutpunkt
Definierar FeatureSpec slutpunkten. Mer information finns i Skapa anpassad modell som betjänar slutpunkter, dokumentationen för Python API eller Databricks SDK.
Kommentar
För arbetsbelastningar som är svarstidskänsliga eller kräver höga frågor per sekund, erbjuder Modellservern routningsoptimering på anpassade modell som betjänar slutpunkter, se Routningsoptimering på serveringsslutpunkter.
Databricks SDK – Python
from databricks.sdk import WorkspaceClient
from databricks.sdk.service.serving import EndpointCoreConfigInput, ServedEntityInput

workspace = WorkspaceClient()

# Create endpoint
workspace.serving_endpoints.create(
  name="my-serving-endpoint",
  config = EndpointCoreConfigInput(
    served_entities=[
    ServedEntityInput(
        entity_name="main.default.customer_features",
        scale_to_zero_enabled=True,
        workload_size="Small"
      )
    ]
  )
)
Python API
from databricks.feature_engineering.entities.feature_serving_endpoint import (
  ServedEntity,
  EndpointCoreConfig,
)

fe.create_feature_serving_endpoint(
  name="customer-features",
    config=EndpointCoreConfig(
    served_entities=ServedEntity(
      feature_spec_name="main.default.customer_features",
             workload_size="Small",
             scale_to_zero_enabled=True,
             instance_profile_arn=None,
    )
  )
)
REST-API
curl -X POST -u token:$DATABRICKS_API_TOKEN ${WORKSPACE_URL}/api/2.0/serving-endpoints \
    -H 'Content-Type: application/json' \
    -d '"name": "customer-features",
   "config": {
       "served_entities": [
           {
               "entity_name": "main.default.customer_features",
               "workload_size": "Small",
               "scale_to_zero_enabled": true
           }
       ]
   }'
Om du vill se slutpunkten klickar du på Servering i det vänstra sidofältet i Databricks-användargränssnittet. När tillståndet är Klart är slutpunkten redo att svara på frågor. Mer information om modellservering finns i Modellservering.
Spara den utökade DataFrame i inferenstabellen
För slutpunkter som skapats från och med februari 2025 kan du konfigurera modellen som betjänar slutpunkten för att logga den förhöjda DataFrame som innehåller uppslagsfunktionsvärdena och funktionens returvärden. DataFrame sparas i slutsatsdragningstabellen för den betjänade modellen.
Anvisningar om hur du konfigurerar denna konfiguration finns i Loggfunktionssökning DataFrames till inferenstabeller.
För information om inferenstabeller, se Loggförfrågningar och svar för servande ändpunkter (legacy).
Hämta en slutpunkt
Du kan använda Databricks SDK eller Python-API:et för att hämta metadata och status för en slutpunkt.
Databricks SDK – Python
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

endpoint = workspace.serving_endpoints.get(name="customer-features")
# print(endpoint)
Python API
endpoint = fe.get_feature_serving_endpoint(name="customer-features")
# print(endpoint)
Hämta schemat för en slutpunkt
Du kan använda Databricks SDK eller REST API för att hämta schemat för en slutpunkt. Mer information om slutpunktsschemat finns i Hämta en modell som betjänar slutpunktsschemat.
Databricks SDK – Python
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

# Create endpoint
endpoint = workspace.serving_endpoints.get_open_api(name="customer-features")
REST-API
ACCESS_TOKEN=<token>
ENDPOINT_NAME=<endpoint name>

curl "https://example.databricks.com/api/2.0/serving-endpoints/$ENDPOINT_NAME/openapi" -H "Authorization: Bearer $ACCESS_TOKEN" -H "Content-Type: application/json"
Fråga en slutpunkt
Du kan använda REST-API:et, SDK:n för MLflow-distributioner eller servergränssnittet för att fråga en slutpunkt.
Följande kod visar hur du konfigurerar autentiseringsuppgifter och skapar klienten när du använder MLflow Deployments SDK.
  # Set up credentials
  export DATABRICKS_HOST=...
  export DATABRICKS_TOKEN=...
  # Set up the client
  import mlflow.deployments

  client = mlflow.deployments.get_deploy_client("databricks")
Kommentar
När du autentiserar med automatiserade verktyg, system, skript och appar rekommenderar Databricks att du använder personliga åtkomsttoken som tillhör tjänstens huvudnamn i stället för arbetsyteanvändare. Information om hur du skapar token för tjänstens huvudnamn finns i Hantera token för tjänstens huvudnamn.
Fråga en slutpunkt med API:er
Det här avsnittet innehåller exempel på frågor mot en slutpunkt med hjälp av REST-API:et eller SDK:n för MLflow-distributioner.
SDK för MLflow-distributioner
Viktigt!
I följande exempel används API:et predict()från MLflow Deployments SDK. Det här API:et är experimentellt och API-definitionen kan ändras.
import mlflow.deployments

client = mlflow.deployments.get_deploy_client("databricks")
response = client.predict(
    endpoint="test-feature-endpoint",
    inputs={
        "dataframe_records": [
            {"user_id": 1, "ytd_spend": 598},
            {"user_id": 2, "ytd_spend": 280},
        ]
    },
)
REST-API
curl -X POST -u token:$DATABRICKS_API_TOKEN $ENDPOINT_INVOCATION_URL \
  -H 'Content-Type: application/json' \
  -d '{"dataframe_records": [
          {"user_id": 1, "ytd_spend": 598},
          {"user_id": 2, "ytd_spend": 280}
      ]}'
Fråga en slutpunkt med hjälp av användargränssnittet
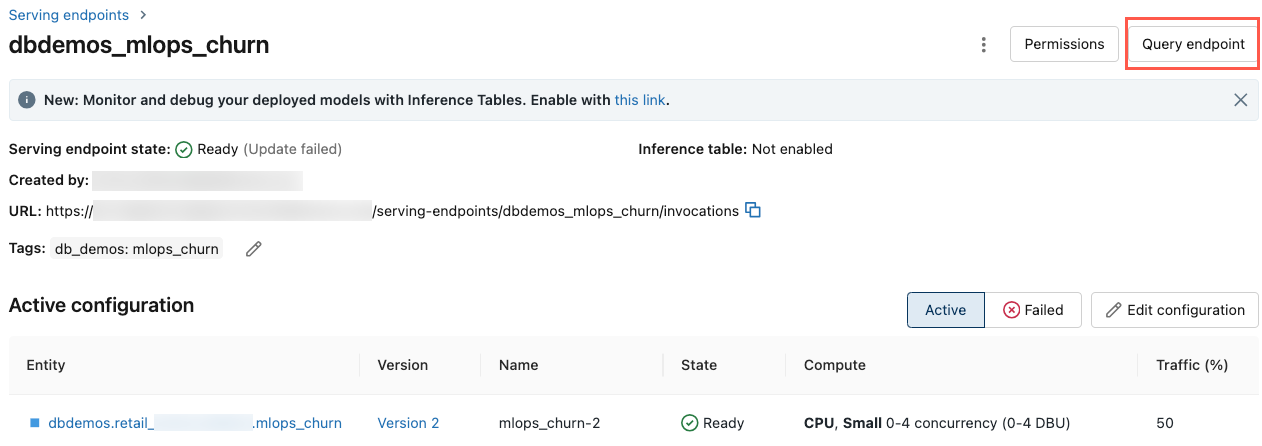
Du kan fråga en tjänst-slutpunkt direkt från servergränssnittet. Användargränssnittet innehåller genererade kodexempel som du kan använda för att fråga slutpunkten.
Klicka på Serving i den vänstra sidopanelen på arbetsytan Azure Databricks.
Klicka på den slutpunkt som du vill fråga efter.
Klicka på Frågeslutpunkt längst upp till höger på skärmen.
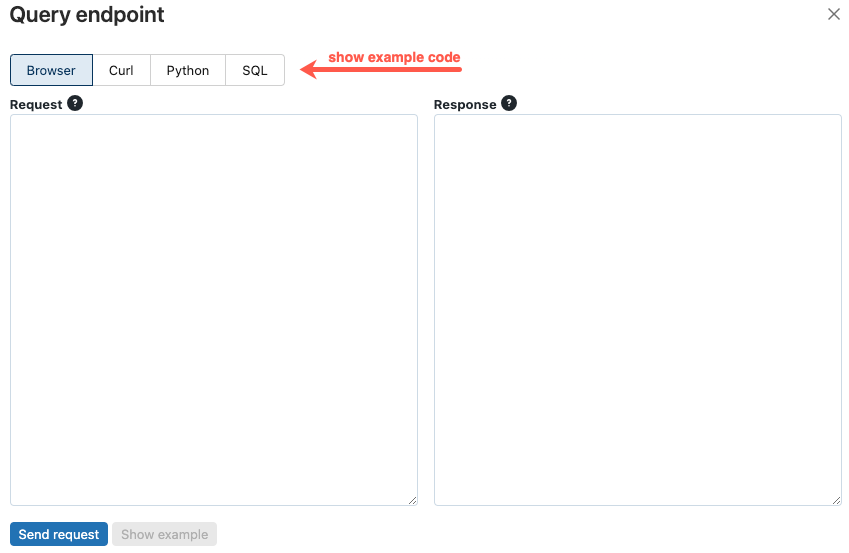
I rutan Begäran skriver du begärandetexten i JSON-format.
Klicka på Skicka begäran.
// Example of a request body.
{
  "dataframe_records": [
    { "user_id": 1, "ytd_spend": 598 },
    { "user_id": 2, "ytd_spend": 280 }
  ]
}
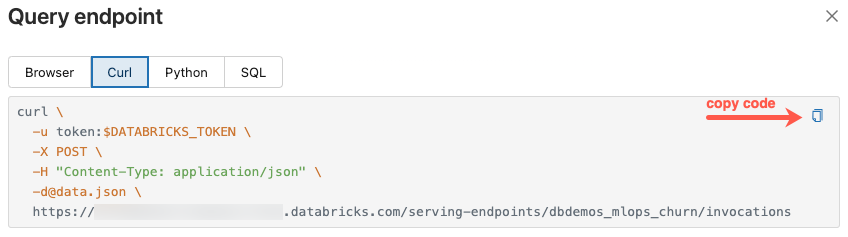
Dialogrutan Query-slutpunkt innehåller genererad exempelkod i curl, Python och SQL. Klicka på flikarna för att visa och kopiera exempelkoden.
Om du vill kopiera koden klickar du på kopieringsikonen längst upp till höger i textrutan.
Uppdatera en ändpunkt
Viktigt!
Om du vill ändra konfigurationen för en funktionsserverslutpunkt (till exempel ändra arbetsbelastningens FeatureSpec storlek eller storlek) använder du alltid de uppdaterings-API:er som beskrivs i det här avsnittet. Ta inte bort och återskapa slutpunkten för att tillämpa ändringar. Att ta bort en liveslutpunkt orsakar omedelbart driftstopp och avbryter alla program som frågar den.
Du kan uppdatera en slutpunkt med hjälp av REST API, Databricks SDK eller serveringsgränssnittet.
Uppdatera en slutpunkt med hjälp av API:er
Databricks SDK – Python
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

workspace.serving_endpoints.update_config(
  name="my-serving-endpoint",
  served_entities=[
    ServedEntityInput(
      entity_name="main.default.customer_features",
      scale_to_zero_enabled=True,
      workload_size="Small"
    )
  ]
)
REST-API
curl -X PUT -u token:$DATABRICKS_API_TOKEN ${WORKSPACE_URL}/api/2.0/serving-endpoints/<endpoint_name>/config \
  -H 'Content-Type: application/json' \
  -d '"served_entities": [
        {
            "name": "customer-features",
            "entity_name": "main.default.customer_features_new",
            "workload_size": "Small",
            "scale_to_zero_enabled": True
        }
    ]'
Uppdatera en slutpunkt med hjälp av användargränssnittet
Följ de här stegen för att använda användargränssnittet för servering:
- Klicka på Serving i den vänstra sidopanelen på arbetsytan Azure Databricks.
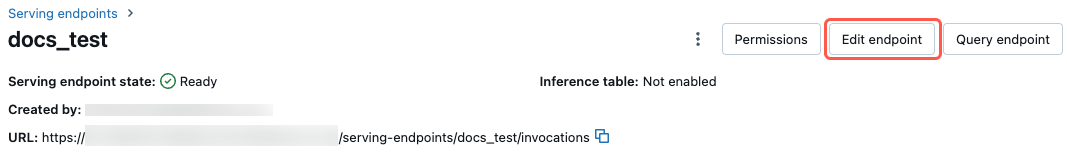
- I tabellen klickar du på namnet på den slutpunkt som du vill uppdatera. Slutpunktsskärmen visas.
- Klicka på Redigera slutpunkt längst upp till höger på skärmen.
- I dialogrutan Redigera serverdelsslutpunkt redigerar du slutpunktsinställningarna efter behov.
- Klicka på Uppdatera för att spara ändringarna.
Ta bort en slutpunkt
Varning
Den här åtgärden kan inte ångras. Om du tar bort en funktionsserverslutpunkt uppstår omedelbar stilleståndstid för alla program som kör frågor mot den. Om du vill ändra slutpunktens konfiguration använder du Uppdatera en slutpunkt i stället för att ta bort och återskapa slutpunkten.
Du kan ta bort en slutpunkt med hjälp av REST-API:et, Databricks SDK, Python-API:et eller användargränssnittet för servering.
Ta bort en slutpunkt med API:er
Databricks SDK – Python
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

workspace.serving_endpoints.delete(name="customer-features")
Python API
fe.delete_feature_serving_endpoint(name="customer-features")
REST-API
curl -X DELETE -u token:$DATABRICKS_API_TOKEN ${WORKSPACE_URL}/api/2.0/serving-endpoints/<endpoint_name>
Ta bort en slutpunkt med hjälp av användargränssnittet
Följ de här stegen för att ta bort en slutpunkt med hjälp av användargränssnittet för servering:
- Klicka på Serving i den vänstra sidopanelen på arbetsytan Azure Databricks.
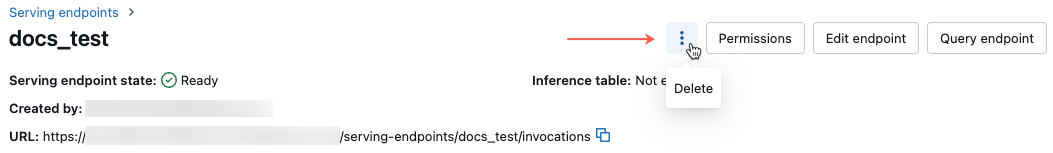
- I tabellen klickar du på namnet på den slutpunkt som du vill ta bort. Slutpunktsskärmen visas.
- I det övre högra hörnet på skärmen klickar du på
 välja Ta bort.
Övervaka hälsotillståndet för en slutpunkt
Information om de loggar och mått som är tillgängliga för funktionsserveringsslutpunkter finns i Övervaka modellkvalitet och slutpunktshälsa.
Åtkomstkontroll
Information om behörigheter för funktionsserverslutpunkter finns i Hantera behörigheter för en modell som betjänar slutpunkten.
Exempelanteckningsbok
Den här notebook-filen visar hur du använder Databricks SDK för att skapa en funktionsserveringsslutpunkt med Databricks Online Feature Store.