Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Azure Batch kör storskaliga parallella och högpresterande databehandlingsjobb (HPC) i Azure. Batch skapar och hanterar pooler med beräkningsnoder, installerar de program som du vill köra och schemalägger jobb som ska köras på noderna.
När du använder Azure är tillförlitlighet ett delat ansvar. Microsoft tillhandahåller en rad funktioner för att stödja återhämtning och återställning. Du ansvarar för att förstå hur dessa funktioner fungerar inom alla tjänster som du använder och välja de funktioner du behöver för att uppfylla dina affärsmål och drifttidsmål.
Den här artikeln beskriver hur du gör Azure Batch motståndskraftigt mot tillfälliga fel, fel i beräkningsnoder, fel i tillgänglighetszonen, regionomfattande fel och tjänstunderhåll. Den beskriver också rekommendationer för distribution till produktion, Batch-tillförlitlighetsarkitektur, säkerhetskopiering och återställning samt viktig information om Azure Batch serviceavtal (SLA).
Rekommendationer för produktionsdistribution
För produktionsarbetsbelastningar, följ metodtipsen för Azure Batch, inklusive följande tillförlitlighetsrekommendationer:
Utforma uppgifter för att tolerera avbrott och återkörning. Gör uppgifter idempotenta, skapa kontrollpunkter för långvarigt arbete och spara nödvändiga utdata och diagnostikdata till varaktig lagring. Mer information finns i Motståndskraft mot tillfälliga fel och motståndskraft mot beräkningsnodfel.
Använd flera beräkningsnoder när arbetsbelastningen måste fortsätta efter ett nodfel. Enskilda beräkningsnoder är inte garanterade att vara tillgängliga. Tillhandahåll tillräckligt med noder så att de återstående användbara noderna kan köra omplanerade uppgifter.
Använd placering i tillgänglighetszon när det stöds. Konfigurera placeringen av tillgänglighetszoner när regionen, SKU:n för virtuella datorer (VM) och arbetsbelastningskonfigurationen stöder det. Noder i felfria zoner kan fortsätta att köra aktiviteter under ett zonavbrott, men planera för minskad kapacitet eftersom ersättningskapaciteten är beroende av kvot och VM-tillgänglighet i felfria zoner. Mer information finns i Motståndskraft mot fel i tillgänglighetszonen.
Konfigurera jobb så att de riktar sig mot pooler dynamiskt i stället för ett fast pool-ID. Med den här designen kan du ändra mål för ett jobb till en felfri pool om den ursprungliga poolen blir otillgänglig eller inte kan skalas till önskad kapacitet. Det förbättrar affärskontinuiteten under underhåll av resurspoolen eller vid fel.
Håll poolkonfigurationerna aktuella. Övervaka slutdatum (EOL) för Batch-stöd för VM-avbildningar och SKU:er och migrera pooler före EOL. Följ vägledningen för underhåll av tjänsten för att hålla Batch-nodagenten aktuell.
Översikt över tillförlitlighetsarkitektur
I det här avsnittet beskrivs några av de viktiga aspekterna av hur tjänsten fungerar som är mest relevant ur ett tillförlitlighetsperspektiv. I avsnittet beskrivs den logiska arkitekturen, som innehåller några av de resurser och funktioner som du distribuerar och använder. Den diskuterar också den fysiska arkitekturen, som innehåller information om hur tjänsten fungerar under täcket.
Logisk arkitektur
Azure Batch använder flera resurstyper för att köra batcharbetsbelastningar. Konfigurationen av dessa resurser avgör hur din arbetsbelastning svarar på störningar.
Alla Batch-bearbetningar och resurser är associerade med ett Batch-konto. En Batch-lösning använder följande logiska komponenter:
Batch-konto: En regional resurs som pooler, jobb, uppgifter och andra Batch-resurser är associerade med. Du skapar kontot och väljer dess region, poolallokeringsläge och autentiseringsinställningar.
Pool: En samling beräkningsnoder som aktiviteter körs på. Konfigurationen för en pool definierar dess VM-avbildning och storlek, antal målnoder, skalningsbeteende, nätverk och zonplacering. Du konfigurerar varje pool för att tillhandahålla den kapacitet, placering och driftsmiljö som din arbetsbelastning kräver. Antalet målnoder är den begärda kapaciteten, men antalet allokerade noder kan vara lägre på grund av kvotgränser, kapacitetsbegränsningar eller allokeringsfel.
Jobb och uppgifter: Ett jobb hanterar en samling uppgifter och är associerat med en pool. En aktivitet kör ett program eller skript på en beräkningsnod. Du definierar jobb, uppgifter, begränsningar, beroenden, beteende för återförsök och poolen som varje jobb körs på.
Associerat lagringskonto: Ett Azure Storage konto som du kan länka till ett Batch-konto. De flesta Batch-lösningar använder ett associerat lagringskonto för programfiler, aktivitetsresursfiler, indata och utdata.
När du har länkat ett lagringskonto till ett Batch-konto refererar Batch till det som autostorage-konto. Ett konto för automatisk lagring krävs för programpaket och kan även lagra aktivitetsresursfiler.
Tillförlitligheten för en Batch-lösning beror på dess lagringsresurser. Du ansvarar för att välja en konfiguration för lagringsredundans som uppfyller dina återställningskrav när du skapar lagringskontot. Flytta utdata från uppgifter och andra varaktiga data från beräkningsnoder till lagring. Information om Azure Storage tillförlitlighetsalternativ finns i Tillförlitlighet i Azure Blob Storage.
Mer information finns i Batch-tjänstens arbetsflöde och resurser samt Batch-konton och Azure Storage konton.
Fysisk arkitektur
Azure Batch har ett regionalt control plane som bearbetar hanteringsåtgärder mot Batch-konton och andra Batch-resurser, till exempel pooler, jobb och uppgifter. Den är separat från beräkningsnoderna som kör uppgifter.
Azure Batch pooler använder Azure Virtual Machines och Virtual Machine Scale Sets. En beräkningsnod är en virtuell dator som bearbetar en del av en Batch-arbetsbelastning. Varje nod tillhör en pool och kör uppgifter som Batch-tjänsten tilldelar den. Batch-nodagenten körs på varje nod och tillhandahåller kommando- och kontrollgränssnittet mellan noden och Batch-tjänsten. Beräkningsnoder och deras lokala lagring är icke-beständiga. När en nod lämnar en pool går ändringar i dess operativsystem och filer förlorade.
Batch-kontots poolallokeringsläge avgör var Batch skapar beräknings- och VM-relaterade resurser:
- Allokeringsläge för Batch-tjänstpool: Batch allokerar resurserna i Batch-tjänsthanterade Azure-prenumerationer.
- Allokeringsläge för användarprenumerationspool: Batch skapar resurserna direkt i prenumerationen som innehåller Batch-kontot.
Ansvarsområden för den fysiska arkitekturen delas upp på följande sätt:
Microsoft: Microsoft driver det regionala Batch-kontrollplanet och tjänstinfrastrukturen. Batch etablerar beräkningsnoder enligt poolkonfigurationen och tillgänglig kapacitet, schemalägger uppgifter, övervakar nodhälsa och försöker återställa noder efter infrastrukturfel. Batch kan köa om avbrutna uppgifter för körning på en annan tillgänglig nod.
Du: Du väljer VM-image och storlek, nodtyper, antal målnoder, skalningskonfiguration, nätverk och placering av tillgänglighetszon.
Du ansvarar också för att upprätthålla tillräckligt med kapacitet för att tolerera nodfel, övervaka nod- och uppgiftstillstånd, hålla gästoperativsystemet och nodagenten aktuella, utforma uppgifter för att tolerera återkörning och flytta varaktiga data från beräkningsnoderna.
Batch-nodåterställning garanterar inte att en arbetsbelastning fortsätter utan avbrott. Mer information finns i Motståndskraft mot fel i beräkningsnoder.
Motståndskraft mot tillfälliga fel
Tillfälliga fel är kortvariga, intermittenta fel i komponenter. De förekommer ofta i en distribuerad miljö som molnet, och de är en normal del av åtgärderna. Tillfälliga fel korrigerar sig själva efter en kort tidsperiod. Det är viktigt att dina program kan hantera tillfälliga fel, vanligtvis genom att försöka igen.
Alla molnbaserade program bör följa vägledningen för tillfälliga felhantering i Azure när de kommunicerar med molnbaserade API:er, databaser och andra komponenter. Mer information finns i Rekommendationer för hantering av övergående fel.
I en Batch-lösning kan tillfälliga fel påverka både program och skript som körs som uppgifter och program som anropar Batch-API:er för att hantera Batch-resurser. Batch tillhandahåller återförsöksmekanismer på uppgiftsnivå. Du ansvarar för att konfigurera uppgiftsbegränsningar, göra uppgifter idempotenta (säkra att kunna köras mer än en gång) och konfigurera omförsöksbeteende för anrop till Batch-tjänsten och andra beroenden.
Återförsök och tidsgränser för uppgifter
Konfigurera maxTaskRetryCount för att styra hur många gånger Batch försöker utföra en aktivitet igen när processen avslutas med en icke-nollavslutskod:
- Standardvärdet,
0, innebär att Batch inte försöker utföra aktiviteten igen efter en icke-nollavslutskod. - Ett positivt heltal anger ett maximalt antal återförsök efter det första försöket.
- Värdet
-1tillåter obegränsade återförsök. Det här värdet rekommenderas inte eftersom ett beständigt fel kan leda till att aktiviteten körs på obestämd tid.
Utforma varje uppgift så att den är idempotent så att återförsök inte orsakar datakorruption eller duplicerade utdata. För långvariga uppgifter använder du checkpointing så att ett nytt försök kan fortsätta från sparade framsteg. Mer information finns i Utformning för återförsök och omkörning.
Ange begränsningen maxWallClockTime för en uppgift eller ett jobb för att avsluta arbete som inte gör framsteg inom en acceptabel period. En tidsgräns begränsar också effekten av upprepade fel. Välj antal återförsök och tidsgränser som överensstämmer med arbetsbelastningens återställningsmål.
Tillfälliga fel i aktivitetsberoenden
Program och skript som körs som Batch-uppgifter anropar ofta andra komponenter, till exempel Azure Storage, databaser eller API:er. Batch behandlar inte de enskilda begäranden som aktivitetskoden skickar till dessa beroenden. Implementera tillfällig felhantering i uppgiftskoden eller använd återförsöksfunktioner som tillhandahålls av beroendets SDK. Följ varje beroendes vägledning för att identifiera återförsöksbara fel, välja lämpliga inställningar för backoff och timeout och följa instruktionerna för återförsök, till exempel headern Retry-After. Försök endast igen med åtgärder som är säkra att upprepa.
Om ett beroendefel gör att aktivitetsprocessen avslutas med en icke-nollavslutskod kan Batch försöka utföra hela aktiviteten igen enligt maxTaskRetryCount. Batch försöker dock inte igen med en enskild beroendeförfrågan i en aktivitet som körs.
Återförsök för Batch API-begäranden
Dina program som körs utanför tjänsten kan anropa Batch-API:er för att skapa och hantera pooler, jobb, uppgifter, beräkningsnoder och andra Batch-resurser. Konfigurera dessa klienter med återförsöksprinciper som sträcker sig över minst fem minuter för att hantera tillfälliga Batch-tjänst- eller nätverksfel.
Använd inbyggt SDK-återförsöksstöd när det är tillgängligt. Till exempel erbjuder det Azure.Compute.Batch-klientbiblioteket för .NET stöd för återförsök via Azure.Core alternativ för återförsök.
Om du interagerar direkt med Batch-tjänstens API:er från koden, vänta flera sekunder innan du försöker igen, använd exponentiell backoff med slumpmässighet (jitter) för att undvika synkroniserade begäranden om återförsök och respektera headern Retry-After som returneras med svar vid begränsning som 429 Too Many Requests och 503 Service Unavailable.
En tidsgräns för begäran betyder inte nödvändigtvis att Batch misslyckades med att bearbeta begäran. Efter en timeout kan du försöka utföra åtgärden igen när det är säkert att göra det, eller hämta resurstillståndet för att avgöra om den ursprungliga åtgärden lyckades. Mer information finns i artikeln Felhantering och identifiering i Azure Batch.
Motståndskraft mot beräkningsnodfel
En beräkningsnod kan bli otillgänglig på grund av ett infrastrukturfel, operativsystemproblem eller konfigurationsproblem. Batch försöker återställa noder som påverkas av infrastrukturfel, men det kan inte automatiskt återställa alla typer av konfigurationsrelaterade fel. Om ett programpaket eller en container till exempel inte kan installeras måste du korrigera det underliggande problemet och kan behöva ta bort och ersätta den berörda noden.
Om ett nodfel avbryter en aktivitet kan Batch försöka utföra aktiviteten igen på samma nod, om möjligt, upp till en intern gräns. Om uppgiften inte kan fortsätta på noden kan Batch köa om den för körning på en annan tillgänglig nod. Dessa tjänstdrivna återställningsförsök är oberoende av maxTaskRetryCount och kan inträffa även när dess värde är 0.
Microsoft-hanterad nodåterställningsprocess
Microsoft hanterar tjänstdriven nodåterställning och omköning av uppgifter. Om Batch-tjänsten slutar ta emot pulsslag från en nod tillräckligt länge för att utlösa återställning kan Batch utföra följande åtgärder:
-
Isolera noden: Batch behandlar noden som felaktig, anger dess tillstånd till
unusableoch slutar schemalägga nya aktiviteter på den. - Identifiera berörda uppgifter: Batch identifierar uppgifter som kördes på noden som kandidater för omplanering.
-
Köa om berättigade uppgifter: Om en påverkad aktivitet fortfarande finns kvar i
runningtillståndet kan Batch återställa den tillactiveså att schemaläggaren kan tilldela den till en annan nod. Batch återställer eller kör inte om en uppgift som redan har sparats i tillståndetcompleted. - Återställ noden: Batch försöker återställa noden till ett felfritt tillstånd eller ersätta den underliggande virtuella datorn.
Återställning sker inte omedelbart. En uppgift kan förbli i running tillståndet medan Batch identifierar nodfelet och försöker schemalägga om uppgiften. Om ingen annan beräkningsnod är tillgänglig kan aktiviteten förbli i det tillståndet tills Batch kan schemalägga om den. Mer information finns i Kända begränsningar för Batch-uppgifter.
Om den ursprungliga noden återupptar felfria pulssignaler innan ersättningen påbörjas kan Batch återställa den till ett stabilt tillstånd. Om ersättningen redan har påbörjats kan Batch i stället ta bort den ursprungliga virtuella datorn och etablera en ersättning.
Ditt ansvar
Tjänstdriven återställning garanterar inte oavbruten aktivitetskörning eller tillräcklig återstående kapacitet. Du ansvarar för följande åtgärder:
Upprätthåll tillräcklig kapacitet: Om din arbetsbelastning måste fortsätta när en nod inte är tillgänglig etablerar du tillräckligt med noder för att de återstående noderna ska kunna köra omplanerade uppgifter. Utan någon annan användbar nod måste avbrutna uppgifter vänta.
Övervaka användbar kapacitet: Spåra antal och tillstånd för aggregerade noder så att du kan identifiera när en pool inte längre har tillräckligt med användbara noder för din arbetsbelastning. Tillstånd som
unusable,startTaskFailed,unknownochpreemptedanger minskad kapacitet. Mer information finns i Övervaka Batch-lösningar genom att räkna uppgifter och noder efter tillstånd.Undersök problemnoder: Om uppgifter upprepade gånger misslyckas, sparas på nytt eller förblir i tillståndet
runningnär deras tilldelade nod blir oanvändbar eller lämnar poolen använder du uppgiftsmetadata för att avgöra om problemen är associerade med en specifik nod.Innan du tar bort en problemnod laddar du upp dess Batch-nodagentloggar och bevarar relevanta aktivitetsloggar eftersom borttagningen av noden tar bort dess lokala filer. Nodagentloggar kan hjälpa Microsoft Support att diagnostisera Batch-tjänst- eller nodproblem, medan aktivitetsloggar som stdout och stderr kan hjälpa dig att identifiera program- och konfigurationsproblem. Mer information finns i Nodagentens loggfiler.
Skydda aktivitetens förlopp och data: Utforma uppgifter för att tolerera avbrott och omkörning. Flytta checkpoints, utdata och andra varaktiga data från beräkningsnoder eftersom deras lokala lagring är icke-beständig.
Mer information finns i artiklarna Azure Batch pool- och nodfel och Felhantering och identifiering i Azure Batch.
Motståndskraft mot fel i tillgänglighetszonen
Tillgänglighetszoner är fysiskt separata grupper av datacenter i en Azure-region. När en zon misslyckas kan tjänsterna redundansväxla till en av de återstående zonerna.
Batch stöder tillgänglighetszoner på två huvudsakliga sätt:
Styrplan: Batch-styrplanet är zonmotståndskraftigt i många regioner. I dessa regioner kan hanteringsåtgärder mot Batch-konton och andra Batch-resurser fortsätta under ett zonfel. Microsoft publicerar inte vilka regioner som ger resiliens för kontrollplanet.
Pooler: Du kan konfigurera en Batch-pool så att den använder placering i tillgänglighetszonen. Om en zon blir otillgänglig förblir beräkningsnoder i felfria zoner tillgängliga för schemaläggning av aktiviteter.
För placering av beräkningsnoder liknar den här stödmodellen zonredundans i andra Azure tjänster eftersom en enda pool kan innehålla beräkningsnoder i flera tillgänglighetszoner. Batch distribuerar dock noder mellan zoner i möjligaste mån. Den försöker använda alla zoner i regionen men garanterar inte placering i varje zon eller en jämn fördelning. Du kan inte välja specifika zoner eller styra antalet noder som placeras i varje zon.
Följande diagram visar ett exempel på ett Batch-konto. Kontot har en enda pool med sina noder fördelade på tre tillgänglighetszoner:
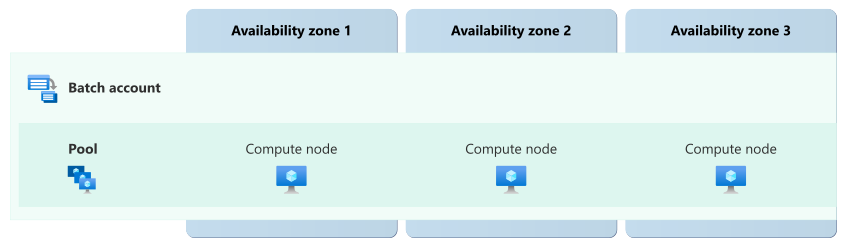
Diagrammet visar ett Batch-konto som innehåller en pool. Poolen har tre beräkningsnoder, där en nod visas i var och en av tillgänglighetszonerna 1, 2 och 3. Placering av tillgänglig zon gäller för beräkningsnoderna och avgör inte zonresiliensen för Batch-kontrollplanet. Fördelningen är ett exempel eftersom Batch använder balansering med bästa förmåga och inte garanterar en nod i varje zon.
Du ansvarar för att göra andra resurser som är beroende av andra, till exempel lagringskonton, zonredundanta. Granska tillförlitlighetsguiderna för varje tjänst. Mer information finns i guider för tillförlitlighet för Azure-tjänster.
Kravspecifikation
Regionstöd: Skapa poolen i en Azure region som stöder tillgänglighetszoner.
SKU-tillgänglighet för virtuella datorer: Den valda vm-SKU:n måste vara tillgänglig i mer än en zon i regionen. Använd Resource SKUs List API för att kontrollera
locationInfofältet för VM-SKU:n.Prenumerationsåtkomst: För ett allokeringsläge för användarprenumerationspool får prenumerationen inte ha någon zonerbjudandebegränsning för den valda virtuella dator-SKU:n. Kontrollera
ResourceSkuRestrictionsi API-svaret för Resource SKUs List. Om det finns en begränsning, skickar du en supportbegäran för att begära att den tas bort.Kommunikation mellan noder: En pool kan inte använda en placeringsprincip för tillgänglighetszoner när kommunikation mellan noder är aktiverad med en InfiniBand-aktiverad VM-SKU.
Instansdistribution mellan zoner
När du aktiverar placering av tillgänglighetszoner försöker Batch allokera beräkningsnoder över alla tillgänglighetszoner i den valda regionen. Den här allokeringen utförs i mån av möjlighet. Batch styr fördelningen, och antalet noder i varje zon kanske inte är lika många.
Cost
Batch lägger inte till någon avgift för att aktivera placering av tillgänglighetszoner. Du debiteras för beräkning, lagring, nätverk och andra Azure resurser som används av arbetsbelastningen. Om du provisionerar extra noder för att tolerera förlust av en zon medför dessa noder sina normala avgifter. Mer information finns i prisinformation för Azure Batch.
Konfigurera stöd för tillgänglighetszoner
Skapa en ny pool med placering i tillgänglighetszon: Information om hur du skapar en pool med placering i tillgänglighetszon aktiverad finns i Skapa en Batch-pool mellan tillgänglighetszoner.
Ändra placering av tillgänglighetszon på en befintlig pool: Du måste välja placering av tillgänglighetszon när du skapar poolen. Du kan inte ändra en befintlig pool så att den använder tillgänglighetszoner.
Du kan skapa en ersättningspool och uppdatera vart och ett av dina jobb så att de använder den genom att följa stegen nedan:
Inaktivera jobbet: Använd åtgärden Inaktivera jobb och välj hur Batch hanterar uppgifter som körs när du skickar begäran:
-
Vänta: Batch slutar starta nya aktiviteter och gör att aktiviteter som körs kan slutföras i den befintliga poolen. Jobbet förblir i
disablingtillståndet tills de aktiviteter som körs har slutförts. - Lägg tillbaka i kön: Batch avbryter körningen av uppgifter och returnerar dem till kön. Aktiviteterna kan köras igen när du har aktiverat jobbet.
- Avsluta: Batch avbryter körningen av aktiviteter och markerar dem som slutförda med felinformation som anger att de har avbrutits. Uppgifterna körs inte igen när du har aktiverat körningen.
Uppgifter som redan är i
activetillståndet, vilket innebär att de är i kö men inte körs, förblir i kö med alla alternativ.Vänta tills jobbet når tillståndet
disabledinnan du fortsätter. Då körs inga aktiviteter och Batch schemalägger inte nya aktiviteter.-
Vänta: Batch slutar starta nya aktiviteter och gör att aktiviteter som körs kan slutföras i den befintliga poolen. Jobbet förblir i
Redigera jobbets pool: Använd åtgärden Uppdatera jobb för att ange jobbets
poolInfo.poolIdtill ersättningspoolen. Batch tillåter endast att den här egenskapen ändras medan jobbet är idisabledtillståndet. Kontrollera att ersättningspoolen finns och har användbar kapacitet innan du aktiverar jobbet. Om poolen inte finns accepterar Batch uppdateringen, men den kan inte schemalägga aktiviteter förrän du har skapat poolen.Aktivera jobbet: Använd åtgärden Aktivera jobb . Jobbet övergår genom tillståndet
enablingtill tillståndetactive. Batch schemalägger sedan köade uppgifter, inklusive uppgifter som returneras till kön med alternativet Requeue på ersättningspoolen. Uppgifter som slutfördes medan Batch använde alternativet Vänta och uppgifter som slutfördes med alternativet Avsluta körs inte igen.
Kapacitetsplanering och -hantering
Batchs normala nodåterställningsprocess försöker ersätta noder som blir oanvändbara vid ett zonfel och återställer poolen till det konfigurerade antalet målnoder. Det ökar inte målvärdet. Om du vill behålla tillräckligt med kapacitet för att arbetsbelastningen ska fortsätta när en zon inte är tillgänglig kan du överetablera poolens kapacitet med autoskalning eller manuellt:
Om du använder autoskalning: Referera till den
$UsableNodeCounttjänstdefinierade variabeln i poolens autoskalningsformel för att identifiera när användbar kapacitet understiger den baslinje som din arbetsbelastning kräver.$UsableNodeCountär en batch-autoskalningsvariabel för poolen vars formel utvärderas, inte ett Azure Monitor mått. Azure Monitor publicerar måttvärden för antalet Batch-noder i Batch-kontoomfånget och dessa mått har ingenpoolId-dimension.Om du hanterar kapaciteten manuellt: Använd åtgärden List Pool Node Counts för att hämta dedikerade nodantal och antal Spot-noder i varje tillstånd för varje pool. Åtgärden returnerar inte ett enda värde för antalet användbara noder. Utvärdera uppgiftskompatibla tillstånd som
idleochrunningmot otillgängliga tillstånd eller problemtillstånd somunusable,unknown,offlineochstartTaskFailed. Det returnerade antalet kanske inte är aktuellt, så enumerera poolens beräkningsnoder när du behöver ett exakt antal.
Batch distribuerar noder mellan zoner i möjligaste mån, så den faktiska fördelningen kanske inte är jämnt fördelad. Anta inte att noder distribueras lika mellan zoner när du planerar kapacitet. Verifiera att din arbetsbelastning kan uppfylla sina återställningsmål med minskad poolkapacitet.
Beteende när alla zoner är felfria
I det här avsnittet beskrivs vad du kan förvänta dig när en Batch-pool använder placering av tillgänglighetszoner och alla zoner är i drift.
Drift över zoner: Batch schemalägger uppgifter på tillgängliga beräkningsnoder i hela poolen, oavsett vilken zon som innehåller varje nod.
Datareplikering mellan zoner: Batch-beräkningsnoder är tillfälliga och Batch replikerar inte aktivitetsfiler mellan zoner. Du ansvarar för att flytta indata, utdata, kontrollpunkter och diagnostikdata som måste överleva nodförlust till varaktig lagring. Konfigurera lagringskontots redundans så att den uppfyller dina tillgänglighetskrav.
Beteende vid ett zonfel
I det här avsnittet beskrivs vad du kan förvänta dig när en Batch-pool använder placering av tillgänglighetszoner och en tillgänglighetszon inte är tillgänglig.
Identifiering och åtgärd: Microsoft övervakar Batch-tjänsten och beräkningsnodens hälsa. Vid ett zonfel identifierar Batch ihållande uteblivna pulssignaler från berörda noder och startar sin normala nodåterställningsprocess. Noder i felfria zoner är fortfarande tillgängliga och Batch kan fortsätta att schemalägga uppgifter på dem.
Batch försöker återställa poolen till det konfigurerade antalet målnoder genom sin normala återställningsprocess, men det ökar inte det målantalet. Du ansvarar för att begära ytterligare kapacitet om målresursen inte tillhandahåller tillräckligt med kapacitet för arbetsbelastningen.
- Anmälan: Microsoft meddelar dig inte automatiskt när en zon är nere. Du kan dock använda Azure Service Health för att förstå tjänstens övergripande hälsotillstånd, inklusive eventuella zonfel, och du kan konfigurera Service Health-aviseringar för att meddela dig om problem.
Aktiva uppgifter: Uppgifter som körs på berörda noder avbryts. Batch kan schemalägga om aktiviteter på tillgängliga noder som en del av dess interna återställningsbeteende. Utforma uppgifter för att tolerera återförsök och återkörning, enligt beskrivningen i Motståndskraft mot tillfälliga fel och motståndskraft mot beräkningsnodfel.
Förväntad dataförlust: Filer på berörda beräkningsnoder är inte tillgängliga under driftstoppet och går förlorade om noderna avbildas om eller tas bort från poolen. Batch replikerar inte dessa filer mellan zoner. Data som sparas till varaktig lagring är fortfarande tillgängliga enligt lagringsresursens redundanskonfiguration.
Förväntad stilleståndstid: Uppgifter på friska noder fortsätter. Avbrutna uppgifter får driftstopp tills Batch kan schemalägga om dem till användbara noder. Om det inte finns någon tillgänglig användbar nod kan en aktivitet förbli i tillståndet
runningtills Batch kan schemalägga om den. Återställningstiden beror på tillgänglig poolkapacitet och den köade arbetsbelastningen.Hanteringsåtgärder mot Batch-konton och andra Batch-resurser fortsätter om kontot finns i en region där kontrollplanet är zonmotståndskraftigt. I andra regioner kan hanteringsåtgärder vara otillgängliga tills den berörda zonen återställs.
Omfördelning: Efter ihållande heartbeat-förlust markerar Batch berörda noder som
unusableoch skickar dem för ersättning genom sin normala nodåterställningsprocess. Batch försöker återställa poolen till det konfigurerade antalet målnoder, men ersättningskapaciteten beror på kvoten och tillgången på virtuella datorer i de felfria zonerna.Jobb förblir associerade med poolen under den här processen. Batch fortsätter att schemalägga aktiviteter från aktiva jobb på användbara noder i felfria zoner. Om ersättningsnoder allokeras och blir användbara kan Batch även schemalägga aktiviteter på dessa noder.
Den här återställningsprocessen ökar inte antalet konfigurerade målnoder. Om din arbetsbelastning kräver kapacitet utöver det målet kan du öka den manuellt eller konfigurera poolens autoskalningsformel för att göra det.
Zonåterställning
Batch hanterar återställningsprocessen när en zon återställs efter ett fel. Batch följer samma process som definieras i Resiliens mot fel i beräkningsnoder.
Batch garanterar inte att noderna balanseras jämnt över tillgänglighetszoner efter återställning. Zonplacering sker fortfarande i mån av möjlighet.
Test för zonfel
Du kan inte simulera ett faktiskt avbrott i en Azure-tillgänglighetszon för testning. Använd i stället en icke-produktionspool för att avbryta representativa uppgifter och ta tillräckligt många beräkningsnoder ur drift för att uppskatta den förväntade kapacitetsförlusten. Överväg att använda följande nodåtgärder som stöds:
- Starta om valda noder.
- Inaktivera schemaläggning av uppgifter på valda noder.
- Ta bort markerade noder från poolen.
När en åtgärd gör att du kan välja hur du ska hantera aktiviteter som körs, väljer du alternativet Köa om så att Batch kan schemalägga de avbrutna aktiviteterna på de återstående noderna.
Under testet kontrollerar du att Batch schemalägger om avbrutna uppgifter och att reexecution inte ger duplicerade eller inkonsekventa utdata. Bekräfta att kontrollpunkter och utdata fortfarande är tillgängliga från varaktig lagring, övervakning identifierar nodförlust och minskad kapacitet, och arbetsbelastningen kan slutföras med den återstående kapaciteten.
Dessa åtgärder validerar uppgiftsavbrott och omplanering, idempotens, kontrollpunkter och beständig utdatahantering. De återskapar dock inte alla effekter av ett zonomfattande fel.
Motståndskraft mot regionomfattande fel
Ett Batch-konto och dess pooler är begränsade till en Azure region. Om det uppstår ett fel i regionen kan dina Batch-jobb och -pooler påverkas.
Batch replikerar inte konton, poolkonfiguration, jobb, uppgifter, programpaket eller uppgiftsdata till en annan region och tillhandahåller inte inbyggd redundansväxling mellan regioner. Du ansvarar för att distribuera och drifta en Batch-lösning för flera regioner när din arbetsbelastning måste tolerera ett regionomfattande fel.
Anpassade multiregionslösningar för motståndskraft
Om du vill skapa en lösning för flera regioner distribuerar du minst ett Batch-konto i varje region som återställningsdesignen använder. Batch-konton fungerar oberoende mellan regioner. Du ansvarar för att välja regioner, distribuera och drifta resurserna i varje region och samordna konfiguration, replikering, failover och failback.
Du kan utforma en aktiv-aktiv-metod som skickar arbete i flera regioner under normal drift eller en aktiv-passiv metod som håller den sekundära distributionen redo för failover. Aktiv-aktiv design kan minska återställningstiden eftersom båda driftsättningarna hanterar arbetsbelastningen under normal drift, medan aktiv-passiv design kan minska beräkningskostnaderna vid normal drift.
Följande lista innehåller exempel på ditt ansvar när du utformar lösningen:
Distribuering: Skapa i förväg batchkonton, pooler eller pooldistributionsdefinitioner, lagringskonton, nätverksresurser och andra beroenden i varje region. Kontrollera att varje vald region stöder Batch-funktioner, VM-storlekar och beroende tjänster som din arbetsbelastning kräver. Behåll varje Batch-konto och de lagringsresurser som används av dess uppgifter i samma region när det är möjligt för att undvika onödiga svarstider. Definiera Batch-konton, pooler och stödresurser med hjälp av infrastruktur som kod så att konfigurationen kan återskapas konsekvent mellan regioner.
Kvoter och kapacitet: Kontrollera tillämpliga Batch-konto-, prenumerations- och VM-familjekvoter i varje återställningsregion och begär ökningar före ett avbrott när det behövs. En kvot är en gräns, inte en kapacitetsgaranti. Tillgängligheten för virtuella datorer varierar beroende på region, VM-familj och över tid. Mer information finns i Batch-konton och kärnkvoter.
Datareplikering: Behåll programpaket, containeravbildningar, indata och referensdata tillgängliga i varje återställningsregion. Batch kopierar inte dessa objekt åt dig.
Lagringsreplikering: Konfigurera lagringsredundans och datareplikering mellan regioner baserat på målet för återställningspunkten. Kontrollera att replikerade data är tillgängliga från varje haveriberedskapsregion. Mer information om alternativ för lagringstillförlitlighet finns i Tillförlitlighet i Azure Blob Storage.
Regioninriktning: Om dina program fungerar med ditt Batch-konto bör du utforma dem så att de kan välja ett annat Batch-konto och dess associerade lagringsresurser utan att kräva en koddistribution.
Redundansväxling: Batch flyttar inte arbetsbelastningen automatiskt till en annan region. Du ansvarar för att upptäcka ett avbrott, bestämma hur avbrottet påverkar din arbetsbelastning, stoppa inlämningar till det berörda Batch-kontot, dirigera nytt arbete till ett Batch-konto i en fungerande region och bestämma om du vill skicka in avbrutna jobb på nytt. Arbets- eller aktivitetsutdata som du inte har replikerat utanför den berörda regionen kan vara otillgängliga eller förlorade. Återställningstiden beror på distributionsmodellen, tillgänglig kapacitet, datareplikering och automatisering.
Regionåterställning: När tjänstens tillgänglighet har återställts i den berörda regionen verifierar du Batch-kontot, pooler, lagringsberoenden och jobbtillståndet innan du dirigerar arbetet till den regionen. Stäm av duplicerade eller delvis slutförda uppgifter innan de skickas in igen. Batch samordnar inte den här processen eller stämmer inte av status mellan regionala konton.
Testning: Testa regelbundet den fullständiga regionala återställningsprocessen i en icke-produktionsmiljö. Simulera att en regional driftsättning blir otillgänglig, dirigera inskickningar till ett annat regionalt Batch-konto, verifiera åtkomsten till programpaket och indata, köra representativa jobb, samla in utdata och öva på att returnera den återställda driftsättningen till tjänst. Mät resultatet mot ditt mål för återställningstid och mål för återställningspunkt.
Säkerhetskopiering och återställning
Azure Batch är inte ett beständigt lager för indata och utdata för arbetsbelastningar. Microsoft underhåller Batch-tjänsten, men du ansvarar för att bevara den konfiguration och de data som behövs för att återskapa arbetsbelastningen:
Batch-konfiguration: Definiera Batch-konton, pooler, jobb och stödresurser med hjälp av infrastruktur som kod, till exempel Bicep och versionskontrollerade jobbdefinitioner. Dessa artefakter ger ett repeterbart sätt att återskapa konfigurationen i samma region eller i en annan region. Testa regelbundet att definitionerna kan driftsätta en pool och köra ett representativt jobb.
Batchmetadata: Batch behåller jobb- och uppgiftsposter tills du tar bort det associerade jobbet eller uppgiften, men dessa poster är inte en säkerhetskopia. Om du behöver behålla den här historiken bevarar du de nödvändiga posterna utanför Batch.
Data på beräkningsnoder: Beräkningsnoder är tillfälliga och deras filsystem är inte en säkerhetskopia eller ett beständigt arkiv. Data på en nod går förlorade när noden avbildas om eller lämnar en pool. Batch kan också ta bort aktivitetsfiler när deras kvarhållningsperiod har upphört att gälla. Spara nödvändiga utdata och diagnostikloggar till varaktig lagring innan en uppgift slutförs. För långvariga uppgifter, spara kontrollpunkter under körningen. Mer information finns i Behåll jobb- och aktivitetsutdata och Övervaka Azure Batch.
Data i autostorage-konton: Ett associerat autostorage-konto kan innehålla programpaket och aktivitetsresursfiler. Förutom att konfigurera redundans som uppfyller dina återställningsmål bör du överväga om du behöver skydda dessa data från oavsiktlig borttagning eller skada. Mer information finns i Säkerhetskopiering och återställning i Azure Blob Storage.
Återställnings- och återhämtningstestning
För att återställa distribuerar du Batch och resurskonfiguration som stöder Batch, återställer eller återansluter nödvändiga indata och programartefakter och skickar in det arbete som inte slutfördes igen. Testa regelbundet både resursrekonstruktion och återställning av data i en isolerad eller återställningsmiljö som inte är i produktion. Använd versionskontrollerade definitioner och säkerhetskopierade data, kör ett representativt jobb, verifiera resultatet och åtkomsten till beroenden och mät den uppnådda återställningstiden och återställningspunkten mot dina mål. Kontrollera att aktiviteterna är idempotenta så att att skicka in osäkert arbete igen inte skadar data eller skapar dubblettutdata.
Motståndskraft mot serviceunderhåll
Microsoft utför plattformsunderhåll och samordnar infrastrukturuppdateringar för Azure Batch och andra tjänster. Du ansvarar för att konfigurera pooluppdateringsbeteende och utforma uppgifter för att tolerera avbrott.
Underhåll av värddatorn: Azure använder underhållstekniker som live migration när det är möjligt. Om underhåll kräver att en beräkningsnod startas om eller flyttas kan aktiviteter som körs avbrytas och Batch kan schemalägga om dem. Gör uppgifter idempotenta och spara kontrollpunkter och utdata i beständig lagring.
Gästoperativsystem: Du ansvarar för att hålla gästoperativsystemet och Batch-nodagenten aktuella. Operativsystemets uppdateringsbeteende beror på avbildningen och uppdateringskonfigurationen. Med lämplig konfiguration kan automatiska os-avbildningsuppgraderingar för Batch-pooler uppdatera poolnoder utan att avbryta aktiviteter som körs. Automatiska operativsystemavbildningsuppgraderingar stöder inte alla Batch-operativsystemavbildningar.
Uppdateringar av nodagent: Automatiska OS-avbildningsuppgraderingar uppdaterar inte Batch-nodagenten automatiskt. Batch-nodagenter uppgraderas inte automatiskt när en pool har beräkningsnoder. Om du vill ta emot en nyare nodagent ändrar du storlek på poolen till noll noder och skalar upp den igen eller ersätter poolen. Innan du tar bort noder, bevara alla nödvändiga aktivitetsutdata och diagnostikloggar. Mer information finns i Uppdateringar av Batch-nodagenten.
Följ rekommendationerna för produktionsdriftsättning och vägledningen om beräkningsnodfel för att hjälpa arbetsbelastningen att fortsätta eller återhämta sig när underhåll avbryter aktiviteter eller gör beräkningsnoder otillgängliga.
Serviceavtal
Serviceavtal (SLA) för Azure-tjänster beskriver den förväntade tillgängligheten för varje tjänst och de villkor som din lösning måste uppfylla för att uppnå den tillgänglighetsförväntningen. Mer information finns i Serviceavtal för onlinetjänster.
Serviceavtalet för Azure Batch-tillgänglighet gäller för åtgärder som du utför mot Batch-API:et. Detaljerad information om vilka typer av operationer som ingår finns i SLA-formuleringen. Din poolstorlek, zondistribution och beroende tjänster påverkar tillgängligheten från slutpunkt till slutpunkt för arbetsbelastningen, men ändrar inte villkoren i Batch-SLA:n.