Kommentar
Åtkomst till den här sidan kräver auktorisering. Du kan prova att logga in eller ändra kataloger.
Åtkomst till den här sidan kräver auktorisering. Du kan prova att ändra kataloger.
Observera
Azure AI-sökning är tillgängligt via Azure-portalen, REST-API:er och Azure-SDK:er. Den ligger också till grund för Foundry IQ, det hanterade kunskapsskiktet som omvandlar företagsinnehåll till återanvändbara, behörighetsmedvetna kunskapsbaser för agenter i Microsoft Foundry-portalen.
Azure AI-sökning kan indexera Markdown-dokument och matriser i Azure Blob Storage med hjälp av en indexerare som vet hur man läser Markdown-data.
Den här handledningen visar hur du indexerar Markdown-filer via Markdown-parsningsläget och REST-API:erna för söktjänsten.
I den här handledningen:
- Ställ in exempeldata och konfigurera en
azureblobdatakälla - Skapa ett Azure AI-sökning index som ska innehålla sökbart innehåll
- Skapa och kör en indexerare för att läsa containern och extrahera sökbart innehåll
- Sök i indexet som du nyss skapade
Förutsättningar
Ett Azure konto med en aktiv prenumeration. Skapa ett konto kostnadsfritt.
Ett Azure Storage konto.
Visual Studio Code med klienttillägget REST.
Observera
Du kan använda en kostnadsfri söktjänst för denna handledning. Den kostnadsfria nivån begränsar dig till tre index, tre indexerare och tre datakällor. Den här handledningen skapar en av varje typ. Innan du börjar kontrollerar du att tjänsten har utrymme för att acceptera de nya resurserna.
Förbereda exempeldata
Skapa en Markdown-fil
Kopiera och klistra in följande Markdown i en fil med namnet sample_markdown.md. Exempeldata är en enda Markdown-fil som innehåller olika Markdown-element. Vi valde en Markdown-fil för att hålla oss under lagringsgränserna för den kostnadsfria nivån.
# Project Documentation
## Introduction
This document provides a complete overview of the **Markdown Features** used within this project. The following sections demonstrate the richness of Markdown formatting, with examples of lists, tables, links, images, blockquotes, inline styles, and more.
---
## Table of Contents
1. [Headers](#headers)
2. [Introduction](#introduction)
3. [Basic Text Formatting](#basic-text-formatting)
4. [Lists](#lists)
5. [Blockquotes](#blockquotes)
6. [Images](#images)
7. [Links](#links)
8. [Tables](#tables)
9. [Code Blocks and Inline Code](#code-blocks-and-inline-code)
10. [Horizontal Rules](#horizontal-rules)
11. [Inline Elements](#inline-elements)
12. [Escaping Characters](#escaping-characters)
13. [HTML Elements](#html-elements)
14. [Emojis](#emojis)
15. [Footnotes](#footnotes)
16. [Task Lists](#task-lists)
17. [Conclusion](#conclusion)
---
## Headers
Markdown supports six levels of headers. Use `#` to create headers:
"# Project Documentation" at the top of the document is an example of an h1 header.
"## Headers" above is an example of an h2 header.
### h3 example
#### h4 example
##### h5 example
###### h6 example
This is an example of content underneath a header.
## Basic Text Formatting
You can apply various styles to your text:
- **Bold**: Use double asterisks or underscores: `**bold**` or `__bold__`.
- *Italic*: Use single asterisks or underscores: `*italic*` or `_italic_`.
- ~~Strikethrough~~: Use double tildes: `~~strikethrough~~`.
## Lists
### Ordered List
1. First item
2. Second item
3. Third item
### Unordered List
- Item A
- Item B
- Item C
### Nested List
1. Parent item
- Child item
- Child item
## Blockquotes
> This is a blockquote.
> Blockquotes are great for emphasizing important information.
>> Nested blockquotes are also possible!
## Images
## Links
[Visit Markdown Guide](https://www.markdownguide.org)
## Tables
| Syntax | Description | Example |
|-------------|-------------|---------------|
| Header | Title | Header Cell |
| Paragraph | Text block | Row Content |
## Code Blocks and Inline Code
### Inline Code
Use backticks to create `inline code`.
### Code Block
```javascript
// JavaScript example
function greet(name) {
console.log(`Hello, ${name}!`);
}
greet('World');
```
## Horizontal Rules
Use three or more dashes or underscores to create a horizontal rule.
---
___
## Inline Elements
Sometimes, it’s useful to include `inline code` to highlight code-like content.
You can also emphasize text like *this* or make it **bold**.
## Escaping Characters
To render special Markdown characters, use backslashes:
- \*Asterisks\*
- \#Hashes\#
- \[Brackets\]
## HTML Elements
You can mix HTML tags with Markdown:
<table>
<tr>
<th>HTML Table</th>
<th>With Markdown</th>
</tr>
<tr>
<td>Row 1</td>
<td>Data 1</td>
</tr>
</table>
## Emojis
Markdown supports some basic emojis:
- :smile: 😄
- :rocket: 🚀
- :checkered_flag: 🏁
## Footnotes
This is an example of a footnote[^1]. Footnotes allow you to add notes without cluttering the main text.
[^1]: This is the content of the footnote.
## Task Lists
- [x] Complete the introduction
- [ ] Add more examples
- [ ] Review the document
## Conclusion
Markdown is a lightweight yet powerful tool for writing documentation. It supports a variety of formatting options while maintaining simplicity and readability.
Thank you for reviewing this example!
Ladda upp filen och få en anslutningssträng
Följ de här instruktionerna för att ladda upp filen sample_markdown.md till en container i ditt Azure Storage-konto. Du måste också hämta anslutningssträngen för lagringskontot. Anteckna reťazec pripojenia och containernamnet för senare användning.
Kopiera en url för söktjänsten och API-nyckeln
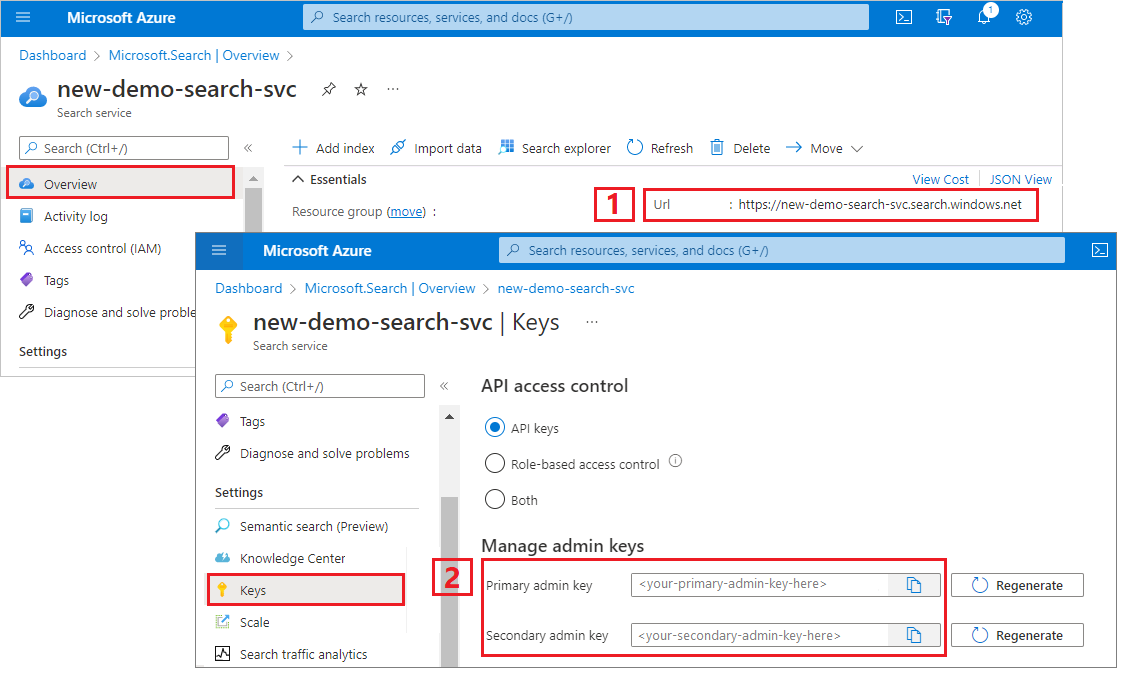
I den här självstudien kräver anslutningar till Azure AI-sökning en slutpunkt och en API-nyckel. Du kan hämta dessa värden från Azure-portalen. Alternativa anslutningsmetoder finns i Hanterade identiteter.
Gå till söktjänsten i Azure-portalen.
Välj Översikt i den vänstra rutan.
Anteckna URL:en, som bör se ut som
https://my-service.search.windows.net.Välj Inställningar>Nycklar i den vänstra rutan.
Anteckna en administratörsnyckel för fullständiga rättigheter i tjänsten. Det finns två utbytbara administratörsnycklar som tillhandahålls för affärskontinuitet om du behöver rulla över en. Du kan använda någon av nycklarna på begäranden för att lägga till, ändra och ta bort objekt.
Konfigurera REST-filen
Skapa en fil i Visual Studio Code.
Ange värden för variabler som används i begäran.
@baseUrl = PUT-YOUR-SEARCH-SERVICE-ENDPOINT-HERE
@apiKey = PUT-YOUR-ADMIN-API-KEY-HERE
@storageConnectionString = PUT-YOUR-STORAGE-CONNECTION-STRING-HERE
@blobContainer = PUT-YOUR-CONTAINER-NAME-HERE
Spara filen med hjälp av ett
.restfilnamnstillägg eller.httpfilnamnstillägg.
Hjälp med REST-klienten finns i Snabbstart: Fulltextsökning med REST.
Skapa en datakälla
Datakällor – Skapa (REST API) skapar en datakällaanslutning som anger vilka data som ska indexeras.
### Create a data source
POST {{baseUrl}}/datasources?api-version=2026-04-01  HTTP/1.1
Content-Type: application/json
api-key: {{apiKey}}

{
    "name" : "sample-markdown-ds",
    "description": null,
    "type": "azureblob",
    "subtype": null,
    "credentials": {
        "connectionString": "{{storageConnectionString}}"
    },
    "container": {
        "name": "{{blobContainer}}",
        "query": null
    },
    "dataChangeDetectionPolicy": null,
    "dataDeletionDetectionPolicy": null
}
Skicka begäran. Svaret bör se ut så här:
HTTP/1.1 201 Created
Transfer-Encoding: chunked
Content-Type: application/json; odata.metadata=minimal; odata.streaming=true; charset=utf-8
ETag: "0x8DCF52E926A3C76"
Location: https://<YOUR-SEARCH-SERVICE-NAME>.search.windows.net:443/datasources('sample-markdown-ds')?api-version=2026-04-01
Server: Microsoft-IIS/10.0
Strict-Transport-Security: max-age=2592000, max-age=15724800; includeSubDomains
Preference-Applied: odata.include-annotations="*"
OData-Version: 4.0
request-id: 0714c187-217e-4d35-928a-5069251e5cba
elapsed-time: 204
Date: Fri, 25 Oct 2024 19:52:35 GMT
Connection: close

{
  "@odata.context": "https://<YOUR-SEARCH-SERVICE-NAME>.search.windows.net/$metadata#datasources/$entity",
  "@odata.etag": "\"0x8DCF52E926A3C76\"",
  "name": "sample-markdown-ds",
  "description": null,
  "type": "azureblob",
  "subtype": null,
  "credentials": {
    "connectionString": null
  },
  "container": {
    "name": "markdown-container",
    "query": null
  },
  "dataChangeDetectionPolicy": null,
  "dataDeletionDetectionPolicy": null,
  "encryptionKey": null,
  "identity": null
}
Skapa ett index
Index – Skapa (REST API) skapar ett sökindex i söktjänsten. Ett index anger alla fält och deras attribut.
I en-till-många-parsning definierar sökdokumentet "många"-sidan av relationen. De fält som du anger i indexet avgör sökdokumentets struktur.
Du behöver bara fält för Markdown-elementen som parsern stöder. Följande fält är:
content: En sträng som innehåller den råa Markdown som finns på en specifik plats, baserat på huvudmetadata vid den tidpunkten i dokumentet.sections: Ett objekt som innehåller underfält för rubrikmetadata upp till önskad rubriknivå. NärmarkdownHeaderDepthär inställt påh3, innehåller den strängfält somh1,h2ochh3. Dessa fält indexeras genom att spegla den här strukturen i indexet eller genom fältmappningar i formatet/sections/h1,/sections/h2och så vidare. Exempel i kontexten finns i index- och indexerarkonfigurationerna i följande exempel. De underfält som ingår är:-
h1– En sträng som innehåller h1-huvudets värde. Tom sträng om den inte har angetts just nu i dokumentet. - (Valfritt)
h2– En sträng som innehåller h2-huvudets värde. Tom sträng om den inte har angetts just nu i dokumentet. - (Valfritt)
h3– En sträng som innehåller h3-huvudets värde. Tom sträng om den inte har angetts just nu i dokumentet. - (Valfritt)
h4– En sträng som innehåller värdet för h4-huvudet. Tom sträng om den inte har angetts just nu i dokumentet. - (Valfritt)
h5– En sträng som innehåller h5-huvudets värde. Tom sträng om den inte har angetts just nu i dokumentet. - (Valfritt)
h6– En sträng som innehåller h6-huvudets värde. Tom sträng om den inte har angetts just nu i dokumentet.
-
ordinal_position: Ett heltalsvärde som anger positionen för avsnittet i dokumenthierarkin. Det här fältet används för att ordna avsnitten i den ursprungliga sekvensen som de visas i dokumentet, med början med en ordningsposition på 1 och öka sekventiellt för varje innehållsblock.
Den här implementeringen använder fältmappningar i indexeraren för att mappa från det berikade innehållet till indexet. För mer information om den en-till-många-dokumentstruktur som parserats, se Index Markdown-blobar.
Det här exemplet innehåller exempel på hur du indexar data både med och utan fältmappningar. I det här fallet h1 innehåller dokumentets rubrik och mappar till ett fält med namnet title. Fälten h2 och h3 mappas till h2_subheaderh3_subheaderrespektive . Fälten content och ordinal_position kräver ingen mappning eftersom de extraheras från Markdown direkt till fält med hjälp av dessa namn. Ett exempel på ett fullständigt indexschema som inte kräver fältmappningar finns i slutet av det här avsnittet.
### Create an index
POST {{baseUrl}}/indexes?api-version=2026-04-01  HTTP/1.1
Content-Type: application/json
api-key: {{apiKey}}

{
  "name": "sample-markdown-index",
  "fields": [
    {"name": "id", "type": "Edm.String", "key": true, "searchable": true, "retrievable": true, "filterable": true, "facetable": true, "sortable": true},
    {"name": "content", "type": "Edm.String", "key": false, "searchable": true, "retrievable": true, "filterable": true, "facetable": true, "sortable": true},
    {"name": "title", "type": "Edm.String", "searchable": true, "retrievable": true, "filterable": true, "facetable": true, "sortable": true},
    {"name": "h2_subheader", "type": "Edm.String", "searchable": true, "retrievable": true, "filterable": true, "facetable": true, "sortable": true},
    {"name": "h3_subheader", "type": "Edm.String", "searchable": true, "retrievable": true, "filterable": true, "facetable": true, "sortable": true},
    {"name": "ordinal_position", "type": "Edm.Int32", "searchable": false, "retrievable": true, "filterable": true, "facetable": true, "sortable": true}
  ]
}
Indexschema i en konfiguration utan fältmappningar
Med fältmappningar kan du ändra och filtrera berikat innehåll så att det passar in i önskad indexform. Men du kanske bara vill ta det berikade innehållet direkt. I så fall skulle schemat se ut så här:
{
  "name": "sample-markdown-index",
  "fields": [
    {"name": "id", "type": "Edm.String", "key": true, "searchable": true, "retrievable": true, "filterable": true, "facetable": true, "sortable": true},
    {"name": "content", "type": "Edm.String", "key": false, "searchable": true, "retrievable": true, "filterable": true, "facetable": true, "sortable": true},
    {"name": "sections",
      "type": "Edm.ComplexType",
      "fields": [
        {"name": "h1", "type": "Edm.String", "searchable": true, "retrievable": true, "filterable": true, "facetable": true, "sortable": true},
        {"name": "h2", "type": "Edm.String", "searchable": true, "retrievable": true, "filterable": true, "facetable": true, "sortable": true},
        {"name": "h3", "type": "Edm.String", "searchable": true, "retrievable": true, "filterable": true, "facetable": true, "sortable": true}
      ]
    },
    {"name": "ordinal_position", "type": "Edm.Int32", "searchable": false, "retrievable": true, "filterable": true, "facetable": true, "sortable": true}
  ]
}
För att upprepa har vi underfält upp till h3 i avsnittsobjektet eftersom markdownHeaderDepth är inställt på h3.
Om du använder det här schemat måste du justera senare begäranden i enlighet med detta. Om du gör det måste du ta bort fältmappningarna från indexerarens konfiguration och uppdatera sökfrågorna för att använda motsvarande fältnamn.
Skapa och köra en indexerare
Indexerare – Skapa (REST API) skapar en indexerare i söktjänsten. En indexerare ansluter till datakällan, läser in och indexerar data, och du kan även ange ett schema för att automatisera datauppdateringen.
### Create and run an indexer
POST {{baseUrl}}/indexers?api-version=2026-04-01  HTTP/1.1
Content-Type: application/json
api-key: {{apiKey}}

{
  "name": "sample-markdown-indexer",
  "dataSourceName": "sample-markdown-ds",
  "targetIndexName": "sample-markdown-index",
  "parameters" : {
    "configuration": {
      "parsingMode": "markdown",
      "markdownParsingSubmode": "oneToMany",
      "markdownHeaderDepth": "h3"
      }
    },
  "fieldMappings" : [
    {
      "sourceFieldName": "/sections/h1",
      "targetFieldName": "title",
      "mappingFunction": null
    }
  ]
}
Viktiga punkter:
Indexeraren parsar endast rubriker upp till
h3. Alla rubriker på lägre nivå (h4,h5,h6) behandlas som oformaterad text och visas i fältetcontent. Därför finns index- och fältmappningarna bara upp till ett djup avh3.Fälten
contentochordinal_positionkräver ingen fältmappning eftersom de finns med dessa namn i det berikade innehållet.
Kör sökfrågor
Du kan börja söka så snart det första dokumentet har lästs in.
### Query the index
POST {{baseUrl}}/indexes/sample-markdown-index/docs/search?api-version=2026-04-01  HTTP/1.1
Content-Type: application/json
api-key: {{apiKey}}

{
  "search": "*",
  "count": true
}
Skicka begäran. Det här är en ospecificerad fulltextsökningsfråga som returnerar alla fält som markerats som hämtningsbara i indexet, tillsammans med ett antal dokument. Svaret bör se ut så här:
HTTP/1.1 200 OK
Transfer-Encoding: chunked
Content-Type: application/json; odata.metadata=minimal; odata.streaming=true; charset=utf-8
Content-Encoding: gzip
Vary: Accept-Encoding
Server: Microsoft-IIS/10.0
Strict-Transport-Security: max-age=2592000, max-age=15724800; includeSubDomains
Preference-Applied: odata.include-annotations="*"
OData-Version: 4.0
request-id: 6b94e605-55e8-47a5-ae15-834f926ddd14
elapsed-time: 77
Date: Fri, 25 Oct 2024 20:22:58 GMT
Connection: close

{
  "@odata.context": "https://<YOUR-SEARCH-SERVICE-NAME>.search.windows.net/indexes('sample-markdown-index')/$metadata#docs(*)",
  "@odata.count": 22,
  "value": [
    <22 search documents here>
  ]
}
Lägg till en search parameter för att söka efter en sträng.
### Query the index
POST {{baseUrl}}/indexes/sample-markdown-index/docs/search?api-version=2026-04-01  HTTP/1.1
Content-Type: application/json
api-key: {{apiKey}}

{
  "search": "h4",
  "count": true
}
Skicka begäran. Svaret bör se ut så här:
HTTP/1.1 200 OK
Transfer-Encoding: chunked
Content-Type: application/json; odata.metadata=minimal; odata.streaming=true; charset=utf-8
Content-Encoding: gzip
Vary: Accept-Encoding
Server: Microsoft-IIS/10.0
Strict-Transport-Security: max-age=2592000, max-age=15724800; includeSubDomains
Preference-Applied: odata.include-annotations="*"
OData-Version: 4.0
request-id: ec5d03f1-e3e7-472f-9396-7ff8e3782105
elapsed-time: 52
Date: Fri, 25 Oct 2024 20:26:29 GMT
Connection: close

{
  "@odata.context": "https://<YOUR-SEARCH-SERVICE-NAME>.search.windows.net/indexes('sample-markdown-index')/$metadata#docs(*)",
  "@odata.count": 1,
  "value": [
    {
      "@search.score": 0.8744742,
      "section_id": "aHR0cHM6Ly9hcmphZ2Fubmpma2ZpbGVzLmJsb2IuY29yZS53aW5kb3dzLm5ldC9tYXJrZG93bi10dXRvcmlhbC9zYW1wbGVfbWFya2Rvd24ubWQ7NA2",
      "content": "#### h4 example\r\n##### h5 example\r\n###### h6 example\r\nThis is an example of content underneath a header.\r\n",
      "title": "Project Documentation",
      "h2_subheader": "Headers",
      "h3_subheader": "h3 example",
      "ordinal_position": 4
    }
  ]
}
Viktiga punkter:
Eftersom
markdownHeaderDepthär inställt påh3behandlas rubrikernah4,h5, ochh6som klartext, så de visas i fältetcontent.Ordningstalet här är
4. Det här innehållet visas på fjärde plats av de 22 totala innehållsavsnitten.
Lägg till en select parameter för att begränsa resultatet till färre fält. Lägg till en filter för att ytterligare begränsa sökningen.
### Query the index
POST {{baseUrl}}/indexes/sample-markdown-index/docs/search?api-version=2026-04-01  HTTP/1.1
Content-Type: application/json
api-key: {{apiKey}}

{
  "search": "Markdown",
  "count": true,
  "select": "title, content, h2_subheader",
  "filter": "h2_subheader eq 'Conclusion'"
}
HTTP/1.1 200 OK
Transfer-Encoding: chunked
Content-Type: application/json; odata.metadata=minimal; odata.streaming=true; charset=utf-8
Content-Encoding: gzip
Vary: Accept-Encoding
Server: Microsoft-IIS/10.0
Strict-Transport-Security: max-age=2592000, max-age=15724800; includeSubDomains
Preference-Applied: odata.include-annotations="*"
OData-Version: 4.0
request-id: a6f9bd46-a064-4e28-818f-ea077618014b
elapsed-time: 35
Date: Fri, 25 Oct 2024 20:36:10 GMT
Connection: close

{
  "@odata.context": "https://<YOUR-SEARCH-SERVICE-NAME>.search.windows.net/indexes('sample-markdown-index')/$metadata#docs(*)",
  "@odata.count": 1,
  "value": [
    {
      "@search.score": 1.1029507,
      "content": "Markdown is a lightweight yet powerful tool for writing documentation. It supports a variety of formatting options while maintaining simplicity and readability.\r\n\r\nThank you for reviewing this example!",
      "title": "Project Documentation",
      "h2_subheader": "Conclusion"
    }
  ]
}
För filter kan du också använda logiska operatorer (och eller inte) och jämförelseoperatorer (eq, ne, gt, lt, ge, le). Strängjämförelser är skiftlägeskänsliga. Mer information och exempel finns i Skapa en fråga.
Observera
Parametern $filter fungerar bara på fält som har markerats som filterbara när indexet skapas.
Återställa och köra om
Indexerare kan återställas för att rensa körningshistoriken, vilket gör det möjligt med en fullständig återkörning. Följande begäranden återställer indexeraren och kör den igen.
### Reset the indexer
POST {{baseUrl}}/indexers/sample-markdown-indexer/reset?api-version=2026-04-01  HTTP/1.1
api-key: {{apiKey}}

### Run the indexer
POST {{baseUrl}}/indexers/sample-markdown-indexer/run?api-version=2026-04-01  HTTP/1.1
api-key: {{apiKey}}

### Check indexer status
GET {{baseUrl}}/indexers/sample-markdown-indexer/status?api-version=2026-04-01  HTTP/1.1
api-key: {{apiKey}}
Rensa resurser
När du arbetar i din egen prenumeration i slutet av ett projekt är det en bra idé att ta bort de resurser som du inte längre behöver. Resurser som lämnas igång kan kosta dig pengar. Du kan ta bort resurser individuellt eller ta bort resursgruppen för att ta bort hela uppsättningen resurser.
Du kan använda Azure-portalen för att ta bort index, indexerare och datakällor.
Nästa steg
Nu när du är bekant med grunderna i Azure Blob-indexering kan du titta närmare på indexerarkonfigurationen för Markdown-blobbar i Azure Storage: