หมายเหตุ
การเข้าถึงหน้านี้ต้องได้รับการอนุญาต คุณสามารถลอง ลงชื่อเข้าใช้หรือเปลี่ยนไดเรกทอรีได้
การเข้าถึงหน้านี้ต้องได้รับการอนุญาต คุณสามารถลองเปลี่ยนไดเรกทอรีได้
นําไปใช้กับ:✅ จุดสิ้นสุดการวิเคราะห์ SQL และ Warehouse ใน Microsoft Fabric
สำคัญ
คุณลักษณะนี้อยู่ในแสดงตัวอย่าง
การจัดกลุ่มข้อมูลใน Fabric คลังข้อมูล จัดระเบียบข้อมูลเพื่อประสิทธิภาพการสืบค้นที่เร็วขึ้นและลดการใช้การประมวลผล บทช่วยสอนนี้จะอธิบายขั้นตอนในการสร้างตารางที่มีการจัดกลุ่มข้อมูล ตั้งแต่การสร้างตารางแบบคลัสเตอร์ไปจนถึงการตรวจสอบประสิทธิภาพ
ข้อกําหนดเบื้องต้น
- บัญชีผู้เช่า Microsoft Fabric ที่มีการสมัครใช้งานที่ใช้งานอยู่
- ตรวจสอบให้แน่ใจว่า คุณมีพื้นที่ทํางานที่เปิดใช้งาน Microsoft Fabric: สร้างพื้นที่ทํางาน
- ตรวจสอบให้แน่ใจว่าคุณได้สร้างคลังสินค้าแล้ว เมื่อต้องการสร้างคลังสินค้าใหม่ โปรดดูที่ สร้างคลังสินค้าใน Microsoft Fabric
- ความเข้าใจพื้นฐานเกี่ยวกับ T-SQL และการสืบค้นข้อมูล
นำเข้าข้อมูลตัวอย่าง
บทช่วยสอนนี้ใช้ชุดข้อมูลตัวอย่าง NY Taxi เพื่อนําเข้าข้อมูล NY Taxi ไปยังคลังสินค้าของคุณ ใช้บทช่วยสอนการโหลดข้อมูลตัวอย่างไปยังคลังข้อมูล
สร้างตารางที่มีการจัดกลุ่มข้อมูล
สําหรับบทช่วยสอนนี้เราต้องการสําเนาตาราง NYTaxi สองชุด: สําเนาปกติของตารางที่นําเข้าจากบทช่วยสอนและสําเนาที่ใช้การจัดกลุ่มข้อมูล ใช้คําสั่งต่อไปนี้เพื่อสร้างตารางใหม่โดยใช้ CREATE TABLE AS SELECT (CTAS) ตามตาราง NYTaxi เดิม:
CREATE TABLE nyctlc_With_DataClustering
WITH (CLUSTER BY (lpepPickupDatetime))
AS SELECT * FROM nyctlc
Note
ตัวอย่างนี้ถือว่าชื่อตารางที่กําหนดให้กับชุดข้อมูล NY Taxi ในบทช่วยสอน โหลดข้อมูลตัวอย่างไปยังคลังข้อมูล ถ้าคุณใช้ชื่ออื่นสําหรับตารางของคุณ ให้ปรับคําสั่งเพื่อแทนที่ nyctlc ด้วยชื่อตารางของคุณ
คําสั่งนี้จะสร้างสําเนาที่แน่นอนของตาราง NYTaxi ต้นฉบับ แต่มีการจัดกลุ่มข้อมูลบน lpepPickupDatetime คอลัมน์ ต่อไปเราจะใช้คอลัมน์นี้สําหรับการสืบค้น
ข้อมูลคิวรี
เรียกใช้แบบสอบถามบนตาราง NYTaxi และทําซ้ําแบบสอบถามเดียวกันทุกประการบนตาราง NYTaxi_With_DataClustering เพื่อเปรียบเทียบ
Note
สําหรับการวิเคราะห์นี้ จะเป็นประโยชน์ในการดูประสิทธิภาพของแคชเย็นของการเรียกใช้ทั้งสองครั้ง นั่นคือ โดยไม่ต้องใช้คุณสมบัติการแคชของ Fabric คลังข้อมูล ดังนั้น ให้เรียกใช้แต่ละคิวรีหนึ่งครั้งก่อนที่คุณจะดูผลลัพธ์ในข้อมูลเชิงลึกของคิวรี
เราใช้คิวรีที่มักทําซ้ําในคลังสินค้า การสอบถามนี้จะคํานวณจํานวนค่าโดยสารเฉลี่ยตามปีระหว่างวันที่ 2008-12-31 และ 2014-06-30:
SELECT
    YEAR(lpepPickupDatetime),
    AVG(fareAmount) as [Average Fare]
FROM
    NYTaxi
WHERE
    lpepPickupDatetime BETWEEN '2008-12-31' AND '2014-06-30'
GROUP BY
    YEAR(lpepPickupDatetime)
ORDER BY
    YEAR(lpepPickupDatetime) DESC
OPTION (LABEL = 'Regular');
Note
ตัวเลือกป้ายชื่อที่ใช้ในคิวรีนี้มีประโยชน์เมื่อเราเปรียบเทียบรายละเอียดคิวรีของตารางกับรายละเอียดRegularที่ใช้การจัดกลุ่มข้อมูลในภายหลังโดยใช้มุมมองข้อมูลเชิงลึกของคิวรี
ต่อไป เราจะทําซ้ําคิวรีเดียวกันทุกประการ แต่ในเวอร์ชันของตารางที่ใช้การจัดกลุ่มข้อมูล:
SELECT
    YEAR(lpepPickupDatetime),
    AVG(fareAmount) as [Average Fare]
FROM
    NYTaxi_With_DataClustering
WHERE
    lpepPickupDatetime BETWEEN '2008-12-31' AND '2014-06-30'
GROUP BY
    YEAR(lpepPickupDatetime)
ORDER BY
    YEAR(lpepPickupDatetime) DESC
OPTION (LABEL = 'Clustered');
คิวรีที่สองใช้ป้ายชื่อClusteredเพื่อให้เราสามารถระบุคิวรีนี้ในภายหลังด้วยข้อมูลเชิงลึกของคิวรี
ตรวจสอบประสิทธิภาพของการจัดกลุ่มข้อมูล
หลังจากตั้งค่าการจัดกลุ่มแล้ว คุณสามารถประเมินประสิทธิภาพได้โดยใช้ข้อมูลเชิงลึกของคิวรี ข้อมูลเชิงลึกของคิวรีใน Fabric คลังข้อมูล จะรวบรวมข้อมูลการดําเนินการคิวรีในอดีตและรวมเป็นข้อมูลเชิงลึกที่นําไปใช้ได้จริง เช่น การระบุคิวรีที่ทํางานเป็นเวลานานหรือดําเนินการบ่อย
ในกรณีนี้ เราใช้ Query Insights เพื่อเปรียบเทียบความแตกต่างของข้อมูลที่สแกนระหว่างกรณีปกติและกรณีคลัสเตอร์
ใช้การสอบถามต่อไปนี้:
SELECT
    label,
    submit_time,
    row_count,
    total_elapsed_time_ms,
    allocated_cpu_time_ms,
    result_cache_hit,
    data_scanned_disk_mb,
    data_scanned_memory_mb,
    data_scanned_remote_storage_mb,
    command
FROM
    queryinsights.exec_requests_history
WHERE
    command LIKE '%NYTaxi%'
    AND label IN ('Regular','Clustered')
ORDER BY
    submit_time DESC;
คิวรีนี้จะดึงรายละเอียดจาก exec_requests_history มุมมอง สําหรับข้อมูลเพิ่มเติม โปรดดู queryinsights.exec_requests_history (Transact-SQL)
แบบสอบถามจะกรองผลลัพธ์ด้วยวิธีต่อไปนี้:
- ดึงข้อมูลเฉพาะแถวที่มี
NYTaxiข้อความในชื่อคําสั่ง (ตามที่ใช้ในแบบสอบถามทดสอบ) - ดึงข้อมูลเฉพาะแถวที่ค่าป้ายชื่อเป็นแบบปกติหรือแบบคลัสเตอร์
Note
อาจใช้เวลาสักครู่เพื่อให้รายละเอียดคิวรีของคุณพร้อมใช้งานในข้อมูลเชิงลึกของคิวรี หากคิวรีข้อมูลเชิงลึกของคิวรีไม่แสดงผลลัพธ์ ให้ลองอีกครั้งหลังจากผ่านไป 2-3 นาที
การเรียกใช้แบบสอบถามนี้ เราจะสังเกตเห็นผลลัพธ์ต่อไปนี้:

การค้นหาทั้งสองมีจํานวนแถว 6 และเวลาในการส่งที่คล้ายกัน
Clusteredแบบสอบถามแสดงให้เห็นtotal_elapsed_time_msในปี 1794 allocated_cpu_time_ms ปี 1676 และ data_scanned_remote_storage_mb 77.519
Regularแบบสอบถามแสดง total_elapsed_time_ms 2651 จาก allocated_cpu_time_ms 2600 และ data_scanned_remote_storage_mb 177.700 ตัวเลขเหล่านี้แสดงให้เห็นว่าแม้ว่าการสืบค้นทั้งสองจะส่งคืนผลลัพธ์เดียวกัน แต่เวอร์ชันนี้ Clustered ใช้เวลา CPU น้อยกว่าเวอร์ชันประมาณ Regular 36% และสแกนข้อมูลบนดิสก์น้อยกว่าประมาณ 56% ไม่มีการใช้แคชในการเรียกใช้คิวรีทั้งสองอย่าง สิ่งเหล่านี้เป็นผลลัพธ์ที่สําคัญในการช่วยลดเวลาการดําเนินการคิวรีและการใช้ และทําให้ lpepPickupDatetime คอลัมน์เป็นตัวเลือกที่แข็งแกร่งสําหรับการจัดกลุ่มข้อมูล
Note
นี่คือตารางขนาดเล็กที่มีประมาณ 76 ล้านแถวและปริมาณข้อมูล 2GB แม้ว่าคิวรีนี้จะส่งกลับเพียงหกแถวในการรวม (หนึ่งแถวสําหรับแต่ละปีในช่วง) แต่จะสแกนประมาณ 8.3 ล้านแถวในช่วงวันที่ที่ให้ไว้ก่อนที่จะรวมผลลัพธ์ ข้อมูลการผลิตจริงที่มีปริมาณข้อมูลที่มากขึ้นสามารถให้ผลลัพธ์ที่สําคัญกว่าได้ ผลลัพธ์ของคุณอาจแตกต่างกันไปตามขนาดความจุ ผลลัพธ์ที่แคชไว้ หรือการทํางานพร้อมกันระหว่างการสืบค้น
เลือกคอลัมน์การจัดกลุ่มจากงานของคุณ
สําหรับตารางการผลิต ให้ใช้รูปแบบการค้นหาที่สังเกตได้แทนการเดาว่าคอลัมน์ใดจะถูกจัดกลุ่ม ความสามารถในการปฏิบัติการของทักษะนี้sqldw-cliวิเคราะห์ประวัติ Query Insights จัดอันดับรูปแบบการสืบค้นซ้ําตามข้อมูลที่สแกนจากระยะไกล และระบุคอลัมน์ที่ใช้ในWHEREเงื่อนไข
ก่อนเริ่ม ให้ติดตั้ง Skills for Fabric ตรวจสอบให้แน่ใจว่าคลังข้อมูลมีคําสั่งค้นหาล่าสุด และยืนยันว่าคุณมีบทบาท Contributor workspace หรือสูงกว่า จากนั้นเปิด GitHub Copilot CLI และใช้พรอมต์แบบนี้:
Use the sqldw-cli skill to recommend clustering columns for
<workspace-name>/<warehouse-name> based on the last seven days of workload.
Rank candidates by total remote data scanned, consider columns used in WHERE
predicates, and explain each column's cardinality and data type suitability.
Use read-only diagnostics.
ทักษะนี้จะระบุรูปแบบคําค้นหาที่มีผลกระทบต่อการสแกนมากที่สุด ดึงตารางและคอลัมน์กรองจากคําค้นหาเหล่านั้น และจัดอันดับผู้สมัครในการจัดกลุ่ม ทบทวนคําแนะนําตามแนวทางเหล่านี้:
- โปรดใช้คอลัมน์ที่กรองตารางขนาดใหญ่ซ้ํา ๆ และใช้ค่าความเป็นสมาชิกระดับกลางถึงสูง เช่น วันที่หรือตัวระบุ
- คอลัมน์โปรดปรามที่ใช้ในเงื่อนไขช่วงเลือกหรือเท่าเทียมใน
WHEREคลอส - อย่าเลือกคอลัมน์เพียงเพราะมันปรากฏในเงื่อนไขการเชื่อมเท่ากัน เงื่อนไขเหล่านี้ไม่ได้รับประโยชน์จากการจัดกลุ่มข้อมูล
- ใช้คอลัมน์จัดกลุ่มไม่เกินสี่คอลัมน์ และอย่าเพิ่มคอลัมน์เกินกว่าปริมาณงานที่ต้องการ
ตัวอย่างเช่น ลองพิจารณาคลังสินค้าอีคอมเมิร์ซที่มี Sales.SalesOrder 1.5 พันล้านแถว และมี Sales.OrderLine 6 พันล้านแถว หลังจากวิเคราะห์คําค้นที่เกิดซ้ํา ทักษะอาจส่งคืนคําแนะนําเหล่านี้:
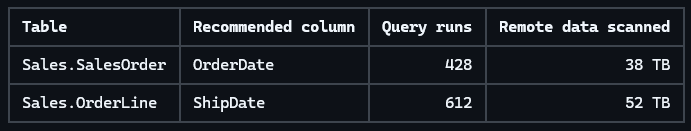
คอลัมน์วันที่เป็นตัวเลือกที่แข็งแกร่งเพราะกรองตารางที่ใหญ่ที่สุด รองรับเงื่อนไขช่วงที่พบบ่อย และให้โอกาสในการข้ามไฟล์ได้มากกว่าคอลัมน์ที่มีจํานวนจํากัดต่ํา เช่น OrderStatus หรือSalesRegion
sqldw-cliความสามารถในการปฏิบัติการเป็นแบบอ่านอย่างเดียว มันแนะนําคอลัมน์แต่ไม่สร้างหรือแทนที่ตาราง หลังจากที่คุณตรวจสอบคําแนะนําแล้ว ให้ใช้ CTAS เพื่อสร้างสําเนาตารางแบบคลัสเตอร์:
CREATE TABLE Sales.SalesOrder_clustered
WITH (CLUSTER BY (OrderDate))
AS
SELECT * FROM Sales.SalesOrder;
เปรียบเทียบเวิร์กโหลดแบบคลัสเตอร์และไม่มีคลัสเตอร์เพื่อยืนยันผลกระทบ หลังจากที่คุณตรวจสอบความถูกต้องของตารางที่ถูกจัดกลุ่มแล้ว ให้เปลี่ยนชื่อตารางเดิม แล้วเปลี่ยนชื่อตารางที่ถูกจัดกลุ่มเป็นชื่อเดิม:
EXEC sp_rename 'Sales.SalesOrder', 'SalesOrder_old';
EXEC sp_rename 'Sales.SalesOrder_clustered', 'SalesOrder';
ตารางต้นฉบับยังคงมีให้ใช้สําหรับการ Sales.SalesOrder_old ย้อนกลับ ตรวจสอบงานที่ขึ้นกับตารางใหม่และตารางใหม่ก่อนลบตารางเดิม เมื่อคุณไม่ต้องการสําเนาย้อนกลับอีกต่อไป ให้ทิ้งมัน:
DROP TABLE Sales.SalesOrder_old;