Not
Bu sayfaya erişim yetkilendirme gerektiriyor. Oturum açmayı veya dizinleri değiştirmeyi deneyebilirsiniz.
Bu sayfaya erişim yetkilendirme gerektiriyor. Dizinleri değiştirmeyi deneyebilirsiniz.
Bu öğreticinin önceki aşamasında, makinenize PyTorch'u yükledik. Şimdi bunu kullanarak modelimizi oluşturmak için kullanacağımız verilerle kodumuzu ayarlayacağız.
Visual Studio'da yeni bir proje açın.
- Visual Studio'yu açın ve öğesini seçin
create a new project.
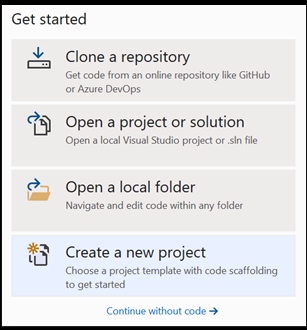
- Arama çubuğuna yazın
Pythonve proje şablonunuz olarak seçinPython Application.

- Yapılandırma penceresinde:
- Projenize bir ad verin. Burada Buna DataClassifier diyoruz.
- Projenizin konumunu seçin.
- VS2019 kullanıyorsanız işaretli olduğundan emin olun
Create directory for solution. - VS2017 kullanıyorsanız
Place solution and project in the same directoryişaretli olmadığından emin olun.
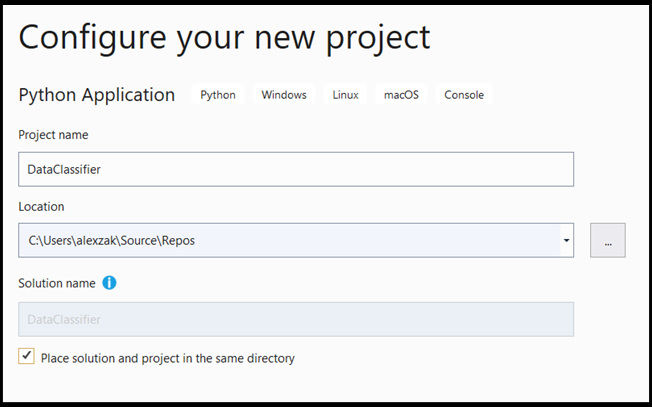
Projenizi oluşturmak için basın create .
Python yorumlayıcısı oluşturma
Şimdi yeni bir Python yorumlayıcısı tanımlamanız gerekir. Bu, yakın zamanda yüklediğiniz PyTorch paketini içermelidir.
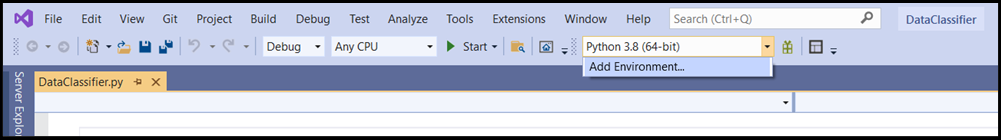
- Tercüman seçimine gidin ve
Add Environmentseçin.
-
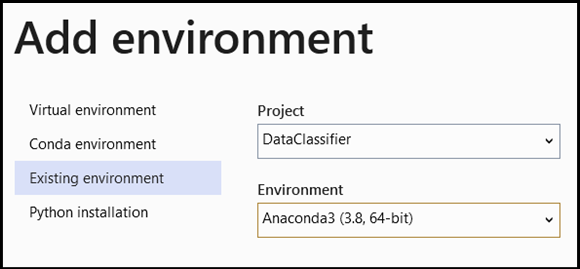
Add Environmentpenceresinde,Existing environmentseçin ve ardındanAnaconda3 (3.6, 64-bit)seçin. Buna PyTorch paketi de dahildir.
Yeni Python yorumlayıcısını ve PyTorch paketini test etmek için dosyaya DataClassifier.py aşağıdaki kodu girin:
from __future__ import print_function

import torch

x=torch.rand(2, 3)

print(x)
Çıkış, aşağıdakine benzer rastgele bir 5x3 tensor olmalıdır.

Uyarı
Daha fazla bilgi edinmek istiyor musunuz? PyTorch resmi web sitesini ziyaret edin.
Verileri anlama
Modeli Fisher'ın Iris çiçek veri kümesinde eğiteceğiz. Bu ünlü veri kümesi üç Iris türünün her biri için 50 kayıt içerir: Iris setosa, Iris virginica ve Iris versicolor.
Veri kümesinin çeşitli sürümleri yayımlandı. Iris veri kümesini UCI Machine Learning Deposu'nda bulabilir, veri kümesini doğrudan Python Scikit-learn kitaplığından içeri aktarabilir veya daha önce yayımlanmış başka bir sürümü kullanabilirsiniz. Iris çiçek veri kümesi hakkında bilgi edinmek için Wikipedia sayfasını ziyaret edin.
Bu öğreticide, modelin tablosal giriş türüyle nasıl eğitileceğini göstermek için Excel dosyasına dışarı aktarılan Iris veri kümesini kullanacaksınız.
Excel tablosunun her satırında dört Iris özelliği gösterilir: cm cinsinden sepal uzunluk, cm cinsinden sepal genişlik, cm'de taçyaprağı uzunluğu ve cm cinsinden petal genişliği. Bu özellikler girişiniz olarak görev yapacaktır. Son sütun bu parametrelerle ilgili Iris türünü içerir ve regresyon çıkışını temsil eder. Toplamda veri kümesi, her biri ilgili Iris türüyle eşleşen dört özellik içeren 150 giriş içerir.
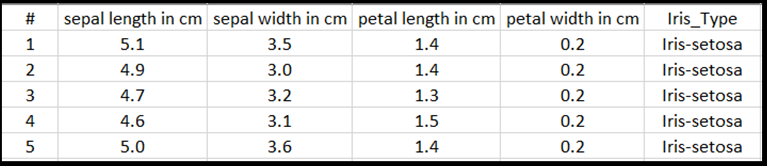
Regresyon analizi, giriş değişkenleri ile sonuç arasındaki ilişkiyi değerlendirir. Girişe bağlı olarak model, üç Iris türünden biri olan doğru çıkış türünü tahmin etmeyi öğrenecektir: Iris-setosa, Iris-versicolor, Iris-virginica.
Önemli
Kendi modelinizi oluşturmak için başka bir veri kümesi kullanmaya karar verirseniz, modelinizin giriş değişkenlerini ve çıkışını senaryonuza göre belirtmeniz gerekir.
Veri kümesini yükleyin.
Iris veri kümesini Excel biçiminde indirin. Burada bulabilirsiniz.
DataClassifier.pyÇözüm Gezgini Dosyaları klasöründeki dosyaya, ihtiyacımız olan tüm paketlere erişmek için aşağıdaki içeri aktarma deyimini ekleyin.
import torch
import pandas as pd
import torch.nn as nn
from torch.utils.data import random_split, DataLoader, TensorDataset
import torch.nn.functional as F
import numpy as np
import torch.optim as optim
from torch.optim import Adam
Gördüğünüz gibi, sinir ağları oluşturmak için modüller ve genişletilebilir sınıflar içeren torch.nn paketini ve verileri yüklemek ve işlemek için pandas (Python veri analizi) paketini kullanacaksınız.
- Verileri belleğe yükleyin ve sınıf sayısını doğrulayın. Her Iris türünde 50 öğe görmeyi bekliyoruz. Bilgisayarınızda veri kümesinin konumunu belirttiğinizden emin olun.
DataClassifier.py dosyasına aşağıdaki kodu ekleyin.
# Loading the Data
df = pd.read_excel(r'C:…\Iris_dataset.xlsx')
print('Take a look at sample from the dataset:')
print(df.head())

# Let's verify if our data is balanced and what types of species we have
print('\nOur dataset is balanced and has the following values to predict:')
print(df['Iris_Type'].value_counts())
Bu kodu çalıştırdığımızda beklenen çıkış aşağıdaki gibidir:

Veri kümesini kullanabilmek ve modeli eğitebilmek için giriş ve çıkış tanımlamamız gerekir. Giriş 150 satır özellik içerir ve çıktı Iris türü sütunudur. Kullanacağımız sinir ağı sayısal değişkenler gerektirdiğinden çıkış değişkenini sayısal biçime dönüştüreceksiniz.
- Veri kümesinde, çıkışı sayısal biçimde temsil edecek ve regresyon girişi ile çıkışı tanımlayacak yeni bir sütun oluşturun.
DataClassifier.py dosyasına aşağıdaki kodu ekleyin.
# Convert Iris species into numeric types: Iris-setosa=0, Iris-versicolor=1, Iris-virginica=2.
labels = {'Iris-setosa':0, 'Iris-versicolor':1, 'Iris-virginica':2}
df['IrisType_num'] = df['Iris_Type']   # Create a new column "IrisType_num"
df.IrisType_num = [labels[item] for item in df.IrisType_num]  # Convert the values to numeric ones

# Define input and output datasets
input = df.iloc[:, 1:-2]            # We drop the first column and the two last ones.
print('\nInput values are:')
print(input.head())
output = df.loc[:, 'IrisType_num']   # Output Y is the last column
print('\nThe output value is:')
print(output.head())
Bu kodu çalıştırdığımızda beklenen çıkış aşağıdaki gibidir:

Modeli eğitmek için model girişini ve çıkışını Tensor biçimine dönüştürmemiz gerekir:
- Tensor'a Dönüştür:
DataClassifier.py dosyasına aşağıdaki kodu ekleyin.
# Convert Input and Output data to Tensors and create a TensorDataset
input = torch.Tensor(input.to_numpy())      # Create tensor of type torch.float32
print('\nInput format: ', input.shape, input.dtype)     # Input format: torch.Size([150, 4]) torch.float32
output = torch.tensor(output.to_numpy())        # Create tensor type torch.int64
print('Output format: ', output.shape, output.dtype)  # Output format: torch.Size([150]) torch.int64
data = TensorDataset(input, output)    # Create a torch.utils.data.TensorDataset object for further data manipulation
Kodu çalıştırırsak, beklenen çıkış aşağıdaki gibi giriş ve çıkış biçimini gösterir:
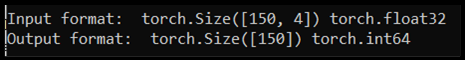
150 giriş değeri vardır. Yaklaşık 60% modelin eğitim verisi olacaktır. Doğrulama için 20% ve test için 30% tutarsınız.
Bu öğreticide, bir eğitim veri kümesinin küme boyutu 10 olarak tanımlanmıştır. Eğitim kümesinde 95 öğe vardır, yani eğitim kümesinden bir kez eğitimi tamamlamak için (bir dönem), ortalama olarak 9 tam parti vardır. Doğrulama ve test kümelerinin toplu iş boyutunu 1 olarak tutacaksınız.
- Kümeleri eğitmek, doğrulamak ve test etmek için verileri bölün:
DataClassifier.py dosyasına aşağıdaki kodu ekleyin.
# Split to Train, Validate and Test sets using random_split
train_batch_size = 10
number_rows = len(input)    # The size of our dataset or the number of rows in excel table.
test_split = int(number_rows*0.3)
validate_split = int(number_rows*0.2)
train_split = number_rows - test_split - validate_split
train_set, validate_set, test_set = random_split(
    data, [train_split, validate_split, test_split])

# Create Dataloader to read the data within batch sizes and put into memory.
train_loader = DataLoader(train_set, batch_size = train_batch_size, shuffle = True)
validate_loader = DataLoader(validate_set, batch_size = 1)
test_loader = DataLoader(test_set, batch_size = 1)
Sonraki Adımlar
Veriler kullanıma hazır olduğunda PyTorch modelimizi eğitme zamanı geldi