Fabric 中的湖仓结合了数据湖的可扩展性和数据仓库的查询能力。 你将结构化和非结构化数据存储在单个位置,使用 Delta Lake 对其进行管理,并使用 Apache Spark 和 SQL 对其进行分析,所有这些作无需在系统之间移动数据。 通过 OneLake的快捷方式 和 跨租户数据共享,你还可以访问来自外部来源和其他组织的受控数据,无需重复。
湖屋给你:
- 数据工程和分析工作负荷共用一个数据副本
- 用于 ACID 事务的 Delta Lake 格式、架构约束和时间旅行
- Spark 和 SQL 访问 ,以便数据工程师使用笔记本,而分析师则使用 T-SQL
- 内置集成与 Power BI、管道、数据流和其他 Fabric 项目
湖畔别墅 vs. 仓库
湖屋和仓库在Fabric中的主要区别在于你偏好的开发工具、数据类型和工作负载模式。 两者共享相同的 SQL 引擎并在 OneLake 上以 Delta 格式存储数据,但它们专为不同的方案而设计:
| Lakehouse | 仓库 | |
|---|---|---|
| 主要开发工具 | Apache Spark (Python、Scala、SQL、R) | T-SQL |
| 数据类型 | 结构化和非结构化 | 结构化 |
| 多表事务 | 否 | 是的 |
| 数据引入 | Notebook、流水线、数据流、 OneLake中的快捷方式 (实时访问且无副本) | T-SQL (COPY INTO、 INSERT、 CTAS、 管道) |
| 最适用于 | 数据工程、数据科学、奖牌体系结构 | BI 报告、维度建模、SQL 优先团队 |
可以在同一工作区中使用这两者,例如,使用 Spark 在湖仓中存储和转换数据,然后将整理好的数据集公开到仓库中,以便进行基于 SQL 的报表。 如需详细指导,请参见“ 选择仓库与湖边别墅”。
与 Lakehouse 数据协作
可以在 lakehouse 中,通过多个 Fabric 工具加载、转换和查询数据:
OneLake 中的快捷方式——无需将数据复制到湖仓,即可访问来自外部源的数据(包括通过 跨租户数据共享 访问其他租户中的数据)。 快捷方式提供对 OneLake 中操作和分析数据的实时只读引用。 请参见 OneLake中的快捷方式。
Lakehouse 资源管理器 - 浏览表和文件、加载数据以及直接在浏览器中管理元数据。 可以在表视图和文件视图之间切换,并将多个 lakehouse 添加到资源管理器。 详见 《Navigate the Lakehouse explorer》。

Spark SQL 查询资源管理器 - 直接在 Lakehouse 资源管理器中运行 Spark SQL 查询,而无需离开工作上下文。 查询浏览器支持 IntelliSense、动态选项卡、跨架构和跨湖仓查询、内联图表可视化以及创建视图。 请参阅Spark SQL 查询浏览器中的查询数据。
Notebooks — 编写 Spark 代码(Python、Scala、SQL、R),以读取、转换和将数据写入 lakehouse 表和文件夹。 请参阅 使用笔记本浏览数据 并使用 笔记本加载数据。
管道 - 使用复制活动和其他数据集成工具将数据从外部源拉取到 Lakehouse。 请参阅 使用复制活动复制数据。
Spark 作业定义 - 在生产级 ETL 的 Java、Scala 或 Python 中运行已编译的 Spark 应用程序。 请参阅什么是 Apache Spark 作业定义?
数据流第 2 代 - 使用低代码可视化界面引入和准备数据。 请参阅 创建第一个数据流。

有关数据引入选项的完整比较,请参阅“将数据引入湖仓的选项”。
使用您选择的引擎分析湖仓数据
Lakehouse 功能区包含“ 使用下拉列表分析数据 ”,可让你直接从 Lakehouse 在不同的分析体验中打开数据:
| 选项 | 说明 |
|---|---|
| SQL 分析终结点 | 在只读编辑器中使用 T-SQL 查询增量表。 请参阅 SQL 分析终结点。 |
| Eventhouse 终结点 | 运行 KQL 查询以执行高性能实时分析。 请参阅 Eventhouse 终结点。 |
| 笔记本 (新建/现有) | 打开 Spark 笔记本以使用代码浏览或转换数据。 请参阅 使用笔记本浏览数据。 |
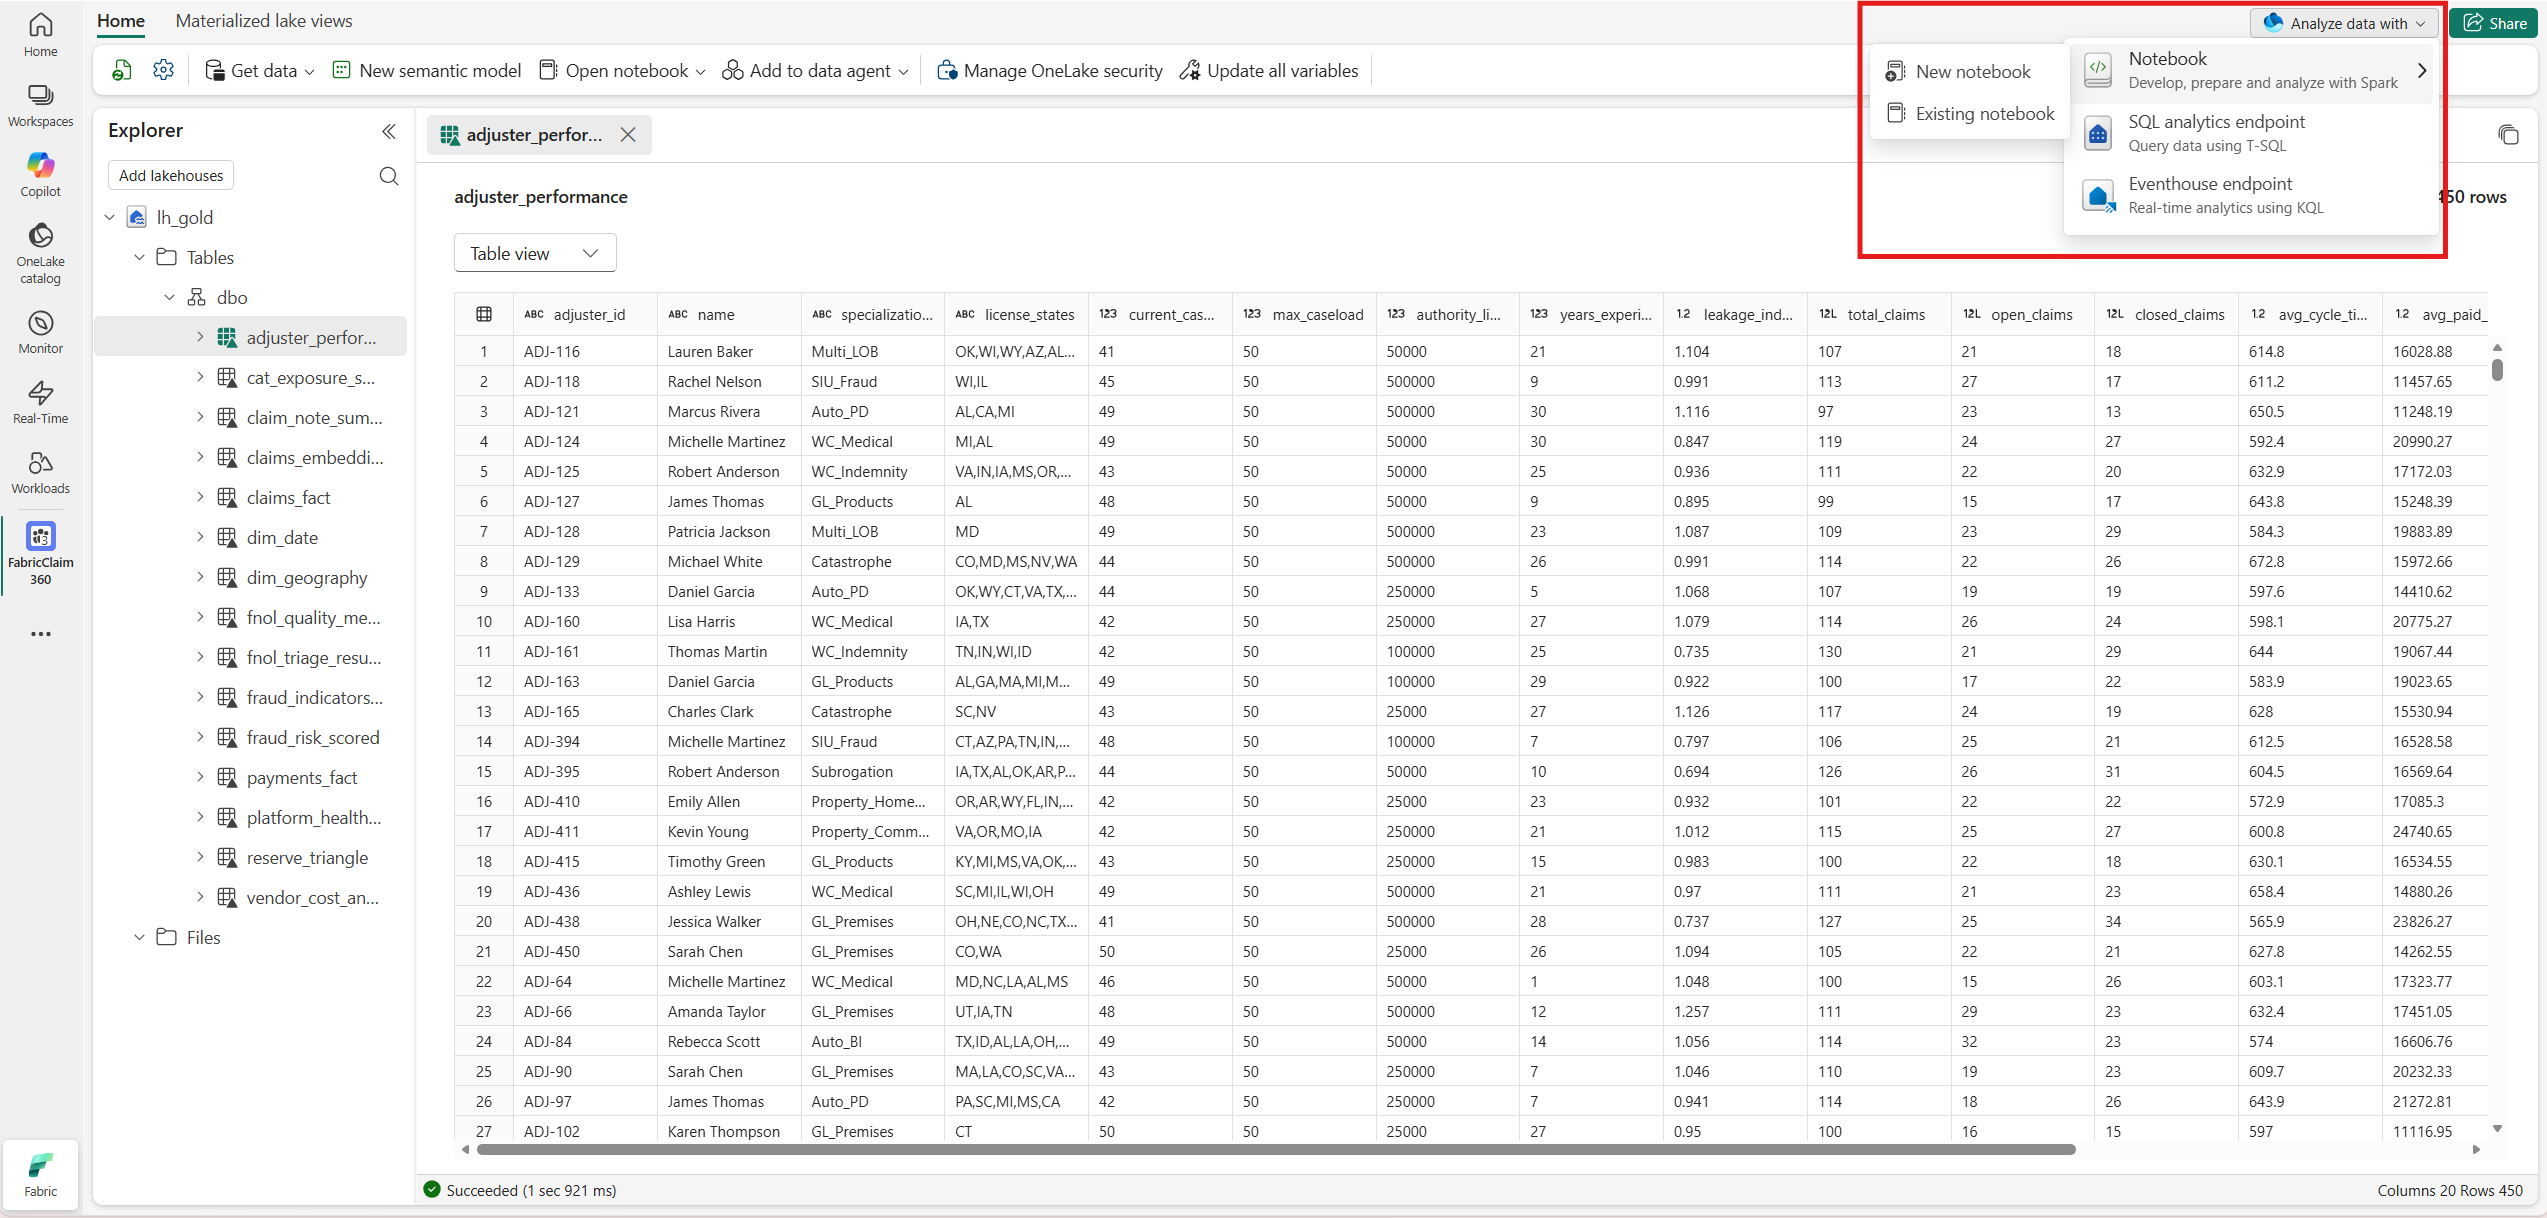
关于每个选项的详细信息及下拉菜单所在,请参见 “导航湖屋探险器”。
Lakehouse SQL 分析端点
创建湖仓时,Fabric 自动生成SQL 分析终结点。 此终结点允许你:
- 使用 T-SQL 查询 Delta 表 - 使用熟悉的 SQL 语法,而无需设置单独的仓库。
- 直接连接Power BI - 创建Power BI 语义模型以基于 lakehouse 数据构建报表。
- 共享只读访问权限 - 分析师和报表生成器可以在不影响 Spark 工作负载的情况下查询数据。
SQL分析端点是只读的,不支持 仓库的完整T-SQL表面。 使用它进行浏览、报告和临时查询。
注意
自 2025 年 9 月 5 日起,创建 Lakehouse 时,不再自动创建默认语义模型。 到 2025 年 11 月 30 日,现有默认语义模型与父项分离,并成为独立的语义模型。 更多信息请参见 Fabric 中的 Power BI 语义模型。
注意
SQL 分析终结点中仅显示 Delta 表。 这包括通过 OneLake 中的快捷方式 访问到的 Delta 表,这些表可与本地存储的表一起显示并查询。 通过此端点无法查询 Parquet、CSV 和其他格式。 如果未看到表, 请将其转换为 Delta 格式。
自动表发现和注册
Lakehouse 将数据组织成两个顶级文件夹:表用于托管 Delta 表,文件用于存储非结构化数据或非 Delta 数据。 当您将文件放置在Tables文件夹中时,Fabric系统会自动:
- 根据支持的格式(当前仅 Delta 表)验证文件。
- 提取元数据 - 列名、数据类型、压缩和分区。
- 在元存储中注册表,以便可以立即使用 Spark SQL 或 T-SQL 对其进行查询。
此托管文件到表体验意味着无需手动为托管区域中的数据编写 CREATE TABLE 语句。
注意
对于没有模式的湖屋,最大元数据大小为10 GB。 发布或更新任何超过10GB的型号都会失败。 为解决此问题,请使用支持架构的湖仓,或通过删除表和列来减小模型规模。 你也可以将大型模型分散到多个湖边别墅,以保持在这个限制内。
使用湖屋进行多任务
Lakehouse 使用浏览器选项卡设计,使你可以在多个项之间打开和切换,而不会丢失位置:
保留正在运行的作业:切换到其他选项卡时,数据加载和上传将继续运行。
保留上下文: 在选项卡之间导航时,所选表、文件和对象保持打开状态。
非阻塞列表重载: 文件和表列表在后台刷新,而不会阻碍你的工作。
作用域内通知: Toast 通知标识他们来自的 Lakehouse,以便你可以跨选项卡跟踪更新。
无障碍湖畔别墅设计
Lakehouse 支持辅助技术和无障碍的交互模式。
- 屏幕阅读器兼容性: 与常用屏幕阅读器合作进行导航和交互。
- 图像的可选文本: 所有图像都包含描述性的替换文字。
- 标记的窗体字段: 所有窗体字段都有屏幕阅读器和键盘用户的关联标签。
- 文本重排: 适应不同屏幕大小和方向的响应式布局。
- 键盘导航: 无需鼠标即可导航 Lakehouse 的完整键盘支持。