适用于: SQL ServerAzure SQL 数据库Azure SQL 托管实例Microsoft Fabric 中的 SQL 数据库
SQL Server 数据库引擎可处理对多种数据存储体系结构(例如,本地表、已分区表以及分布在多个服务器上的表)执行的查询。 以下章节将介绍数据库引擎如何处理查询并通过执行计划缓存优化查询重用。
本文中的代码示例使用 AdventureWorks2025、AdventureWorksDW2025 或 AdventureWorksLT2025 示例数据库,您可以从 Azure Data SQL Samples Repository GitHub 存储库下载这些数据库。
执行模式
SQL Server 数据库引擎可以通过两种不同的处理方式处理 Transact-SQL(T-SQL)语句:
- 行模式执行
- 批模式执行
行模式执行
行模式执行 是一种用于行存储表和索引的查询处理方法,其中数据以行格式存储。 当查询执行并访问行存储表和索引中的数据时,执行树操作符和子操作符会读取对象模式中指定的所有列的每个所需行。 对于读取的每一行,数据库引擎 随后会检索结果集中所需的列,如 SELECT 语句、JOIN 谓词或过滤谓词中引用的列。
注意
行模式执行在 OLTP 场景中非常高效,但在扫描大量数据时,例如数据仓库场景,效率可能较低。
批模式执行
批处理模式执行是一种查询处理方法,将多行一起处理(因此称为批处理)。 批中的每列都作为一个矢量存储在单独的内存区域中,因此批模式处理是基于矢量的。 批处理还采用了针对先进指令集和现代处理器中更高内存吞吐量优化的算法。
批处理模式的执行最初是围绕列存储格式进行集成和优化的。 从 SQL Server 2019(15.x)开始,在 Azure SQL 数据库 中,批处理模式的执行不再需要列存储索引。 有关详细信息,请参阅行存储中的批处理模式。
批处理模式处理在可能的情况下处理压缩数据,并消除了行模式执行中使用的 交换操作符。 结果是并行性更佳和性能更快。
当查询以批处理模式运行并访问列存储索引中的数据时,执行树操作符和子操作符会在列段中一起读取多行。 数据库引擎 只读取结果所需的、由 SELECT 语句、JOIN 谓词或筛选谓词所引用的列。 有关列存储索引的更多信息,请参见 列存储索引架构。
注意
批处理模式在数据仓库场景中非常高效,可以读取和汇总大量数据。
SQL 语句处理
处理单个 T-SQL 语句是 数据库引擎 执行 T-SQL 语句的最基本方式。 以下步骤通过处理一个仅引用本地基表(无视图或远程表)的 SELECT 语句,展示了基本流程。
逻辑运算符的优先顺序
当你在一个语句中使用多个逻辑算符时,先对 NOT 求值,然后对 AND 求值,最后对 OR 求值。 算术和按位运算符在逻辑运算符之前处理。 有关详细信息,请参阅 运算符优先级。
在以下例子中,颜色条件适用于产品模型21,而不适用于产品模型20,因为 AND 优先于 OR。
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR ProductModelID = 21
         AND Color = 'Red';
GO
使用括号,即使在不需要时,也能提高查询的可读性,并减少因操作符优先级而出错的可能性。 以下示例比前一个更容易读,含义相同。
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE ProductModelID = 20
      OR (ProductModelID = 21
          AND Color = 'Red');
GO
您可以通过添加括号来强制先评估 OR,从而改变查询的含义。 以下查询只查找型号 20 和 21 中红色的产品。
SELECT ProductID,
       ProductModelID
FROM Production.Product
WHERE (ProductModelID = 20
       OR ProductModelID = 21)
      AND Color = 'Red';
GO
优化 SELECT 语句
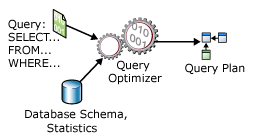
SELECT 语句是非程序性的,它不说明数据库服务器应用于检索所请求数据的确切步骤。 这种声明性行为意味着数据库服务器必须分析语句和数据库,以确定提取请求数据的最高效方式。 这一过程称为 查询计划优化。 执行此任务的组件是查询优化器。 查询优化器的输入包括查询、数据库模式(对象定义)和对象统计数据。 查询优化器的输出是一个 查询执行计划,有时也称为 查询计划 或 执行计划。 执行计划的内容在 执行计划缓存与重用中有更详细的描述。
下图展示了查询优化器在单个 SELECT 语句优化过程中的输入和输出:
一个 SELECT 语句仅定义:
- 结果集的格式。 这主要在 SELECT 列表中指定。 然而,其他子句(如
ORDER BY和GROUP BY)也会影响结果集的最终格式。 - 包含源数据的表。 在
FROM子句中指定。 - 就
SELECT语句而言,表之间在逻辑上如何相关。 这在连接表达式中定义,连接表达式可能出现在WHERE子句中,也可能出现在跟在FROM之后的ON子句中。 - 为了符合
SELECT语句的要求,源表中的行所必须满足的条件。 这些条件在WHERE和HAVING子句中指定。
查询执行计划定义:
访问源表的顺序。
通常,数据库服务器可以以多种顺序访问基表来构建结果集。 例如,如果
SELECT语句引用三个表,数据库服务器可以先访问TableA,使用TableA中的数据从TableB中提取匹配的行,然后使用TableB中的数据从TableC中提取数据。 数据库服务器访问表的其他顺序包括:TableC、TableB、TableA或
TableB、TableA、TableC或
TableB、TableC、TableA或
TableC、TableA、、TableB用于从每个表提取数据的方法。
访问每个表中的数据一般也有不同的方法。 如果只需要几行具有特定键值的记录,数据库服务器可以快速查找这些记录,或扫描较小的索引范围。 如果需要表中的所有行,数据库服务器可以扫描整个表或索引。 如果表中的所有行都是必需的,但有一个索引,其键列在
ORDER BY中,那么执行索引扫描而非表扫描可能会省去对结果集进行单独排序。 如果表非常小,全表扫描可能是几乎所有访问该表的最高效方法。用于计算的方法,以及如何对每个表中的数据进行筛选、聚合和排序的方法。
当从表中访问数据时,不同方法会对数据执行不同类型的计算,例如计算标量值,并根据查询文本中的定义对数据进行聚合和排序。 例如,在使用
ORDER BY或GROUP BY子句时,以及如何过滤数据,例如在使用WHERE或HAVING子句时。
从潜在的多个可能的计划中选择一个执行计划的过程称为“优化”。 查询优化器是数据库引擎最重要的组件之一。 虽然查询优化器会使用一定开销来分析查询并选择计划,但当它选择高效的执行计划时,这些开销通常会得到数倍补偿。 例如,两家建筑公司可能拿到一所住宅的相同设计图。 如果一家公司在起初花几天时间规划如何建造房屋,而另一家公司则没有规划就开始建造,那么花时间规划项目的公司通常会先完成。
查询优化器是一种基于成本的优化器。 就所使用的计算资源量而言,每个可能的执行计划都具有相关成本。 查询优化器必须分析可能的计划并选择一个预计成本最低的计划。 有些复杂语句有成千上万种可能的执行方案。 在这些情况下,查询优化器不会分析所有可能的组合, 而是使用复杂的算法查找一个执行计划,其成本尽可能接近最低成本。
查询优化器不一定选择估算成本最低的执行计划。 它在可用于优化的时间内找到一个具有合理估算成本的计划。 并行执行计划可能比串行执行计划消耗更多资源,同时缩短估计的已用时间。
SQL Server查询优化器在估算从表或索引中提取信息的不同方法的资源成本时,依赖统计数据。 会为列和索引保留统计信息,并保存有关底层数据密度1的信息。 这些信息表明了特定索引或列中值的选择性。 例如,在一个代表汽车的表中,很多汽车出自同一制造商,但每辆车都有唯一的车牌号 (VIN)。 因为 VIN 的密度比制造商低,所以 VIN 索引比制造商索引更具选择性。 如果索引统计信息不是最新的,则查询优化器可能无法针对表的当前状态做出最佳选择。 有关密度的详细信息,请参阅 统计信息。
1 密度定义数据中存在的唯一值的分布,或给定列的重复值平均数。 密度与值的选择性成反比,密度越小,值的选择性越大。
查询优化器的重要性在于它使数据库服务器能够动态调整数据库中不断变化的条件,而无需开发者或数据库管理员的输入。 此功能使开发者能够专注于描述查询的最终结果。 他们可以信任查询优化器在每次对语句的查询计划进行优化时,根据数据库的状态构建高效的执行计划。
注意
SQL Server Management Studio 有三个选项来显示执行计划:
处理 SELECT 语句
数据库引擎 通过以下步骤处理单个SELECT语句:
- 分析器扫描
SELECT语句并将其分解成逻辑单元(如关键字、表达式、运算符和标识符)。 - 查询树,有时也称为序列树,是用来描述将源数据转换为结果集所需格式所需的逻辑步骤的。
- 查询优化器分析访问源表的不同方式。 它选择了在使用更少资源的情况下,最快返回结果的步骤序列。 它会更新查询树以记录这一系列的具体步骤。 查询树的最终、优化的版本称为“执行计划”。
- 关系引擎开始执行计划。 当它处理需要来自基表数据的步骤时,会向存储引擎请求所需的行集。
- 关系引擎将存储引擎返回的数据处理成为结果集定义的格式,然后将结果集返回客户端。
常量折叠和表达式求值
数据库引擎会先计算一些常数表达式来提高查询性能。 查询优化器采用的这种优化技术旨在简化编译时的表达式,而非运行时。 它涉及到在查询编译期间计算常量表达式,以便生成的执行计划更高效。 这一过程称为 常量折叠。 常量是一个 T-SQL 字面值,例如 3、1.0e3、'ABC'、'2025-12-31' 或 0x12345678。 例如,考虑以下查询:
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 30 * 12, '2025-01-01');
这里, 30 * 12 是一个常数表达式。 数据库引擎 在编译过程中会评估该表达式,并可在内部将查询重写为:
SELECT *
FROM Orders
WHERE OrderDate < DATEADD(day, 360, '2025-01-01');
可折叠表达式
数据库引擎 对以下类型的表达式使用常数折叠:
- 仅包含常数的算术表达式,例如
1 + 1和5 / 3 * 2。 - 仅包含常数的逻辑表达式,例如
1 = 1和1 > 2 AND 3 > 4。 - 数据库引擎 视为可折叠的内置函数,包括
CAST和CONVERT。 一般来说,如果一个内在函数仅取决于其输入,而不涉及其他上下文信息,如SET选项、语言设置、数据库选项和加密密钥,则该函数是可折叠的。 不确定性函数是不可折叠的。 确定性内置函数是可折叠的,但也有例外情况。 - CLR用户定义类型的确定性方法和确定性标量值CLR用户自定义函数。 有关详细信息,请参阅 CLR 用户定义函数和方法的常数折叠。
注意
使用大型对象类型时将出现例外。 如果折叠过程的输出类型是大型对象类型(text、ntext、image、nvarchar(max)、varchar(max)、varbinary(max)、json 或 xml),数据库引擎 不会折叠表达式。
不可折叠的表达式
所有其他表达式类型都是不可折叠的。 特别是下列类型的表达式是不可折叠的:
- 非常数表达式,例如,结果取决于列值的表达式。
- 结果取决于局部变量或参数的表达式,例如
@x。 - 不确定性函数。
- 用户自定义的T-SQL函数。
- 结果取决于语言设置的表达式。
- 结果受
SET选项影响的表达式。 - 结果取决于服务器配置选项的表达式。
可折叠和不可折叠常数表达式的示例
请考虑下列查询:
USE AdventureWorks2025;
GO

SELECT *
FROM Sales.SalesOrderHeader AS s
     INNER JOIN Sales.SalesOrderDetail AS d
         ON s.SalesOrderID = d.SalesOrderID
WHERE TotalDue > 117.00 + 1000.00;
如果该查询的 PARAMETERIZATION 数据库选项未设置为 FORCED,则表达式 117.00 + 1000.00 会在查询编译前被计算,并替换为其结果 1117.00。 这种常量折叠的好处包括:
- 运行时不必重复计算表达式。
- 查询优化器利用表达式求值后的值来估计查询
TotalDue > 117.00 + 1000.00部分的结果集大小。
另一方面,如果dbo.f是用户定义的标量函数,dbo.f(100)表达式就不会折叠,因为数据库引擎不会折叠涉及用户自定义函数的表达式,即使它们是确定性的。 有关参数化的更多信息,请参见 强制参数化。
表达式计算
此外,有些不进行常量折叠(但其参数在编译时已知)的表达式(无论其参数是变量还是常量)将由优化器在优化期间包含的结果集大小(基数)估计器进行计算。
具体而言,在编译时将计算下列内置函数和特殊运算符(如果它们的所有输入都已知):UPPER、LOWER、RTRIM、DATEPART( YY only )、GETDATE、CAST 和 CONVERT。 如果所有输入都是已知的,则在编译时计算下列运算符:
- 算术算符:
+,-,*,/, 一元算符- - 逻辑算子:
AND,OR,NOT - 比较算符:
<,IS NULL,<=,>=,<>,LIKE,>,IS NOT NULL
在基数估计过程中,查询优化器不计算其他任何函数或运算符。
编译时刻表达式评估的示例
以下面的存储过程为例:
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc
(
    @d DATETIME
)
AS
SELECT COUNT(*)
FROM Sales.SalesOrderHeader
WHERE OrderDate > @d + 1;
在优化存储过程中 SELECT 语句时,查询优化器会尝试评估条件 OrderDate > @d + 1 的结果集预期基数。 表达式 @d + 1 不可进行常数折叠,因为 @d 是一个参数。 但是,在优化时,该参数值是已知的。 该值使查询优化器能够准确估算结果集的大小,从而帮助查询优化器选择一个好的查询计划。
现在来看一个与前一个示例类似的例子,不同之处在于,在查询中用局部变量 @d2 替换了 @d + 1,并且表达式是在 SET 语句中而不是在查询中求值的。
USE AdventureWorks2025;
GO

CREATE PROCEDURE MyProc2
(
    @d DATETIME
)
AS
BEGIN
    DECLARE @d2 AS DATETIME;
    SET @d2 = @d + 1;
    SELECT COUNT(*)
    FROM Sales.SalesOrderHeader
    WHERE OrderDate > @d2;
END
当 MyProc2 中的 SELECT 语句在 数据库引擎 中进行优化时,@d2 值是未知的。 因此,查询优化器对 OrderDate > @d2 的选择性默认使用估计值(此处为 30%)。
处理其他语句
处理 SELECT 语句的基本步骤适用于其他 T-SQL 语句,如 INSERT、UPDATE 和 DELETE。 这两个 UPDATE 和 DELETE 语句都必须针对要修改或删除的行集合。 识别这些行的过程与识别组成 SELECT 语句结果集的源行的过程相同。
UPDATE和INSERT语句都可能包含内嵌SELECT语句,提供数据值以便更新或插入。
即使是数据定义语言(DDL)语句,如 CREATE PROCEDURE 或 ALTER TABLE,也解析为系统目录表上的一系列关系操作,有时(如 ALTER TABLE ADD COLUMN)也会针对数据表进行操作。
工作表
关系引擎可能需要构建一个内部工作表来执行 T-SQL 语句中指定的逻辑操作。 工作表是内部表,用于存储中间结果。 某些 GROUP BY、 ORDER BY或 UNION 查询会生成工作表。 例如,如果某 ORDER BY 条子句引用的列没有被任何索引覆盖,关系引擎可能需要生成一个工作临时表,将结果集按请求的顺序排序。 工作表格有时也用作缓冲,临时保存查询计划执行部分结果。 工作台是在 tempdb 中构建的,如果不再需要,就会自动丢弃。
视图分辨率
数据库引擎查询处理器对索引视图和非索引视图的处理方式不同:
- 数据库以与表相同的格式存储索引视图的行。 如果查询优化器决定在查询计划中使用索引视图,它会将索引视图视为基表。
- 只有非索引视图的定义才存储,而不存储视图的行。 查询优化器将视图定义的逻辑整合到它为引用非索引视图的 T-SQL 语句构建的执行计划中。
查询优化器用来决定何时使用索引视图的逻辑类似于它决定何时在表中使用索引的逻辑。 如果索引视图中的数据覆盖了全部或部分T-SQL语句,且查询优化器判定视图中的某个索引是低成本访问路径,则无论查询是否以名称引用视图,它都会选择该索引。
当 T-SQL 语句引用非索引视图时,解析器和查询优化器会分析 T-SQL 语句和视图的定义,然后将二者整合为一个执行计划。 T-SQL 语句和视图没有分开的执行计划。
例如,请看下面的视图:
USE AdventureWorks2025;
GO

CREATE VIEW EmployeeName AS
    SELECT h.BusinessEntityID,
           p.LastName,
           p.FirstName
    FROM HumanResources.Employee AS h
         INNER JOIN Person.Person AS p
             ON h.BusinessEntityID = p.BusinessEntityID;
GO
基于此观点,这两个T-SQL语句对基表执行相同的操作,并产生相同的结果:
USE AdventureWorks2025;
GO

/* SELECT referencing the EmployeeName view. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM Sales.SalesOrderHeader AS soh
     INNER JOIN dbo.EmployeeName AS EmpN
         ON (soh.SalesPersonID = EmpN.BusinessEntityID)
WHERE OrderDate > '20230531';

/* SELECT referencing the Person and Employee tables directly. */
SELECT LastName AS EmployeeLastName,
       SalesOrderID,
       OrderDate
FROM HumanResources.Employee AS e
     INNER JOIN Sales.SalesOrderHeader AS soh
         ON soh.SalesPersonID = e.BusinessEntityID
     INNER JOIN Person.Person AS p
         ON e.BusinessEntityID = p.BusinessEntityID
WHERE OrderDate > '20230531';
SQL Server Management Studio(SSMS)的Showplan功能显示,关系引擎为这两个SELECT语句构建相同的执行计划。
对视图使用提示
如果你在查询中对视图放置提示,它们可能会与视图扩展访问基表时发现的其他提示发生冲突。 当发生冲突时,查询会返回错误。 例如,请考虑以下视图,其定义中包含一个表提示:
USE AdventureWorks2025;
GO

CREATE VIEW Person.AddrState
WITH SCHEMABINDING AS
    SELECT a.AddressID,
           a.AddressLine1,
           s.StateProvinceCode,
           s.CountryRegionCode
    FROM Person.Address AS a WITH (NOLOCK), Person.StateProvince AS s
    WHERE a.StateProvinceID = s.StateProvinceID;
现在假设您输入此查询:
SELECT AddressID,
       AddressLine1,
       StateProvinceCode,
       CountryRegionCode
FROM Person.AddrState WITH (SERIALIZABLE)
WHERE StateProvinceCode = 'WA';
查询失败了,因为 SERIALIZABLE 视图上的 Person.AddrState 提示在视图展开时会传播到 Person.Address 和 Person.StateProvince 表。 然而,展开视图也会揭示 NOLOCK 上的 Person.Address 提示。 由于 SERIALIZABLE 和 NOLOCK 提示冲突,所以得到的查询不正确。
PAGLOCK、NOLOCK、ROWLOCK、TABLOCK 和 TABLOCKX 这些表格提示彼此冲突,NOLOCK、REPEATABLEREAD、SERIALIZABLE、READCOMMITTED 和 HOLDLOCK 这些表格提示也是如此。
提示可以在嵌套视图中的层级间传播。 例如,假设某个查询在视图 HOLDLOCK 上应用了 v1 提示。 展开 v1 后,你会发现视图 v2 是 v1 定义的一部分。
v2 的定义包含对其某个基础表的 NOLOCK 提示。 但该表也从针对视图 HOLDLOCK 的查询中继承了 v1 提示。 由于 NOLOCK 提示和 HOLDLOCK 提示冲突,所以查询将失败。
当你在包含视图的查询中使用提示 FORCE ORDER 时,视图在有序构造中的位置决定了视图内表的连接顺序。 例如,下面的查询将从三个表和一个视图中进行选择:
SELECT * FROM Table1, Table2, View1, Table3
WHERE Table1.Col1 = Table2.Col1
    AND Table2.Col1 = View1.Col1
    AND View1.Col2 = Table3.Col2;
OPTION (FORCE ORDER);
并且 View1 定义如以下示例所示:
CREATE VIEW View1 AS
    SELECT Colx,
           Coly
    FROM TableA, TableB
    WHERE TableA.ColZ = TableB.Colz;
查询计划中的联接顺序为 Table1、 Table2、 TableA、 TableB、 Table3。
解析视图的索引
与任何索引一样,数据库引擎 只有在查询优化器认为有利时,才会选择在其查询计划中使用带索引视图。
你可以在任何版本的 数据库引擎 中创建索引视图。 在某些版本中,查询优化器会自动考虑索引视图,而在其他版本中,你需要使用 NOEXPAND 表提示。 查询优化器自动使用索引视图这一功能仅在 SQL Server 的特定版本中受支持。
注意
Azure SQL 数据库和 Azure SQL 托管实例支持自动使用索引视图,而无需指定 NOEXPAND 提示。
当满足以下条件时,查询优化器会使用索引视图:
- 下列会话选项均设置为
ON:ANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLQUOTED_IDENTIFIER
-
NUMERIC_ROUNDABORT会话选项设置为OFF。 - 查询优化器会找到视图索引列与查询元素之间的匹配,例如:
-
WHERE子句中的搜索条件谓词 - 联接操作
- 聚合函数
-
GROUP BY子句 - 表引用
-
- 估计的索引使用成本是查询优化器考虑使用的所有访问机制中的最低成本。
- 查询中引用的每张表(无论是直接引用,还是通过展开视图访问其底层表),只要对应于索引视图中的表引用,都必须在查询中应用相同的一组提示。
注意
在此上下文中,不管当前事务隔离级别如何, READCOMMITTED 和 READCOMMITTEDLOCK 提示始终被认为是不同的提示。
除 SET 选项和表提示的要求外,查询优化器也使用上述规则确定表索引是否包含查询。 查询中无需指定其他内容即可使用索引视图。
查询不必在 FROM 子句中显式引用索引视图,查询优化器即可使用该索引视图。 如果查询所引用的基表中的列也同时存在于索引视图中,并且,查询优化器估计使用索引视图将提供最低成本的访问机制,则查询优化器会选择索引视图,其方式类似于当查询中不直接引用基表索引时选择基表索引。 视图中包含查询未引用的列时,只要视图提供包含一个或多个查询中所指定列的最低成本选项,查询优化器即可选择该视图。
查询优化器将 FROM 子句中引用的索引视图视为标准视图。 查询优化器在优化进程开始时将视图的定义展开至查询中。 然后,执行索引视图匹配。 可将索引视图用于查询优化器选择的最终执行计划中,或该计划可以通过访问视图引用的基表来具体化视图中的必要数据。 查询优化器会选择成本最低的方式。
对索引视图使用提示
可以通过使用 EXPAND VIEWS 查询提示来防止在查询中使用视图索引,或者使用 NOEXPAND 表提示强制在查询的 FROM 子句中指定的索引视图上使用索引。 但应该让查询优化器动态确定用于每个查询的最佳访问方法。 只在经测试证实 EXPAND 和 NOEXPAND 可显著提高性能的特定情形中使用它们。
EXPAND VIEWS选项指定对于整个查询,查询优化器不应使用任何视图索引。当你为视图指定
NOEXPAND时,查询优化器会考虑使用视图上定义的任何索引。 通过可选的NOEXPAND子句指定的INDEX()会强制查询优化器使用指定的索引。 你只能为已编制索引的视图指定NOEXPAND,不能为未编制索引的视图指定它。 仅特定版本的 SQL Server 支持查询优化器自动使用索引视图。注意
Azure SQL 数据库和 Azure SQL 托管实例支持自动使用索引视图,而无需指定
NOEXPAND提示。
如果在包含视图的查询中既未指定 NOEXPAND 也未指定 EXPAND VIEWS ,则展开该视图以访问基础表。 如果组成视图的查询包含表提示,则这些提示将传播到基础表。 (该过程在 视图解析过程中有更详细的解释。)只要视图底层表上存在的提示集合彼此相同,查询就可以与索引视图匹配。 大多数情况下,这些提示彼此匹配,因为它们是直接从视图继承而来的。 但是,如果查询引用表而不是引用视图,且直接应用于这些表的提示并不相同,则这类查询就无法与索引视图进行匹配。 在视图展开后,如果 INDEX、PAGLOCK、ROWLOCK、TABLOCKX、UPDLOCK 或 XLOCK 提示应用于查询中引用的表,则该查询不符合索引视图匹配的条件。
如果形式为 INDEX ( index_val [ ,...n] ) 的表提示引用了查询中的视图,而你还没有指定 NOEXPAND 提示,则忽略该索引提示。 若要指定使用特定索引,请使用 NOEXPAND。
通常,当查询优化器将索引视图与查询匹配时,它会将查询中表格或视图中指定的提示直接应用到索引视图上。 如果查询优化器选择不使用索引视图,它会将任何提示直接传播到视图中引用的表格。 更多信息请参见 查看分辨率。 此传播不应用于联接提示。 它们仅在查询中的原始位置应用。 查询优化器在匹配查询与索引视图时不考虑连接提示。 如果查询计划使用了与包含联接提示的查询部分匹配的索引视图,则计划中不使用联接提示。
索引视图定义中不允许有提示。 数据库引擎 在维护索引视图定义时,或执行使用索引视图的查询时,会忽略索引视图定义中的提示。
有关详细信息,请参阅 表提示。
解析分布式分区视图
数据库引擎 查询处理器优化分布式分区视图的性能。 分布式分区视图性能的最重要方面是尽量减少成员服务器之间传输的数据量。
数据库引擎构建智能、动态的计划,高效利用分布式查询访问远程成员表的数据:
- 查询处理器首先使用 OLE DB 从每个成员表中检索 CHECK 约束定义。 该方法允许查询处理器映射成员表中键值的分布。
- 查询处理器将 T-SQL 语句中
WHERE子句指定的键范围与显示行在成员表中如何分布的映射进行比较。 查询处理器随后构建一个查询执行计划,利用分布式查询只检索完成 T-SQL 语句所需的远程行。 执行计划还以这样的方式构建:任何对远程成员表的访问,无论是获取数据还是元数据,都会被延迟到需要这些信息时。
例如,有这样一个系统:其中 Customers 表在 Server1(CustomerID 从 1 到 3299999)、Server2(CustomerID 从 3300000 到 6599999)和 Server3(CustomerID 从 6600000 到 9999999)间进行分区。
考虑为在 Server1 上执行的下列查询所生成的执行计划:
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID BETWEEN 3200000 AND 3400000;
该查询的执行计划从本地成员表中提取 CustomerID 键值从 3200000 到 3299999 的行,并发出分布式查询以从 Server2 中检索键值从 3300000 到 3400000 的行。
数据库引擎查询处理器还可以在查询执行计划中内置动态逻辑,对于在必须生成计划时尚不知道键值的 T-SQL 语句。 例如下面的存储过程:
CREATE PROCEDURE GetCustomer
(
    @CustomerIDParameter INT
)
AS
SELECT *
FROM CompanyData.dbo.Customers
WHERE CustomerID = @CustomerIDParameter;
数据库引擎 无法预测每次执行过程时 @CustomerIDParameter 参数提供的是哪个键值。 由于无法预测键值,查询处理器也无法预测它需要访问哪个成员表。 为处理这种情况,数据库引擎 构建了一个执行计划,其中包含条件逻辑,称为动态过滤器,以控制访问哪个成员表,基于输入参数值。 假设 GetCustomer 存储过程是在Server1上执行的,执行计划逻辑可以如下输出表示:
IF @CustomerIDParameter BETWEEN 1 and 3299999
   Retrieve row from local table CustomerData.dbo.Customer_33
ELSE IF @CustomerIDParameter BETWEEN 3300000 and 6599999
   Retrieve row from linked table Server2.CustomerData.dbo.Customer_66
ELSE IF @CustomerIDParameter BETWEEN 6600000 and 9999999
   Retrieve row from linked table Server3.CustomerData.dbo.Customer_99
数据库引擎有时会为未参数化的查询构建这类动态执行计划。 查询优化器可参数化查询,以便重新使用执行计划。 如果查询优化器对引用分区视图的查询进行了参数化,查询优化器就无法再假设所需的行来自指定的基表。 然后它必须在执行计划中使用动态过滤器。
存储过程和触发器执行
数据库引擎 只存储存储过程和触发器的源代码。 第一次执行存储过程或触发器时,源被编译为执行计划。 如果在执行计划从内存老化掉之前再次执行该存储过程或触发器,则关系引擎将检测现有计划并重新使用它。 如果计划从内存中移出,会重新构建一个新的计划。 该过程类似于 数据库引擎 对所有 T-SQL 语句所遵循的过程。 与动态 T-SQL 批处理相比,存储过程和触发器在 数据库引擎 中的主要性能优势在于它们的 T-SQL 语句始终相同。 因此,关系引擎能够轻松地将它们与任何现有执行计划相匹配。 可以轻松地重新使用存储过程和触发器计划。
存储过程和触发器的执行计划与调用存储过程或激发触发器的批处理的执行计划是独立执行的。 这种分离允许更好地重用存储过程和触发器执行计划。
执行计划的缓存和重复使用
数据库引擎 使用内存来存储执行计划和数据缓冲区。 分配给执行计划或数据缓冲区的内存比例会根据系统状态动态调整。 存储执行计划的内存部分称为 计划缓存。
计划缓存存储
计划缓存为所有已编译的计划提供了两个存储区域:
- 对象计划缓存存储(OBJCP),用于存储与持久化对象相关的计划,如存储过程、函数和触发器。
- SQL 计划缓存存储(SQLCP),存储与自动参数化、动态或预处理查询相关的计划。
以下查询提供了这两个缓存存储的内存使用情况:
SELECT *
FROM sys.dm_os_memory_clerks
WHERE name LIKE '%plans%';
计划缓存还有两个额外的存储,它们不存储计划:
- 绑定树缓存存储(PHDR),用于视图、约束和默认值在计划编译期间使用的数据结构。 这些结构被称为 绑定树 或 代数化器树。
- 扩展存储过程缓存存储区(XPROC),用于预定义的系统过程,如sp_executesql或xp_cmdshell。 这些存储过程使用DLL代替T-SQL语句。 缓存结构仅包含函数名和实现该过程的 DLL 名称。
执行计划组成部分
数据库引擎 执行计划包含以下主要组件:
编译计划(或查询计划)
由编译过程生成的查询计划主要是由任意数量的用户使用的可重入的只读数据结构。 它存储有关以下内容的信息:
物理运算符,用于实现由逻辑运算符描述的操作。
这些运算符的顺序,用于确定访问、筛选和聚合数据的顺序。
流经操作符的估计行数。
注意
查询计划还存储关于用于基数估算的统计信息对象的信息。
必须创建哪些支持对象,例如工作台或
tempdb中的工作文件。
查询计划不存储任何用户上下文或运行时信息。 数据库引擎每次从计划缓存中检索计划时,都会确定工作线程的数量。 缓存并行计划也可以串行运行。
执行上下文
当前执行查询的每个用户都有一个数据结构,用于保存其执行时特定的数据,如参数值。 这个数据结构称为 执行上下文。 执行上下文的数据结构会被重复利用,但其内容不会。 如果其他用户执行相同的查询,则会为新用户重新初始化上下文数据结构。
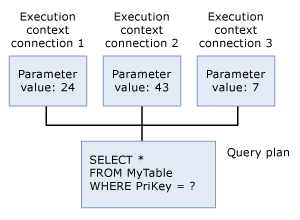
重用相同语句的计划
当数据库引擎执行任意T-SQL语句时,首先会检查计划缓存,以确认同一T-SQL语句是否存在已有的执行计划。 如果某个 T-SQL 语句与之前执行过且具有缓存计划的 T-SQL 语句完全逐字逐字符匹配,则该语句被视为已存在。 数据库引擎会重用它找到的任何现有计划,从而节省重新编译T-SQL语句的开销。 如果不存在执行计划,数据库引擎 会为查询生成新的执行计划。
注意
计划缓存不会持久化某些 T-SQL 语句的执行计划,例如运行在行存储上的批量操作语句或包含大字符串文字的语句。 这些计划仅在查询运行期间存在。
数据库引擎 使用高效的算法来查找任何特定 T-SQL 语句的现有执行计划。 在大多数系统中,这种扫描所使用的资源极少,且少于通过重复使用现有计划而不是编译每个 T-SQL 语句所节省的资源。
将新的 T-SQL 语句与计划缓存中现有未使用的执行计划匹配的算法要求所有对象引用都必须完全限定。 例如,假设 Person 是执行以下 SELECT 语句的用户的默认架构。 虽然这个例子不需要你完全限定 Person 表才能执行,但这意味着第二个语句与现有计划不匹配,而第三个语句则匹配:
USE AdventureWorks2025;
GO

SELECT *
FROM Person;
GO

SELECT *
FROM Person.Person;
GO

SELECT *
FROM Person.Person;
GO
对于给定执行,更改以下SET任一选项会影响重用执行计划的能力,因为数据库引擎执行常量折叠,而这些选项会影响此类表达式的结果:
ANSI_DEFAULTSANSI_NULL_DFLT_OFFANSI_NULL_DFLT_ONANSI_NULLSANSI_PADDINGANSI_WARNINGSARITHABORTCONCAT_NULL_YIELDS_NULLDATEFIRSTDATEFORMATFORCEPLANLANGUAGENO_BROWSETABLENUMERIC_ROUNDABORTQUOTED_IDENTIFIER
为同一个查询缓存多个计划
查询和执行计划在数据库引擎中是唯一可识别的,与指纹非常类似:
- “查询计划哈希”是在给定查询的执行计划上计算的二进制哈希值,用于唯一标识类似的执行计划。
- 查询哈希是基于查询的T-SQL文本计算的二进制哈希值,用于唯一标识查询。
你可以使用 计划句柄从计划缓存中检索编译后的计划。 该瞬态标识符仅在计划保留在缓存中时保持不变。 执行计划句柄是根据整个批处理的已编译执行计划派生的哈希值。 即使批处理中的一个或多个语句被重新编译,编译后的计划句柄保持不变。
注意
如果你为批处理编制计划而不是单一语句,你可以用计划句柄和语句偏移量来获取批处理中单个语句的计划。
sys.dm_exec_requests DMV包含每条记录的statement_start_offset和statement_end_offset列。 这些列指的是当前执行的批处理或持久化对象的当前执行语句。 有关详细信息,请参阅 sys.dm_exec_requests。
sys.dm_exec_query_stats DMV也包含每条记录的这些列。 这些列指的是语句在批处理或持久化对象中的位置。 有关详细信息,请参阅 sys.dm_exec_query_stats。
批处理的实际 T-SQL 文本存储在与计划缓存分开的内存空间中,称为 SQL Manager 缓存(SQLMGR)。 你可以通过 SQL 句柄 从SQL Manager缓存中获取编译计划的T-SQL文本。 该瞬态标识符只有在至少一个引用它的计划仍保留在计划缓存中时保持不变。 SQL 句柄是从整个批处理文本中推导出的哈希值,并且保证对于每个批次,SQL 句柄都是唯一的。
注意
像编译后的计划一样,T-SQL文本是按批次存储的,包括注释。 SQL 句柄包含整个批处理文本的 MD5 哈希值,并且保证对每个批次都是唯一的。
以下查询提供了关于 SQL Manager 缓存内存使用情况的信息:
SELECT *
FROM sys.dm_os_memory_objects
WHERE type = 'MEMOBJ_SQLMGR';
一个 SQL 句柄与多个计划句柄之间存在对应关系。 当已编译计划的缓存键不同时,就会出现这种情况。 这种差异可能是由于同一批次的两次执行之间SET选项的变化所致。
请思考以下存储过程:
USE WideWorldImporters;
GO

CREATE PROCEDURE usp_SalesByCustomer
(
    @CID INT
)
AS
SELECT *
FROM Sales.Customers
WHERE CustomerID = @CID;
GO

SET ANSI_DEFAULTS ON;
GO

EXECUTE usp_SalesByCustomer 10;
GO
通过以下查询验证你能在计划缓存中找到的内容:
SELECT cp.memory_object_address,
       cp.objtype,
       refcounts,
       usecounts,
       qs.query_plan_hash,
       qs.query_hash,
       qs.plan_handle,
       qs.sql_handle
FROM sys.dm_exec_cached_plans AS cp
CROSS APPLY sys.dm_exec_sql_text(cp.plan_handle)
CROSS APPLY sys.dm_exec_query_plan(cp.plan_handle)
     INNER JOIN sys.dm_exec_query_stats AS qs
         ON qs.plan_handle = cp.plan_handle
WHERE text LIKE '%usp_SalesByCustomer%';
GO
结果集如下。
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
现在,使用不同的参数执行存储过程,且不更改执行上下文:
EXECUTE usp_SalesByCustomer 8;
GO
再确认一下你能在计划缓存中找到的内容。 结果集如下。
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
注意到 usecounts 值增加到 2,这意味着相同的缓存计划被原样重复使用,因为执行上下文数据结构被重用。 现在更改 SET ANSI_DEFAULTS 选项,并使用相同的参数执行存储过程。
SET ANSI_DEFAULTS OFF;
GO

EXECUTE usp_SalesByCustomer 8;
GO
再确认一下你能在计划缓存中找到的内容。 结果集如下。
memory_object_address    objtype   refcounts   usecounts   query_plan_hash    query_hash
---------------------   -------  ---------  ---------  ------------------ ------------------
0x000001CD01DEC060        Proc      2           1           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D
0x000001CC6C534060        Proc      2           2           0x3B4303441A1D7E6D 0xA05D5197DA1EAC2D

plan_handle
------------------------------------------------------------------------------------------
0x0500130095555D02B031F111CD01000001000000000000000000000000000000000000000000000000000000
0x0500130095555D02D022F111CD01000001000000000000000000000000000000000000000000000000000000

sql_handle
------------------------------------------------------------------------------------------
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
0x0300130095555D02C864C10061AB000001000000000000000000000000000000000000000000000000000000
请注意,sys.dm_exec_cached_plans DMV 输出中现在有两个条目:
- 该
usecounts列显示了第一条记录中的值1。 该值表示使用SET ANSI_DEFAULTS OFF执行一次的计划。 -
usecounts列显示第二条记录中的值2。 该值表示使用SET ANSI_DEFAULTS ON执行的计划,因为它被执行了两次。 - 不同的
memory_object_address会引用计划缓存中不同的执行计划条目。 但是,这两个条目的sql_handle值是相同的,因为它们属于相同的批次。- 将
ANSI_DEFAULTS设置为OFF的执行中新增了一个plan_handle,并且对于具有相同一组选项SET的调用,可以重复使用。 由于执行上下文因选项更改SET而重新初始化,因此需要新的计划句柄。 但这种更改不会触发重新编译:两条目都指向相同的计划和查询,这一点从相同的query_plan_hash和query_hash值可以证明。
- 将
这种情况意味着缓存中有两个计划条目对应同一批次。 这强调了确保在重复执行相同查询时,影响 SET 选项的计划缓存相同的重要性。 这种方法优化了计划的重用,并将计划缓存大小保持在所需的最小值内。
提示
常见的陷阱是,不同的客户端对 SET 选项可能有不同的默认值。 例如,通过 SQL Server Management Studio 建立的连接会自动将 QUOTED_IDENTIFIER 设置为 QUOTED_IDENTIFIER,而 SQLCMD 则将 OFF 设置为 ON。 从这两个客户端执行相同的查询会导致多个计划(如前例所述)。
从计划缓存中删除执行计划
只要有足够的内存来存储这些执行计划,执行计划就会留在计划缓存中。 当内存压力存在时,SQL Server 数据库引擎 采用基于成本的方法决定从计划缓存中移除哪些执行计划。 为了做出基于成本的决策,SQL Server 数据库引擎会根据以下因素为每个执行计划增加或减少当前的成本变量。
当用户进程将执行计划插入缓存时,用户进程将当前成本设定为原始查询编译成本。 对于临时执行计划,用户进程将当前成本设置为零。 之后,每次用户进程引用执行计划时,都会将当前成本重置为原始编译成本。 对于临时执行计划,用户过程会增加当前成本。 对于所有计划而言,当前开销的最大值就是原始编译开销。
当内存压力存在时,SQL Server 数据库引擎 会从计划缓存中移除执行计划。 为了确定删除哪些计划,SQL Server 数据库引擎会重复检查每个执行计划的状态并将删除当前开销为零的执行计划。 当前成本为零的执行计划在内存压力存在时不会自动被移除。 只有当 SQL Server 数据库引擎 分析执行计划且当前成本为零时,这才会被移除。 当检查执行计划时,如果当前没有查询使用该计划,则 SQL Server 数据库引擎将降低当前开销以将其推向零。
SQL Server 数据库引擎 会持续检查执行计划,直到移除足够多的计划以满足内存需求。 如果存在内存不足的情况,执行计划的成本可能会多次增加和减少。 当内存压力消失时,SQL Server 数据库引擎 停止降低未使用执行计划的当前成本。 所有执行计划都会保留在计划缓存中,即使其成本为零。
SQL Server 数据库引擎使用资源监视器和用户工作线程从计划缓存中释放内存,以响应内存不足。 资源监控线程和用户工作线程可以同时检查执行计划,以降低每个未使用的执行计划的当前成本。 如果存在全局内存不足的情况,资源监视器将会从计划缓存中删除执行计划。 它释放内存以强制实施系统内存、进程内存、资源池内存和所有缓存最大大小的策略。
所有缓存的最大大小是缓存池大小的一个函数,不能超出最大服务器内存的大小。 有关配置最大服务器内存的更多信息,请参见 sp_configure 中的 max server memory 设置。
当存在单一缓存不足的情况时,用户工作线程将会从计划缓存中删除执行计划。 它们强制实施最大单一缓存大小和最大单一缓存条目数的策略。
以下示例说明会从计划缓存中删除哪些执行计划:
- 一个执行计划经常被引用,因此其开销永不为零。 计划会保留在计划缓存中,除非内存压力大且当前成本为零,否则不会被移除。
- 插入的一个即席执行计划,并且在内存不足情况出现之前没有再次引用该计划。 由于临时计划初始化时当前成本为零,当 SQL Server 数据库引擎检查执行计划时,会看到当前成本为零,并从计划缓存中移除该计划。 当内存压力不存在时,即席执行计划会以零当前成本保持在计划缓存中。
若要从缓存中手动删除单个计划或所有计划,请使用 DBCC FREEPROCCACHE。 你也可以使用 DBCC FREESYSTEMCACHE 清除任何缓存,包括计划缓存。 在 SQL Server 2016(13.x)及以后版本中,使用 ALTER DATABASE SCOPED CONFIGURATION CLEAR PROCEDURE_CACHE 清除作用域内数据库的过程(计划)缓存。
通过 sp_configure 和 reconfigure 对某些配置设置的更改,也会导致计划从计划缓存中移除。 可在 DBCC FREEPROCCACHE 一文的“备注”部分中找到这些配置设置的列表。 当你进行此配置更改时,以下提示信息会被写入错误日志:
SQL Server has encountered %d occurrence(s) of cachestore flush for the '%s' cachestore (part of plan cache) due to some database maintenance or reconfigure operations.
重新编译执行计划
数据库中的某些变动可能导致执行计划效率低下或无效。 数据库引擎检测到这些变化,并将计划标记为无效。 此后,必须为执行查询的下一个连接重新编译新的计划。 使计划无效的条件包括:
- 对查询引用的表或视图的更改(
ALTER VIEW和ALTER TABLE)。 - 对单个过程的更改,会将该过程的所有计划从缓存中移除(
ALTER PROCEDURE)。 - 对执行计划所使用的任何索引进行更改。
- 对执行计划使用的统计信息的更新,无论是由
UPDATE STATISTICS等语句显式生成,还是自动生成。 - 删除执行计划所使用的索引。
- 显式调用
sp_recompile。 - 大量更改键(由其他用户执行的 `
INSERT` 或 `DELETE` 语句对查询引用的表进行修改所引发的)。 - 对于带有触发器的表,如果插入或删除表中的行数显著增加。
- 通过使用
WITH RECOMPILE选项执行存储过程。
大多数重新编译要么是为了语句的正确性,要么是为了获得可能更快的查询执行计划。
当批处理中的语句触发重新编译时,只有该语句被重新编译,而非整个批次。 无论批处理是通过存储过程、触发器、临时批处理还是预备语句提交,这条规则都适用。
语句级重新编译提升了性能,因为在大多数情况下,少量语句会导致重新编译及其在 CPU 时间和锁方面的相关开销。 因此,批次中不需要重新编译的其他语句避免了这些开销。
sql_statement_recompile 扩展事件 (XEvent) 会报告语句级别的重新编译。 当任何类型的批处理需要语句级重新编译时,会发生此 XEvent。 该需求包括存储过程、触发器、临时批处理和查询。 批处理可以通过多种接口提交,包括 sp_executesql、动态 SQL、Prepare 方法或执行方法。
recompile_cause XEvent 列sql_statement_recompile包含一个整数代码,指示重新编译的原因。 以下列出可能的原因:
- 游标选项已更改
- 延迟编译
-
FOR BROWSE权限已更改 -
OPTION (RECOMPILE)已请求 - 参数化执行计划已刷新
- 分区视图已更改
- 影响数据库版本的计划已更改
- 查询通知环境已更改
- 查询存储中缺少该执行计划
- 查询存储执行计划强制失败
- 查询存储执行计划强制策略已更改
- 远程行集已更改
- 架构已更改
-
SET选项已更改 - 统计信息已更改
- 临时表已更改
注意
当你将数据库选项ON设置为 AUTO_UPDATE_STATISTICS 时,当查询针对其统计信息已更新或其基数自上次执行以来发生显著变化的表或索引视图时,会重新编译。 此行为适用于标准用户定义表、临时表以及由 DML 触发器创建的插入表和删除表。
将 AUTO_UPDATE_STATISTICS 设置为 OFF 可以阻止这些重新编译,但过时的统计数据通常比重编译更会降低查询性能。 更多信息请参见 AUTO_UPDATE_STATISTICS 选项。 插入和删除的DMLINSTEAD OF触发表是在tempdb中创建的,因此它们遵循AUTO_UPDATE_STATISTICS的tempdb设置。
使用明确的参数进行计划重用
使用参数,包括在ADO.NET应用中的命名参数,以及在OLE DB和ODBC应用中使用参数标记,可以增加执行计划的复用率。
警告
始终通过测试类型、长度、格式和范围来验证用户输入。 有关详细信息,请参阅 SQL 注入。
下面两个 SELECT 语句之间的唯一区别是 WHERE 子句中比较的值不同:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
这两个查询的执行计划之间的唯一区别是为与 ProductSubcategoryID 列进行比较而存储的值。 虽然目标是让 数据库引擎 始终识别这些语句生成的计划本质上相同并重用这些计划,但 数据库引擎 有时无法在复杂的 T-SQL 语句中检测到这种相似性。
通过参数从T-SQL语句中分离常量,有助于关系引擎识别重复的执行计划。 参数的使用方式如下:
在T-SQL中,使用
sp_executesql:DECLARE @MyIntParm AS INT; SET @MyIntParm = 1; EXECUTE sp_executesql N'SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = @Parm', N'@Parm INT', @MyIntParm;该方法推荐用于会动态生成 SQL 语句的 T-SQL 脚本、存储过程或触发器。
使用
SqlClient的 ADO.NET 使用命名参数,例如@Parm。 OLE DB 和 ODBC 使用参数标记。 参数标记是用来替代 SQL 语句中的常量的问号(?),并与程序变量绑定。 例如,可以在 ODBC 应用程序中执行下列操作:使用
SQLBindParameter将整数变量绑定到 SQL 语句中的第一个参数标记。为变量赋整数值。
执行该语句,指定参数标记(
?):SQLExecDirect(hstmt, "SELECT * FROM AdventureWorks2025.Production.Product WHERE ProductSubcategoryID = ?", SQL_NTS);
SQL Server 原生客户端 OLE DB 提供者和 SQL Server 原生客户端 ODBC 驱动程序在应用程序中使用参数标记时,使用
sp_executesql向 SQL Server 发送语句。编写存储过程,这些过程设计上使用参数。
如果你没有在应用设计中明确构建参数,也可以依赖查询优化器通过默认的简单参数化行为自动参数化某些查询。 另外,也可以通过将 PARAMETERIZATION 语句的 ALTER DATABASE 选项设置为 FORCED,强制查询优化器考虑将数据库中的所有查询参数化。
简单参数化
在数据库引擎中,在T-SQL语句中使用参数或参数标记,可以提升关系引擎将新T-SQL语句与已编译的执行计划匹配的能力。
警告
始终通过测试类型、长度、格式和范围来验证用户输入。 有关详细信息,请参阅 SQL 注入。
如果执行T-SQL语句时没有参数,数据库引擎会在内部对该语句进行参数化,以提高与现有执行计划匹配的可能性。 这个过程称为 参数化。 默认是 简单参数化,你可以为数据库启用 强制参数化。
请看下面的语句:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
你可以在语句末尾将值 1 作为参数添加到其中。 关系引擎构建该批次的执行计划,就像你在值 1 的位置指定了一个参数。 由于这种简单的参数化,数据库引擎 识别到以下两个语句生成的执行计划本质上相同,并将第一个计划用于第二个语句:
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 1;
SELECT *
FROM Production.Product
WHERE ProductSubcategoryID = 4;
在处理复杂的T-SQL语句时,关系引擎可能难以确定哪些表达式可以参数化。 为了提高关系引擎将复杂 T-SQL 语句与现有未使用的执行计划相匹配的能力,可以通过使用 sp_executesql 或参数标记之一来明确指定参数。
注意
当你使用 +、-、*、/或%算术运算符将 int、smallint、tinyint 或 bigint 常数值隐式或显式转换为float、real、decimal或numeric数据类型时,数据库引擎 会应用特定规则来计算表达式结果的类型和精度。 这些规则因查询是否参数化而有所不同。 因此,在某些情况下,查询中的相似表达式可能会产生不同的结果。
在简单参数化的默认行为下,数据库引擎 只会参数化相对较少的一类查询。 但是,可以通过将 PARAMETERIZATION 命令的 ALTER DATABASE 选项设置为 FORCED,来指定对数据库中的所有查询都进行参数化(但受到某些限制)。 这一变化可以通过减少查询编译的频率,提升经历大量并发查询的数据库的性能。
您也可以指定对单个查询以及其他在语法上等效,只有参数值不同的查询进行参数化。
提示
当你使用对象关系映射(ORM)解决方案,如实体框架(EF)时,应用程序查询如手动LINQ查询树或某些原始SQL查询可能没有参数化。 这一限制影响了计划的重用以及在 查询存储 中跟踪查询的能力。 有关详细信息,请参阅 EF 查询缓存和参数化以及 EF 原始 SQL 查询。
强制参数化
你可以通过指定数据库中所有 SELECT、 INSERT、 UPDATE和 DELETE 语句都要参数化,但受一定限制,来覆盖 数据库引擎 默认的简单参数化行为。 通过在 ALTER DATABASE 语句中将 PARAMETERIZATION 选项设置为 FORCED,启用强制参数化。 通过降低查询编译和重新编译的频率,强制参数化可提高某些数据库的性能。 能够受益于强制参数化的数据库通常是需要处理来自源(例如,销售点应用程序)的大量并发查询的数据库。
当你将选项FORCED设置为 PARAMETERIZATION 时,任何出现在 SELECT、 INSERT、 UPDATE或DELETE语句中的文字值,无论以何种形式提交,都会在查询编译过程中被转换为参数。 例外情况是出现在以下查询结构中的字面量:
-
INSERT...EXECUTE语句。 - 存储过程、触发器或用户定义函数的正文中包含的语句。 数据库引擎已经为这些例程重用了查询计划。
- 已经在客户端应用中参数化的预处理语句。
- 包含 XQuery 方法调用的语句,此方法将出现在其参数通常都会被参数化的上下文(例如,
WHERE子句)中。 如果方法出现在参数不会参数化的上下文中,则会参数化该语句的其余部分。 - T-SQL 光标内的语句。 (API 游标内的
SELECT语句将参数化。) - 不推荐使用的查询构造。
- 任何在
ANSI_PADDING上下文中运行的语句,或将ANSI_NULLS设置为OFF的语句。 - 包含超过 2,097 个符合参数化条件的字面量的语句。
- 引用变量的语句,例如,
WHERE T.col2 >= @bb。 - 包含
RECOMPILE查询提示的语句。 - 包含
COMPUTE子句的语句。 - 包含
WHERE CURRENT OF子句的语句。
以下查询子句没有参数化。 在这些情况下,只有子句未参数化。 同一查询中的其他子句或许可以进行强制参数化。
- 任何
<select_list>语句的SELECT。 该列表包含SELECT子查询列表以及INSERT语句内的SELECT列表。 - 在
SELECT语句中出现的IF子查询语句。 - 查询的
TOP、TABLESAMPLE、HAVING、GROUP BY、ORDER BY、OUTPUT...INTO或FOR XML子句。 -
OPENROWSET、OPENQUERY、OPENDATASOURCE、OPENXML或任意FULLTEXT运算符的参数(直接或作为子表达式)。 -
LIKE子句中的 pattern 和 escape_character 参数。 -
CONVERT子句中的样式参数。 -
IDENTITY子句中的整数常数。 - 使用 ODBC 扩展语法指定的常数。
- 可折叠常数表达式,它们是
+、-、*、/和%运算符的参数。 在考虑强制参数化的资格时,数据库引擎 认为当以下任一条件成立时,表达式是常数折叠的:- 表达式中没有列、变量、或子查询。
- 表达式包含
CASE子句。
- 查询提示子句的参数,包括 查询提示的
FAST参数、 查询提示的MAXDOP参数,以及MAXRECURSION查询提示的 number 参数。
参数化发生在单个 T-SQL 语句的层面。 即,批处理中的单条语句将参数化。 编译完成后,参数化查询会在其原始提交批次的上下文中执行。 如果查询的执行计划被缓存,你可以通过引用 sql 动态管理视图的 sys.syscacheobjects 列来判断查询是否被参数化。 如果查询是参数化的,参数的名称和数据类型会排在提交批次文本之前,例如 (@1 TINYINT)。
注意
参数名称是任意的。 用户或应用程序不应依赖特定的命名顺序。 此外,以下项在 SQL Server 版本更迭和累积更新(CU)升级过程中可能发生变化:参数名称、参数化的文字选择以及参数化文本的间距。
参数的数据类型
当 数据库引擎 参数化字面量时,参数会转换为以下数据类型:
- 原本可适合int数据类型大小的整数字面量参数化为int。作为涉及任意比较运算符的谓词一部分的较大整数字面量(包括
<、<=、=、>、!>、!<、<>、ALL、>=、!=、SOME、BETWEEN、ANY和IN)参数化为 numeric(38,0)。 较大的字面量,不属于涉及比较算子的谓词部分,参数化为 数值,其精度刚好足以支持其大小,且标度为 0。 - 作为涉及比较运算符的谓词一部分的定点数值字面量,会参数化为精度为 38 且小数位数恰好足以支持其大小的 numeric。 不属于涉及比较运算符的谓词组成部分的定点数字字面量,会参数化为精度和小数位数恰好足以支持其大小的 numeric。
- 浮点数值字面量参数化为 float(53)。
- 非 Unicode 字符串字面量如果在 8,000 个字符以内,则参数化为 varchar(8000);如果超过 8,000 个字符,则参数化为 varchar(max)。
- 如果 Unicode 字符串字面量不超过 4,000 个 Unicode 字符,则参数化为 nvarchar(4000);如果该字面量超过 4,000 个字符,则参数化为 nvarchar(max)。
- 如果该二进制字面量不超过 8,000 字节,则参数化为 varbinary(8000)。 如果大于8000字节,则转换为varbinary(max)。
- 货币字面量参数化为 money。
强制参数化使用指南
在将 PARAMETERIZATION 选项设置为 FORCED 时,请考虑以下几点:
- 强制参数化在编译查询时将查询中的文字常量改为参数。 因此,查询优化器可能会选择不太理想的查询计划。 尤其是查询优化器不太可能将查询与索引视图或计算列索引相匹配。 此外,它在对分区表和分布式分区视图执行查询时也可能选择次优方案。 不要在高度依赖索引视图和计算列索引的环境中使用强制参数化。 通常,只有有经验的数据库专业人员在确定不会对性能产生不利影响后才会使用该
PARAMETERIZATION FORCED选项。 - 一旦(上下文中正在执行查询的)数据库中的
PARAMETERIZATION选项设置为FORCED,则引用了多个数据库的分布式查询即可进行强制参数化。 - 将
PARAMETERIZATION选项设置为FORCED会清除数据库计划缓存中的所有查询计划,但当前正在编译、重新编译或运行的计划除外。 在设置更改过程中正在编译或运行的查询计划,在下一次查询执行时会被参数化。 - 设置该
PARAMETERIZATION选项是一种在线操作,无需数据库层面的独占锁。 - 在重新附加或还原数据库时,
PARAMETERIZATION选项的当前设置将保留。
你可以通过指定对单个查询及任何其他与其在语法上等效但仅参数值不同的查询尝试简单参数化,来更改强制参数化的行为。 相反,即使数据库中禁用了强制参数化,您也可以指定仅对一组语法相同的查询进行强制参数化。 为此使用 计划指南 (Plan Guides)。
注意
PARAMETERIZATION 选项设置为 FORCED 时,错误消息的报告可能与 PARAMETERIZATION 选项设置为 SIMPLE 时不同:在强制参数化下可能会报告多条错误消息,而在简单参数化下可能报告的消息条数较少,并且可能无法准确报告出现错误的行号。
启用强制参数化后,仍会发生简单参数化。 例如,根据强制参数化规则,无法将以下查询参数化:
SELECT *
FROM Person.Address
WHERE AddressID = 1 + 2;
但根据简单参数化规则,可以将该查询参数化。 尝试强制参数化失败后,仍将接着尝试简单参数化。
准备 SQL 语句
数据库引擎 支持在执行前准备 T-SQL 语句。 如果应用程序需要多次执行一个 T-SQL 语句,它可以使用数据库 API 来:
- 仅需预编译语句一次。 这一步将 T-SQL 语句编译成执行计划。
- 每次需要执行语句时,都执行预编译的执行计划。 这种方法可防止在第一次之后的每次执行时重新编译 T-SQL 语句。 语句的准备和执行由 API 函数和方法控制。 SQL Server 原生客户端 OLE DB 提供者和 SQL Server 原生客户端 ODBC 驱动支持执行 T-SQL 语句的准备/执行模型。 在准备请求中,提供程序或驱动程序将语句发送到 SQL Server,其中包含准备语句的请求。 数据库引擎 编译执行计划,并将该计划的句柄返回给提供者或驱动程序。 在执行请求时,提供者或驱动程序会向服务器发送请求,以执行与句柄关联的计划。
预处理语句无法在 数据库引擎 中创建临时对象。 预定义语句不能引用创建临时对象(如临时表)的系统存储过程。 必须直接执行这些过程。
过度使用准备/执行模型会降低性能。 如果语句只执行一次,直接执行只需与服务器进行一次网络往返。 准备和执行一个只执行一次的T-SQL语句需要额外的网络往返:准备语句一次,执行一次。
如果使用参数标记,预处理语句会更有效。 例如,假设可能偶尔让应用程序从 AdventureWorksLT2025 示例数据库检索产品信息。 应用程序有两种方式可以完成这项任务。
通过采用第一种方法,应用程序可以为每个请求的产品执行独立查询:
SELECT *
FROM Production.Product
WHERE ProductID = 63;
使用第二种方法,应用程序执行以下操作:
准备包含参数标记(
?)的语句。SELECT * FROM Production.Product WHERE ProductID = ?;将程序变量绑定到参数标记上。
每次需要产品信息时,用键值填充绑定的变量,然后执行该语句。
当该语句被执行超过三次时,第二种方法更高效。
在 数据库引擎 中,准备/执行模型相较于直接执行没有显著的性能优势,因为 数据库引擎 会重用执行计划。 数据库引擎 拥有高效的算法,用于匹配当前 T-SQL 语句与为同一 T-SQL 语句先前执行生成的执行计划。 如果应用程序多次执行带参数标记的 T-SQL 语句,数据库引擎 会在第二次及后续执行中重用第一次执行的执行计划(除非该计划因老化而从计划缓存中移除)。 准备/执行模型还具有下列优点:
- 通过识别句柄查找执行计划比用于匹配T-SQL语句与现有执行计划的算法更高效。
- 应用程序可以控制执行计划的创建时间和重用的时间。
- 准备/执行模型可移植到其他数据库,包括早期版本的 SQL Server。
参数敏感度
参数敏感性,也称为参数嗅探,是指数据库引擎在编译或重新编译过程中嗅探当前参数值,并将其传递给查询优化器,以帮助生成更高效的查询执行计划。
在编译或重新编译期间,将针对以下类型的批处理对参数值进行探查:
- 存储过程
- 通过
sp_executesql提交的查询 - 预定义查询
有关参数嗅探问题的故障排除,请参见:
- 调查并解决参数敏感问题
- 使用明确的参数进行计划重用
- 参数敏感方案优化
- 在 Azure SQL 数据库 中排查存在参数敏感查询执行计划问题的查询
- 在 Azure SQL 托管实例中排查存在参数敏感查询执行计划问题的查询
当数据库引擎中的查询使用提示OPTION (RECOMPILE)时,查询优化器会将参数和局部变量转换为编译时常量,这些常量可进行常量折叠并化简为字面量。 在编译过程中,优化器知道并可以使用参数和局部变量在该语句之前立即存在的当前运行时值。
OPTION (RECOMPILE) 提示允许优化器生成针对特定值的更优查询计划,并在运行时利用最佳的底层索引。 对于参数,此过程不是指最初传递到批处理或存储过程的值,而是重新编译时的值。 这些值可以在过程中修改,在到达包含 RECOMPILE 的语句之前。 这种行为可以提升输入数据高度可变或偏颇的查询的性能,但代价是每次执行时都要编译查询。 这种成本可能很高。 避免在未评估该 hint(RECOMPILE)对整体工作负载影响的情况下使用它。
局部变量与基数估计
当查询使用局部变量时,数据库引擎无法在编译时嗅取其值,因此它通过现有统计或启发式方法估计基数。 如果存在统计信息,它通常使用统计直方图中的所有 密度 值(也称为 平均密度)来估计与谓词匹配的行数。 然而,如果该列没有统计数据,数据库引擎会依赖启发式估计,比如对等式谓词假设10% 选择性,对不等式和范围假设30%。 这些估算可能导致执行计划的准确性降低。 下面是使用局部变量的查询的示例。
DECLARE @ProductId AS INT = 100;

SELECT *
FROM Products
WHERE ProductId = @ProductId;
在这种情况下,数据库引擎 不会用值 100 来优化查询。 它使用一般估计值。
并行查询处理
数据库引擎 提供并行查询,以优化拥有多个微处理器(CPU)计算机的查询执行和索引操作。 由于 数据库引擎 可以通过多个操作系统工作线程并行执行查询或索引操作,操作完成得快且高效。
在查询优化过程中,数据库引擎 会寻找可能受益于并行执行的查询或索引操作。 对于这些查询,数据库引擎 会在查询执行计划中插入交换操作符,以便为并行执行做准备。 交换运算符是在查询执行计划中提供进程管理、数据再分发和流控制的运算符。 交换运算符包含作为子类型的 Distribute Streams、Repartition Streams 和 Gather Streams 逻辑运算符,其中一个或多个运算符可能出现在并行查询的查询计划的显示计划结果中。
重要
某些构造会阻碍数据库引擎对整个执行计划或部分执行计划使用并行性的能力。
禁止并行度的构造包括:
| 构造 | 说明 |
|---|---|
| 标量 UDF 函数 | 有关标量用户自定义函数的更多信息,请参见 创建用户自定义函数。 从 SQL Server 2019(15.x)开始,SQL Server 数据库引擎 可以内联化这些函数,并在查询处理中解锁并行处理的使用。 有关标量UDF内联的更多信息,请参见 SQL数据库中的智能查询处理。 |
| 远程查询 | 有关远程查询的更多信息,请参见逻辑和物理 showplan 运算符参考。 |
| 动态游标 | 有关光标的更多信息,请参见 DECLARE CURSOR。 |
| 递归查询 | 关于递归的更多信息,请参见定义和使用递归公用表表达式的指南和T-SQL 中的递归。 |
| 多语句表值函数 (MSTVF) | 有关多语句表值函数 (MSTVF) 的更多信息,请参见 创建用户定义的函数(数据库引擎)。 |
TOP 关键字 |
有关更多信息,请参见 TOP。 |
查询执行计划可能包含 QueryPlan 元素中的 NonParallelPlanReason 属性,该属性描述未使用并行度的原因。 此属性的值包括:
| NonParallelPlanReason 值 | 说明 |
|---|---|
MaxDOPSetToOne |
最大并行度设为 1。 |
EstimatedDOPIsOne |
估计的并行度为 1。 |
NoParallelWithRemoteQuery |
远程查询不支持并行度。 |
NoParallelDynamicCursor |
动态游标不支持并行计划。 |
NoParallelFastForwardCursor |
快进游标不支持并行执行计划。 |
NoParallelCursorFetchByBookmark |
不支持通过书签获取数据的游标使用并行执行计划。 |
NoParallelCreateIndexInNonEnterpriseEdition |
非企业版不支持创建并行索引。 |
NoParallelPlansInDesktopOrExpressEdition |
桌面版和 Express 版不支持并行计划。 |
NonParallelizableIntrinsicFunction |
查询引用不可并行的内部函数。 |
CLRUserDefinedFunctionRequiresDataAccess |
需要数据访问的 CLR UDF 不支持并行。 |
TSQLUserDefinedFunctionsNotParallelizable |
查询引用不可并行的 T-SQL 用户定义函数。 |
TableVariableTransactionsDoNotSupportParallelNestedTransaction |
表变量事务不支持并行嵌套事务。 |
DMLQueryReturnsOutputToClient |
DML 查询将输出返回到客户端,并且不可并行化。 |
MixedSerialAndParallelOnlineIndexBuildNotSupported |
不支持在单次在线索引构建中混合使用串行和并行执行计划。 |
CouldNotGenerateValidParallelPlan |
验证并行执行计划失败,回退到串行执行。 |
NoParallelForMemoryOptimizedTables |
被引用的内存中 OLTP 表不支持并行处理。 |
NoParallelForDmlOnMemoryOptimizedTable |
内存中 OLTP 表上的 DML 不支持并行。 |
NoParallelForNativelyCompiledModule |
引用的本机编译模块不支持并行。 |
NoRangesResumableCreate |
可恢复的创建操作的范围生成失败。 |
插入交换运算符之后,结果便为并行查询执行计划。 并行查询执行计划可以使用多个工作线程。 非并行(串行)查询使用的串行执行计划仅使用一个工作线程来实现执行。 并行查询实际使用的工作线程数量是在查询计划执行初始化时确定,具体取决于计划的复杂度和并行程度。
并行度(DOP)指定了执行并行任务的最大处理器数量。 DOP并不表示查询所使用的总工作线程数。 DOP 限制根据任务设置。 它不是针对每个请求或每个查询的限制。 这意味着,在并行查询期间,单个请求可以生成多个任务,然后将它们分配给计划程序。 当不同任务同时执行时,在查询执行的任意时刻,可能会并发使用多于 MAXDOP 所指定数量的处理器。 有关详细信息,请参阅 线程和任务体系结构指南。
如果满足以下任一条件,查询优化器不会对查询使用并行执行计划:
串行执行计划非常简单,或者未超过并行度成本阈值设置。
串行执行计划的总估计子树开销低于优化器探索的任何并行执行计划。
查询包含无法并行运行的标量运算符或关系运算符。 某些运算符可能会导致查询计划的一部分以串行模式运行,或者导致整个计划以串行模式运行。
注意
并行执行计划的总子树成本估计值可能低于并行度设置的成本阈值。 换句话说,串行计划的总估计子树成本超过了前者,因此选择了总估计子树成本较低的查询计划。
并行度 (DOP)
数据库引擎 会自动检测每个并行查询执行或索引数据定义语言(DDL)操作实例的最佳并行度。 它根据以下标准确定该数值:
SQL Server 是否在具有多个微处理器或 CPU 的计算机(例如对称多处理计算机 (SMP))上运行。 只有具有多个 CPU 的计算机才能使用并行查询。
可用的工作线程是否足够。 每个查询或索引操作均要求一定数量的工作线程才能执行。 执行并行计划比执行串行计划需要更多的工作线程,所需工作线程数会随着并行度的提高而增加。 当并行计划对特定并行度的工作线程要求无法满足时,SQL Server 数据库引擎 会自动降低并行度,或串行运行并行计划。
所执行的查询或索引操作的类型。 创建索引、重新生成索引或删除聚集索引等索引操作,以及大量占用 CPU 周期的查询最适合采用并行计划。 例如,大型表的连接、大型聚合以及大型结果集的排序都是很好的候选场景。 基本查询常见于事务处理应用中,往往会认为并行执行查询所需的额外协调超过了潜在的性能提升。 为了区分能够从并行计划中受益的查询和不能从中受益的查询,SQL Server 数据库引擎将比较执行查询或索引操作的估计开销与并行度的开销阈值。 如果经过适当测试发现不同的值更适合当前运行的工作负载,用户可以通过使用
5来更改 的默认值。待处理的行数是否足够。 如果查询优化器判断行数过少,则不会引入交换操作符来进行行的分发。 因此,运算符会串行执行。 以串行计划执行运算符可避免出现这样的情况:启动、分发和协调的开销超过并行执行运算符所获得的收益。
是否有当前统计数据 如果不能达到最高并行度,则在放弃并行计划之前会考虑较低的并行度。 例如,当你在视图上创建聚集索引时,无法评估统计信息,因为聚集索引尚不存在。 在此情况下,SQL Server 数据库引擎无法为索引操作提供最高并行度。 不过,某些运算符(例如,排序和扫描)仍能从并行执行中获益。
注意
并行索引操作只能在 SQL Server Enterprise、Developer 和 Evaluation 版本中使用。
执行时,SQL Server 数据库引擎将确定当前系统工作负荷和前面介绍的配置信息是否允许并行执行。 如果可以确保并行执行,SQL Server 数据库引擎将确定最佳工作线程数,并在这些工作线程间分配并行计划的执行。 从查询或索引操作开始在多工作线程上并行执行起,将一直使用相同的工作线程数,直到操作完成。 每次从计划缓存中检索执行计划时,SQL Server 数据库引擎都会重新检查最佳工作线程决策数。 例如,缓存并行计划的一次执行可以串行运行,同一计划的后续执行可以使用三个工作线程,第三个执行则可以使用四个工作线程。
并行查询执行计划中的 update 和 delete 运算符将按顺序执行,但 WHERE 或 UPDATE 语句的 DELETE 子句可以并行执行。 之后,实际的数据更改将串行应用到数据库。
从数据库兼容性级别110开始, SELECT ... INTO 该语句可以并行执行。 其他形式的插入操作符的工作方式与之前版本中描述相同。
从数据库兼容性级别130开始,在插入堆或聚集列存储索引(CCI)并使用INSERT ... SELECT提示时,可以并行执行TABLOCK语句。 插入本地临时表(用 # 前缀标识)和全局临时表(用 ## 前缀标识)也可通过提示 TABLOCK 进行并行处理。 有关详细信息,请参阅 INSERT。
并行执行计划可以填充静态和由键集驱动的游标。 然而,只有串行执行可以提供动态游标行为。 查询优化器始终为查询生成串行执行计划,这是动态游标的一部分。
覆盖并行度
并行度设置并行计划执行中要使用的处理器数量。 你可以在不同层级设置此配置:
在服务器级别,使用 最大并行度(
MAXDOP)服务器配置选项。适用范围:SQL Server
SQL Server 2019(15.x)在安装过程中引入了针对设置
MAXDOP服务器配置选项的自动建议。 安装程序用户界面允许接受建议的设置或输入自己的值。 有关详细信息,请参阅“数据库引擎配置 - MaxDOP”页。工作负载层级,通过使用
MAX_DOPResource Governor 工作负载组配置选项。适用范围:SQL Server
在数据库级别,通过使用
MAXDOP数据库范围配置。适用于:SQL Server、Azure SQL 数据库 和 Azure SQL 托管实例
在查询或索引语句级别,可通过使用
MAXDOP查询提示 或MAXDOP索引选项。 例如,您可以使用MAXDOP选项,通过增加或减少专门用于在线索引操作的处理器数量来控制。 通过这种方式,你可以在索引操作所用资源与并发用户所用资源之间取得平衡。适用于:SQL Server、Azure SQL 数据库 和 Azure SQL 托管实例
将 max degree of parallelism 选项设置为 0(默认)可使 数据库引擎 能够在并行计划执行中使用所有可用的处理器,最多可达 64 个处理器。 虽然 数据库引擎 在将0选项设置为MAXDOP时,会将运行时目标设定为 64 个逻辑处理器,但如果需要,你可以手动设置不同的值。 对于查询和索引,将 MAXDOP 设置为 0 时,数据库引擎 可以在并行计划执行中对给定的查询或索引使用所有可用的处理器,最多可使用 64 个处理器。
MAXDOP 不是所有并行查询的强制值,而是所有符合并行性条件的查询的暂定目标。 这意味着如果运行时可用的工作线程不足,查询的并行程度可能会低于 MAXDOP 服务器配置选项。
提示
欲了解更多信息,请参阅 MAXDOP 推荐,了解有关在服务器、数据库、查询或查询提示级别配置 MAXDOP 的指导。
并行查询示例
以下查询统计自2024年4月1日开始的某个季度内下达的订单数量,且订单中至少一个行项目在承诺日期之后才被客户收到。 该查询列出这类订单的计数,按每个订单的优先级分组并按优先级升序排序。
该示例使用理论性的表名和列名。
SELECT o_orderpriority,
       COUNT(*) AS Order_Count
FROM orders
WHERE o_orderdate >= '2024/04/01'
      AND o_orderdate < DATEADD(mm, 3, '2024/04/01')
      AND EXISTS (SELECT *
                  FROM lineitem
                  WHERE l_orderkey = o_orderkey
                        AND l_commitdate < l_receiptdate)
GROUP BY o_orderpriority
ORDER BY o_orderpriority;
假设以下索引在 lineitem 和 orders 表中进行定义:
CREATE INDEX l_order_dates_idx
    ON lineitem(l_orderkey, l_receiptdate, l_commitdate, l_shipdate);

CREATE UNIQUE INDEX o_datkeyopr_idx
    ON ORDERS(o_orderdate, o_orderkey, o_custkey, o_orderpriority);
下面是为前面显示的查询生成的一种可能的并行计划:
|--Stream Aggregate(GROUP BY:([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=COUNT(*)))
    |--Parallelism(Gather Streams, ORDER BY:
                  ([ORDERS].[o_orderpriority] ASC))
         |--Stream Aggregate(GROUP BY:
                  ([ORDERS].[o_orderpriority])
                  DEFINE:([Expr1005]=Count(*)))
              |--Sort(ORDER BY:([ORDERS].[o_orderpriority] ASC))
                   |--Merge Join(Left Semi Join, MERGE:
                  ([ORDERS].[o_orderkey])=
                        ([LINEITEM].[l_orderkey]),
                  RESIDUAL:([ORDERS].[o_orderkey]=
                        [LINEITEM].[l_orderkey]))
                        |--Sort(ORDER BY:([ORDERS].[o_orderkey] ASC))
                        |    |--Parallelism(Repartition Streams,
                           PARTITION COLUMNS:
                           ([ORDERS].[o_orderkey]))
                        |         |--Index Seek(OBJECT:
                     ([tpcd1G].[dbo].[ORDERS].[O_DATKEYOPR_IDX]),
                     SEEK:([ORDERS].[o_orderdate] >=
                           Apr  1 2024 12:00AM AND
                           [ORDERS].[o_orderdate] <
                           Jul  1 2024 12:00AM) ORDERED)
                        |--Parallelism(Repartition Streams,
                     PARTITION COLUMNS:
                     ([LINEITEM].[l_orderkey]),
                     ORDER BY:([LINEITEM].[l_orderkey] ASC))
                             |--Filter(WHERE:
                           ([LINEITEM].[l_commitdate]<
                           [LINEITEM].[l_receiptdate]))
                                  |--Index Scan(OBJECT:
         ([tpcd1G].[dbo].[LINEITEM].[L_ORDER_DATES_IDX]), ORDERED)
下图展示了一个查询计划,其并行度为 4,并且涉及两表连接。
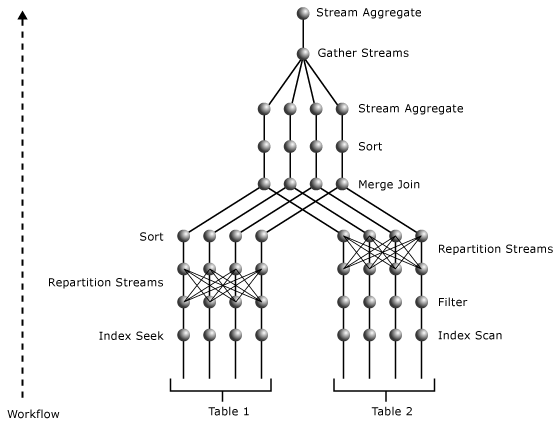
该并行计划包含三个并行操作符。
o_datkey_ptr 索引的 Index Seek 运算符和 l_order_dates_idx 索引的 Index Scan 运算符都会并行执行。 该过程会产生多个独立流,分别可从索引扫描算符和索引查找算符上方最近的并行算子确定。 两个运算符都在对交换操作的类型重新进行分区。 它们在流之间重新洗牌数据,输出流数与输入流数相同。 这个流数等于并行度。
索引扫描算子上的 l_order_dates_idx 并行算子使用 L_ORDERKEY 的值作为键对输入流进行重新划分。 这样, L_ORDERKEY 的相同值将得到相同的输出流。 同时,输出流维护 L_ORDERKEY 列的顺序,以满足 Merge Join 运算符的输入要求。
索引查找算子上的并行算子使用 O_ORDERKEY 的值重新划分其输入流。 由于输入未按 O_ORDERKEY 列值排序,而该列是在 Merge Join 操作符中的连接列,因此,并行操作符与合并连接操作符之间的排序操作符会确保输入按连接列排序,以供 Merge Join 操作符使用。 与 Merge Join 运算符一样,Sort 运算符也是并行执行的。
顶层的并行运算符将多个流的结果收集成一个流。 随后,由位于并行操作符下方的“流聚合”操作符执行的部分聚合操作,会被累加为单个 SUM 值,对应位于并行操作符上方的“流聚合”操作符中 O_ORDERPRIORITY 的每个不同值。 由于该计划有两个交换段,并行度等于 4,它使用了八个工作线程。
有关本例中使用的操作符的更多信息,请参见 逻辑和物理 Showplan 运算符参考。
并行索引操作
用于创建或重建索引或丢弃聚集索引的索引操作的查询计划,可以支持拥有多个处理器的计算机上的并行多线程操作。
注意
并行索引操作仅在企业版中提供。
数据库引擎 使用与其他查询相同的算法来确定索引操作的并行度(可运行的独立工作线程总数)。
max degree of parallelism 服务器配置选项设置了索引操作的最大并行度。 你可以通过在max degree of parallelism、ALTER TABLE、DROP INDEX和ALTER INDEX语句中设置CREATE INDEX索引选项来覆盖单个索引操作的MAXDOP值。
当 SQL Server 数据库引擎 构建索引执行计划时,并行操作次数会从以下值中取出最低值:
- 计算机中的处理器数量,或称CPU。
- 在服务器配置选项中指定的
max degree of parallelism数值。 - 指尚未超过 SQL Server 工作线程工作量阈值的 CPU 数量。
例如,在一台拥有八个CPU的计算机上,其中 max degree of parallelism 设置为 6,索引操作最多使用六个并行工作线程。 如果在生成索引执行计划时计算机中的 5 个 CPU 超出了 SQL Server 工作的阈值,则执行计划仅指定三个并行工作线程。
并行索引操作的主要阶段包括:
- 协调工作线程快速并随机地扫描表,以估计索引键的分布情况。 协调工作线程建立键边界,创建若干键区间,其数量等于并行操作的并行度,每个键区间估计覆盖相近的行数。 例如,如果表中有四百万行且并行度为4,协调工作线程会确定用来分隔四组行的关键值,每组行有100万行。 如果协调工作线程无法建立足够的密钥范围来使用所有 CPU,它会相应降低并行度。
- 协调工作线程分派与并行操作度相等的若干工作线程,并等待这些工作线程完成它们的工作。 每个工作线程都使用筛选器扫描基表,筛选器只检索键值位于分配给工作线程的范围内的行。 每个工作线程都为其键范围内的行生成索引结构。 在已分区索引的情况下,每个工作线程将生成指定数目的分区。 工作线程之间不能共享分区。
- 在所有并行工作线程完成后,协调工作线程将索引子单元连接到单一索引。 此阶段只适用于脱机索引操作。
单个 CREATE TABLE 或 ALTER TABLE 语句可以有多个约束,需要创建索引。 虽然每个单独的索引创建操作可能是具有多个 CPU 的计算机上的并行操作,但是这些多个索引创建操作连续执行。
分布式查询体系结构
数据库引擎 支持两种方法在 T-SQL 语句中引用异构 OLE DB 数据源:
链接服务器名称
使用系统存储过程
sp_addlinkedserver和sp_addlinkedsrvlogin为 OLE DB 数据源赋予服务器名称。 你可以在 T-SQL 语句中使用四部分名称引用这些链接服务器中的对象。 例如,如果DeptSQLSrvr的一个链接服务器名称是用另一个 SQL Server 的实例定义的,则下面的语句引用该服务器上的一个表:SELECT JobTitle, HireDate FROM DeptSQLSrvr.AdventureWorks2025.HumanResources.Employee;你也可以在
OPENQUERY语句中指定链接的服务器名称,以打开 OLE DB 数据源中的行集。 然后你可以像在 T-SQL 语句中的表一样引用这个行集。即席连接器名称
对于不频繁引用数据源,指定
OPENDATASOURCE或OPENROWSET函数,并提供连接链接服务器所需的信息。 然后你可以像在 T-SQL 语句中引用表一样引用行集:SELECT a.* FROM OPENROWSET ( 'Microsoft.Jet.OLEDB.4.0', 'MSOffice\Access\Samples\Northwind.mdb'; 'Admin'; '', Employees ) AS a;
数据库引擎 使用 OLE DB 在关系引擎和存储引擎之间通信。 关系型引擎将每个 T-SQL 语句拆分为一系列对基本的 OLE DB 行集进行的操作,这些行集由存储引擎从基表中打开。 这一过程意味着关系引擎还可以在任何 OLE DB 数据源上开启基本的 OLE DB 行集。
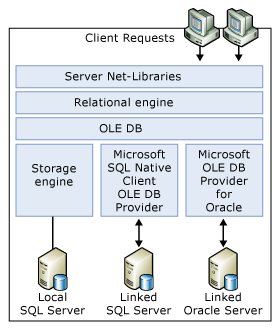
关系引擎使用 OLE DB 应用程序编程接口 (API) 打开链接服务器上的行集、提取行并管理事务。
对于你作为链接的服务器访问的每个 OLE DB 数据源,运行 SQL Server 的服务器必须拥有 OLE DB 提供程序。 你可以针对特定 OLE DB 数据源使用的 T-SQL 操作集合取决于 OLE DB 提供商的能力。
对于每个 SQL Server 实例,sysadmin 固定服务器角色的成员可以通过使用 SQL Server DisallowAdhocAccess 属性来启用或禁用 OLE DB 提供者的即席连接器名称。 当你启用即席访问时,任何登录该实例的用户都可以执行包含即席连接器名称的 T-SQL 语句,引用 OLE DB 提供程序可访问的网络上任意数据源。 为了控制对数据源的访问,sysadmin 固定服务器角色的成员可以禁用该 OLE DB 提供程序的即席访问,从而将用户限制为只能访问由管理员定义的链接服务器名称所引用的数据源。 默认情况下,对 SQL Server OLE DB 提供程序启用即席访问,而对所有其他的 OLE DB 提供程序禁用即席访问。
分布式查询允许用户利用SQL Server服务运行的Windows账户的安全上下文,访问其他数据源(例如文件、非关系型数据源如Active Directory等)。 SQL Server会针对Windows登录适当地模拟该登录名。 然而,这种模拟功能无法用于SQL Server登录。 这一限制可能会允许分布式查询用户访问另一个用户本身没有权限、但运行 SQL Server 服务的账户拥有权限的数据源。 使用 sp_addlinkedsrvlogin 定义被授权访问相应链接服务器的特定登录名。 该控制不适用于即席名称,因此启用 OLE DB 提供商用于即席访问时需谨慎。
在可能的情况下,数据库引擎 会向 OLE DB 数据源推送关系操作,如连接、筛选、投影、排序和分组操作。 数据库引擎 不会默认将基表扫描到 SQL Server 中并自行执行关系操作。 数据库引擎 查询 OLE DB 提供程序以确定其支持的 SQL 语法级别,并基于这些信息向提供者推送尽可能多的关系操作。
数据库引擎 规定了一种机制,使 OLE DB 提供者能够返回统计数据,指示关键值在 OLE DB 数据源中的分布方式。 该机制使数据库引擎查询优化器能够更好地根据每个T-SQL语句的要求分析数据源中的数据模式,提升查询优化器生成最优执行计划的能力。
分区表和索引上的查询处理
数据库引擎 支持分区表和索引的分区感知查询处理。 本节介绍查询处理器如何处理分区对象,如何解释涉及分区的执行计划,以及提升分区对象查询性能的最佳实践。
注意
SQL Server Standard 版支持分区表和索引,从 SQL Server 2016(13.x)服务包 1 开始。
新增的分区感知查找操作
在 数据库引擎 中,查询处理器内部将分区表视为以 PartitionID 为前导列的多列索引。
PartitionID 是一个隐藏的计算列,在内部用于表示包含特定行的分区的 ID。 例如,假设表 T 定义为 T(a, b, c),按列 a 进行分区,并在列 b 上具有聚集索引。 该分区表被视为具有 T(PartitionID, a, b, c) 架构且在组合键 (PartitionID, b) 上具有聚类索引的非分区表。 这种表示方式使查询优化器能够基于 PartitionID 对任意分区表或索引执行寻道操作。
分区消除现在在此查找操作中完成。
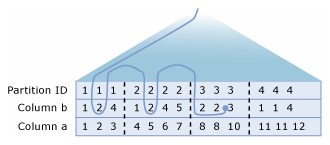
此外,查询优化器得到了扩展,使得可以在 PartitionID(作为逻辑首列)以及可能的其他索引键列上进行带有一个条件的寻道或扫描操作。 查询处理器随后对每个符合第一级查找操作条件的不同值,在一个或多个附加列上使用不同的条件执行二级查找。 这种操作称为 分区跳过扫描,允许查询优化器基于一个条件执行查找或扫描操作以确定要访问的分区,并在该操作符内进行二级索引查找操作,返回这些分区中满足不同条件的行。 例如,请考虑以下查询。
SELECT *
FROM T
WHERE a < 10
      AND b = 2;
在此示例中,假设表 T,定义为 T(a, b, c),按列 a 进行分区,并在列 b 上具有聚集索引。 以下划分函数定义了表 T的划分边界:
CREATE PARTITION FUNCTION myRangePF1(INT)
    AS RANGE LEFT
    FOR VALUES (3, 7, 10);
为求解该查询,查询处理器将执行第一级查找操作以查找包含符合条件 T.a < 10的行的每个分区。 该操作用于识别需要访问的分区。 在每个识别出的分区内,处理器随后对列 b 的聚类索引进行二级查找,以寻找满足条件 T.b = 2 和 T.a < 10 的行。
下图是分区跳过扫描操作的逻辑表示。 图中显示了表 T,其数据位于列 a 和 b 中。 分区编号为 1 到 4,分区边界由垂直虚线表示。 对划分进行的一级寻道操作(图中未显示)确定划分1、2和3满足由表的划分定义和列谓词 a(T.a < 10)所暗示的寻道条件。 二级查找所经过的路径用曲线表示。 本质上,该操作在每个划分中寻找满足条件 b = 2的行。 操作的总成本与三个独立索引查找的总成本相同。
在查询执行计划中显示分区信息
通过使用 T-SQL SET 语句 SET SHOWPLAN_XML 或 SET STATISTICS XML,或使用 SSMS 中的图形执行计划输出,检查对分区表和索引的查询的执行计划。 例如,你可以在 查询编辑器 工具栏中选择“显示预计执行计划”来显示编译时执行计划,通过选择“包含实际执行计划”显示运行时计划。
通过使用这些工具,您可以找到以下信息:
- 访问分区表或索引的操作如扫描、查找、插入、更新、合并和删除。
- 查询访问的分区。 例如,运行时执行计划包括访问的分区总数和被访问的连续分区范围。
- 当使用分区跳过扫描操作时,该操作用于查找或扫描操作,以从一个或多个分区中检索数据。
增强的分区信息
数据库引擎为编译时和运行时执行计划提供增强的分区信息。 现在,执行计划可以提供以下信息:
- 一个可选
Partitioned属性表示运算符(如查找、扫描、插入、更新、合并或删除)是在分区表上执行的。 - 会生成一个新的
SeekPredicateNew元素,其SeekKeys子元素包含PartitionID作为主索引键列,以及指定在PartitionID上进行范围查找的过滤条件。 两个子元素SeekKeys的存在表明对其进行了分区跳跃扫描PartitionID。 - 提供访问的分区总数的摘要信息。 只有在运行时计划中才有此信息。
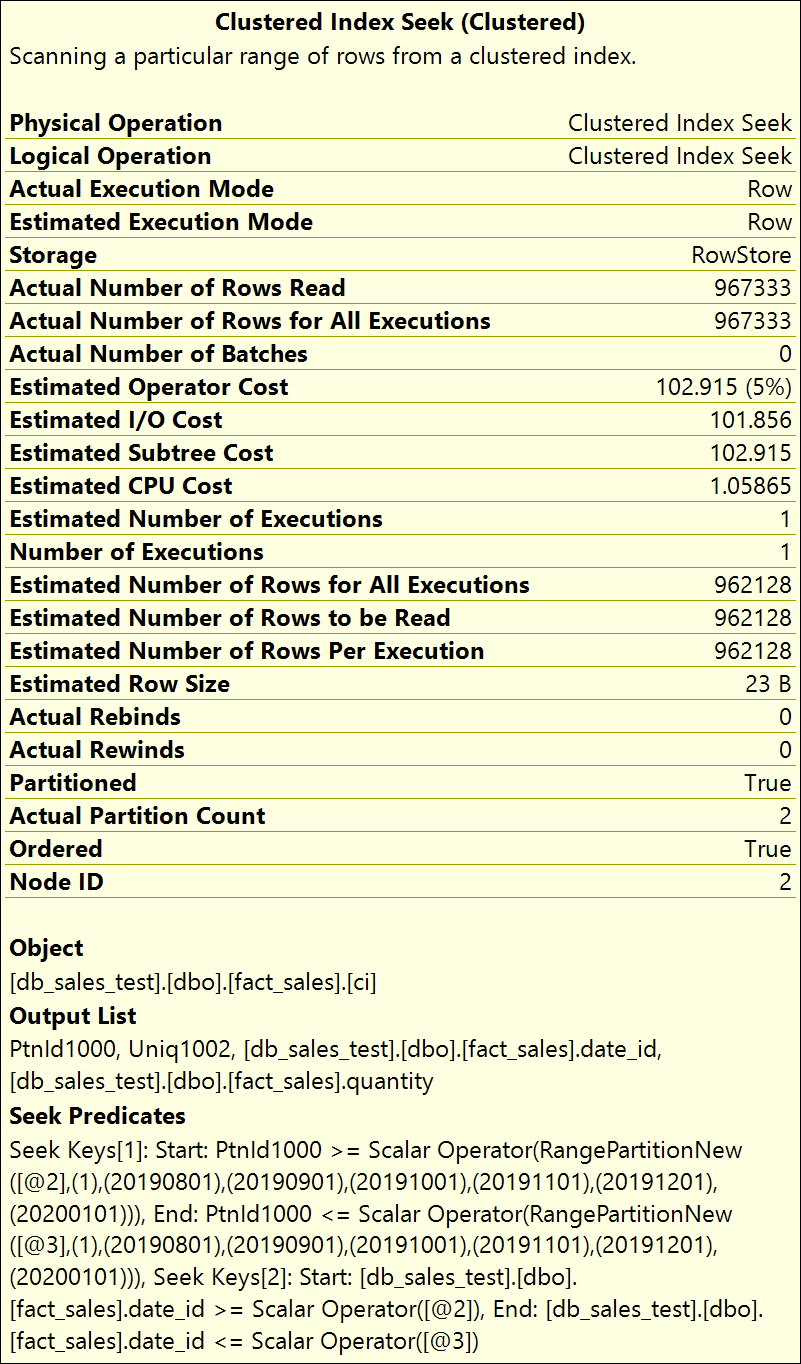
为演示此信息在图形执行计划输出和 XML 显示计划输出中的显示方式,请考虑对已分区表 fact_sales的以下查询。 此查询将更新两个分区中的数据。
UPDATE fact_sales
    SET quantity = quantity - 2
WHERE date_id BETWEEN 20190802 AND 20190902;
下图显示了此查询的运行时执行计划中 Clustered Index Seek 运算符的属性。 要查看表的 fact_sales 定义和划分定义,请参见 示例。
已分区属性
对已分区表或已分区索引执行某个运算符(例如 Index Seek )时,Partitioned 属性将出现在编译时和运行时计划中并设置为 True (1)。 当属性设置为 False (0)时,它不会显示。
Partitioned 属性可以出现在以下物理和逻辑运算符中:
- 表扫描
- 索引扫描
- 索引查找
- 插入
- 更新
- 删除
- 合并
如前图所示,该属性出现在定义该属性的算符的属性中。 在 XML Showplan 输出中,该属性在定义它的操作符的 RelOp 节点中显示为 Partitioned="1"。
新增的 Seek 谓词
在XML Showplan输出中,元素 SeekPredicateNew 出现在定义它的操作符中。 它最多可以包含两个 SeekKeys 子元素实例。 第一个 SeekKeys 项目指定在逻辑索引的分区 ID 级别进行的一级查找操作。 也就是说,该寻道操作确定了必须访问以满足查询条件的分区。 第二 SeekKeys 项指定了在第一级寻道中识别的每个分区内发生的二级寻道。
分区摘要信息
在运行时执行计划中,分区摘要信息提供了所访问分区的计数以及所访问的实际分区的标识。 您可以使用此信息来验证查询中所访问的分区是否正确以及所有其他分区是否均排除在外。
提供以下信息: Actual Partition Count和 Partitions Accessed。
Actual Partition Count 是查询所访问的分区总数。
Partitions Accessed 在 XML Showplan 输出中,是在定义它的操作符的 RuntimePartitionSummary 节点中的新 RelOp 元素内出现的分区摘要信息。 下面的示例显示了 RuntimePartitionSummary 元素的内容,它表明共访问了两个分区(分区 2 和 3)。
<RunTimePartitionSummary>
    <PartitionsAccessed PartitionCount="2" >
        <PartitionRange Start="2" End="3" />
    </PartitionsAccessed>
</RunTimePartitionSummary>
通过使用其他 showplan 方法显示分区信息
显示计划方法 SHOWPLAN_ALL、SHOWPLAN_TEXT和 STATISTICS PROFILE 并不报告本文所述的分区信息,但以下情况例外。 作为 SEEK 谓词的一部分,要访问的分区由表示该分区 ID 的计算列上的范围谓词标识。 下面的示例演示如何将 SEEK 谓词用于 Clustered Index Seek 运算符。 访问的分区是分区 2 和 3,并且该查找运算符将筛选符合条件 date_id BETWEEN 20190802 AND 20190902的行。
|--Clustered Index Seek(OBJECT:([db_sales_test].[dbo].[fact_sales].[ci]),
        SEEK:([PtnId1000] >= (2) AND [PtnId1000] <= (3)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] >= (20190802)
                AND [db_sales_test].[dbo].[fact_sales].[date_id] <= (20190902))
                ORDERED FORWARD)
解释已分区堆的执行计划
分区堆被视为基于分区 ID 的逻辑索引。 在执行计划中,分区堆上的分区消除表示为一个带有基于分区 ID 的 SEEK 谓词的 Table Scan 算子。 下面的示例显示了所提供的 Showplan 信息:
|-- Table Scan (OBJECT: ([db].[dbo].[T]), SEEK: ([PtnId1001]=[Expr1011]) ORDERED FORWARD)
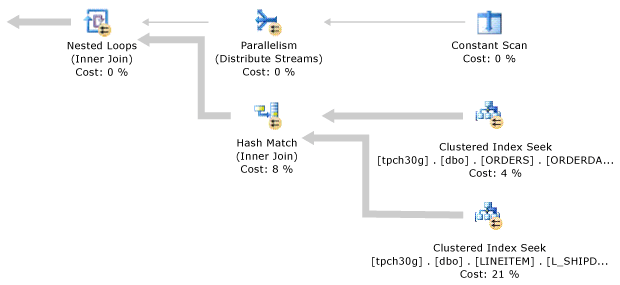
解释并置联接的执行计划
当两张表使用相同或等效的分区函数进行分区,且连接条件中指定了连接双方的分区列时,可能会发生连接共置。 查询优化器可以生成一个计划,其中具有相等分区 ID 的每个表的分区将分别联接在一起。 并置联接可能比非并置联接的执行速度快,因为前者可以只需较少的内存和处理时间。 查询优化器会基于成本估计来选择非并置计划或并置计划。
在同位连接计划中,Nested Loops 连接操作符从内部读取一个或多个被连接的表或索引分区。
Constant Scan 运算符内的数字表示分区号。
当为分区表或索引生成同位连接的并行计划时,Constant Scan 和 Nested Loops 连接操作符之间会出现一个并行操作符。 在此情况下,在联接外侧的多个工作线程会各自在不同的分区上进行读取和操作。
下图展示了一个同位连接的并行查询计划。
已分区对象的并行查询执行策略
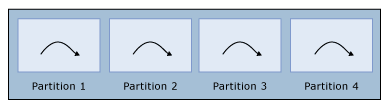
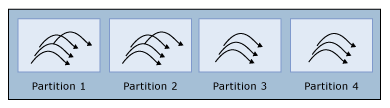
查询处理器对从已分区对象选择查询使用并行执行策略。 作为执行策略的一部分,查询处理器会确定查询所需的表分区,以及要分配给每个分区的工作线程比例。 在大多数情况下,查询处理器会为每个分区分配数量相等或几乎相等的工作线程,然后在这些分区中并行地执行查询。 以下几段更详细地介绍了工作线程分配情况。
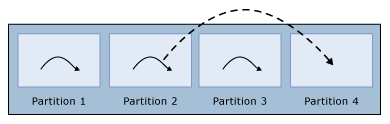
如果工作线程数小于分区数,则查询处理器会将每个工作线程分配给一个不同的分区,最初会有一个或多个分区没有获得分配的工作线程。 当一个工作线程在某个分区上完成执行后,查询处理器会将其分配到下一个分区,直到每个分区都被分配到一个工作线程。 这种分配是查询处理器唯一一次将工作线程重新分配到其他分区的情况。
显示了工作线程在完成后被重新分配的情况。 如果工作线程数与分区数相等,则查询处理器会为每个分区分配一个工作线程。 工作线程完成时,不会重新分配给另一个分区。
如果工作线程数大于分区数,则查询处理器会为每个分区分配相等数量的工作线程。 如果工作线程数不等于分区数的整数倍,查询处理器会为某些分区分配一个额外的工作线程,以便使用所有可用的工作线程。 如果只有一个分区,所有工作线程都分配到该分区。 下图中,有四个分区和14个工作线程。 每个分区分配了三个工作线程,两个分区有额外的工作线程,总计14个工作线程分配。 工作线程完成时,不会重新分配给另一个分区。
虽然前面的例子提出了一种简单的工作线程分配方法,但实际策略更为复杂,并考虑了查询执行过程中出现的其他变量。 例如,如果表是分区的,列 A 上有聚类索引,并且查询具有谓词子句 WHERE A IN (13, 17, 25),则查询处理器会为这三个查找值(A = 13、A = 17 和 A = 25)中的每一个分配一个或多个工作线程,而不是为每个表分区分配。 只需在包含这些值的分区中执行查询,如果所有这些查找谓词都恰好位于同一个表分区中,所有工作线程都会被分配到同一个表分区。
再举一个例子,假设表在列 A 上有四个分区,边界点为(10、20、30),列上 B有一个索引,查询有一个谓词子句 WHERE B IN (50, 100, 150)。 由于表的分区基于的 A值,这些 B 值可以出现在任何一个表的分区中。 因此,查询处理器会在四个表分区中的每一个中查找 B 的三个值(50、100、150)。 查询处理器按比例分配工作线程,以便并行执行这12个查询扫描中的每一个。
按列进行的表分区 A |
在每个表分区中寻找列 B |
|---|---|
表分区1: A < 10 |
B = 50、 B = 100、、 B = 150 |
表格分区2: A >= 10 AND A < 20 |
B = 50、 B = 100、、 B = 150 |
表格分区3: A >= 20 AND A < 30 |
B = 50、 B = 100、、 B = 150 |
表格分区4: A >= 30 |
B = 50、 B = 100、、 B = 150 |
最佳做法
为了提升访问大量来自大型分区表和索引数据的查询性能,请遵循以下最佳实践:
将每个分区跨多个磁盘条带化。 这种方法在使用机械硬盘时尤为重要。
尽可能使用具有足够主内存的服务器以便在内存中保留频繁访问的分区或所有分区,以减少 I/O 开销。
如果你查询的数据无法存储在内存中,可以压缩表和索引以降低I/O成本。
使用具有快速处理器的服务器以及尽可能多的处理器核,以充分利用并行查询处理能力。
确保服务器具有足够的 I/O 控制器带宽。
对每个大型已分区表创建聚集索引,以充分利用 B 树扫描优化。
在批量加载数据到分区表时,请遵循白皮书《数据加载性能指南》中的最佳实践建议。
示例
下面的示例创建一个测试数据库,其中包含一个带有七个分区的表。 要查看编译时和运行时计划的分区信息,执行本例查询时,请使用“ 在查询执行计划中显示分区信息 ”中描述的工具。
注意
本示例要向表中插入超过 100 万行数据。 具体取决于硬件情况,运行本示例可能需要几分钟时间。 在执行本示例之前,请确保您有超过 1.5 GB 的可用磁盘空间。
USE master;
GO

IF DB_ID(N'db_sales_test') IS NOT NULL
    DROP DATABASE db_sales_test;
GO

CREATE DATABASE db_sales_test;
GO

USE db_sales_test;
GO

CREATE PARTITION FUNCTION pf_range_fact(INT)
    AS RANGE RIGHT
    FOR VALUES (20190801, 20190901, 20191001, 20191101, 20191201, 20200101);
GO

CREATE PARTITION SCHEME ps_fact_sales
    AS PARTITION pf_range_fact
    ALL TO ([PRIMARY]);
GO

CREATE TABLE fact_sales
(
    date_id INT,
    product_id INT,
    store_id INT,
    quantity INT,
    unit_price NUMERIC (7, 2),
    other_data CHAR (1000)
) ON ps_fact_sales (date_id);
GO

CREATE CLUSTERED INDEX ci
    ON fact_sales(date_id);
GO

PRINT 'Loading...';

SET NOCOUNT ON;

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 1000000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190800 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END
GO

DECLARE @i AS INT;

SET @i = 1;

WHILE (@i < 10000)
    BEGIN
        INSERT INTO fact_sales
        VALUES (20190900 + (@i % 30) + 1, @i % 10000, @i % 200, RAND() - 25, (@i % 3) + 1, '');
        SET @i += 1;
    END

PRINT 'Done.';
GO

-- Two-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190802 AND 20190902
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO

-- Single-partition query.
SET STATISTICS XML ON;
GO

SELECT date_id,
       SUM(quantity * unit_price) AS total_price
FROM fact_sales
WHERE date_id BETWEEN 20190801 AND 20190831
GROUP BY date_id;
GO

SET STATISTICS XML OFF;
GO