适用范围:SQL Server
总结
Microsoft SQL Server(sqlservr.exe进程占用过多处理器时间)中的 CPU 使用率较高通常源于查询效率低、索引缺失、统计信息过时、参数敏感计划或工作负荷增加。 本文将引导你完成有序的故障排除过程,以首先确认SQL Server是 CPU 压力的来源,然后确定消耗 CPU 最多的查询。 然后,它解释了目标修复,例如更新统计信息、添加缺失索引、解决参数探查和 SARGability 问题、禁用繁重跟踪和缓解旋转锁争用。 最后,它涵盖了操作系统和虚拟机优化,包括Windows电源计划,以及何时纵向扩展到更多 CPU 的指导。 使用这些步骤可减少持续 CPU 利用率、恢复查询性能,并确定何时需要硬件纵向扩展。
SQL Server中 CPU 使用率较高的常见原因
尽管导致 SQL Server CPU 使用率高的可能原因很多,但最常见的原因如下:
- 由于以下条件,表或索引扫描导致的逻辑读取较高:
- 过时的统计信息
- 缺失索引
- 参数敏感计划 (PSP) 问题
- 查询设计不佳
- 工作负载增加
使用以下步骤排查SQL Server中的高 CPU 使用率问题。
步骤 1:验证 SQL Server 是否导致 CPU 使用率过高
使用以下工具之一检查 SQL Server 进程是否确实导致 CPU 使用率过高:
任务管理器:在 进程 选项卡上,检查 SQL Server Windows NT-64 Bit 的 CPU 列值是否接近 100%。
性能和资源监视器 (perfmon)
- 计数器:
Process/%User Time,% Privileged Time - 实例:sqlservr
- 计数器:
可以使用以下 PowerShell 脚本在 60 秒的跨度内收集计数器数据:
$serverName = $env:COMPUTERNAME
$Counters = @(
    ("\\$serverName" + "\Process(sqlservr*)\% User Time"), ("\\$serverName" + "\Process(sqlservr*)\% Privileged Time")
)
Get-Counter -Counter $Counters -MaxSamples 30 | ForEach {
    $_.CounterSamples | ForEach {
        [pscustomobject]@{
            TimeStamp = $_.TimeStamp
            Path = $_.Path
            Value = ([Math]::Round($_.CookedValue, 3))
        }
        Start-Sleep -s 2
    }
}
如果
% User Time始终大于 90%(“% 用户时间”是每个处理器上的处理器时间之和,其最大值为 100% *(CPU 数量)),则 SQL Server 进程导致了较高的 CPU 使用率。 但如果% Privileged time始终大于 90%,则是防病毒软件、其他驱动程序或计算机上的其他 OS 组件导致 CPU 使用率过高。 你应与系统管理员共同分析此行为的根本原因。性能仪表板:在SQL Server Management Studio中,右键单击 <SQLServerInstance> 并选择“报告>标准报表>性能仪表板”。
仪表板显示一个标题为 System CPU Utilization 的图表,并使用条形图。 较深的颜色表示 SQL Server 引擎 CPU 利用率,而较浅的颜色表示整个操作系统 CPU 使用率(请参阅图形上的图例以供参考)。 选择圆形刷新按钮或 F5 以查看更新的利用率。
步骤 2:确定影响 CPU 使用率的查询
当 Sqlservr.exe 进程导致 CPU 使用率显著升高时,原因通常是 SQL Server 查询执行了表或索引扫描,其次是排序、哈希操作以及循环(例如嵌套循环运算符或 WHILE (T-SQL))。 要了解查询当前占总体 CPU 容量的多少,请运行以下语句:
DECLARE @init_sum_cpu_time int,
        @utilizedCpuCount int
--get CPU count used by SQL Server
SELECT @utilizedCpuCount = COUNT( * )
FROM sys.dm_os_schedulers
WHERE status = 'VISIBLE ONLINE'
--calculate the CPU usage by queries OVER a 5 sec interval
SELECT @init_sum_cpu_time = SUM(cpu_time) FROM sys.dm_exec_requests
WAITFOR DELAY '00:00:05'
SELECT CONVERT(DECIMAL(5,2), ((SUM(cpu_time) - @init_sum_cpu_time) / (@utilizedCpuCount * 5000.00)) * 100) AS [CPU from Queries as Percent of Total CPU Capacity]
FROM sys.dm_exec_requests
若要确定当前负责高 CPU 活动的查询,请运行以下语句:
SELECT TOP 10 s.session_id,
           r.status,
           r.cpu_time,
           r.logical_reads,
           r.reads,
           r.writes,
           r.total_elapsed_time / (1000 * 60) 'Elaps M',
           SUBSTRING(st.TEXT, (r.statement_start_offset / 2) + 1,
           ((CASE r.statement_end_offset
                WHEN -1 THEN DATALENGTH(st.TEXT)
                ELSE r.statement_end_offset
            END - r.statement_start_offset) / 2) + 1) AS statement_text,
           COALESCE(QUOTENAME(DB_NAME(st.dbid)) + N'.' + QUOTENAME(OBJECT_SCHEMA_NAME(st.objectid, st.dbid))
           + N'.' + QUOTENAME(OBJECT_NAME(st.objectid, st.dbid)), '') AS command_text,
           r.command,
           s.login_name,
           s.host_name,
           s.program_name,
           s.last_request_end_time,
           s.login_time,
           r.open_transaction_count
FROM sys.dm_exec_sessions AS s
JOIN sys.dm_exec_requests AS r ON r.session_id = s.session_id CROSS APPLY sys.Dm_exec_sql_text(r.sql_handle) AS st
WHERE r.session_id != @@SPID
ORDER BY r.cpu_time DESC
如果查询当前未占用 CPU,可以运行以下语句来查找历史占用大量 CPU 的查询:
SELECT TOP 10  qs.last_execution_time, st.text AS batch_text,
    SUBSTRING(st.TEXT, (qs.statement_start_offset / 2) + 1, ((CASE qs.statement_end_offset WHEN - 1 THEN DATALENGTH(st.TEXT) ELSE qs.statement_end_offset END - qs.statement_start_offset) / 2) + 1) AS statement_text,
    (qs.total_worker_time / 1000) / qs.execution_count AS avg_cpu_time_ms,
    (qs.total_elapsed_time / 1000) / qs.execution_count AS avg_elapsed_time_ms,
    qs.total_logical_reads / qs.execution_count AS avg_logical_reads,
    (qs.total_worker_time / 1000) AS cumulative_cpu_time_all_executions_ms,
    (qs.total_elapsed_time / 1000) AS cumulative_elapsed_time_all_executions_ms
FROM sys.dm_exec_query_stats qs
CROSS APPLY sys.dm_exec_sql_text(sql_handle) st
ORDER BY(qs.total_worker_time / qs.execution_count) DESC
步骤 3:更新统计信息
确定使用最多 CPU 的查询后,更新统计信息以用于这些查询使用的表。 使用 sp_updatestats 系统存储过程更新当前数据库中所有用户定义表和内部表的统计信息。 例如:
exec sp_updatestats
注意
sp_updatestats 系统存储过程针对当前数据库中的所有用户定义表和内部表运行 UPDATE STATISTICS。 对于定期维护,请确保计划的维护使统计信息保持最新。 使用自适应索引碎片整理等解决方案,自动管理一个或多个数据库的索引碎片整理和统计信息更新。 此过程会自动选择是根据其碎片级别重新生成还是重新组织索引以及其他参数,并使用线性阈值更新统计信息。
有关 sp_updatestats 的更多信息,请参见 sp_updatestats。
如果SQL Server仍使用过多的 CPU 容量,请转到下一步。
步骤 4:添加缺失索引
缺少索引可能导致运行速度较慢的查询和 CPU 使用率过高。 可以识别缺失的索引并创建这些索引,以减轻这种性能影响。
运行以下查询以识别导致 CPU 使用率高且在查询计划中至少包含一个缺失索引的查询:
-- Captures the Total CPU time spent by a query along with the query plan and total executions
SELECT
    qs_cpu.total_worker_time / 1000 AS total_cpu_time_ms,
    q.[text],
    p.query_plan,
    qs_cpu.execution_count,
    q.dbid,
    q.objectid,
    q.encrypted AS text_encrypted
FROM
    (SELECT TOP 500 qs.plan_handle,
     qs.total_worker_time,
     qs.execution_count FROM sys.dm_exec_query_stats qs ORDER BY qs.total_worker_time DESC) AS qs_cpu
CROSS APPLY sys.dm_exec_sql_text(plan_handle) AS q
CROSS APPLY sys.dm_exec_query_plan(plan_handle) p
WHERE p.query_plan.exist('declare namespace
        qplan = "http://schemas.microsoft.com/sqlserver/2004/07/showplan";
        //qplan:MissingIndexes')=1
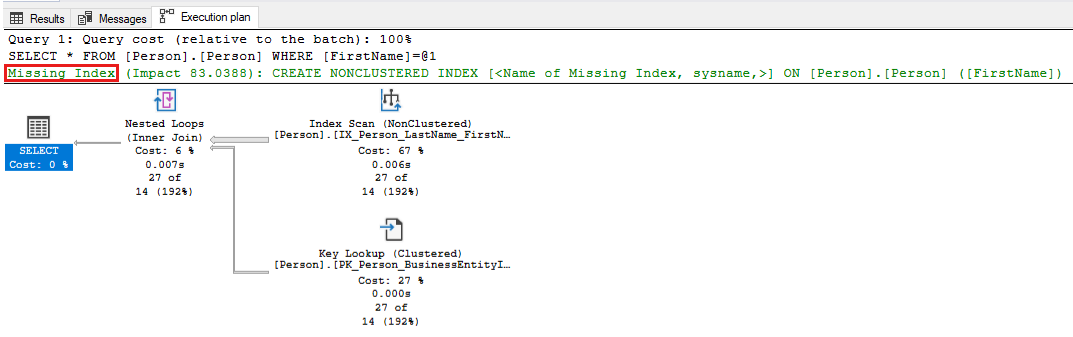
查看已标识查询的执行计划,并通过进行所需的更改来优化查询。 以下屏幕截图显示了一个示例,其中 SQL Server 将指出查询的缺失索引。 右键单击查询计划的“缺失索引”部分,然后选择缺少索引详细信息,在 SQL Server Management Studio 的另一个窗口中创建索引。
使用以下查询检查是否缺少索引,并应用具有高改进度量值的任何建议索引。 从输出中具有最高 improvement_measure 值的前 5 或 10 条建议开始。 这些索引对性能有最显著的积极影响。 确定是否要应用这些索引,并确保对应用程序进行了性能测试。 然后,继续应用缺失索引建议,直到获得所需的应用程序性能结果。 有关本主题的详细信息,请参阅使用缺失索引建议优化非聚集索引。
SELECT CONVERT(VARCHAR(30), GETDATE(), 126) AS runtime,
    mig.index_group_handle,
    mid.index_handle,
    CONVERT(DECIMAL(28, 1), migs.avg_total_user_cost * migs.avg_user_impact * (migs.user_seeks + migs.user_scans)) AS improvement_measure,
    'CREATE INDEX missing_index_' + CONVERT(VARCHAR, mig.index_group_handle) + '_' + CONVERT(VARCHAR, mid.index_handle) + ' ON ' + mid.statement + ' (' + ISNULL(mid.equality_columns,
        '') + CASE WHEN mid.equality_columns IS NOT NULL
AND mid.inequality_columns IS NOT NULL THEN ','
ELSE ''
END + ISNULL(mid.inequality_columns,
        '') + ')' + ISNULL(' INCLUDE (' + mid.included_columns + ')',
        '') AS create_index_statement,
    migs.*,
    mid.database_id,
    mid.[object_id]
FROM sys.dm_db_missing_index_groups mig
INNER JOIN sys.dm_db_missing_index_group_stats migs ON migs.group_handle = mig.index_group_handle
INNER JOIN sys.dm_db_missing_index_details mid ON mig.index_handle = mid.index_handle
WHERE CONVERT (DECIMAL (28, 1),
               migs.avg_total_user_cost * migs.avg_user_impact * (migs.user_seeks + migs.user_scans)) > 10
ORDER BY migs.avg_total_user_cost * migs.avg_user_impact * (migs.user_seeks + migs.user_scans) DESC

步骤 5:调查并解决参数敏感型问题
可以使用 DBCC FREEPROCCACHE 命令释放计划缓存,并检查这是否解决了 CPU 使用率过高的问题。 如果修复该问题后问题得到解决,则表明这是参数敏感问题(PSP,也称为“参数探查问题”)。
注意
使用不带参数的 DBCC FREEPROCCACHE 将从计划缓存中删除所有已编译的计划。 这将导致新查询会再次被编译,从而导致每个新查询都会一次性花费更长时间。 最佳方法是使用 DBCC FREEPROCCACHE ( plan_handle | sql_handle ) 来识别哪个查询可能导致该问题,然后解决该单个查询或这些查询。
要解决此参数敏感问题,请使用以下方法。 每种方法都有相应的利弊。
使用 RECOMPILE 查询提示。 可以向在步骤 2中标识的一个或多个 CPU 过高查询添加
RECOMPILE查询提示。 此提示有助于在编译 CPU 使用率略微增加与每次查询执行更优性能之间取得平衡。 有关详细信息,请参阅参数和执行计划重用、 参数敏感度和 RECOMPILE 查询提示。下面是如何将此提示应用到查询的示例。
SELECT * FROM Person.Person
WHERE LastName = 'Wood'
OPTION (RECOMPILE)
使用 OPTIMIZE FOR 查询提示,使用适用于数据中大多数值的更典型的参数值覆盖实际参数值。 此选项需要充分了解最佳参数值和关联的计划特征。 下面是如何在查询中使用此提示的示例。
DECLARE @LastName Name = 'Frintu'
SELECT FirstName, LastName FROM Person.Person
WHERE LastName = @LastName
OPTION (OPTIMIZE FOR (@LastName = 'Wood'))
使用 OPTIMIZE FOR UNKNOWN 查询提示,使用密度向量平均值覆盖实际参数值。 也可以通过捕获本地变量中的传入参数值,然后使用谓词中的本地变量而不是使用参数本身来执行此操作。 对于此修复,平均密度可能足以提供可接受的性能。
使用 DISABLE_PARAMETER_SNIFFING 查询提示,完全禁用参数探查。 下面是如何在查询中使用它的示例:
SELECT * FROM Person.Address
WHERE City = 'SEATTLE' AND PostalCode = 98104
OPTION (USE HINT ('DISABLE_PARAMETER_SNIFFING'))
使用 KEEPFIXED PLAN 查询提示,防止缓存中的计划被重新编译。 此解决方法假定“足够好”的常见计划是已在缓存中的计划。 还可以禁用统计信息自动更新,以减少逐出良好执行计划并编译新的不良执行计划的可能性。
将 DBCC FREEPROCCACHE 命令用作临时解决方案,直到应用程序代码修复为止。 可以使用
DBCC FREEPROCCACHE (plan_handle)命令仅删除导致问题的计划。 例如,若要查找引用 AdventureWorks 中Person.Person表的查询计划,可以使用此查询查找查询句柄。 然后,可以使用查询结果第二列中生成的DBCC FREEPROCCACHE (plan_handle),从缓存中释放特定查询计划。SELECT text, 'DBCC FREEPROCCACHE (0x' + CONVERT(VARCHAR (512), plan_handle, 2) + ')' AS dbcc_freeproc_command FROM sys.dm_exec_cached_plans CROSS APPLY sys.dm_exec_query_plan(plan_handle) CROSS APPLY sys.dm_exec_sql_text(plan_handle) WHERE text LIKE '%person.person%'
步骤 6:调查并解决 SARGability 问题
当 SQL Server 引擎可以使用索引查找来加快查询的执行时,查询中的谓词被视为可 SARG 化(Search ARGument-able)。 许多查询设计会阻碍 SARGability,并导致表或索引扫描以及 CPU 使用率过高。 请考虑 AdventureWorks 数据库的以下查询,其中必须检索每个 ProductNumber 并向其应用 SUBSTRING() 函数,然后再将其与字符串文本值进行比较。 可以看到,必须先提取表的所有行,然后应用函数,才能进行比较。 从表中提取所有行意味着扫描表或索引,这会导致更高的 CPU 使用率。
SELECT ProductID, Name, ProductNumber
FROM [Production].[Product]
WHERE SUBSTRING(ProductNumber, 0, 4) =  'HN-'
对搜索谓词中的列应用任何函数或计算通常会使查询变为非 SARGable,并导致 CPU 占用率增加。 解决方案通常包括以创造性的方式重写查询,从而使查询具备 SARG 性。 此示例的一个可能解决方案是按如下方式重写:从查询谓词中移除该函数,改为搜索另一列,并获得相同结果:
SELECT ProductID, Name, ProductNumber
FROM [Production].[Product]
WHERE Name LIKE  'Hex%'
下面是另一个示例,销售经理可能希望为大额订单提供 10% 的销售佣金,并希望查看哪些订单的佣金将超过 300 美元。 这是合乎逻辑的,但不可进行索引优化(non-sargable)的一种做法。
SELECT DISTINCT SalesOrderID, UnitPrice, UnitPrice * 0.10 [10% Commission]
FROM [Sales].[SalesOrderDetail]
WHERE UnitPrice * 0.10 > 300
下面是一个可能不太直观,但以 SARGable 重写查询的方法,其中计算将移动到谓词的另一边。
SELECT DISTINCT SalesOrderID, UnitPrice, UnitPrice * 0.10 [10% Commission]
FROM [Sales].[SalesOrderDetail]
WHERE UnitPrice > 300/0.10
SARGability 不仅适用于 WHERE 子句,也适用于 JOINs、HAVING、GROUP BY、ORDER BY 子句。 查询中常见的妨碍 SARGability 的情况涉及在 WHERE 或 JOIN 子句中使用 CONVERT()、CAST()、ISNULL()、COALESCE() 函数,从而导致列扫描。 在数据类型转换情况下(CONVERT 或 CAST),解决方法可能是确保你比较的是相同的数据类型。 下面是一个示例,其中 T1.ProdID 列显式转换为 INT 中的 JOIN 数据类型。 此转换会导致无法利用联接列上的索引。 当数据类型不同时,在 SQL Server 为执行联接而转换其中一种类型的隐式转换情况下,也会出现相同的问题。
SELECT T1.ProdID, T1.ProdDesc
FROM T1 JOIN T2
ON CONVERT(int, T1.ProdID) = T2.ProductID
WHERE t2.ProductID BETWEEN 200 AND 300
为了避免对表进行 T1 扫描,可以在正确规划和设计后更改 ProdID 列的基础数据类型,然后联接这两列,而无需使用转换函数 ON T1.ProdID = T2.ProductID。
另一种解决方案是在 T1 中创建一个使用相同 CONVERT() 函数的计算列,然后在其上创建索引。 这将允许查询优化器使用该索引,而无需更改查询。
ALTER TABLE dbo.T1  ADD IntProdID AS CONVERT (INT, ProdID);
CREATE INDEX IndProdID_int ON dbo.T1 (IntProdID);
在某些情况下,无法轻松地重写查询以使其具有 SARGability(可搜索性)。 在那些情况下,请查看带有索引的计算列是否可提供帮助,或者保持查询原样,并意识到它可能使 CPU 使用率更高。
步骤 7:禁用重度跟踪
检查影响SQL Server性能的 SQL 跟踪或 XEvent 跟踪,并导致 CPU 使用率较高。 例如,如果跟踪大量 SQL Server 活动,则使用以下事件可能会导致 CPU 使用率较高:
- 查询计划 XML 事件(
query_plan_profile、query_post_compilation_showplan、query_post_execution_plan_profile、query_post_execution_showplan、query_pre_execution_showplan) - 语句级事件(
sql_statement_completed、sql_statement_starting、sp_statement_starting、sp_statement_completed) - 登录和注销事件(
login、process_login_finish、login_event、logout) - 锁定事件(
lock_acquired、lock_cancel、lock_released) - 等待事件(
wait_info、wait_info_external) - SQL 审核事件(取决于审核的组和该组中的 SQL Server 活动)
运行以下查询以确定活动的 XEvent 或 Server 跟踪:
PRINT '--Profiler trace summary--'
SELECT traceid, property, CONVERT(VARCHAR(1024), value) AS value FROM::fn_trace_getinfo(
    default)
GO
PRINT '--Trace event details--'
SELECT trace_id,
    status,
    CASE WHEN row_number = 1 THEN path ELSE NULL end AS path,
    CASE WHEN row_number = 1 THEN max_size ELSE NULL end AS max_size,
    CASE WHEN row_number = 1 THEN start_time ELSE NULL end AS start_time,
    CASE WHEN row_number = 1 THEN stop_time ELSE NULL end AS stop_time,
    max_files,
    is_rowset,
    is_rollover,
    is_shutdown,
    is_default,
    buffer_count,
    buffer_size,
    last_event_time,
    event_count,
    trace_event_id,
    trace_event_name,
    trace_column_id,
    trace_column_name,
    expensive_event
FROM
    (SELECT t.id AS trace_id,
     row_number() over(PARTITION BY t.id order by te.trace_event_id, tc.trace_column_id) AS row_number,
     t.status,
     t.path,
     t.max_size,
     t.start_time,
     t.stop_time,
     t.max_files,
     t.is_rowset,
     t.is_rollover,
     t.is_shutdown,
     t.is_default,
     t.buffer_count,
     t.buffer_size,
     t.last_event_time,
     t.event_count,
     te.trace_event_id,
     te.name AS trace_event_name,
     tc.trace_column_id,
     tc.name AS trace_column_name,
     CASE WHEN te.trace_event_id in (23, 24, 40, 41, 44, 45, 51, 52, 54, 68, 96, 97, 98, 113, 114, 122, 146, 180) THEN CAST(1 as bit) ELSE CAST(0 AS BIT) END AS expensive_event FROM sys.traces t CROSS APPLY::fn_trace_geteventinfo(t.id) AS e JOIN sys.trace_events te ON te.trace_event_id = e.eventid JOIN sys.trace_columns tc ON e.columnid = trace_column_id) AS x
GO
PRINT '--XEvent Session Details--'
SELECT sess.NAME 'session_name', event_name, xe_event_name, trace_event_id,
    CASE WHEN xemap.trace_event_id IN(23, 24, 40, 41, 44, 45, 51, 52, 54, 68, 96, 97, 98, 113, 114, 122, 146, 180)
    THEN Cast(1 AS BIT)
ELSE Cast(0 AS BIT)
END AS expensive_event
FROM sys.dm_xe_sessions sess
JOIN sys.dm_xe_session_events evt
ON sess.address = evt.event_session_address
INNER JOIN sys.trace_xe_event_map xemap
ON evt.event_name = xemap.xe_event_name
GO
步骤 8:修复自旋锁争用导致 CPU 使用率过高的问题
若要解决由旋转锁争用导致的常见高 CPU 使用率,请参阅以下部分。
SOS_CACHESTORE旋转锁争用
如果SQL Server实例遇到严重的SOS_CACHESTORE自旋锁争用,或者你注意到查询计划经常在计划外查询工作负载下被移除,请参阅以下文章,并使用命令启用跟踪标志:
修复:临时 SQL Server 计划缓存上的 SOS_CACHESTORE 旋转锁争用导致 SQL Server 中的 CPU 使用率过高。
如果 CPU 使用率过高的情况通过 T174 得以解决,请使用 SQL Server 配置管理器 将其作为 启动参数 启用。
由于大型内存计算机上的SOS_BLOCKALLOCPARTIALLIST旋转锁争用,随机 CPU 使用率较高
在大型内存计算机上, SOS_BLOCKALLOCPARTIALLIST 旋转锁争用可能会产生 CPU 使用率的随机峰值。 使用以下步骤,通过将单个整个服务器范围内的部分块分配列表划分为多个列表,来减少争用。
确认冲突。 检查
sys.dm_os_spinlock_stats上的collisions和spins值是否偏高(针对SOS_BLOCKALLOCPARTIALLIST旋转锁)。 如果争用与 CPU 峰值关联,请继续执行以下步骤。暂时缓解 CPU 峰值。 运行
DBCC DROPCLEANBUFFERS释放部分块分配列表,并在计划永久修复时提供临时缓解。确保 SQL Server 内部版本包含该修补程序。 分区行为通过跟踪标志 8142 和 8145 传递,并在 SQL Server 2019 年累积更新 21 中首次引入,以解决 bug 2410400。 如果使用的是较旧的内部版本,请在启用跟踪标志之前先为当前版本应用最新的累积更新。
启用跟踪标志 8142。 启用 跟踪标志 8142 作为全局启动参数。 此跟踪标志按 CPU 对受旋转锁保护的列表进行分区,最多 64 个分区,这通常足以消除争用。
如果争用仍然存在,请启用跟踪标志 8145。 在 64 个 CPU 分区不够用的系统上,还启用 跟踪标志 8145 作为全局启动参数。 跟踪标志 8145 将跟踪标志 8142 启用的分区修改为每个软 NUMA 节点,而不是每个 CPU。 除非还启用了跟踪标志 8142,否则它不起作用。
重启 SQL Server 服务,使启动跟踪标志生效,然后重新检查
sys.dm_os_spinlock_stats以确认争用已降低,CPU 使用率已稳定。
由于高端计算机上的XVB_list上的旋转锁争用,CPU 使用率较高
如果 SQL Server 实例在高配置计算机(具有大量较新一代处理器(CPU)的高端系统)上因 XVB_LIST 自旋锁争用而出现 CPU 占用率高的情况,请同时启用跟踪标志 TF8102 和 TF8101。
注意
CPU 使用率过高可能是由其他许多类型的自旋锁争用引起的。 有关旋转锁的详细信息,请参阅 诊断和解决 SQL Server 上的旋转锁争用。
步骤 9:在 OS 级别检查电源计划设置
使用默认均衡电源计划配置Windows时,SQL Server工作负荷可能会遇到性能降低并导致系统上 CPU 过高的问题。 均衡电源计划设置可能会降低 CPU 时钟速度以节省能源。 例如,3.00 GHz 的处理器可能会降频至 1.2 GHz。 因此,由于时钟速度降低,通常消耗大约 30% CPU 的工作负荷可能会达到 100% 利用率。 若要保持计算密集型SQL Server工作负荷的一致和最佳性能,请将系统配置为使用高性能电源计划。 此设置可确保 CPU 以其额定的最高速度运行,从而避免性能瓶颈。 有关详细信息,请参阅 在使用“均衡”电源计划时,Windows Server 性能缓慢。
步骤 10:配置虚拟机
如果使用的是虚拟机,请确保不要过度预配 CPU 并正确配置它们。 有关详细信息,请参阅ESX/ESXi 虚拟机性能问题故障排除 (2001003)。
步骤 11:纵向扩展系统以使用更多 CPU
如果单个查询实例使用很少的 CPU 容量,但所有查询的整体工作负荷都会导致 CPU 消耗过高,请考虑通过添加更多 CPU 来纵向扩展计算机。 使用以下查询查找每次执行的平均和最大 CPU 消耗超过某个阈值,并且在系统上多次运行的查询数。 请确保修改两个变量的值以匹配环境:
-- Shows queries where Max and average CPU time exceeds 200 ms and executed more than 1000 times
DECLARE @cputime_threshold_microsec INT = 200*1000
DECLARE @execution_count INT = 1000
SELECT qs.total_worker_time/1000 total_cpu_time_ms,
       qs.max_worker_time/1000 max_cpu_time_ms,
       (qs.total_worker_time/1000)/execution_count average_cpu_time_ms,
       qs.execution_count,
       q.[text]
FROM sys.dm_exec_query_stats qs CROSS APPLY sys.dm_exec_sql_text(plan_handle) AS q
WHERE (qs.total_worker_time/execution_count > @cputime_threshold_microsec
        OR qs.max_worker_time > @cputime_threshold_microsec )
        AND execution_count > @execution_count
ORDER BY  qs.total_worker_time DESC