特徵表可透過兩種方式供應:
- 模型服務:部署一個以特徵表訓練的模型。 同一端點同時用於特徵查找與模型推論。 端點會 自動查找或計算特徵值,利用模型記錄時追蹤的資料譜系。 利用此資料來提供模型預測。
-
特徵服務:部署可直接參考特徵表的
FeatureSpec,無需模型。 端點會回傳所請求的功能輸出。 當應用程式需要特徵值而非模型預測時,請使用此方法。 如果你最終是使用特徵資料進行模型推論,Databricks 建議直接使用模型服務。
兩種方式都支援預先計算及隨選功能。
需求
- Databricks Runtime 14.2 ML 或更新版本。
- 要使用 Python API,功能服務需要
databricks-feature-engineering版本 0.1.2 或以上,該版本內建於 Databricks Runtime 14.2 ML。 對於較舊 Databricks Runtime ML 版本,請使用%pip install databricks-feature-engineering>=0.1.2手動安裝所需的版本。 如果你使用 Databricks 筆記本,必須在新儲存格執行此指令:dbutils.library.restartPython()來重新啟動 Python 核心。 - 若要使用 Databricks SDK,特徵服務需要
databricks-sdk0.18.0 版或更新版本。 若要手動安裝所需的版本,請使用%pip install databricks-sdk>=0.18.0。 如果你使用 Databricks 筆記本,必須在新儲存格執行此指令:dbutils.library.restartPython()來重新啟動 Python 核心。
Databricks 特徵服務提供了 UI 和數個程式設計選項,可用於建立、更新、查詢和刪除端點。 本文包含下列每個選項的指示:
- Databricks 使用者介面
- REST API
- Python API
- Databricks SDK
若要使用 REST API 或 MLflow 部署 SDK,您必須具有 Databricks API 權杖。
重要
作為生產案例的安全最佳做法,Databricks 建議您在生產期間使用機器對機器 OAuth 權杖進行驗證。
對於測試和開發,Databricks 建議使用屬於服務主體而不是工作區使用者的個人存取權杖。 若要建立服務主體的權杖,請參閱管理服務主體的權杖。
功能服務的驗證
有關認證的資訊,請參見 授權存取Azure Databricks資源。
建立 FeatureSpec
FeatureSpec 是一組用戶定義的特性和函式。 您可以在 FeatureSpec 中合併特徵和函數。
FeatureSpecs 會儲存在 Unity Catalog 並由其管理,且會出現在 [目錄總管] 中。
中指定的 FeatureSpec 數據表必須發佈至在線功能存放區或第三方在線商店。 請參閱 Databricks Online 功能存放區。
您必須使用 databricks-feature-engineering 套件來建立 FeatureSpec。
首先,定義函數:
from unitycatalog.ai.core.databricks import DatabricksFunctionClient

client = DatabricksFunctionClient()

CATALOG = "main"
SCHEMA = "default"

def difference(num_1: float, num_2: float) -> float:
  """
  A function that accepts two floating point numbers, subtracts the second one
  from the first, and returns the result as a float.

  Args:
      num_1 (float): The first number.
      num_2 (float): The second number.

  Returns:
      float: The resulting difference of the two input numbers.
  """
  return num_1 - num_2

client.create_python_function(
  func=difference,
  catalog=CATALOG,
  schema=SCHEMA,
  replace=True
)
然後您可以在FeatureSpec中使用該函數:
from databricks.feature_engineering import (
  FeatureFunction,
  FeatureLookup,
  FeatureEngineeringClient,
)

fe = FeatureEngineeringClient()

features = [
  # Lookup column `average_yearly_spend` and `country` from a table in UC by the input `user_id`.
  FeatureLookup(
    table_name="main.default.customer_profile",
    lookup_key="user_id",
    feature_names=["average_yearly_spend", "country"]
  ),
  # Calculate a new feature called `spending_gap` - the difference between `ytd_spend` and `average_yearly_spend`.
  FeatureFunction(
    udf_name="main.default.difference",
    output_name="spending_gap",
    # Bind the function parameter with input from other features or from request.
    # The function calculates num_1 - num_2.
    input_bindings={"num_1": "ytd_spend", "num_2": "average_yearly_spend"},
  ),
]

# Create a `FeatureSpec` with the features defined above.
# The `FeatureSpec` can be accessed in Unity Catalog as a function.
fe.create_feature_spec(
  name="main.default.customer_features",
  features=features,
)
指定預設值
若要指定功能的預設值,請使用 default_values 中的 FeatureLookup參數。 請參閱下列範例:
feature_lookups = [
    FeatureLookup(
        table_name="ml.recommender_system.customer_features",
        feature_names=[
            "membership_tier",
            "age",
            "page_views_count_30days",
        ],
        lookup_key="customer_id",
        default_values={
          "age": 18,
          "membership_tier": "bronze"
        },
    ),
]
如果使用 rename_outputs 參數重新命名特徵欄,default_values 則必須使用重新命名的特徵名稱。
FeatureLookup(
  table_name = 'main.default.table',
  feature_names = ['materialized_feature_value'],
  lookup_key = 'id',
  rename_outputs={"materialized_feature_value": "feature_value"},
  default_values={
    "feature_value": 0
  }
)
新增 Python 相依性
如果使用者自訂函式(UDF)會匯入 Python 套件,請在建立 FeatureSpec 時宣告這些套件。 該 extra_pip_requirements 參數需要 databricks-feature-engineering 版本 0.17.0 或以上。 功能服務會自動安裝 MLflow 和 databricks-feature-lookup 套件。
例如,如果你的功能規格中的 UDF 匯入了 NumPy,請在規格中加入以下要求:
fe.create_feature_spec(
    name="main.default.customer_features_with_dependencies",
    features=features,
    extra_pip_requirements=["numpy==1.26.4"],
)
建立端點時,請使用main.default.customer_features_with_dependencies規格名稱。
每個 extra_pip_requirements 項目必須是 PyPI 需求字串,例如 numpy==1.26.4,或是 Unity 目錄卷中檔案 .whl 的路徑。 例如,對於你已上傳的輪子,請使用 /Volumes/main/libraries/wheels/custom_features-1.0.0-py3-none-any.whl。 端點建立者必須在該卷上具有 USE CATALOG,並在其父層 catalog 和 schema 上具有 USE SCHEMA 和 READ VOLUME。
對於來自私有儲存庫的套件,請設定 工作區預設套件儲存庫。 不要將 pip 指令選項(例如 --index-url)放入 extra_pip_requirements。
Unity 目錄 UDF ENVIRONMENT 條款中的相依關係適用於離線 SQL 執行。 功能服務不會自動複製這些內容。 在功能規格的 requirements 中宣告 UDF 所需的所有套件,包括上游功能中的 UDF。
若終端部署失敗,請檢查建置日誌是否有套件安裝錯誤、版本衝突或輪式存取失敗。 請參閱 監控模型品質和端點健康情況。
如需包含 CustomUDF 和 FeatureViewSource 的範例,請參閱 提供 Serve CustomUDF 功能及其相依性。 關於模型服務相依,請參見 自訂 UDF 相依。
建立端點
FeatureSpec 可定義端點。 欲了解更多資訊,請參閱 Create custom model serving endpoints、the Python API documentation,或 Databricks SDK 文件。
注意
對於延遲敏感或每秒需要高查詢的工作負載,模型服務會在自定義模型服務端點上提供路由優化,請參閱 服務端點的路由優化。
Databricks SDK - Python
from databricks.sdk import WorkspaceClient
from databricks.sdk.service.serving import EndpointCoreConfigInput, ServedEntityInput

workspace = WorkspaceClient()

# Create endpoint
workspace.serving_endpoints.create(
  name="my-serving-endpoint",
  config = EndpointCoreConfigInput(
    served_entities=[
    ServedEntityInput(
        entity_name="main.default.customer_features",
        scale_to_zero_enabled=True,
        workload_size="Small"
      )
    ]
  )
)
Python API
from databricks.feature_engineering.entities.feature_serving_endpoint import (
  ServedEntity,
  EndpointCoreConfig,
)

fe.create_feature_serving_endpoint(
  name="customer-features",
    config=EndpointCoreConfig(
    served_entities=ServedEntity(
      feature_spec_name="main.default.customer_features",
             workload_size="Small",
             scale_to_zero_enabled=True,
             instance_profile_arn=None,
    )
  )
)
REST API
curl -X POST -u token:$DATABRICKS_API_TOKEN ${WORKSPACE_URL}/api/2.0/serving-endpoints \
    -H 'Content-Type: application/json' \
    -d '"name": "customer-features",
   "config": {
       "served_entities": [
           {
               "entity_name": "main.default.customer_features",
               "workload_size": "Small",
               "scale_to_zero_enabled": true
           }
       ]
   }'
若要查看端點,請按一下 Databricks UI 左側邊欄中的 [服務]。 當狀態為 [就緒] 時,端點即已準備好回應查詢。 欲了解更多關於模範服務的資訊,請參閱 模範服務。
將增強型 DataFrame 儲存在推斷數據表中
針對從 2025 年 2 月開始建立的端點,您可以配置模型服務端點,以記錄包含查閱特徵值和函式傳回值的增強式 DataFrame。 DataFrame 會儲存至所提供模型的推斷數據表。
如需設定此配置的說明,請參閱 記錄功能查詢 DataFrame 以推斷資料表。
如需推論表的相關資訊,請參閱記錄服務端點的請求和回應(舊版)。
取得端點
你可以使用 Databricks SDK 或 Python API 取得端點的元資料和狀態。
Databricks SDK - Python
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

endpoint = workspace.serving_endpoints.get(name="customer-features")
# print(endpoint)
Python API
endpoint = fe.get_feature_serving_endpoint(name="customer-features")
# print(endpoint)
取得端點的架構
您可以使用 Databricks SDK 或 REST API 來取得端點的架構。 如需端點架構的詳細資訊,請參閱 取得服務端點架構的模型。
Databricks SDK - Python
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

# Create endpoint
endpoint = workspace.serving_endpoints.get_open_api(name="customer-features")
REST API
ACCESS_TOKEN=<token>
ENDPOINT_NAME=<endpoint name>

curl "https://example.databricks.com/api/2.0/serving-endpoints/$ENDPOINT_NAME/openapi" -H "Authorization: Bearer $ACCESS_TOKEN" -H "Content-Type: application/json"
查詢端點
您可以使用 REST API、MLflow 部署 SDK 或服務 UI 來查詢端點。
下列程式代碼示範如何使用 MLflow 部署 SDK 來設定認證並建立用戶端。
  # Set up credentials
  export DATABRICKS_HOST=...
  export DATABRICKS_TOKEN=...
  # Set up the client
  import mlflow.deployments

  client = mlflow.deployments.get_deploy_client("databricks")
注意
作為安全性最佳做法,當您使用自動化工具、系統、指令碼和應用程式進行驗證時,Databricks 建議您使用屬於服務主體的個人存取權杖,而不是工作區使用者。 若要建立服務主體的權杖,請參閱管理服務主體的權杖。
使用 API 查詢端點
本節包含使用 REST API 或 MLflow 部署 SDK 查詢端點的範例。
MLflow 部署套件開發工具包(SDK)
重要
下列範例使用 predict() API,來自 MLflow 部署 SDK。 此 API 是實驗性的,API 定義可能會變更。
import mlflow.deployments

client = mlflow.deployments.get_deploy_client("databricks")
response = client.predict(
    endpoint="test-feature-endpoint",
    inputs={
        "dataframe_records": [
            {"user_id": 1, "ytd_spend": 598},
            {"user_id": 2, "ytd_spend": 280},
        ]
    },
)
REST API
curl -X POST -u token:$DATABRICKS_API_TOKEN $ENDPOINT_INVOCATION_URL \
  -H 'Content-Type: application/json' \
  -d '{"dataframe_records": [
          {"user_id": 1, "ytd_spend": 598},
          {"user_id": 2, "ytd_spend": 280}
      ]}'
使用 UI 查詢端點
您可以直接從服務 UI 查詢服務端點。 這個 UI 包含可用於查詢端點的自動生成程式碼範例。
在Azure Databricks工作區的左側側邊欄,點選 Serving。
按一下您要查詢的端點。
在畫面右上角,按一下 [查詢端點]。
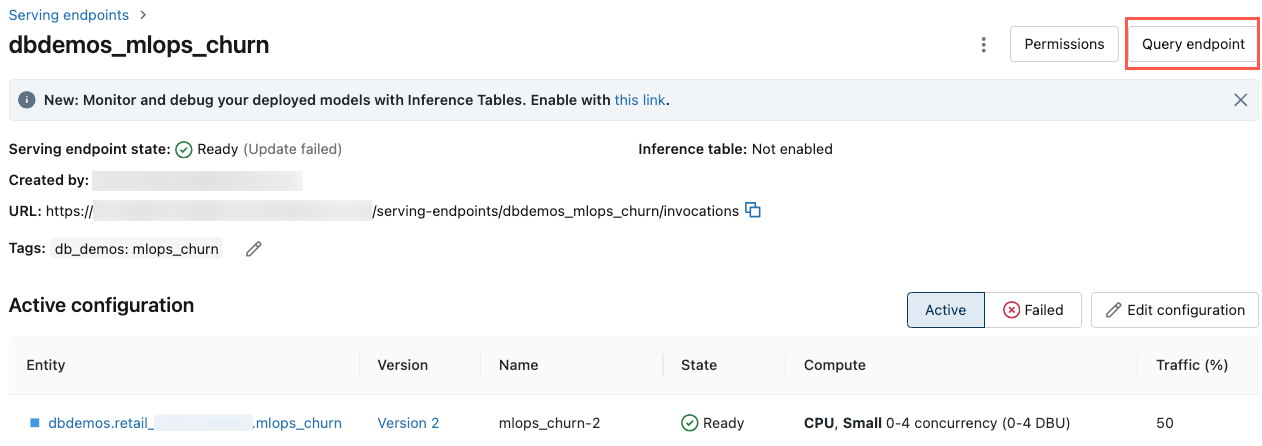
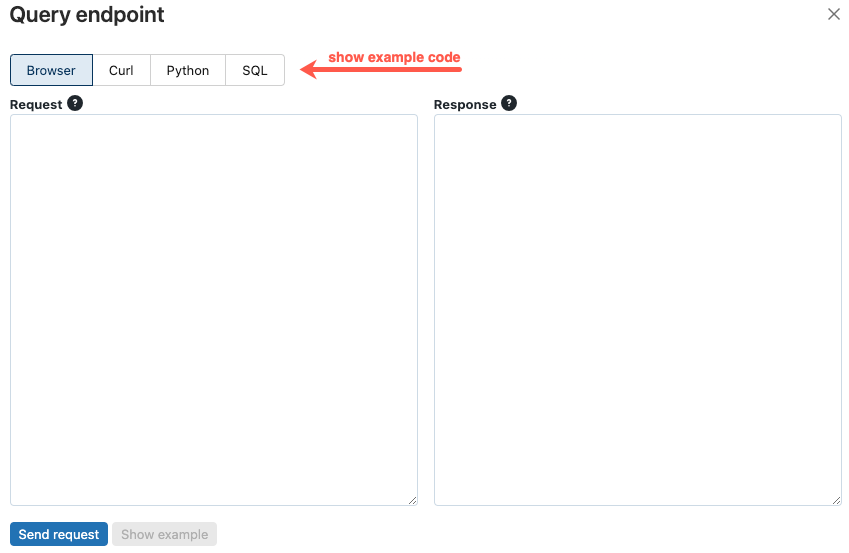
在 [要求] 方塊中,以 JSON 格式鍵入要求本文。
按一下傳送要求。
// Example of a request body.
{
  "dataframe_records": [
    { "user_id": 1, "ytd_spend": 598 },
    { "user_id": 2, "ytd_spend": 280 }
  ]
}
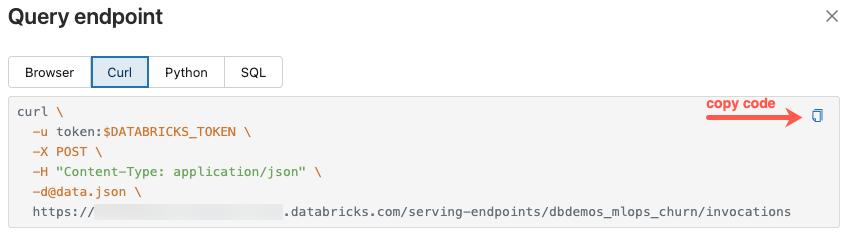
Query endpoint對話框包含以 curl、Python 和 SQL 生成的範例程式碼。 按一下索引標籤以檢視並複製範例程式碼。
若要複製程式碼,請按一下文字輸入框右上角的複製圖示。
更新端點
重要
若要修改功能服務端點的設定(例如更改 FeatureSpec 或工作負載大小),請務必使用本節所述的更新 API。 不要刪除並重新建立端點來套用變更。 刪除一個即時端點會立即造成停機,並中斷所有查詢該端點的應用程式。
您可以使用 REST API、Databricks SDK 或服務 UI 來更新端點。
使用 API 更新端點
Databricks SDK - Python
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

workspace.serving_endpoints.update_config(
  name="my-serving-endpoint",
  served_entities=[
    ServedEntityInput(
      entity_name="main.default.customer_features",
      scale_to_zero_enabled=True,
      workload_size="Small"
    )
  ]
)
REST API
curl -X PUT -u token:$DATABRICKS_API_TOKEN ${WORKSPACE_URL}/api/2.0/serving-endpoints/<endpoint_name>/config \
  -H 'Content-Type: application/json' \
  -d '"served_entities": [
        {
            "name": "customer-features",
            "entity_name": "main.default.customer_features_new",
            "workload_size": "Small",
            "scale_to_zero_enabled": True
        }
    ]'
使用UI更新端點
請遵循下列步驟使用服務 UI:
- 在Azure Databricks工作區的左側側邊欄,點選 Serving。
- 在資料表中,按下您要更新的端點名稱。 端點畫面隨即出現。
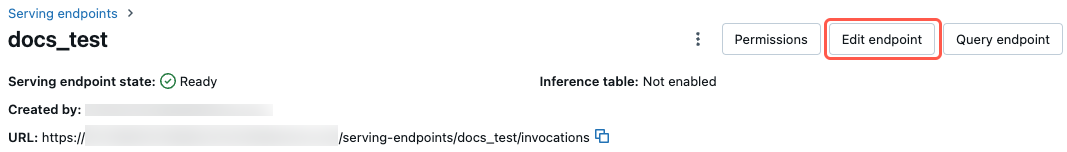
- 在畫面右上角,按一下 [編輯端點]。
- 在 [編輯服務端點] 對話方塊中,視需要編輯端點設定。
- 按一下 [更新],以儲存變更。
更新一個使用中的 Feature Serving 端點所使用的相依項
功能服務端點在首次建置與部署時會解析其相依性:即其服務主體需要的權限,以讀取線上表格(USE CATALOG、USE SCHEMA 和 SELECT),以及其 FeatureSpec 中所述之 Unity Catalog UDF 的 EXECUTE。 端點會在建置時固定這些權限,並不會在簡單的重新部署或重啟時重新解析。 如果你重新建立線上資料表或 UDF,端點會失去該物件的存取權限。 如果你在原地更新 UDF,端點仍會執行原始版本。 功能查詢可能會失敗,或靜默使用舊有的 UDF 邏輯,即使端點持續回報 Ready。
對於線上資料表和按需 UDF,Databricks 建議進行版本化遷移:建立新版本的相依,針對其建立新的端點,並將流量遷移到新端點。 這有助於避免停機時間及本節所述的故障模式。
重新建立線上表格
警告
不要在即時 Feature Serving 端點下原地刪除並重新建立線上資料表。
當你建立端點時,Model Serving 會在線上資料表的目錄上賦予該端點的服務主體USE SCHEMA、在線上資料表的結構描述上賦予SELECT,以及在線上資料表上賦予USE CATALOG。 刪除並重新建立資料表,即使名稱相同,也會在 Unity 目錄中建立新的可保護物件,因此 SELECT 授權不會被帶過去。 服務主體失去對資料表的存取權,OAuth 權杖簽發失敗,線上商店的連線也退回到密碼驗證並失敗。 功能查詢隨後會因出現如 KeyError: 'OAUTH_TOKEN' 或 password authentication failed 等錯誤而失敗。
這些失敗很容易被忽略:端點仍會回報 Ready ,同步管線仍顯示成功執行,但查詢卻失敗。 更改線上資料表的同步模式(例如在 SNAPSHOT 和 CONTINUOUS 之間)無法原地完成,必須重新建立資料表,這也可能觸發這個問題。
端點不會讀取特定的線上資料表。 它會透過其 FeatureSpec中所命名的離線特徵表查找特徵,當一個特徵表被發佈到多個線上資料表時,端點會使用最早的那個。 將相同的圖徵表發佈到第二個線上資料表,並不會將端點移到新的線上資料表。 請參閱 線上 Feature Store 限制。
為了減少停機時間,請同時為離線功能表和線上功能表建立版本:
- 建立一個新的離線功能資料表,並在名稱中包含版本(例如,
customer_features_v2)。 - 將新功能資料表發佈到新的線上資料表。 請參閱 發布功能表。
- 建立一個使用新特徵表的新節點,並建立一個新的 Feature Serving 端點,用於提供該節點。
- 將流量遷移到新的端點。 當舊端點不再接收流量後,刪除它及其線上資料表。
更新隨選 UDF
警告
不要直接修改由 FeatureSpec 使用的 Unity Catalog UDF。
A FeatureSpec的按需 UDF 在部署時建置到服務端點中。 純粹的刷新或重新部署會在該服務映像中重複使用相同的 UDF。 同名的 UDF 原地更新不會生效。 如果你丟棄並重新建立 UDF,端點上的 EXECUTE 也會遺失,所以使用 UDF 的查找作業會失敗。
FeatureSpecs 和 UDF 沒有版本欄位,所以依名稱建立版本:建立一個新的 UDF 和一個新的 FeatureSpec,建立一個使用新的 FeatureSpec 的新端點,並將流量遷移到該端點。 請參見 建立一個項目FeatureSpec。
請參閱 隨需功能計算。
在就地變更後復原端點
如果你已經直接在原處更改了依賴性,請重建端點,讓它重新解析依賴關係。 建立一個新的 FeatureSpec(或對於模型服務端點,註冊一個新的模型版本),並 更新該端點 以提供它。 變更端點提供的內容會重建端點,此作業會重新佈建新的服務主體並重新執行權限設定。 這些方法都無法可靠地重建端點:停止再啟動、單純重新部署,或更改環境變數。
刪除端點
警告
這項動作無法復原。 刪除功能服務端點會立即導致任何查詢該端點的應用程式停機。 如果你想更改端點的設定,請使用 「更新端點 」,而不是刪除並重新建立端點。
你可以使用 REST API、Databricks SDK、Python API 或 Serving UI 來刪除端點。
使用 API 刪除端點
Databricks SDK - Python
from databricks.sdk import WorkspaceClient
workspace = WorkspaceClient()

workspace.serving_endpoints.delete(name="customer-features")
Python API
fe.delete_feature_serving_endpoint(name="customer-features")
REST API
curl -X DELETE -u token:$DATABRICKS_API_TOKEN ${WORKSPACE_URL}/api/2.0/serving-endpoints/<endpoint_name>
使用 UI 刪除端點
請遵循下列步驟使用服務 UI 刪除端點:
- 在Azure Databricks工作區的左側側邊欄,點選 Serving。
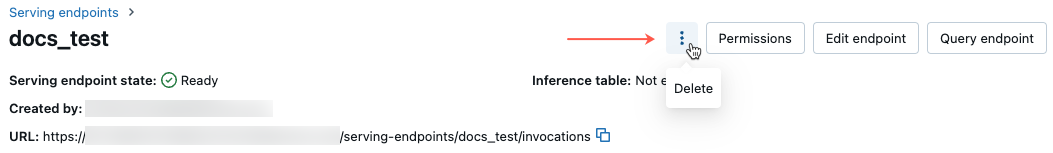
- 在資料表中,按下您要刪除的端點名稱。 端點畫面隨即出現。
- 在畫面右上角,點擊
 然後選取 刪除。
監視端點的健康情況
如需有關特徵服務端點可用的記錄和計量的資訊,請參閱監視模型品質和端點健康情況。
存取控制
如需功能服務端點權限的相關資訊,請參閱 管理模型服務端點的權限。
範例筆記本
本筆記本說明如何使用 Databricks SDK 來建立功能服務端點,使用 Databricks Online 功能商店。