Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Vytváření a údržba samostatných vyhledávacích tabulek pro data, která aplikace často používají v dotazech, když úložiště dat neposkytuje vhodné sekundární indexy. Tento přístup zlepšuje výkon čtení tím, že se vyhne úplnému prohledávání dat, pokud dotazy nepoužívají primární klíč nebo klíč oddílu.
Kontext a problém
Mnoho úložišť dat uspořádá data pro kolekci entit pomocí primárního klíče. Aplikace může tento klíč použít k vyhledání a načtení dat. Následující obrázek znázorňuje příklad úložiště dat, ve kterém jsou informace o zákazníci uspořádané podle primárního klíče, ID zákazníka.
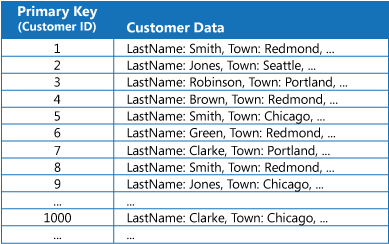
Na obrázku je tabulka se dvěma sloupci záznamů zákazníků. První sloupec Primární klíč (ID zákazníka) obsahuje ID zákazníka 1 až 9 následované třemi tečkami, ID 1000 a dalšími tečkami. Druhý sloupec Customer Data (Zákaznická data) obsahuje zákaznická data skládající se z příjmení a města následovaného třemi tečky. Mezi viditelné příklady patří ID 1, které mapuje na příjmení Smith a město Redmond a ID 2, které mapuje na příjmení Jones a město Seattle. Další řádek zobrazuje Smitha v Chicagu a další zobrazuje Smitha v Redmondu. Další řádek zobrazuje Jonese v Chicagu.
I když je primární klíč cenný pro dotazy, které načítají data na základě hodnoty tohoto klíče, aplikace, která potřebuje načíst data na základě některého jiného pole, nemůže pro tento dotaz použít primární klíč. V příkladu zákazníků nemůže aplikace použít primární klíč Customer ID k načtení zákazníků, pokud se dotazuje na data výhradně odkazem na hodnotu jiného atributu, například města, ve kterém zákazník sídlí. Pokud chcete provést dotaz, který odkazuje jenom na město, aplikace může muset načíst a prozkoumat každý záznam zákazníka, což může být pomalý proces.
Řada systémů pro správu relačních databází podporuje sekundární indexy. Sekundární index je samostatná datová struktura uspořádaná podle jednoho nebo více polí jiného než primárního (sekundárního) klíče. Sekundární index označuje, kde jsou uložena data pro každou indexovanou hodnotu. Položky v sekundárním indexu jsou obvykle seřazené podle hodnoty sekundárních klíčů, aby umožňovaly rychlé vyhledávání dat. Systém pro správu databází obvykle udržuje tyto indexy automaticky.
Relační databáze umožňují, aby více sekundárních indexů podporovalo různé vzory dotazů. Například v tabulce Zákazníci v relační databázi, kde je ID zákazníka primárním klíčem, je výhodné přidat sekundární index přes pole Město, pokud aplikace často vyhledává zákazníky podle města, kde se nacházejí.
I když jsou sekundární indexy v relačních systémech běžné, ne všechna úložiště dat poskytují ekvivalentní funkci. Některá úložiště dat nemají sekundární indexy, zatímco jiné poskytují indexy, které nesplňují požadavky na dotazy, dělení nebo výkon úlohy. V těchto případech si aplikace musí vybrat mezi úplnými kontrolami a ruční správou indexů.
Solution
Vytvořte tabulku indexu, která uspořádá data podle zadaného klíče. Následující část popisuje tři běžné strategie strukturování tabulky indexu. Následující dvě části popisují použití pro tabulky indexů v konkrétních scénářích.
Standardní strategie strukturování
Následující strategie se běžně používají ke strukturování tabulky indexu. Zvolte strategii na základě počtu sekundárních indexů, které váš scénář vyžaduje, a povahy dotazů, které vaše aplikace provádí.
Úplná denormalizace
Úplná denormalizace duplikuje data v každé indexové tabulce, ale organizuje je podle jiných klíčů než primárního klíče. Následující obrázek znázorňuje tabulky indexů, které uspořádají stejné informace o zákazníci podle města a příjmení.

Tato strategie funguje dobře pro úlohy náročné na čtení, ve kterých se data mění zřídka. S rostoucí rychlostí aktualizace se údržba každé kopie zvyšuje o režijní náklady na zpracování (viz složitost konzistence). U datových sad s velkým objemem může ukládání kopií vyžadovat také značné místo.
Normalizovaný index
Normalizovaná tabulka indexu uspořádá data podle klíčů jiných než primárního klíče. Normalizovaná indexová tabulka odkazuje na původní data pomocí primárního klíče místo duplikování těchto dat, jak je znázorněno na následujícím obrázku. Původní data se nazývají tabulka faktů.
Tip
Tabulka faktů znamená autoritativní zdrojovou tabulku odkazovanou indexem. Neznamená to, že jde o dimenzionální datový model.

Tato metoda šetří místo a snižuje nároky na údržbu duplicitních dat. Nevýhodou je, že aplikace musí provést dvě vyhledávací operace k vyhledání dat pomocí sekundárního klíče. Aplikace musí najít primární klíč pro data v tabulce indexu a pak pomocí primárního klíče vyhledat data v tabulce faktů.
Částečná denormalizace
Částečná denormalizace vytváří tabulky indexů, které duplikují často načtená pole a jsou uspořádány podle klíčů jiných než primárního klíče. Na tabulku faktů se odkazuje při přístupu k méně často přistupovaným polím. Následující obrázek ukazuje, jak se běžně používaná data v každé tabulce indexu duplikují.

Tato strategie vyrovnává první dva přístupy. Data pro běžné dotazy můžete rychle načíst pomocí jednoho vyhledávání, zatímco režijní náklady na prostor a údržbu nejsou tak významné jako duplikování celé datové sady.
Složené klávesy
Některé aplikace často dotazují data zadáním kombinace hodnot, například "Najít všechny zákazníky, kteří žijí v Redmondu a mají příjmení Smith". V této situaci vytvořte klíče indexu z více atributů, jako jsou atributy Město a Příjmení v tomto případě.
Použijte kódování, které zachovává hranice součástí, aby různé kombinace hodnot nemohly vytvořit stejný klíč. Pokud dotazy závisí na pořadí klíčů, ujistěte se také, že kódování zachovává požadované pořadí řazení v pravidlech kolace klíčů úložiště dat.
Následující obrázek znázorňuje tabulku indexu založenou na složených klíčích. Klíče jsou seřazené podle města a potom podle příjmení pro záznamy, které mají stejnou hodnotu pro město.
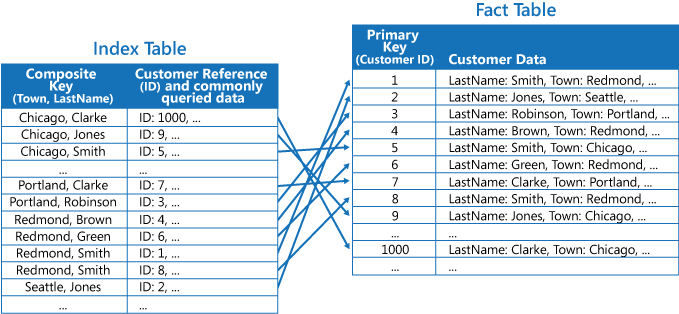
Diagram obsahuje tabulku indexu vlevo a tabulku faktů vpravo. Tabulka faktů uspořádá data zákazníků podle primárního klíče, ID zákazníka. Každý řádek Zákaznická data obsahuje příjmení zákazníka, město a tři tečky označující jiná data. Tabulka indexu je uspořádaná složeným klíčem, který kombinuje město a příjmení. Jeho druhý sloupec, Reference (ID) zákazníka a běžně dotazovaná data, obsahuje ID zákazníka a tři tečky. Šipky se rozšiřují z řádků tabulky indexů do tabulky faktů, přičemž každá šipka odkazuje na řádek ID zákazníka, na který odkazuje tato položka rejstříku. Křížové šipky znázorňují, že položky seřazené složeným klíčem můžou odkazovat na řádky zákazníků na různých pozicích v tabulce faktů.
Indexovací tabulky nad horizontálně dělenými daty
Tabulky indexů můžou urychlit operace dotazů nad horizontálně dělenými daty. Jsou obzvlášť užitečné, když je shardovací klíč hašovaný. Následující obrázek ukazuje příklad, kdy shardovací klíč je hashem ID zákazníka. Indexová tabulka uspořádává položky podle nehashovaných hodnot Town a LastName a u každé položky ukládá odpovídající hashovaný klíč shardu.
Toto uspořádání podporuje rozsahové a seřazené vyhledávání podle nehashovaných hodnot a zároveň poskytuje informace o směrování potřebné k načtení každého záznamu ze správného střepu. Například dotaz "Najít všechny zákazníky, kteří žijí v Redmondu", může najít odpovídající položky v souvislém bloku v tabulce indexu. Aplikace pak postupuje podle odkazů na data zákazníka pomocí shard klíčů uložených v indexové tabulce.

Problémy a důležité informace
Při rozhodování o implementaci tohoto modelu zvažte následující body:
Režijní náklady na údržbu Udržování sekundárních indexů může znamenat značné režijní náklady. Analyzujte a seznamte se s dotazy, které vaše aplikace používá. Tabulky indexů můžete vytvářet jenom v případech, kdy je budete pravděpodobně používat pravidelně. Nevytvávejte spekulativní indexové tabulky pro podporu dotazů, které aplikace neprovádí nebo provádí jen občas. S rostoucím počtem vzorů dotazů roste počet tabulek indexů a každý z nich přidává provozní plochu pro monitorování, údržbu a ladění. Zvažte výhodu dotazu každé tabulky indexu oproti provozním nákladům na údržbu jiné odvozené datové struktury. Pravidelně kontrolujte existující indexové tabulky, abyste určili a odstranili ty, na které již nejsou směrovány žádné dotazy.
Náklady na úložiště a propustnost Duplikování dat v tabulce indexu zvyšuje náklady na úložiště v poměru k počtu tabulek indexů a velikosti zkopírovaných polí. Údržba více kopií dat také zvyšuje úsilí. Každý zápis do indexové tabulky spotřebovává propustnou kapacitu, například ve formě transakcí započítávaných do limitů účtu úložiště ve službě Azure Table Storage nebo jako jednotky žádostí v Azure Cosmos DB. Náklady se netýkají jen úložiště, ale i propustnosti při zápisu.
Dvojitý trest vyhledávání. Implementace tabulky indexu jako normalizované struktury, která odkazuje na původní data, vyžaduje, aby aplikace k nalezení dat prováděla dvě operace vyhledávání. První operace prohledá tabulku indexu, aby načetla primární klíč, a druhá primární klíč využije k načtení dat.
Složitost konzistence Pokud systém obsahuje řadu indexových tabulek nad velkými datovými sadami, může být údržba konzistence mezi tabulkami indexů a původními daty obtížná. Pokud zdrojová data a položky indexu nelze aktualizovat ve stejné transakci, navrhujte aplikaci kolem modelu konečné konzistence. Před potvrzením zápisu zachyťte všechny změny zdroje trvale. Například zpracovávejte proud změn databáze, pomocí vzoru Transactional Outbox zapište záznam do outboxu ve stejné transakci jako zdrojovou změnu nebo zařaďte příkaz do fronty před změnou zdrojových dat. V přístupu založeném na příkazech použijte pracovní proces ke zpracování příkazu a aktualizaci zdrojových dat a jeho indexů. Neaktualizovat zdrojová data a pak nezávisle publikovat zprávu o aktualizaci indexu, protože selhání mezi těmito operacemi může ponechat index zastaralý.
Navrhni asynchronní příjemce tak, aby byl idempotentní, protože doručování zpráv a opakování může způsobit, že stejná aktualizace se spustí vícekrát. Aktualizace téhož zdrojového záznamu mohou také dorazit v nesprávném pořadí. Do každé aktualizace indexu zahrňte zdrojovou verzi nebo pořadové číslo a použijte aktualizaci jenom v případě, že je novější než verze indexu. Při mazání zachovejte verzovaný tombstone nebo ekvivalentní high-water mark, aby opožděná starší aktualizace nemohla znovu vytvořit smazanou položku indexu. Během intervalu mezi zápisem zdrojových dat a asynchronní aktualizací indexu můžou dotazy na tabulku indexu vrátit zastaralé odkazy na záznamy, které byly ve zdrojových datech aktualizovány nebo odstraněny, a mohou vynechat nedávno přidané záznamy.
Dělení tabulek indexu Tabulky indexů můžou být dělené nebo horizontálně dělené, což zvyšuje složitost směrování dotazů a vyžaduje strategii dělení podle vzorů dotazů, které má index sloužit.
Kdy použít tento vzor
Tento vzor použijte, když aplikace často potřebuje načíst data pomocí jiného klíče než primárního (nebo horizontálního) klíče a úložiště dat nativně nepodporuje sekundární indexy nebo jeho nativní indexy nevyhovují požadavkům na dotaz, dělení nebo výkon úlohy.
Tento vzor nemusí být vhodný v těchto případech:
Data jsou nestálá. Data se mění tak často, že rychlost zápisu překračuje rychlost, s jakou je možné tabulky indexů asynchronně aktualizovat. Okno zastarávání se zvětšuje, dokud index není trvale zastaralý, takže přestane být účinný a režijní náklady na úložiště a propustnost spojené s údržbou indexové tabulky převýší jakékoli úspory při dotazování.
Máte nediskriminující klíče. Pole vybrané jako sekundární klíč pro tabulku indexu není nerozlišující a může mít pouze malou sadu hodnot (například logické pole, které zaznamenává, zda je položka aktivní). Tabulka indexu nese plné náklady na úložiště a propustnost, ale poskytuje minimální selektivitu dotazů.
Datové hodnoty mají nerovnoměrnou distribuci. Vyvážení hodnot dat pro pole vybrané jako sekundární klíč pro tabulku indexu je velmi nerovnoměrné. Pokud například 90 procent záznamů obsahuje stejnou hodnotu v poli, může vytvoření a údržba indexové tabulky pro vyhledávání dat na základě tohoto pole vyžadovat větší režii než postupné prohledávání dat. Pokud ale dotazy často cílí na hodnoty, které leží ve zbývajících 10 procentech, může být tento index stále užitečný.
Návrh úloh
Architekt by měl vyhodnotit způsob použití vzoru indexové tabulky v návrhu úloh k řešení cílů a principů popsaných v pilířích Azure Well-Architected Frameworku. Následující tabulka obsahuje pokyny, jak tento model podporuje cíle jednotlivých pilířů.
| Pilíř | Jak tento model podporuje cíle pilíře |
|---|---|
| Spolehlivost pomáhá vaší úloze splňovat cíle odolnosti a obnovení tím, že vytváří redundanci a zachovává funkce během selhání. | Asynchronní údržba indexu může zabránit tomu, aby dočasná selhání při aktualizaci indexu blokovala zápisy zdrojových dat. Idempotentní zpracování, zpracování nedoručených dopisů, monitorování a odsouhlasení pomáhají obnovit konzistenci indexů po selháních. - RE:07 Sebezáchování - RE:10 Monitoring |
| efektivita výkonu pomáhá vašim úlohám efektivně splňovat požadavky prostřednictvím optimalizací škálování, dat a kódu. | Tabulky indexů umožňují rychlé vyhledávání v polích bez primárního klíče, aniž by bylo nutné prohledávat úplná data. U horizontálně dělených úložišť dat můžou tabulky indexů uspořádat položky podle hodnot, které nejsou hashované, aby podporovaly dotazy na rozsah a řazení, které samotný klíč horizontálního oddílu nemůže efektivně obsluhovat. - PE:05 Škálování a dělení - Datový výkon PE:08 |
Stejně jako u jakéhokoli rozhodnutí o návrhu, pokud tento model zavádí kompromisy v rámci pilíře, zvažte je proti cílům ostatních pilířů.
Example
Zvažte aplikaci, která ukládá informace o filmech. Předpokládejme, že katalog je velký a s převahou čtecích operací, každý film má jeden primární žánr, dotazy na herce jsou časté, údaje o obsazení se mění zřídka a krátké zpoždění indexace je přijatelné. Table Storage ukládá každou entitu jako strukturovanou sadu pojmenovaných vlastností. Každá entita obsahuje PartitionKey, RowKey a časové razítko a entity ve stejné tabulce mohou mít různé sady vlastností.
Table Storage používá složený primární klíč, který se skládá z PartitionKey a RowKey. Hodnota PartitionKey určuje oddíl, ve kterém je entita uložena. V rámci oddílu hodnota RowKey jednoznačně identifikuje entitu. Služba Table Storage je optimalizovaná pro dotazy, které určují oba klíče nebo načítají souvislou oblast hodnot klíčů řádků v rámci jednoho oddílu.
Tip
Table Storage podporuje transakční aktualizace entit ve stejné tabulce a oddílu prostřednictvím transakcí skupiny entit. Transakce nemůže zahrnovat tabulku faktů a samostatnou indexovou tabulku. Chcete-li aktualizovat entitu faktů a indexovat entity atomicky, uložte je do stejné tabulky se stejným PartitionKey. Transakce skupin entit jsou omezené na 100 entit na dávku s maximální datovou částí 4 MiB.
V tomto příkladu vytvořte tabulku Azure s oddíly pro každý žánr pomocí zakódovaného identifikátoru žánru jako klíče oddílu a stabilního jedinečného identifikátoru videa jako klíče řádku. Uložte názvy žánrů a filmů jako vlastnosti. Následující obrázek používá čitelné názvy místo identifikátorů, aby byl příklad přehlednější.

Tento přístup je méně účinný, pokud se aplikace potřebuje na filmy dotazovat také podle herců v hlavních rolích. V takovém případě vytvořte samostatnou tabulku Azure, která funguje jako indexová tabulka. Použijte kódovaný stabilní identifikátor aktéra jako klíč oddílu a identifikátor filmu jako klíč řádku. Uložte názvy herců a filmů jako vlastnosti. Na následujícím obrázku se místo identifikátorů používají čitelné názvy. Pokud ve filmu hraje více než jeden herec, tentýž film se vyskytuje ve více particích.
Následující obrázek ukazuje tabulku indexu aktora.

Návod k návrhu
Tabulka filmů používá žánr jako klíč partition, což znamená, že dotazy filtrující podle žánru se provádějí efektivně jako skenování partition nad souvislými rozsahy klíčů řádků. Table Storage však podporuje pouze jeden clusterovaný index nad PartitionKey a RowKey. Nemá žádné sekundární indexy. Dotaz, například „najít všechny filmy, ve kterých hraje konkrétní herec“, vyžaduje úplné prohledání tabulky ve všech oddílech podle žánru, což je při velkém měřítku nákladné.
Indexová tabulka objektu actor toto omezení řeší vrácením vzoru přístupu. Každý identifikátor objektu actor se stane klíčem oddílu a každý identifikátor videa se stane klíčem řádku, takže dotazy založené na objektech actor se přeloží jako efektivní vyhledávání oddílů. Vzhledem k tomu, že každý oddíl obsahuje jenom filmy jednoho herce, dotaz vrátí souvislou oblast entit bez prohledávání nesouvisejících dat.
Protože záznamy o filmech a hercích používají samostatné tabulky a klíče oddílů, nemohou tyto záznamy sdílet transakci v rámci skupiny entit. Udržujte index actorů prostřednictvím odolného asynchronního mechanismu pro zachytávání změn a navrhněte aplikaci tak, aby tolerovala krátkodobou neaktuálnost dotazů.
Tabulka indexu používá částečnou denormalizaci: každá položka duplikuje běžně používaná pole (například názvy ostatních herců), aby nejčastější dotazy mohly být zodpovězeny pouze z tabulky indexu jediným vyhledáváním. U méně často používaných polí obsahuje položka klíč oddílu pro žánr z původní tabulky filmů, což umožňuje provést cílený bodový dotaz do oddílu žánru a načíst celý záznam. Tento návrh vyrovnává rychlost dotazů oproti nákladům na úložiště a režijním nákladům na údržbu.
Další kroky
Pokyny k návrhu dotazů pro Table Storage popisují vzory sekundárních indexů, které využívají
PartitionKeyaRowKey, včetně postupů pro ukládání položek indexu ve stejném oddílu nebo v samostatných oddílech.Strategie dělení dat vysvětlují, jak vybrat klíče oddílů a řádků na základě vzorů dotazů, distribuce dat, požadavků na transakce a cílů škálovatelnosti.
Strategie architektury pro optimalizaci výkonu dat poskytují pokyny pro vyhodnocení vzorů dotazů, indexů, oddílů a požadavků na monitorování.
Úrovně konzistence v Azure Cosmos DB popisují modely konzistence, které jsou relevantní při údržbě tabulek indexů v Azure Cosmos DB.
Související zdroje informací
Při implementaci tohoto modelu můžou být relevantní také následující vzory:
Vzorec fragmentace. Vzor indexové tabulky se často používá ve spojení s daty rozdělenými do shardů. Model horizontálního dělení popisuje, jak rozdělit úložiště dat do sady horizontálních oddílů.
Vzor materializovaného zobrazení. Místo indexování dat pro podporu dotazů, které sumarizují data, může být vhodnější vytvořit materializované zobrazení dat. Tento návrhový vzor popisuje, jak vytvářet předem naplněná zobrazení nad daty pro podporu efektivních souhrnných dotazů.
Transakční vzorec odeslané pošty. Použijte vzor Transactional Outbox, který vám pomůže spolehlivě publikovat změny pro asynchronní údržbu indexu, když zdrojová data a položky indexu nelze aktualizovat v rámci jedné transakce.