Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
Azure Table Storage je služba, která ukládá strukturovaná data NoSQL v cloudu. Poskytuje úložiště bez schématu, kde každá entita je přístupná prostřednictvím klíče a obsahuje sadu atributů. Jedna tabulka může obsahovat entity, které mají různé sady vlastností, a vlastnosti se můžou skládat z různých datových typů.
Při používání Azure je spolehlivost sdílenou odpovědností. Microsoft nabízí celou řadu možností, které podporují odolnost a obnovení. Zodpovídáte za pochopení toho, jak tyto možnosti fungují ve všech službách, které používáte, a výběrem možností, které potřebujete ke splnění vašich obchodních cílů a cílů dostupnosti.
Tento článek popisuje, jak zajistit odolnost služby Table Storage vůči nejrůznějším potenciálním výpadkům a problémům, včetně přechodných chyb, výpadků zón dostupnosti a výpadků oblastí. Popisuje také, jak můžete použít zálohy k zotavení z jiných typů problémů a zvýrazní některé klíčové informace o smlouvě SLA (Table Storage Service Level Agreement).
Poznámka:
Table Storage je součástí platformy Azure Storage. Některé z funkcí Table Storage jsou společné v mnoha službách Azure Storage. V tomto článku používáme Azure Storage nebo Storage k odkazování na tyto běžné funkce.
Doporučení pro produkční nasazení pro spolehlivost
V produkčních prostředích proveďte následující akce:
Povolte zónově redundantní úložiště (ZRS) pro účty úložiště, které obsahují prostředky Table Storage. ZRS poskytuje vyšší dostupnost tím, že replikuje data synchronně napříč několika zónami dostupnosti v primární oblasti. Tato replikace chrání před selháními zóny dostupnosti.
Pokud potřebujete odolnost vůči výpadkům oblastí a primární oblast vašeho účtu úložiště je spárovaná, zvažte povolení geograficky redundantního úložiště (GRS), aby se data asynchronně replikovala do spárované oblasti. V podporovaných oblastech můžete kombinovat geografickou redundanci s redundancí zón pomocí geograficky zónově redundantního úložiště (GZRS).
Pro produkční úlohy ve velkém měřítku nebo pokud máte vysoké požadavky na odolnost zvažte použití Azure Cosmos DB for Table. Azure Cosmos DB for Table je kompatibilní s aplikacemi, které jsou napsané pro Table Storage. Podporuje operace čtení a zápisu s nízkou latencí ve velkém měřítku a poskytuje silnou globální distribuci napříč několika oblastmi s flexibilními modely konzistence. Poskytuje také integrované funkce zálohování a další funkce, které zlepšují odolnost a výkon vaší aplikace.
Přehled architektury spolehlivosti
Table Storage funguje jako distribuovaná databáze NoSQL v infrastruktuře platformy Azure Storage. Služba poskytuje redundanci prostřednictvím více kopií dat tabulky a konkrétní model redundance závisí na konfiguraci vašeho účtu úložiště.
Místně redundantní úložiště (LRS) replikuje data v účtech úložiště do jedné nebo více zón dostupnosti Azure umístěných v primární oblasti podle vašeho výběru. I když není možné zvolit upřednostňovanou zónu dostupnosti, Azure může přesunout nebo rozšířit účty LRS napříč zónami, aby se zlepšilo vyrovnávání zatížení. Není zaručeno, že se vaše data šíří napříč zónami. Další informace o availability zones najdete v tématu Co jsou Zóny dostupnosti?

Zónově redundantní úložiště (ZRS), geograficky redundantní úložiště (GRS) a geograficky zónově redundantní úložiště (GZRS) poskytují dodatečnou ochranu. Tento článek podrobně popisuje tyto možnosti.
Odolnost proti přechodným chybám
Přechodné chyby jsou krátká, přerušovaná selhání ve složkách. V distribuovaném prostředí, jako je cloud, se vyskytují často a jsou normální součástí provozu. Přechodné chyby se opravují po krátké době. Je důležité, aby vaše aplikace mohly zpracovávat přechodné chyby, obvykle opakováním ovlivněných požadavků.
Všechny aplikace hostované v cloudu by měly při komunikaci se všemi cloudovými rozhraními API, databázemi a dalšími komponentami postupovat podle pokynů pro zpracování přechodných chyb Azure. Další informace najdete v tématu Doporučení pro zpracování přechodných chyb.
Klientské knihovny a sady SDK služby Table Storage zahrnují integrované zásady opakovaných pokusů, které automaticky řeší běžná přechodná selhání, jako jsou vypršení časového limitu sítě, dočasná nedostupnost služby (HTTP 503), odpovědi signalizující omezení požadavků (HTTP 429) a stavy přetížení serveru oddílu. Když vaše aplikace narazí na tyto přechodné stavy, klientské knihovny automaticky opakují operace pomocí strategií exponenciálního prodlužování intervalů mezi pokusy.
Pokud chcete efektivně spravovat přechodné chyby při použití služby Table Storage, proveďte následující akce:
Nakonfigurujte v klientovi Služby Table Storage odpovídající časové limity, abyste vyrovnali rychlost odezvy s odolností vůči dočasným zpomalením. Výchozí časové limity v klientských knihovnách Azure Storage jsou obvykle vhodné pro většinu scénářů.
Implementujte exponenciální prodlevu pro zásady opakování pokusů, zejména když vaše aplikace narazí na chyby HTTP 503 – server je zaneprázdněn nebo HTTP 500 – vypršel časový limit operace. Table Storage může omezovat požadavky, když jsou jednotlivé oddíly nadměrně zatížené nebo když se účet úložiště blíží svým limitům.
Návrh logiky opakování pracující s oddíly ve vysoce škálovatelných aplikacích Logika opakovaných pokusů zohledňující oddíly je pokročilejší přístup, který bere v úvahu architekturu využívající oddíly ve službě Table Storage a rozkládá operace mezi více oddílů, aby se snížila pravděpodobnost omezení propustnosti u serverů jednotlivých oddílů.
Další informace o architektuře Table Storage a o tom, jak navrhovat odolné a vysoce škálované aplikace, najdete v kontrolním seznamu výkonu a škálovatelnosti pro Table Storage.
Odolnost proti chybám zóny dostupnosti
Zóny dostupnosti jsou fyzicky oddělené skupiny datacenter v rámci oblasti Azure. Když jedna zóna selže, mohou služby přejít na jednu ze zbývajících zón.
Služba Table Storage je zónově redundantní, když ji nasadíte s konfigurací ZRS. Na rozdíl od místně redundantního úložiště (LRS) zaručuje ZRS synchronní replikaci dat tabulky napříč několika zónami dostupnosti. Tato konfigurace zajišťuje, aby vaše tabulky zůstaly přístupné i v případě, že nebude dostupná celá zóna dostupnosti. Všechny operace zápisu musí být potvrzeny napříč několika zónami, než služba dokončí zápis, což poskytuje záruky silné konzistence.
Redundance zón je povolená na úrovni účtu úložiště a vztahuje se na všechny prostředky služby Table Storage v rámci daného účtu. Vzhledem k tomu, že nastavení platí pro celý účet úložiště, nemůžete nakonfigurovat jednotlivé entity pro různé úrovně redundance. Když dojde k výpadku zóny dostupnosti, Azure Storage automaticky směruje požadavky do zón, které jsou v pořádku, aniž by vyžadovala zásah od vás nebo vaší aplikace.
Následující diagram znázorňuje ukázkovou architekturu ZRS, která používá tři zóny dostupnosti. ZRS může používat tři nebo více zón dostupnosti.

Požadavky
Podpora oblastí: Zónově redundantní účty Azure Storage můžete nasadit v libovolné oblasti, která podporuje zóny dostupnosti.
Typy účtů úložiště: Pokud chcete povolit ZRS pro Table Storage, musíte použít účet úložiště úrovně Standard pro obecné účely verze 2. Účty služby Premium Storage nepodporují Table Storage.
Náklady
Když povolíte zónově redundantní úložiště (ZRS), platíte jinak než místně redundantní úložiště (LRS) kvůli dodatečné replikaci a režijním nákladům na úložiště.
Podrobné informace o cenách najdete v tématu Ceny služby Table Storage.
Konfigurujte podporu zón dostupnosti
Vytvořte zónově redundantní účet úložiště a tabulku:
Vytvoření účtu úložiště Jako možnost redundance nezapomeňte vybrat geograficky redundantní úložiště SRS, GZRS nebo geograficky redundantní úložiště jen pro čtení (RA-GZRS).
Změnit typ replikace. Informace o tom, jak změnit existující účet úložiště na zónově redundantní úložiště (ZRS) a informace o možnostech konfigurace a požadavcích, najdete v tématu Změna způsobu replikace účtu úložiště.
Zakažte zónovou redundanci. Převeďte účty ZRS zpět na nezonální konfiguraci, jako je místně redundantní úložiště (LRS), pomocí stejného procesu změny konfigurace redundance.
Chování, když jsou všechny zóny v pořádku
Tato část popisuje, co očekávat, když je účet Table Storage nakonfigurovaný pro redundanci zón a všechny zóny dostupnosti jsou funkční.
Směrování provozu mezi zónami: Azure Storage s zónově redundantním úložištěm (ZRS) automaticky distribuuje požadavky mezi clustery úložiště ve více zónách dostupnosti. Distribuce provozu je pro aplikace transparentní a nevyžaduje žádnou konfiguraci na straně klienta.
Replikace dat mezi zónami: ZRS synchronně replikuje operace zápisu napříč třemi nebo více zónami dostupnosti v rámci oblasti. Operace zápisu není dokončena, dokud Azure Storage nezapíše data do všech požadovaných replik v těchto zónách. Tato synchronní replikace zajišťuje silnou konzistenci a nulovou ztrátu dat během selhání zóny.
Chování při selhání zóny
Když se zóna dostupnosti stane nedostupnou, služba Table Storage automaticky zpracuje proces převzetí služeb při selhání tím, že reaguje následujícím chováním:
- Detekce a odpověď: Microsoft automaticky rozpozná selhání zóny a zahájí procesy obnovení. Pro účty zónově redundantního úložiště (ZRS) se nevyžaduje žádná akce zákazníka. Pokud se zóna stane nedostupnou, Azure provádí síťové aktualizace, jako je přesměrování DNS.
- Oznámení: Microsoft vás automaticky neoznámí, když je zóna mimo provoz. Pomocí Azure Resource Health ale můžete monitorovat stav jednotlivých prostředků a můžete nastavit Resource Health výstrahy, které vás upozorní na problémy. Pomocí služby Azure Service Health můžete také porozumět celkovému stavu služby, včetně jakýchkoli selhání zón, a můžete nastavit upozornění služby Service Health , která vás upozorní na problémy.
Aktivní požadavky: Během procesu obnovení může dojít k vyřazení požadavků během letu a mělo by se to opakovat. Aplikace by měly implementovat logiku opakování pro zpracování těchto dočasných přerušení.
Očekávaná ztráta dat: Během selhání zóny nedojde ke ztrátě dat, protože data se před dokončením operací zápisu synchronně replikují napříč několika zónami.
Očekávaný výpadek: Během automatického obnovení může dojít ke krátkému výpadku, obvykle na několik sekund, když je provoz přesměrován do zdravých zón. Při návrhu aplikací pro ZRS dodržujte postupy pro zpracování přechodných chyb, včetně implementace zásad opakování s exponenciálním zpětným vypnutím.
Přesměrování provozu: Pokud se zóna stane nedostupnou, Azure provádí aktualizace sítí, jako je opětovné bodování DNS (Domain Name System), aby se požadavky směrovala na zbývající zóny dostupnosti, které jsou v pořádku. Služba udržuje plnou funkčnost pomocí zón, které jsou v pořádku, a nevyžaduje zásah zákazníka.
Obnovení zóny
Jakmile se postižená zóna dostupnosti zotaví, Azure Storage automaticky obnoví běžný provoz a znovu naváže replikaci mezi třemi nebo více zónami dostupnosti. Služba automaticky zajišťuje konzistenci dat tím, že synchronizuje všechny operace, ke kterým došlo během období výpadku.
Testování poruch zón
Když používáte zónově redundantní úložiště (ZRS), Azure Storage automaticky spravuje replikaci, směrování provozu a reakce na výpadek zóny. Vzhledem k tomu, že je tato funkce plně spravována, nemusíte zahajovat ani ověřovat procesy selhání zóny dostupnosti.
Odolnost proti selháním v celé oblasti
Azure Storage, včetně Azure Blob Storage, Azure Files, Azure Table Storage a Azure Queue Storage, poskytuje celou řadu možností geografické redundance a převzetí služeb při selhání, které vyhovují různým požadavkům.
Důležité
Geograficky redundantní úložiště (GRS) funguje jenom v rámci spárovaných oblastí Azure. Pokud oblast vašeho účtu úložiště není spárovaná, zvažte použití vlastních řešení pro více oblastí pro odolnost.
Geograficky redundantní úložiště pro spárované oblasti
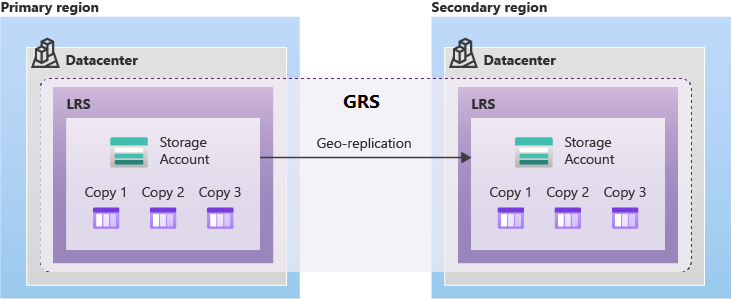
Azure Storage poskytuje několik typů GRS ve spárovaných oblastech. Bez ohledu na typ GRS, který používáte, služba vždy replikuje data v sekundární oblasti pomocí místně redundantního úložiště (LRS). Tento přístup poskytuje ochranu před selháním hardwaru v sekundární oblasti.
GRS poskytuje podporu pro plánované a neplánované převzetí služeb při selhání do spárované oblasti Azure v případě výpadku v primární oblasti. GRS asynchronně replikuje data z primární oblasti do spárované oblasti.
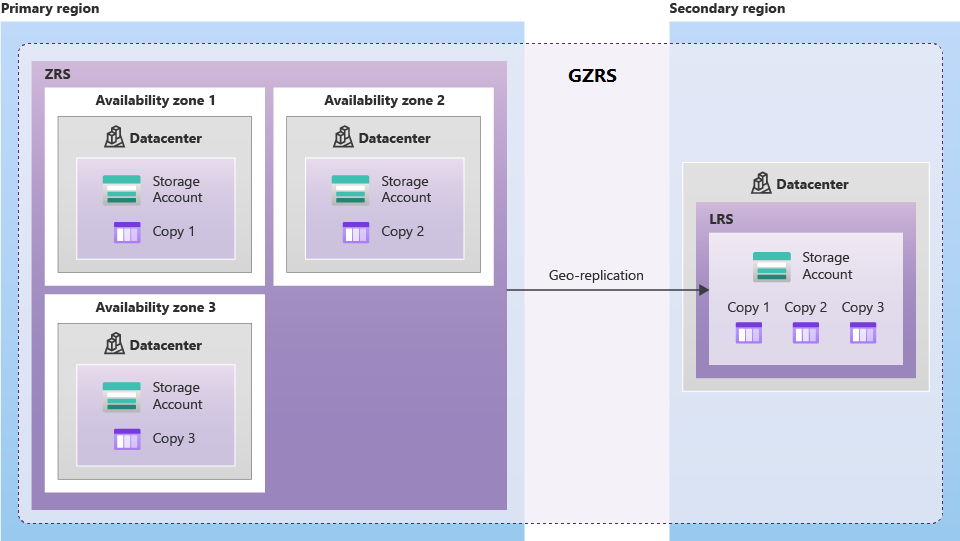
Geograficky zónově redundantní úložiště (GZRS) replikuje data v několika zónách dostupnosti v primární oblasti a do spárované oblasti.
Následující diagram znázorňuje ukázkovou architekturu GZRS, která používá tři zóny dostupnosti v primární oblasti. GZRS může používat tři nebo více zón dostupnosti v primární oblasti.
Geograficky redundantní úložiště s přístupem pro čtení (RA-GRS) a geograficky zónově redundantní úložiště jen pro čtení (RA-GZRS) rozšiřuje geograficky redundantní úložiště (GRS) a geograficky zónově redundantní úložiště (GZRS) s přidanou výhodou přístupu pro čtení k sekundárnímu koncovému bodu. Tyto možnosti jsou ideální pro aplikace navržené pro obchodní aplikace s vysokou dostupností, které jsou kritické pro podnikání. V nepravděpodobném případě, že primární koncový bod dojde k výpadku, můžou aplikace nakonfigurované pro přístup pro čtení do sekundární oblasti dál fungovat.


Typy převzetí při selhání
Azure Storage podporuje pro různé scénáře tři typy přepnutí při selhání.
Neplánované převzetí služeb po havárii řízené zákazníkem: Pokud v primární oblasti dojde k rozsáhlému selhání úložiště v rámci celé oblasti, jste odpovědní za zahájení obnovení.
Plánované převzetí služeb při selhání spravované zákazníkem: Zodpovídáte za inicializování obnovení, pokud v primární oblasti došlo k selhání jiné části vašeho řešení a potřebujete přepnout celé řešení na sekundární oblast. Pokud úložiště zůstává funkční v primární oblasti, použijte plánované převzetí služeb, pokud potřebujete převést své řešení do sekundární oblasti, například kvůli cvičením pro zotavení po havárii navrženým tak, aby bylo zajištěno dodržování předpisů a auditních požadavků.
Převzetí služeb při selhání spravované Microsoftem: Za výjimečných okolností může Microsoft zahájit převzetí služeb při selhání pro všechny účty geograficky redundantního úložiště (GRS) v oblasti. Převzetí služeb při selhání spravované Microsoftem je ale poslední možností a očekává se, že se provede pouze po delší době výpadku. Neměli byste spoléhat na převzetí při selhání spravované společností Microsoft.
Účty GRS mohou používat kterýkoli z těchto typů převzetí služeb při selhání. Není třeba předem nakonfigurovat účet úložiště pro použití jakéhokoli typu převzetí služeb při selhání.
Požadavky
Podpora oblastí: Geograficky redundantní konfigurace Azure Storage používají spárované oblasti Azure pro replikaci sekundární oblasti. Sekundární oblast se automaticky určí na základě výběru primární oblasti a nedá se přizpůsobit. Úplný seznam spárovaných oblastí Azure najdete v seznamu oblastí Azure.
Pokud oblast vašeho účtu úložiště není spárovaná, zvažte použití vlastních řešení pro více oblastí pro odolnost.
Typy účtů úložiště: Geo-redundantní úložiště (GRS) a převzetí a obnovení iniciované zákazníkem jsou k dispozici ve všech spárovaných oblastech Azure, které podporují účty Azure Storage verze pro obecné účely v2.
Úvahy
Při implementaci služby Table Storage ve více oblastech zvažte následující důležité faktory:
Latence asynchronní replikace: Replikace dat do sekundární oblasti je asynchronní, což znamená, že mezi zápisem dat do primární oblasti a dostupností dat v sekundární oblasti dochází k prodlevě. Tato prodleva může způsobit potenciální ztrátu dat, pokud dojde k selhání primární oblasti před replikací nedávných dat. Ztrátu dat měří cíl bodu obnovení (RPO). Můžete očekávat, že prodleva replikace bude kratší než 15 minut, ale tentokrát je odhad a není zaručen.
Můžete zkontrolovat vlastnost Čas poslední synchronizace a zjistit, kolik dat by se mohlo ztratit, pokud by u vašeho účtu úložiště došlo k neplánovanému převzetí služeb při selhání.
Přístup k sekundární oblasti: V konfiguracích geograficky redundantního úložiště (GRS) a geograficky zónově redundantního úložiště (GZRS) není sekundární oblast k dispozici pro čtení, dokud nedojde k převzetí služeb při selhání.
Konfigurace geograficky redundantního úložiště s přístupem pro čtení (RA-GRS) a geograficky zónově redundantního úložiště s přístupem pro čtení (RA-GZRS) zajišťují přístup ke čtení sekundární oblasti během normálních operací, ale kvůli latenci asynchronní replikace můžou vracet mírně zastaralá data.
Omezení funkcí: Některé funkce služby Azure Storage nejsou podporované nebo mají omezení, pokud používáte geograficky redundantní úložiště (GRS) nebo převzetí služeb při selhání spravované zákazníkem. Před implementací geografické redundance zkontrolujte kompatibilitu funkcí .
Náklady
Konfigurace účtů Azure Storage pro více oblastí jsou spojeny s dodatečnými náklady na replikaci mezi oblastmi a úložiště v sekundární oblasti. Přenos dat mezi oblastmi Azure se účtuje na základě standardních sazeb šířky pásma mezi oblastmi.
Podrobné informace o cenách najdete v tématu Ceny služby Table Storage.
Nakonfigurujte podporu pro více oblastí
Vytvořte nový účet geograficky redundantního úložiště (GRS). Pokud chcete vytvořit účet GRS, přečtěte si téma Vytvoření účtu úložiště a výběr geograficky redundantního úložiště jen pro čtení (RA-GRS), geograficky zónově redundantního úložiště (GZRS) nebo geograficky zónově redundantního úložiště jen pro čtení (RA-GZRS) během vytváření účtu.
Povolte geografickou redundanci u existujícího účtu úložiště. Pokud chcete převést existující účet úložiště na geograficky redundantní úložiště (GRS), přečtěte si téma Změna způsobu replikace účtu úložiště.
Výstraha
Po změně konfigurace vašeho účtu pro geografickou redundanci může trvat značné množství času, než se stávající data v nové primární oblasti plně zkopírují do nové sekundární oblasti.
Abyste předešli velké ztrátě dat, před zahájením neplánovaného převzetí služeb při selhání zkontrolujte hodnotu vlastnosti Čas poslední synchronizace. Pokud chcete vyhodnotit potenciální ztrátu dat, porovnejte čas poslední synchronizace s časem posledního zápisu dat do nové primární oblasti.
Zakažte geografickou redundanci. Pomocí stejného procesu změny konfigurace redundance převeďte účty GRS zpět na konfigurace s jednou oblastí, jako je místně redundantní úložiště (LRS) nebo zónově redundantní úložiště (ZRS).
Chování, když jsou všechny oblasti v pořádku
Tato část popisuje, co očekávat, když je účet úložiště nakonfigurovaný pro geografickou redundanci a všechny oblasti jsou funkční.
Směrování provozu mezi oblastmi: Azure Storage používá přístup typu aktivní-pasivní, kdy se všechny operace zápisu a většina operací čtení směrují do primární oblasti.
Pro geograficky redundantní úložiště s přístupem pro čtení (RA-GRS) a konfigurace geograficky zónově redundantního úložiště s přístupem pro čtení (RA-GZRS) můžou aplikace volitelně číst ze sekundární oblasti tak, že přistupují k sekundárnímu koncovému bodu. Tento přístup vyžaduje explicitní konfiguraci aplikace a není automatický. Kvůli prodlevě asynchronní replikace mohou být data v sekundární oblasti mírně zastaralá.
Replikace dat mezi oblastmi: Operace zápisu se nejprve potvrdí do primární oblasti pomocí následujících nakonfigurovaných typů redundance:
- Místně redundantní úložiště (LRS) pro geograficky redundantní úložiště (GRS) a RA-GRS
- Zónově redundantní úložiště (ZRS) pro geograficky zónově redundantní úložiště (GZRS) a RA-GZRS
Po úspěšném dokončení v primární oblasti se data asynchronně replikují do sekundární oblasti, kde jsou uložená pomocí LRS.
Asynchronní povaha replikace mezi oblastmi znamená, že mezi zápisem dat do primární oblasti a dostupností v sekundární oblasti je obvykle prodleva. Čas replikace můžete monitorovat pomocí vlastnosti Čas poslední synchronizace.
Chování při selhání oblasti
Tato část popisuje, co očekávat, když je účet úložiště nakonfigurovaný pro geografickou redundanci a v primární oblasti došlo k výpadku.
Převzetí služeb při selhání spravované zákazníkem (neplánované): Neplánované převzetí služeb při selhání použijte, když úložiště v primárním regionu není k dispozici.
Detekce a reakce: V nepravděpodobném případě, že váš účet úložiště není v primární oblasti dostupný, můžete zvážit zahájení zákaznicky řízeného neplánovaného převzetí služeb při selhání. Při rozhodování zvažte následující faktory:
Jestli azure Resource Health zobrazuje problémy s přístupem k účtu úložiště ve vaší primární oblasti
Zda vám Microsoft doporučuje provést přepnutí při selhání do jiné oblasti
Výstraha
Neplánované převzetí služeb při selhání může vést ke ztrátě dat. Než zahájíte převzetí služeb při selhání spravované zákazníkem, zvažte, zda obnovení služby ospravedlňuje riziko ztráty dat.
Oznámení: Microsoft vás při výpadku oblasti automaticky neoznámí. Pomocí Azure Resource Health ale můžete monitorovat stav jednotlivých prostředků a můžete nastavit Resource Health výstrahy, které vás upozorní na problémy. Můžete také použít Azure Service Health k pochopení celkového stavu služby, včetně všech selhání oblastí, a můžete nastavit upozornění služby Service Health, která vás upozorní na problémy.
Aktivní požadavky: Během procesu převzetí služeb při selhání jsou koncové body primárního i sekundárního účtu úložiště dočasně nedostupné pro čtení i zápis. Jakékoli aktivní požadavky mohou být zrušeny a klientské aplikace musí opakovat pokus po dokončení převzetí služeb při selhání.
Očekávaná ztráta dat: Ke ztrátě dat běžně dochází při neplánovaném převzetí služeb po selhání kvůli zpoždění asynchronní replikace, což znamená, že nedávno zapsaná data nemusejí být replikována. Můžete zkontrolovat vlastnost Čas poslední synchronizace a zjistit, kolik dat může být ztraceno během neplánovaného převzetí služeb při selhání. Očekávaná ztráta dat se často označuje jako cíl bodu obnovení (RPO). Obvykle můžete očekávat, že RPO bude méně než 15 minut, ale tento čas není zaručen.
Očekávaný výpadek: Očekávané výpadky se často označují jako plánovaná doba obnovení (RTO). Zotavení po selhání spravovaného zákazníkem se obvykle dokončí během 60 minut, v závislosti na velikosti a složitosti účtu.
Přesměrování provozu: Jakmile se převzetí služeb při selhání dokončí, Azure automaticky aktualizuje koncové body účtu úložiště, aby aplikace nemusely být znovu nakonfigurované. Pokud vaše aplikace uchovává záznamy DNS (Domain Name System) v mezipaměti, může být nutné vymazat mezipaměť, aby aplikace odesílala provoz do nové primární oblasti.
Konfigurace po převzetí služeb při selhání: Po dokončení neplánovaného převzetí služeb při selhání používá váš účet úložiště v cílové oblasti vrstvu místně redundantního úložiště (LRS). Pokud ho potřebujete geograficky replikovat znovu, musíte znovu povolit geograficky redundantní úložiště (GRS) a počkat na replikaci dat do nové sekundární oblasti.
Další informace o tom, jak iniciovat převzetí služeb při selhání spravované zákazníkem, najdete v tématu Fungování převzetí služeb při selhání spravovaného zákazníkem (neplánované) a zahájení převzetí služeb při selhání účtu úložiště.
Převzetí služeb při selhání spravované zákazníkem (plánované): Plánované převzetí služeb při selhání použijte tehdy, když úložiště v primární oblasti zůstává funkční, ale z jiného důvodu potřebujete převést celé řešení do sekundární oblasti. Například u jiné služby Azure může docházet k problému a potřebujete přejít na použití sekundární oblasti pro celé řešení. Nebo můžete použít plánované převzetí služeb při selhání k provedení cvičení obnovy po havárii (DR) pro účely dodržování předpisů a auditu.
Detekce a odpověď: Zodpovídáte za rozhodnutí o převzetí provozu. Toto rozhodnutí obvykle provedete v případě, že potřebujete provést přepnutí mezi regiony, i když je váš účet úložiště v pořádku. Můžete například aktivovat převzetí služeb při selhání, pokud dojde k závažnému výpadku jiné součásti aplikace, ze které se v primární oblasti nemůžete zotavit.
Oznámení: Microsoft vás při výpadku oblasti automaticky neoznámí. Pomocí Azure Resource Health ale můžete monitorovat stav jednotlivých prostředků a můžete nastavit Resource Health výstrahy, které vás upozorní na problémy. Můžete také použít Azure Service Health k pochopení celkového stavu služby, včetně všech selhání oblastí, a můžete nastavit upozornění služby Service Health, která vás upozorní na problémy.
Aktivní požadavky: Během procesu převzetí služeb při selhání jsou koncové body primárního i sekundárního účtu úložiště dočasně nedostupné pro čtení i zápis. Jakékoli aktivní požadavky mohou být zrušeny a klientské aplikace musí opakovat pokus po dokončení převzetí služeb při selhání.
Očekávaná ztráta dat: Neočekává se žádná ztráta dat, protože proces převzetí služeb při selhání proběhne až po synchronizaci všech dat, což vede k RPO rovný nule.
Očekávaný výpadek: Převzetí služeb při selhání se obvykle dokončí do 60 minut, což znamená, že očekávaná doba obnovy (RTO) je přibližně 60 minut, v závislosti na velikosti účtu a složitosti. Během procesu přepnutí jsou koncové body primárního i sekundárního účtu úložiště dočasně nedostupné pro čtení i zápis.
Přesměrování provozu: Jakmile se převzetí služeb při selhání dokončí, Azure automaticky aktualizuje koncové body účtu úložiště, aby aplikace nemusely být znovu nakonfigurované. Pokud vaše aplikace uchovává záznamy DNS v mezipaměti, může být nutné vymazat mezipaměť, aby se zajistilo, že aplikace odesílá provoz do nové primární oblasti.
Konfigurace po převzetí služeb: Po dokončení plánovaného převzetí služeb se váš účet úložiště v cílovém regionu bude dál geograficky replikovat a zůstane na úrovni GRS.
Další informace o tom, jak iniciovat převzetí služeb při selhání spravované zákazníkem, najdete v tématu Fungování převzetí služeb při selhání spravovaného zákazníkem (plánované) a zahájení převzetí služeb při selhání účtu úložiště.
Převzetí služeb při selhání řízené Microsoftem: V ojedinělých případech závažné havárie, kdy Microsoft zjistí, že primární oblast je nenávratně poškozená, může být zahájeno automatické převzetí služeb sekundární oblasti při selhání. Microsoft zpracovává celý proces a nevyžaduje žádnou akci zákazníka. Doba, která uplyne před převzetím služeb při selhání, závisí na závažnosti havárie a času potřebném k vyhodnocení situace.
- Oznámení: Microsoft vás při výpadku oblasti automaticky neoznámí. Pomocí Azure Resource Health ale můžete monitorovat stav jednotlivých prostředků a můžete nastavit Resource Health výstrahy, které vás upozorní na problémy. Můžete také použít Azure Service Health k pochopení celkového stavu služby, včetně všech selhání oblastí, a můžete nastavit upozornění služby Service Health, která vás upozorní na problémy.
Důležité
Využijte možnosti převzetí služeb při poruše spravované zákazníkem k vývoji, testování a implementaci vašich plánů zotavení po havárii. Nespoléhejte na převzetí služeb při selhání zajišťované společností Microsoft, které může být použito pouze v krajních případech. Převzetí služeb při selhání spravované Microsoftem je pravděpodobně zahájeno pro celou oblast. Nelze jej zahájit pro jednotlivé účty úložiště, předplatná nebo zákazníky. Převzetí služeb při selhání může probíhat v různých časech pro různé služby Azure. Doporučujeme, abyste používali převzetí služeb při selhání spravované zákazníkem.
Obnovení oblasti
Proces navrácení služeb po obnovení se výrazně liší ve scénářích převzetí služeb při selhání spravovaných Microsoftem a spravovanými zákazníky.
Převzetí služeb při selhání spravované zákazníkem (neplánované): Po neplánovaném převzetí služeb při selhání je účet úložiště nakonfigurován tak, aby používal místně redundantní úložiště (LRS). Chcete-li provést návrat, musíte znovu navázat vztah geograficky redundantního úložiště (GRS) a počkat, než se data replikují.
Převzetí služeb při selhání spravované zákazníkem (plánované): Po plánovaném převzetí služeb při selhání zůstane účet úložiště geograficky replikovaný. Můžete zahájit další zákazníkem spravované převzetí služeb při selhání a vrátit se do původního primárního regionu. Platí stejné úvahy o převzetí služeb při selhání.
Převzetí služeb při selhání spravované společností Microsoft: Pokud Microsoft zahájí převzetí služeb při selhání, pravděpodobně v primární oblasti došlo k závažné havárii a primární oblast nemusí být možné obnovit. Jakékoli časové harmonogramy nebo plány obnovy závisí na rozsahu regionální katastrofy a úsilí o obnovu. Monitorujte komunikaci služby Azure Service Health pro podrobnosti.
Testování selhání regionů
Můžete simulovat regionální selhání a otestovat postupy zotavení po havárii.
Testování plánovaného převzetí služeb při selhání: U účtů geograficky redundantního úložiště (GRS) můžete během oken údržby provádět plánované operace převzetí služeb při selhání a testovat celý proces převzetí služeb při selhání i zpětného převzetí služeb po obnovení. Plánovaný failover nevyžaduje ztrátu dat, ale znamená odstávku během failoveru i failbacku.
Testování sekundárního koncového bodu: V případě geograficky redundantního úložiště s přístupem pro čtení (RA-GRS) a konfigurací geograficky zónově redundantního úložiště s přístupem pro čtení (RA-GZRS) pravidelně testujte operace čtení na sekundárním koncovém bodu, abyste zajistili, že vaše aplikace dokáže úspěšně číst data ze sekundární oblasti.
Vlastní řešení pro více regionů pro zajištění odolnosti
Možnosti převzetí služeb při selhání mezi oblastmi služby Azure Storage nemusí být vhodné z následujících důvodů:
Váš účet úložiště je v nepárovaném regionu.
Vaše obchodní cíle dostupnosti nejsou splněny dobou obnovy ani ztrátou dat, které nabízejí integrované možnosti při selhání systému.
Musíte převzít služby při selhání do oblasti, která není párem primární oblasti.
Potřebujete aktivní/aktivní konfiguraci napříč oblastmi.
Tato část obsahuje základní přehled některých přístupů, které je potřeba zvážit. Komplexní přehled topologií nasazení ve více oblastech pro Azure Storage je mimo rozsah tohoto článku.
Poznámka:
U aplikací vytvořených tak, aby používaly Table Storage, zvažte použití služby Azure Cosmos DB for Table. Azure Cosmos DB pro tabulku podporuje pokročilé požadavky na více oblastí, včetně podpory pro nepairované oblasti. Je také navržený pro kompatibilitu s aplikacemi vytvořenými pro Table Storage.
Azure Storage můžete nasadit napříč několika oblastmi pomocí samostatných účtů úložiště v každé oblasti. Tento přístup poskytuje flexibilitu při výběru oblastí, možnost používat neprůplné oblasti a podrobnější kontrolu nad načasováním replikace a konzistencí dat. Při implementaci více účtů úložiště napříč oblastmi je potřeba nakonfigurovat replikaci dat mezi oblastmi, implementovat vyrovnávání zatížení a zásady převzetí služeb při selhání a zajistit konzistenci dat napříč oblastmi.
V případě Table Storage přístup využívající více účtů vyžaduje, abyste spravovali distribuci dat, zajišťovali synchronizaci mezi tabulkami v různých oblastech včetně řešení konfliktů a implementovali vlastní logiku převzetí služeb při selhání.
Zálohování a obnovení
Redundance úložiště pomáhá chránit před selháními infrastruktury, ale neposkytuje historický bod obnovení po náhodném odstranění nebo poškození. Table Storage neposkytuje tradiční možnosti zálohování, jako je obnovení k určitému bodu v čase (PITR). Můžete ale implementovat vlastní strategie zálohování pro data tabulky.
Pokud potřebujete integrované možnosti zálohování, zvažte přechod do služby Azure Cosmos DB for Table, která poskytuje podporu pro pravidelné i průběžné zálohování. Další informace najdete v tématu Online zálohování a obnovení dat na vyžádání ve službě Azure Cosmos DB.
V případě scénářů, které vyžadují zálohování dat z Table Storage, zvažte následující přístupy:
Exportujte pomocí Azure Data Factory. Pomocí konektoru Azure Data Factory pro Table Storage můžete exportovat entity do jiného umístění. Každou entitu můžete například zálohovat do souboru JSON, který je uložený ve službě Azure Blob Storage.
Proveďte zálohování na úrovni aplikace. Implementovat vlastní logiku zálohování v aplikacích pro export důležitých entit tabulek do jiných služeb úložiště, jako je Azure SQL Database nebo Azure Cosmos DB, pro robustnější možnosti zálohování a obnovení.
Při návrhu strategií zálohování pro Table Storage zvažte dělenou povahu dat a ujistěte se, že procesy zálohování dokážou efektivně zpracovávat velké tabulky zpracováním více oddílů paralelně.
Další informace o tom, jak redundance a zálohování řeší různá rizika, najdete v tématu Redundance, replikace a zálohování.
Smlouva o úrovni služeb
Smlouva o úrovni služeb (SLA) pro Azure Storage popisuje očekávanou dostupnost služby a podmínky, které musí být splněny, aby bylo možné očekávat dostupnost. Smlouva SLA dostupnosti, pro kterou máte nárok, závisí na úrovni úložiště a na typu replikace, který používáte. Další informace najdete v tématu Smlouvy SLA pro online služby.