Poznámka:
Přístup k této stránce vyžaduje autorizaci. Můžete se zkusit přihlásit nebo změnit adresáře.
Přístup k této stránce vyžaduje autorizaci. Můžete zkusit změnit adresáře.
V tomto kurzu vytvoříte lakehouse, načtete ukázková data do tabulky Delta, použijete datové transformace tam, kde je to potřeba, a poté vytvoříte analytické sestavy.
Návod
Tento kurz je součástí série. Po dokončení tohoto kurzu pokračujte v načítání dat do lakehousu k vytvoření kompletního podnikového lakehousu pomocí kanálů Data Factory, poznámkových bloků Sparku a pokročilých technik reportování.
Tady je kontrolní seznam kroků, které jste dokončili v tomto kurzu:
Pokud nemáte Fabric, zaregistrujte se na bezplatnou zkušební verzi.
Požadavky
- Než vytvoříte lakehouse, musíte vytvořit pracovní prostor Fabric.
- Než budete ingestovat soubor CSV, musíte mít nakonfigurovaný OneDrive. Pokud nemáte nakonfigurovaný OneDrive, zaregistrujte si bezplatnou zkušební verzi Microsoftu 365: bezplatnou zkušební verzi – Vyzkoušejte Microsoft 365 za měsíc. Pokyny k nastavení najdete v tématu Nastavení OneDrivu.
Proč pro tento kurz potřebuji OneDrive?
Pro účely tohoto kurzu potřebujete OneDrive, protože proces příjmu dat využívá OneDrive jako základní mechanismus úložiště pro nahrávání souborů. Když nahrajete soubor CSV do systému Fabric, je dočasně uložen ve vašem účtu OneDrive, než se importuje do datového jezera. Tato integrace zajišťuje zabezpečený a bezproblémový přenos souborů v ekosystému Microsoft 365.
Krok načítání dat nefunguje, pokud nemáte nakonfigurovaný OneDrive, protože Fabric nemá přístup k nahranému souboru. Pokud už máte data dostupná v jezeře nebo jiném podporovaném umístění, OneDrive se nevyžaduje.
Poznámka:
Pokud už máte data v jezeře, můžete tato data použít místo ukázkového souboru CSV. Chcete-li zkontrolovat, zda jsou data již spojena s vaším jezerním domem, použijte Lakehouse Explorer nebo SQL analytics endpoint pro prohlížení tabulek, souborů a složek. Další informace o tom, jak zkontrolovat, najdete v tématu Přehled Lakehouse a Případy použití koncového bodu Analýzy Lakehouse SQL.
Vytvořte lakehouse
V této části vytvoříte lakehouse v Fabric.
V Fabricvyberte z navigačního panelu Pracovní prostory.
Pokud chcete otevřít pracovní prostor, zadejte jeho název do vyhledávacího pole umístěného nahoře a vyberte ho z výsledků hledání.
V pracovním prostoru vyberte Nová položka, do vyhledávacího pole zadejte Lakehouse a pak vyberte Lakehouse.
V dialogovém okně New lakehouse zadejte do pole Názevwwilakehouse.

Vyberte Vytvořit, abyste vytvořili a otevřeli nový lakehouse.

Ingestace ukázkových dat
V této části vkládáte ukázková zákaznická data do datového jezera.
Poznámka:
Pokud nemáte nakonfigurovaný OneDrive, zaregistrujte si bezplatnou zkušební verzi Microsoftu 365: bezplatnou zkušební verzi – Vyzkoušejte Microsoft 365 za měsíc.
Stáhněte si soubor dimension_customer.csv z úložiště ukázkových dat Fabric.
Vyberte Lakehouse a přejděte na kartu Domů.
Vyberte Získat data>New Dataflow Gen2 a vytvořte nový tok dat. Tento tok dat použijete k ingestování ukázkových dat do jezera. Případně můžete v části Načíst data v jezeře vybrat dlaždici Nový tok dat Gen2 .

V podokně Nový tok dat Gen2 zadejte data dimenze zákazníka do pole Název a vyberte Vytvořit.

Na kartě Domů datového toku vyberte dlaždici Importovat ze souboru Text/CSV.
Na obrazovce Připojení ke zdroji dat vyberte volbu Nahrát soubor.
Procházejte nebo přetáhněte soubor dimension_customer.csv, který jste stáhli v kroku 1. Po nahrání souboru vyberte Další.

Na stránce Náhled dat souboru můžete zobrazit náhled dat. Pak pokračujte výběrem možnosti Vytvořit a vraťte se zpět na plátno toku dat.


Transformace a načtení dat do Lakehouse
V této části transformujete data na základě vašich obchodních požadavků a načtete je do jezera.
V podokně Nastavení dotazu se ujistěte, že je pole Název nastavené na dimension_customer. Tento název se používá jako název tabulky v jezeře, takže musí být malými písmeny a nesmí obsahovat mezery.

Vzhledem k tomu, že jste vytvořili tok dat z jezera, cíl dat se automaticky nastaví na váš jezerní dům. Můžete to ověřit tak, že v podokně nastavení dotazu zkontrolujete cíl dat .
Návod
Pokud vytvoříte tok dat z pracovního prostoru místo z jezera, musíte ručně přidat cíl dat. Další informace najdete v tématu Výchozí cíl toku Dat Gen2 a cíle dat a spravovaná nastavení.
Na plátně toku dat můžete data snadno transformovat na základě vašich obchodních požadavků. Pro zjednodušení neprobínáme žádné změny v tomto kurzu. Pokračujte tak, že na panelu nástrojů vyberete Uložit a Spustit .

Počkejte, až se tok dat dokončí. Během procesu se zobrazí indikátor rotačního stavu.
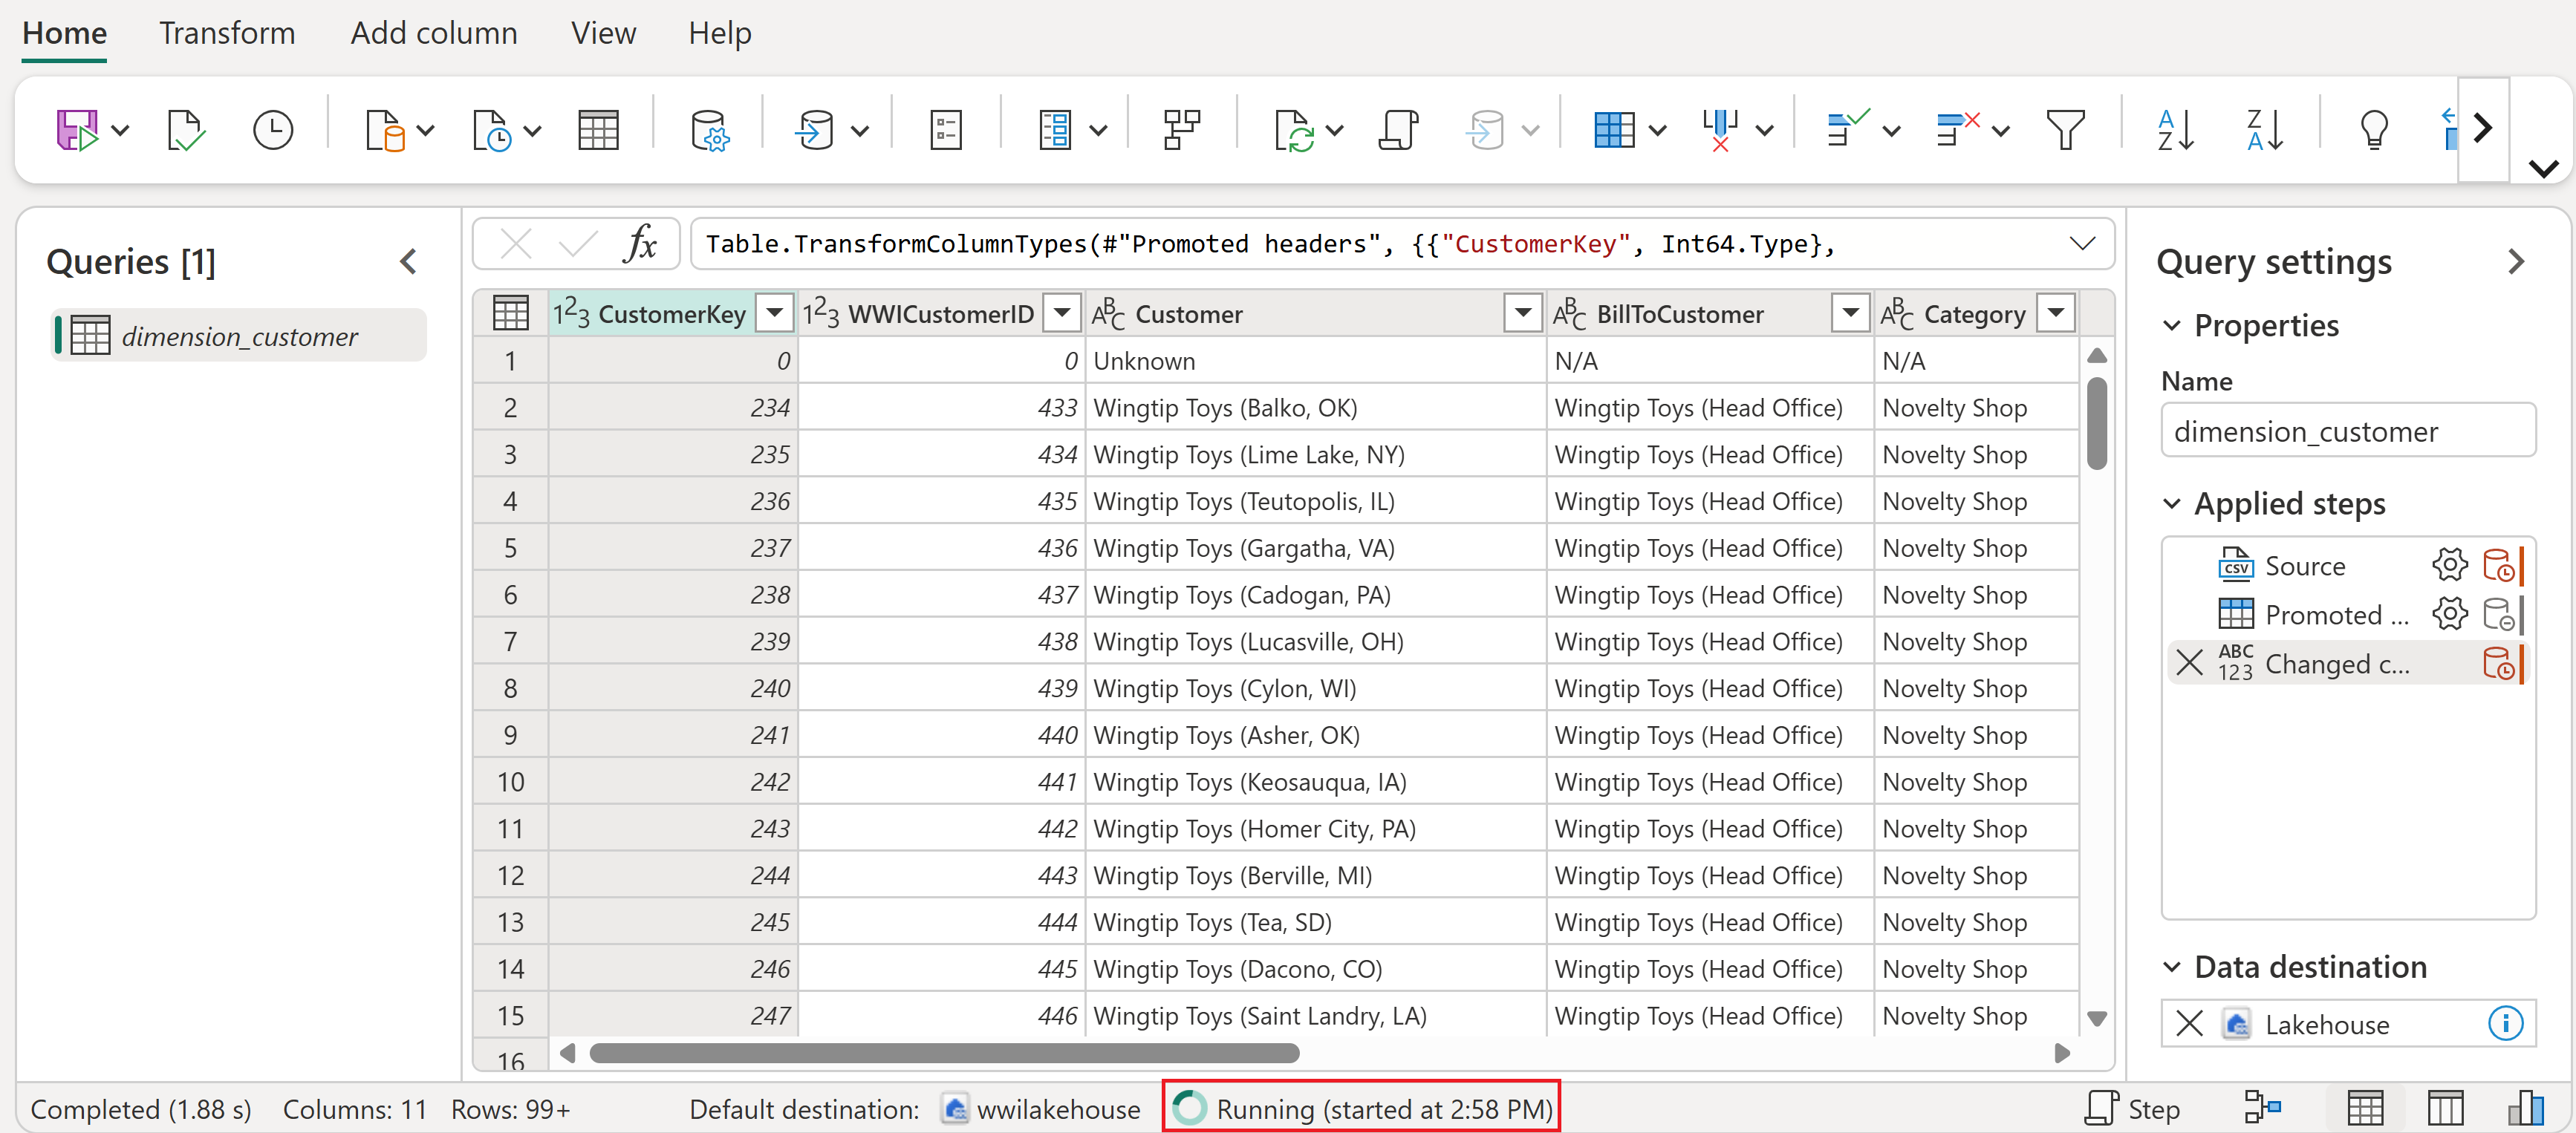
Po úspěšném dokončení spuštění toku dat vyberte v horním řádku nabídek své jezero a otevřete ho.
V průzkumníku Lakehouse najděte schéma dbo pod tabulkami, vyberte vedle něj menu ... (elipsa) a pak zvolte Obnovit. Tím se spustí tok dat a načte se data ze zdrojového souboru do tabulky lakehouse.

Po dokončení aktualizace rozbalte schéma dbo a zobrazte tabulku dimension_customer Delta. Výběrem tabulky zobrazíte náhled dat.
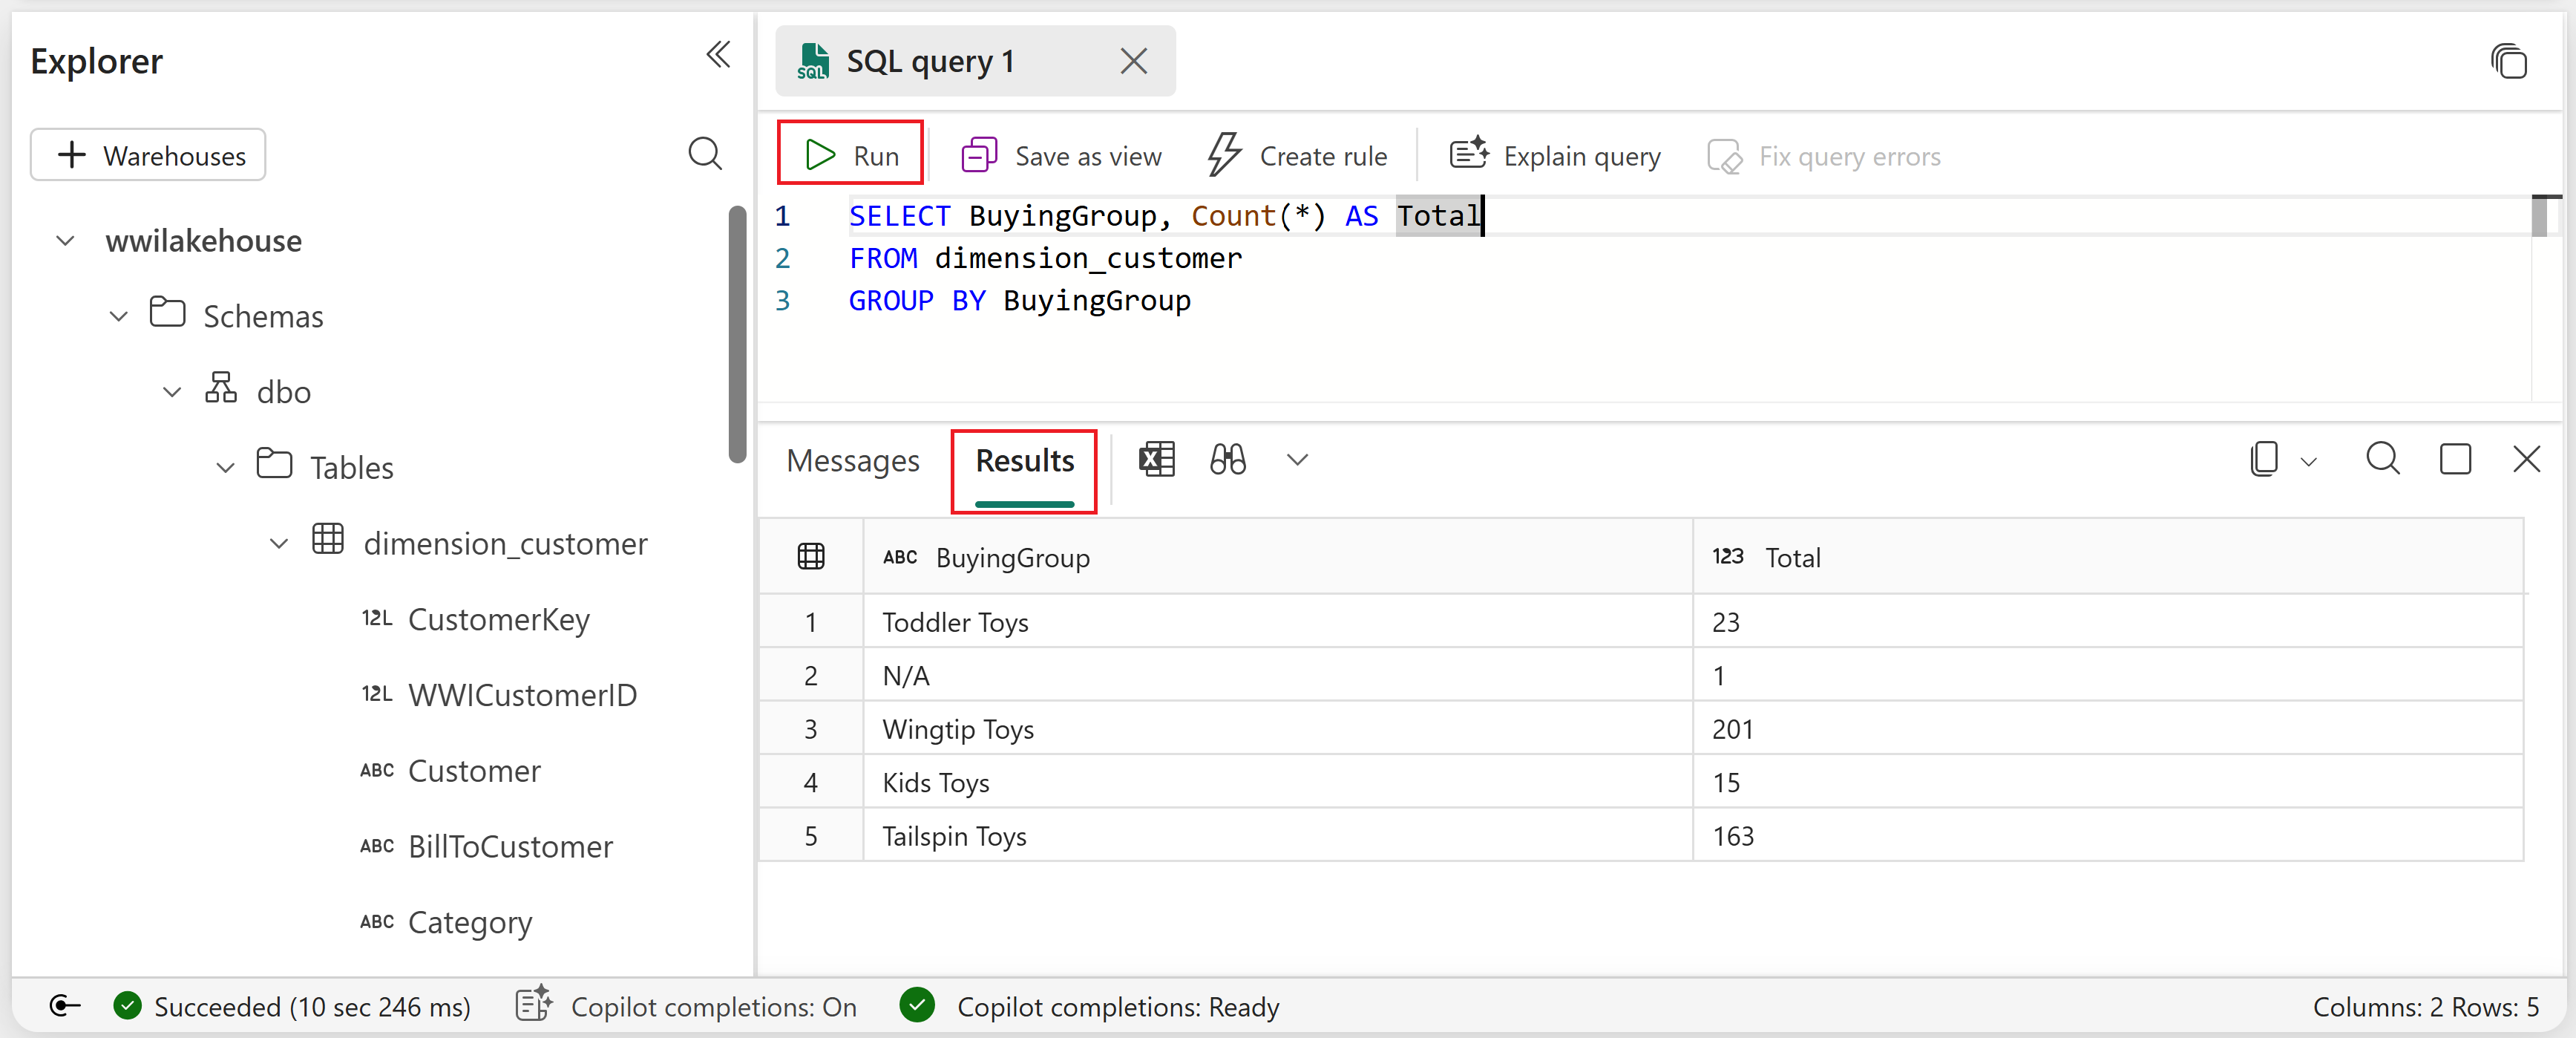
K dotazování dat pomocí příkazů SQL můžete použít koncový bod analýzy SQL lakehouse. V rozevírací nabídce v pravém horním rohu obrazovky vyberte SQL Analytics endpoint.

Výběr tabulky dimension_customer umožní zobrazit náhled jejích dat. Pokud chcete napsat příkazy SQL, vyberte v nabídce nový dotaz SQL nebo vyberte dlaždici Nový dotaz SQL .

Zadejte následující ukázkový dotaz, který agreguje počet řádků na základě sloupce BuyingGroup v tabulce dimension_customer .
SELECT BuyingGroup, Count(*) AS Total
FROM dimension_customer
GROUP BY BuyingGroup
Poznámka:
Soubory dotazů SQL se automaticky ukládají pro budoucí referenci a tyto soubory můžete podle potřeby přejmenovat nebo odstranit.
Pokud chcete skript spustit, vyberte ikonu Spustit v horní části souboru skriptu.


Přidání tabulek do sémantického modelu
V této části přidáte tabulky do sémantického modelu, abyste je mohli použít k vytváření zpráv.
Otevřete lakehouse a přepněte do zobrazení koncového bodu analýzy SQL.
Vyberte Nový sémantický model.
V podokně Nový sémantický model zadejte název sémantického modelu, přiřaďte pracovní prostor a vyberte tabulky, které chcete přidat. V tomto případě vyberte tabulku dimension-customer.

Výběrem možnosti Potvrdit vytvořte sémantický model.
Výstraha
Pokud se zobrazí chybová zpráva "Nepovedlo se nám přidat nebo odebrat tabulky" kvůli překročení limitu výpočetní kapacity prostředků infrastruktury vaší organizace, počkejte několik minut a zkuste to znovu. Další informace najdete v dokumentaci ke kapacitě Fabric.
Sémantický model se vytvoří v režimu úložiště Direct Lake, což znamená, že čte data přímo z tabulek Delta v OneLake pro rychlý výkon dotazů bez nutnosti importu dat. Po vytvoření můžete upravit sémantický model a přidat relace, míry a další.
Návod
Další informace o Direct Lake a jejích výhodách najdete v přehledu Direct Lake.

Vytvořit sestavu
V této části vytváříte report ze sémantického modelu, který jste vytvořili.
V pracovním prostoru vyhledejte sémantický model, který jste vytvořili, vyberte nabídku ... (tři tečky) a pak vyberte Automaticky vytvořit sestavu.

Tabulka je dimenze a v ní nejsou žádné metriky. Power BI vytvoří míru pro počet řádků, agreguje ho napříč různými sloupci a vytvoří různé grafy, jak je znázorněno na následujícím snímku obrazovky.

Tuto sestavu můžete uložit pro budoucnost výběrem možnosti Uložit na horním pásu karet. V této sestavě můžete provádět další změny tak, aby splňovaly vaše požadavky zahrnutím nebo vyloučením jiných tabulek nebo sloupců.

