Hinweis
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, sich anzumelden oder das Verzeichnis zu wechseln.
Für den Zugriff auf diese Seite ist eine Autorisierung erforderlich. Sie können versuchen, das Verzeichnis zu wechseln.
Important
Dieses Feature befindet sich in der Public Preview. Arbeitsbereichsadministratoren können den Zugriff auf dieses Feature über die Vorschauseite steuern. Siehe Manage Azure Databricks Previews.
Zugriffskontrolle
Features sind regelbare Unity Catalog-Objekte. Der Zugriff auf ein Feature wird durch die Rechte des Unity-Katalogs und CREATE FEATURE die READ FEATUREMANAGERechte des Unity-Katalogs gesteuert. Vollständige Beschreibungen finden Sie unter Unity Catalog-Berechtigungsreferenz.
-
CREATE FEATURE– Erforderlich, um ein Feature in einem Schema zu erstellen.create_featureundregister_featurefür das übergeordnete Schema erforderlichCREATE FEATURE. Nach dem Prinzip der geringsten Berechtigung können Sie sie auf Schemaebene gewährenCREATE FEATURE. Sie können es auch einem Katalog erteilen, um das Erstellen von Features in einem beliebigen Schema in diesem Katalog zu ermöglichen. -
READ FEATURE– Erforderlich zum Lesen eines Features und seiner Daten.get_feature,create_training_setund lesen Sie materialisierte Featuredaten für Schulungen oder die Bereitstellung, die für das Feature erforderlich sindREAD FEATURE.READ FEATUREfür ein Schema oder Katalog gilt für alle aktuellen und zukünftigen Features, die es enthält. -
MANAGE– Erforderlich, um den Lebenszyklus und die Gewährung eines Features zu verwalten. Das Löschen eines Features mitdelete_featureund das Materialisieren eines Features mitmaterialize_featuresoderdelete_materialized_feature, das für das Feature erforderlich istMANAGE.
Alle Featurevorgänge erfordern USE CATALOG auch den übergeordneten Katalog und USE SCHEMA das übergeordnete Schema. Informationen MANAGE zur Materialisierung und READ FEATURE Anwendung auf die Materialisierung finden Sie unter "Berechtigungen".
Featureansichts-API
Feature Konstruktor und register_feature()
Der empfohlene Ansatz besteht darin, ein Feature Objekt lokal zu erstellen und zu verwenden register_feature , um es im Unity-Katalog zu speichern. Mit diesem zweistufigen Workflow können Sie mit Features (einschließlich create_training_set) experimentieren, bevor Sie sie registrieren.
Feature(
    source: DataSource,                                    # Required: DeltaTableSource, StreamSource, or RequestSource
    function: Union[AggregationFunction, ColumnSelection], # Required: Aggregation or column selection
    entity: Optional[List[str]] = None,                    # Required for all sources except RequestSource: entity columns
    timeseries_column: Optional[str] = None,               # Required for all sources except RequestSource: timestamp column
    name: Optional[str] = None,                            # Optional: Feature name (auto-generated if omitted)
    description: Optional[str] = None,                     # Optional: Feature description
)
FeatureEngineeringClient.register_feature() registriert einen lokal erstellten Feature Unity-Katalog.
FeatureEngineeringClient.register_feature(
    feature: Feature,       # Required: A Feature instance (not already registered)
    catalog_name: str,      # Required: UC catalog name
    schema_name: str,       # Required: UC schema name
) -> Feature
from databricks.feature_engineering.entities import Feature, DeltaTableSource, AggregationFunction, Sum, RollingWindow
from datetime import timedelta

# Step 1: Construct the feature locally
feature = Feature(
    source=DeltaTableSource(catalog_name="main", schema_name="store", table_name="transactions"),
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)

# Step 2: Register in Unity Catalog
fe = FeatureEngineeringClient()
registered_feature = fe.register_feature(
    feature=feature,
    catalog_name="main",
    schema_name="store",
)
create_feature()
FeatureEngineeringClient.create_feature() überprüft, erstellt und registriert sofort ein Feature im Unity-Katalog in einem einzigen Schritt. Verwenden Sie diese Option, wenn Sie nicht zuerst mit dem Feature experimentieren müssen.
FeatureEngineeringClient.create_feature(
    source: DataSource,                                    # Required: DeltaTableSource, StreamSource, or RequestSource
    function: Union[AggregationFunction, ColumnSelection], # Required: Aggregation or column selection
    catalog_name: str,                                     # Required: The catalog name for the feature
    schema_name: str,                                      # Required: The schema name for the feature
    entity: Optional[List[str]] = None,                    # Required for all sources except RequestSource: entity columns
    timeseries_column: Optional[str] = None,               # Required for all sources except RequestSource: timestamp column
    name: Optional[str] = None,                            # Optional: Feature name (auto-generated if omitted)
    description: Optional[str] = None,                     # Optional: Feature description
) -> Feature
Parameter:
-
source: Die Datenquelle, die in der Featureberechnung verwendet wird (DeltaTableSource,StreamSourceoderRequestSource). -
function: EinAggregationFunctionBündel des Operators (z. BSum(input="amount"). ), Eingabespalte und Zeitfenster zusammen. OderColumnSelection("column_name")für Pass-Through-Features. -
catalog_name: Der Name des Unity-Katalogkatalogs für das Feature. -
schema_name: Der Schemaname des Unity-Katalogs für das Feature. -
entity: Liste der Spaltennamen, die die Aggregations- oder Nachschlageschlüssel (Primärschlüssel) definieren. Erforderlich für alle Quelltypen außerRequestSource. Beispielsweise["user_id"]Aggregate oder Nachschlageaktionen pro Benutzer. -
timeseries_column: Die Zeitstempelspalte, die für die Zeitfensteraggregation oder die Auswahl des neuesten Werts verwendet wird. Erforderlich für alle Quelltypen außerRequestSource. -
name: Optionaler Featurename. Wenn sie nicht angegeben wird, wird automatisch aus der Eingabespalte, Funktion und dem Fenster generiert (z. Bamount_avg_rolling_7d. ). -
description: Optionale Beschreibung des Features.
Gibt: Eine überprüfte Feature-Instanz
Wirft: ValueError, wenn eine Überprüfung fehlschlägt
delete_feature()
Löscht ein Feature aus dem Unity-Katalog anhand seines vollqualifizierten Namens.
FeatureEngineeringClient.delete_feature(
    full_name: str,  # Required: '<catalog>.<schema>.<feature_name>'
) -> None
fe.delete_feature(full_name="main.store.amount_sum_rolling_7d")
Bevor Sie ein Feature löschen, entfernen oder aktualisieren Sie alle Modelle oder Featurespezifikationen, die darauf verweisen. Wenn das Feature materialisiert wurde, löschen Sie zuerst das materialisierte Feature. Erfahren Sie , wie Sie ein materialisiertes Feature löschen.
Automatisch generierte Namen
Wenn name dieser Parameter nicht angegeben wird, wird automatisch ein Name generiert. Generierte Namen folgen dem Muster: {column}_{function}_{window}. Beispiel:
-
price_avg_rolling_1h(1-Stunden-Durchschnittspreis) -
transaction_count_rolling_30d_1d(30-Tage-Anzahl der Transaktion mit 1D-Verzögerung vom Ereigniszeitstempel)
Unterstützte Funktionen
Aggregationsfunktionen
Note
Aggregationsfunktionen werden zusammen AggregationFunction mit einem Zeitfenster umschlossen, wie in Zeitfenstern beschrieben. Jede Funktion verwendet einen input Parameter, der die zu aggregierende Quellspalte angibt.
| Funktion | Description | Exemplarischer Anwendungsfall |
|---|---|---|
Sum(input="column") |
Summe der Werte | Tägliche App-Nutzung pro Benutzer in Minuten |
Avg(input="column") |
Mittelwert der Werte | Mittlerer Transaktionsbetrag |
Count(input="column") |
Anzahl der Datensätze | Anzahl der Anmeldungen pro Benutzer |
Min(input="column") |
Minimalwert | Niedrigste Von einem tragbaren Gerät aufgezeichnete Herzfrequenz |
Max(input="column") |
Maximalwert | Höchster Transaktionsbetrag pro Sitzung |
StddevPop(input="column") |
Standardabweichung der Population | Tägliche Transaktionsbetragsvariabilität für alle Kunden |
StddevSamp(input="column") |
Stichprobenstandardabweichung | Variabilität der Klickraten für Anzeigenkampagnen |
VarPop(input="column") |
Varianz der Population | Verbreitung von Sensorwerten für IoT-Geräte in einer Fabrik |
VarSamp(input="column") |
Stichprobenabweichung | Verteilung von Filmbewertungen über eine ausgewählte Gruppe |
ApproxCountDistinct(input="column", relativeSD=0.05) |
Ungefähre eindeutige Anzahl | Unterschiedliche Anzahl der gekauften Artikel |
ApproxPercentile(input="column", percentile=0.95, accuracy=100) |
Ungefähres Perzentil | p95-Antwortverzögerung |
First(input="column") |
Erster Wert | Erster Anmeldezeitstempel |
Last(input="column") |
Letzter Wert | Zuletzt erworbener Betrag |
FirstN(input="column", n=3) |
Erste Werte n als Array |
Erste drei Produkte, die in einer Sitzung betrachtet werden |
LastN(input="column", n=3) |
Letzte n Werte als Array |
Drei jüngste Statuszustände von Unterstützungsfällen |
FirstDistinct(input="column", n=3) |
Zuerst n unterscheidende Werte als Array |
Die ersten drei unterschiedlichen Produktkategorien |
LastDistinct(input="column", n=3) |
Letzte n unterschiedliche Werte als Array |
Drei jüngste unterschiedliche Händlerkategorien |
Note
First, Last, FirstN, LastN, , FirstDistinct, und LastDistinct enthalten standardmäßig Nullwerte. Um NULL-Werte zu überspringen, fügen Sie ein filter_condition , das Eingabespalten explizit ausschließt, die NULL sind.
FirstN, LastN, , FirstDistinctund LastDistinct nutzt die Merkmale, timeseries_column um Eingabezeilen zu ordnen und ein Array mit bis zu bestimmten Werten n zurückzugeben. Der Parameter n muss eine positive ganze Zahl sein.
FirstN und FirstDistinct Werte vom frühesten bis zum neuesten auswählen.
LastN und wählt LastDistinct Werte vom neuesten bis frühesten aus und gibt dann die ausgewählten Werte in Zeitstempelreihenfolge zurück.
FirstDistinct und LastDistinct beim Auswählen von Werten in diese Richtung doppelte Werte entfernen.
Wenn zum Beispiel die Quellzeilen einer Entität nach event_time["A", "A", "B", "C", "B", "B"]geordnet sind, geben folgende Funktionen zurück:
| Funktion | Result |
|---|---|
FirstN(input="event_type", n=3) |
["A", "A", "B"] |
LastN(input="event_type", n=3) |
["C", "B", "B"] |
FirstDistinct(input="event_type", n=3) |
["A", "B", "C"] |
LastDistinct(input="event_type", n=3) |
["A", "C", "B"] |
FirstN, LastN, , FirstDistinctund LastDistinct erfordern databricks-feature-engineering Version 0.17.0 oder neuer.
ColumnSelection (Pass-Through)
ColumnSelection wählt eine einzelne Spalte aus einer Quelle aus, ohne eine Aggregation anzuwenden. Er wird direkt in den function Parameter eingeschlossen (nicht innerhalb AggregationFunction). Der Rückgabetyp wird aus dem Quellschema abgeleitet.
| Funktion | Description | Exemplarischer Anwendungsfall |
|---|---|---|
ColumnSelection("col") |
Letzter Wert einer Spalte (keine Aggregation) | Neueste Anbieterkategorie, Pass-Through eines Anforderungsfelds |
ColumnSelection kann mit einer beliebigen Datenquelle verwendet werden:
-
DeltaTableSource: Gibt den neuesten Wert pro Entitätsschlüssel über einen Punkt-in-Time-Join (keine Lookbackfensteraggregation) zurück. -
StreamSource: Gibt den neuesten Wert pro Entitätsschlüssel aus dem Stream zurück (keine Rückblickfensteraggregation). -
RequestSource: Durchläuft den zur Ableitungszeit bereitgestellten Wert (oder extrahiert aus dem bezeichneten DataFrame zur Schulungszeit).
from databricks.feature_engineering.entities import (
    ColumnSelection, DeltaTableSource, Feature, FieldDefinition,
    RequestSource, ScalarDataType,
)

delta_source = DeltaTableSource(
    catalog_name="main", schema_name="feature_store", table_name="transactions",
)

request_source = RequestSource(
    schema=[
        FieldDefinition(name="session_duration", data_type=ScalarDataType.DOUBLE),
    ]
)

# ColumnSelection from a Delta table
latest_amount = Feature(
    source=delta_source,
    function=ColumnSelection("amount"),
    entity=["user_id"],
    timeseries_column="transaction_time",
    name="latest_transaction_amount",
)

# ColumnSelection from a RequestSource
session_feature = Feature(
    source=request_source,
    function=ColumnSelection("session_duration"),
    name="session_duration",
)
Beispiel: Aggregations- und Spaltenauswahlfeatures
Das folgende Beispiel zeigt Features, die über dieselbe Datenquelle definiert sind.
from databricks.feature_engineering.entities import (
    AggregationFunction, Feature, Sum, Avg, ApproxCountDistinct,
    ColumnSelection, RollingWindow,
)
from datetime import timedelta

window = RollingWindow(window_duration=timedelta(days=7))

sum_feature = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(Sum(input="amount"), window),
)

avg_feature = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(Avg(input="amount"), window),
)

distinct_count = Feature(
    source=source,
    entity=["user_id"],
    timeseries_column="event_time",
    function=AggregationFunction(ApproxCountDistinct(input="product_id", relativeSD=0.01), window),
)

# Column selection (no aggregation, no time window)
latest_amount = Feature(
    source=source,
    function=ColumnSelection("amount"),
    entity=["user_id"],
    timeseries_column="event_time",
    name="latest_amount",
)
Funktionen mit Filterbedingungen
Mit dem filter_condition Parameter können Sie Zeilen aus der Quelltabelle filtern, bevor Aggregationen berechnet werden. Dies funktioniert als SQL-Klausel WHERE , die vor dem Gruppieren und Aggregieren von Daten angewendet wird.
Note
filter_condition Filtert Zeilen vor der Aggregation, z. B. eine SQL-Klausel WHERE , die vor GROUP BYder Aggregation angewendet wird. Sie ändert nicht die Granularität, die immer von entity der Featuredefinition definiert wird.
Filter sind nützlich, wenn Sie mit großen Quelltabellen arbeiten, die eine Obermenge von Daten enthalten, die für die Featureberechnung erforderlich sind, und die Notwendigkeit minimieren, separate Ansichten über diesen Tabellen zu erstellen.
from databricks.feature_engineering.entities import AggregationFunction, Sum, Count, RollingWindow, DeltaTableSource
from datetime import timedelta

# Source with filter applied at the source level
high_value_transactions = DeltaTableSource(
    catalog_name="main",
    schema_name="ecommerce",
    table_name="transactions",
    filter_condition="amount > 100",  # Only transactions over $100
)

high_value_sales = Feature(
    source=high_value_transactions,
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=30))),
)

# Multiple conditions
completed_orders_source = DeltaTableSource(
    catalog_name="main",
    schema_name="ecommerce",
    table_name="orders",
    filter_condition="status = 'completed' AND payment_method = 'credit_card'",
)

completed_orders = Feature(
    source=completed_orders_source,
    entity=["user_id"],
    timeseries_column="order_time",
    function=AggregationFunction(Count(input="order_id"), RollingWindow(window_duration=timedelta(days=7))),
)

# Filter on a StreamSource
from databricks.feature_engineering.entities import StreamSource

purchase_stream = StreamSource(
    full_name="main.ecommerce.transactions_stream",
    filter_condition="value.event_type = 'purchase'",
)

purchase_total = Feature(
    source=purchase_stream,
    entity=["value.user_id"],
    timeseries_column="value.event_time",
    function=AggregationFunction(Sum(input="value.amount"), RollingWindow(window_duration=timedelta(hours=1))),
)
Datenquellen
DeltaTableSource
DeltaTableSource ist ein ephemeres Python Objekt, das verwendet wird, um zu definieren, wie Features aus einer Quelltabelle berechnet werden. Es wird keine neue Tabelle erstellt. Sie gibt die Konfiguration zum Lesen von Daten und Aggregierungsfeatures an.
DeltaTableSource(
    catalog_name: str,                              # Required: Catalog name
    schema_name: str,                               # Required: Schema name
    table_name: str,                                # Required: Table name
    filter_condition: Optional[str] = None,         # Optional: SQL WHERE clause to filter source data
    transformation_sql: Optional[str] = None,       # Optional: SQL SELECT expression for column transformations
    dataframe_schema: Optional[str] = None,         # Required if transformation_sql is set: schema of the resulting DataFrame
    lateness: Optional[SourceLateness] = None,       # Optional: Expected source settling time
)
Parameter:
-
catalog_name, ,schema_nametable_name: Identifizieren sie die Quell-Delta-Tabelle im Unity-Katalog. -
filter_condition: Eine SQL-KlauselWHERE, die vor der Aggregation angewendet wird. Beispiel:"status = 'completed'". -
transformation_sql: Ein SQL-AusdruckSELECT, der auf die Quelltabelle angewendet wird. Verwenden Sie diese Eigenschaft, um Spalten, Umwandlungstypen oder abgeleitete Spalten vor der Aggregation umzubenennen. Wenn nicht angegeben, werden alle Spalten ausgewählt (*). Beispiel:"user_id, CAST(amount AS DOUBLE) AS amount, event_time". -
dataframe_schema: Das Schema des resultierenden DataFrames nach Transformationen im Spark StructType JSON-Format (vondf.schema.json()). Erforderlich, wenntransformation_sqlangegeben ist. Dadurch wird dem System die Spaltennamen und -typen mitgeteilt, die aus der Transformation resultieren. -
lateness: EinSourceLatenessObjekt, das beschreibt, wie lange die Quelle normalerweise braucht, um in Ereigniszeit vollständig zu werden. Wenn sie weggelassen wird, gilt die Quelle sofort als vollständig.
Wenn beide filter_condition und transformation_sql festgelegt werden, lautet die resultierende Abfrage: SELECT {transformation_sql} FROM {table} WHERE {filter_condition}.
SourceLateness.settling_delay ist die empfohlene Methode, während des Trainings eine konstante ETL-Verzögerung zu simulieren, die die Online-Materialisierung beeinflusst. Azure Databricks verschiebt die berechtigte Trainingsbewertungszeit um diese Dauer nach hinten, sodass ein Trainingsbeispiel keine Daten verwendet, die sich noch online übertragen hätten. Während der Materialisierung wartet Azure Databricks genauso lange, bevor ein abgeschlossenes Fenster veröffentlicht wird, und bedient das zuletzt abgeschlossene Fenster während der dazwischenliegenden Zeit.
Angenommen, ein täglicher ETL-Job wird 8 Stunden nach Mitternacht in einer lokalen Zeitzone abgeschlossen, in der Mitternacht 07:00 UTC entspricht. Verwenden Sie eine Setling-Verzögerung von 8 Stunden und einen Fensterversatz von 7 Stunden:
from datetime import timedelta
from databricks.feature_engineering.entities import (
    DeltaTableSource,
    SourceLateness,
    TumblingWindow,
)

source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    lateness=SourceLateness(settling_delay=timedelta(hours=8)),
)

window = TumblingWindow(
    window_duration=timedelta(days=1),
    offset=timedelta(hours=7),
)
Note
Die timeseries_column müssen vom Typ TimestampType oder TimestampNTZTypesein.
DateType wird für Zeitreihen nicht unterstützt; beschreibe die Spalte zuerst TimestampType (zum Beispiel mit transformation_sql).
Beispiel: Verwenden transformation_sql für Spaltentransformationen
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="raw_events",
    transformation_sql="user_id, CAST(price_cents AS DOUBLE) / 100 AS price, event_time",
    filter_condition="event_type = 'purchase'",
    dataframe_schema=spark.sql(
        "SELECT user_id, CAST(price_cents AS DOUBLE) / 100 AS price, event_time FROM main.analytics.raw_events LIMIT 0"
    ).schema.json(),
)
Beispiel: Ableiten transformation_sql und dataframe_schema von einem PySpark DataFrame
Sie können Ihre Transformation als PySpark-Abfrage schreiben und dann das Schema aus dem resultierenden DataFrame extrahieren:
df = spark.sql(f"""
  SELECT user_id, CAST(amount AS DOUBLE) / 100 AS amount_dollars, event_time
  FROM main.analytics.events
  WHERE event_date >= date_sub(current_date(), 7)
  LIMIT 0
""")

# Use df.schema.json() as the dataframe_schema
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    transformation_sql="user_id, CAST(amount AS DOUBLE) / 100 AS amount_dollars, event_time",
    filter_condition="event_date >= date_sub(current_date(), 7)",
    dataframe_schema=df.schema.json(),
)
Unterstützte transformation_sql Ausdrücke
Die gleichen Regeln gelten für transformation_sql auf DeltaTableSource und StreamSource.
transformation_sql unterstützt beliebige zeilenweise Ausdrücke; Operationen werden unabhängig für jede Zeile ausgewertet. Sie ändern weder die Anzahl der Zeilen noch die Eins-zu-eins-Entsprechung mit der Quelle. Zeilenweise Ausdrücke umfassen Spaltenumbenennungen, Guss, arithmetische Operationen und mehr.
Operationen, die die Form oder Zeilenanzahl verändern, werden nicht unterstützt, wie z. B. Aggregationen wie SUM() oder COUNT(). Verwenden Sie AggregationFunction stattdessen die Featuredefinition.
DeltaTableSource.from_sql()
Als Einfachheit können Sie eine DeltaTableSource aus einer SQL-Abfrage erstellen. Die Methode analysiert die Abfrage, um den Tabellennamen automatisch zu extrahieren, transformation_sqlund filter_condition.
DeltaTableSource.from_sql(
    sql: str,                           # Required: SQL SELECT query
    spark: SparkSession,                # Required: active SparkSession (for schema inference)
) -> DeltaTableSource
Nur einfache SELECT ... FROM ... [WHERE ...] Abfragen werden unterstützt. Komplexe SQL (JOINs, Unterabfragen, CTEs, UNIONs) werden abgelehnt. Erstellen Sie für komplexe Abfragen DeltaTableSource direkt mit transformation_sql und filter_condition.
from databricks.feature_engineering.entities import (
    AggregationFunction,
    DeltaTableSource,
    Feature,
    Sum,
    TumblingWindow,
)

source = DeltaTableSource.from_sql(
    spark=spark,
    sql=f"SELECT customer_id, event_ts, amount * 2 AS doubled_amount, amount FROM {CATALOG}.{SCHEMA}.{TABLE}",
)

feature = Feature(
    source=source,
    function=AggregationFunction(Sum(input="doubled_amount"), time_window=TumblingWindow(window_duration=timedelta(days=7))),
    entity=["customer_id"], timeseries_column="event_ts",
)
Durchlaufen mit to_dataframe()
Wird source.to_dataframe() verwendet, um eine Vorschau der Daten anzuzeigen, die für die Featureberechnung verwendet werden. Dies ist nützlich für die Iterierung filter_condition und transformation_sql bis sie die erwarteten Ergebnisse erzeugen.
source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="events",
    filter_condition="event_type = 'purchase'",
)

# Preview the filtered source data
source.to_dataframe().display()
Grundlegendes zu Entitäten
Entitätsspalten definieren die Aggregationsebene für Ihre Features. Sie werden für die Feature Definition angegeben, nicht für DeltaTableSource. Entitäten bestimmen:
-
Gruppieren von Daten: Features werden pro eindeutige Kombination von Entitätswerten aggregiert (ähnlich
GROUP BYwie in SQL) - Die Primärschlüsselstruktur: Jede eindeutige Entitätskombination führt zu einer Zeile berechneter Features.
Beispiel: Features auf Kundenebene
Der folgende Code aggregiert Features auf Kundenebene (eine Zeile pro Kunde):
from databricks.feature_engineering.entities import DeltaTableSource

source = DeltaTableSource(
    catalog_name="main",
    schema_name="analytics",
    table_name="user_events",
)

Feature(
    source=source,
    entity=["user_id"],                # Features aggregated per user
    timeseries_column="event_time",    # Timestamp for time windows
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)
Beispiel: Features auf Kundenspeicherebene
Um Features auf einer detaillierteren Ebene zu aggregieren (eine Zeile pro Kundenspeicherkombination), verwenden Sie mehrere Entitätsspalten:
source = DeltaTableSource(
    catalog_name="main",
    schema_name="retail",
    table_name="transactions",
)

Feature(
    source=source,
    entity=["user_id", "store_id"],  # Features aggregated per user-store pair
    timeseries_column="transaction_time",
    function=AggregationFunction(Sum(input="amount"), RollingWindow(window_duration=timedelta(days=7))),
)
Wenn Sie Features auf verschiedenen Aggregationsebenen benötigen (z. B. Auf Kundenebene und Kundenspeicherebene), verwenden Sie in Ihren Featuredefinitionen unterschiedliche entity Werte. Dasselbe DeltaTableSource kann für Features mit unterschiedlichen Entitätskonfigurationen gemeinsam verwendet werden.
StreamSource
StreamSource verweist auf einen Stream. Der Stream enthält Verbindungs-, Authentifizierungs-, Schema- und Aufnahmekonfiguration für die Streamingquelle. Für Kafka müssen Spaltenverweise in Featuredefinitionen mit value.key. einem Präfix versehen oder angeben, welcher Teil der Nachricht gelesen werden soll.
StreamSource(
    full_name: str,                       # Required: Three-part Stream name (catalog.schema.stream)
    filter_condition: Optional[str] = None,      # Optional: SQL WHERE clause applied before aggregation
    transformation_sql: Optional[str] = None,    # Optional: SQL SELECT expression for column transformations
    dataframe_schema: Optional[str] = None,      # Required if transformation_sql is set: schema of the resulting DataFrame
    lateness: Optional[SourceLateness] = None,    # Optional: Expected source settling time
)
Parameter:
-
full_name: Der vollständige dreiteilige Name eines Datenstroms (z. B"my_catalog.my_schema.my_stream". ). -
filter_condition(optional): Eine SQL-KlauselWHERE, die vor der Aggregation auf Datenstrom angewendet wird, mit punktpräfixierten Spaltenbezügen (z. B"value.event_type = 'purchase'". ). -
transformation_sql(optional): Ein SQL-AusdruckSELECT, der vor der Aggregation oder Spaltenauswahl angewendet wird, wobei punktpräfixierte Referenzen auf diekeyund-Strukturenvalueverwendet werden. Unterstützt dieselben zeilenweisen Ausdrücke wieDeltaTableSource. Wenn weggelassen, verwendet die Quelle alle Spalten (*). -
dataframe_schema: Das Spark-JSON-SchemaStructTypeder projizierten Ausgabe. Erforderlich, wenn du .transformation_sql -
lateness: EinSourceLatenessObjekt, das beschreibt, wie lange der Strom normalerweise braucht, um in der Ereigniszeit vollständig zu werden. SieheSourceLateness.settling_delay.
from databricks.feature_engineering.entities import StreamSource

stream_source = StreamSource(
    full_name="my_catalog.my_schema.my_stream",
    filter_condition="value.event_type = 'purchase'",
)
Man leitet dataframe_schema ab, indem man die Projektion gegen den Aufnahmetisch des Stroms ausführt, der die key und value Strukturen freilegt.
transformation_sql = (
    "value.amount * value.conversion_rate AS converted_amount, "
    "struct(value.user_id AS user_id, value.event_time AS time) AS event"
)

ingestion_table = "my_catalog.my_schema.events_ingestion"
dataframe_schema = spark.sql(
    f"SELECT {transformation_sql} FROM {ingestion_table} LIMIT 0"
).schema.json()

stream_source = StreamSource(
    full_name="my_catalog.my_schema.my_stream",
    transformation_sql=transformation_sql,
    dataframe_schema=dataframe_schema,
)
RequestSource
RequestSource definiert ein Schema für Daten, die zur Ableitungszeit in der Anforderungsnutzlast bereitgestellt werden, anstatt aus einer vordefinierten Tabelle nachschlagen zu müssen. Während der Schulung werden diese Spalten aus dem beschrifteten DataFrame extrahiert, das an create_training_set. Während der Modellbereitstellung muss der Aufrufer sie in die HTTP-Anforderungsnutzlast einschließen.
RequestSource wird verwendet mit ColumnSelection (um einen Wert direkt zu durchlaufen). Es unterstützt keine Aggregationsfunktionen oder Zeitfenster.
Definieren des Schemas
Definieren Sie das Schema als Eine Liste von FieldDefinition Objekten, wobei jeder einen Spaltennamen und ein ScalarDataType:
from databricks.feature_engineering.entities import (
    FieldDefinition, RequestSource, ScalarDataType,
)

request_source = RequestSource(
    schema=[
        FieldDefinition(name="transaction_amount", data_type=ScalarDataType.DOUBLE),
        FieldDefinition(name="vendor_id", data_type=ScalarDataType.STRING),
        FieldDefinition(name="transaction_id", data_type=ScalarDataType.STRING),
        FieldDefinition(name="transaction_time", data_type=ScalarDataType.DATE),
    ]
)
Unterstützte Datentypen
RequestSourceunterstützt die skalaren Typen, die in : , , ScalarDataType, , INTEGER, FLOAT, BOOLEAN, STRING, , , . DOUBLELONGTIMESTAMPDATESHORT Komplexe Typen wie Arrays, Karten und Strukturen werden nicht unterstützt.
Wie Anforderungsdaten hydratisiert werden
| Kontext | Behavior |
|---|---|
Schulung (create_training_set) |
Spalten werden aus dem beschrifteten DataFrame extrahiert. Typen werden anhand des deklarierten Schemas überprüft. Bei Nichtübereinstimmungen wird ein Fehler ausgelöst (keine implizite Umwandlung). |
| Dienst ( Modellendpunkt) | Spalten werden aus dataframe_records oder dataframe_split in der HTTP-Anforderung abgerufen. JSON-Werte werden in die deklarierten Typen (z. B. JSON-Nummer → DOUBLE) umgesetzt. |
Modellsignatur
Wenn ein Modell mit log_model einem Schulungssatz protokolliert wird, der Features enthält RequestSource , werden die RequestSource Spalten der MLflow-Modellsignatur als erforderliche Eingaben hinzugefügt. Dies bedeutet, dass das API-Schema des dienstenden Endpunkts widerspiegelt, welche Felder Aufrufer zur Ableitungszeit bereitstellen müssen.
Schulungs- und Rückschluss-API
create_training_set und score_batch Berechnen von Punkt-in-Time-korrekten Featurewerten bei Bedarf aus den Quelldaten. Bei Features, die die Offlinematerialisierung unterstützen, z. B. Gleitfensteraggregationen in Delta-Tabellenquellen, verbessert die Materialisierungsfeatures zuerst in einem Offlinespeicher die Leistung beider Vorgänge. Wenn materialisierte Offlinefeatures verfügbar sind, lesen die Vorgänge vorkompilierte Offlinedaten, anstatt Featurewerte aus der Quelle neu zu komputieren. Siehe Materialisieren von Featureansichten , um Features in einem Offlinespeicher zu materialisieren.
create_training_set()
Erstellt ein Schulungsdatenset mit Punkt-in-Time-korrekter Featureberechnung. Ausführliche Informationen finden Sie unter "Train models with Feature Views".
FeatureEngineeringClient.create_training_set(
    df: DataFrame,                                # DataFrame with training data
    features: Optional[List[Feature]],            # List of Feature objects
    label: Union[str, List[str], None],           # Label column name(s)
    exclude_columns: Optional[List[str]] = None,  # Optional: columns to exclude
) -> TrainingSet
log_model()
Protokolliert ein Modell mit Featuremetadaten für die Nachverfolgung von Linien und die automatische Featuresuche während der Ableitung. Ausführliche Informationen finden Sie unter "Train models with Feature Views".
FeatureEngineeringClient.log_model(
    model,                                    # Trained model object
    artifact_path: str,                       # Path to store model artifact
    flavor: ModuleType,                       # MLflow flavor module (e.g., mlflow.sklearn)
    training_set: TrainingSet,                # TrainingSet used for training
    registered_model_name: Optional[str],     # Optional: register model in Unity Catalog
)
score_batch()
Führt die Offlinebatch-Ableitung mit automatischer Featuresuche durch. Verwendet die featuremetadaten, die mit dem Modell gespeichert sind, um punktintime korrekte Features zu berechnen, um die Konsistenz mit der Schulung sicherzustellen.
FeatureEngineeringClient.score_batch(
    model_uri: str,                           # URI of logged model (e.g., "models:/catalog.schema.model/1")
    df: DataFrame,                            # DataFrame with entity keys and timestamps
) -> DataFrame
Der Eingabedatenrahmen muss die Entitäts- und Zeitserienspalten enthalten, die während der Schulung verwendet werden. Features werden automatisch aus den Quelldaten berechnet.
fe = FeatureEngineeringClient()

# Batch scoring with automatic feature lookup
predictions = fe.score_batch(
    model_uri="models:/main.ecommerce.fraud_model/1",
    df=inference_df,
)
predictions.display()
Zeitfenster
Feature Views unterstützen vier Fenstertypen, um das Rückblickverhalten für zeitfensterbasierte Aggregationen zu steuern. Die verfügbaren Fenstertypen hängen von der Herkunft des Features ab:
Streaming-Source-Funktionen können Roll- und Sägezahnfenster verwenden.
Batch-Quellfunktionen können Roll-, Tumbling- und Gleitfenster verwenden.
Rollfenster kehren von der Ereigniszeit zurück. Dauer und Verzögerung werden explizit definiert.
Springende Fenster sind feste, nicht überlappende Zeitfenster. Jeder Datenpunkt gehört zu genau einem Fenster.
Gleitfenster sind überlappende und rollende Zeitfenster mit einem konfigurierbaren Slide-Intervall.
Sawtooth-Fenster halten ein langes Rückblickfenster über eine Streamingquelle frisch, indem sie einen hybriden Batch- und Streaming-Pfad verwenden. Siehe Sawtooth-Fenster.
Die folgende Abbildung zeigt die Typen mit Roll-, Schieb-, Roll- und Sägezahnfenstern.
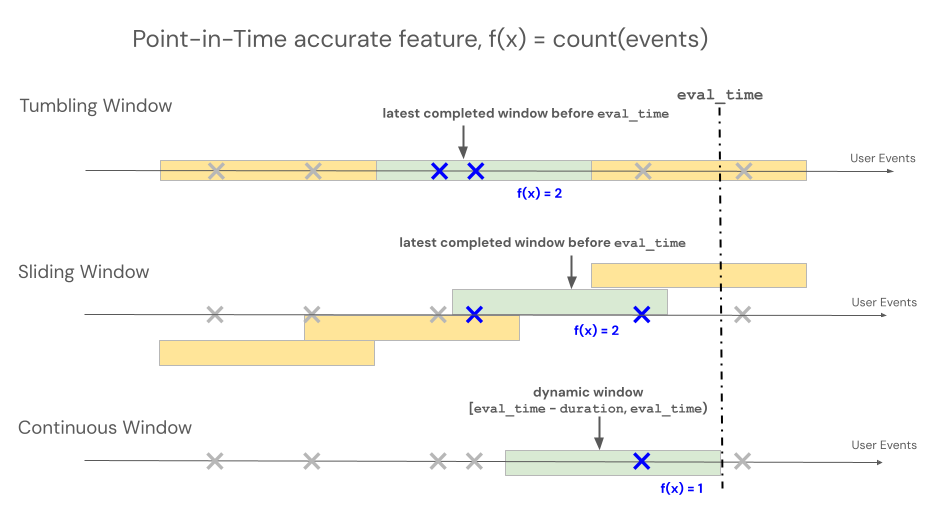
Zeitfenster-Timing
Verwenden Sie, delay um ein Fenster zu einem früheren analytischen Zeitpunkt zu bewerten. Zum Beispiel berechnet ein 30-Tage-Fenster mit einer 7-tägigen Verzögerung einen 30-Tage-Wert eine Woche vor der Bewertungszeit.
delay unabhängig von der Ankunftszeit der Quelle. Um die Zeit zu modellieren, die die Quelldaten benötigen, um anzukommen, konfigurieren Sie SourceLateness.settling_delay stattdessen.
Wenn beide Settings vorhanden sind, komponieren sie. Azure Databricks behandelt das Fenster als abgeschlossen nach der Quell-Setling-Verzögerung und bewertet es mit der analytischen Verzögerung.
Verwenden Sie, offset um die Ausrichtung fester Fenstergrenzen zu ändern. Standardmäßig sind Tumbling-Fenster und Schiebefenster auf Mitternachts-UTC ausgerichtet. Zum Beispiel richtet ein Offset von 22 Stunden eine Tagesgrenze auf 22:00 UTC aus. Um Grenzen in einer lokalen Zeitzone zu approximieren, konfigurieren Sie einen statischen Offset relativ zum UTC. Der Offset passt nicht an die Sommerzeit an, verschiebt die Auswertungszeit nicht und modelliert nicht verspätete Daten.
Die folgende Tabelle fasst die Unterstützung für diese Felder zusammen:
| Feld | Unterstützte Fenster | Constraint |
|---|---|---|
delay |
Rollen, Rollen und Gleiten | Muss ein nicht-negativ sein. datetime.timedelta |
offset |
Rollen und Rutschen | Muss nicht negativ sein und kürzer als die Periode* |
SourceLateness.settling_delay |
Roll-, Roll- und Gleitfunktionen | Muss ein nicht-negativ sein. datetime.timedelta |
*Punkt: Für ein Tumbling-Fenster muss der Offset kürzer als window_durationsein. Für ein Schiebefenster muss es kürzer als slide_durationsein.
Rollfenster
Note
RollingWindow wurde zuvor benannt ContinuousWindow. Wenn Sie von einer früheren SDK-Version migrieren, aktualisieren Sie Die Importe entsprechend.
Rollfenster sind up-to-Datums- und Echtzeitaggregate, die in der Regel über Streamingdaten verwendet werden. In Streamingpipelines gibt das Rollfenster nur dann eine neue Zeile aus, wenn sich der Inhalt des Fensters mit fester Länge ändert, z. B. wenn ein Ereignis eintritt oder verlässt. Wenn ein Rollfensterfeature in Schulungspipelinen verwendet wird, wird eine genaue Punkt-in-Time-Featureberechnung für die Quelldaten mithilfe der Dauer fester Länge ausgeführt, die unmittelbar vor dem Zeitstempel eines bestimmten Ereignisses liegt. Auf diese Weise können Online-Offline-Abweichungen oder Datenverluste verhindert werden. Merkmale zum Zeitpunkt T aggregieren Ereignisse im Zeitraum von [T − Dauer, T).
class RollingWindow(TimeWindow):
    window_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
In der folgenden Tabelle sind die Parameter für ein rollierendes Fenster aufgeführt. Die Start- und Endzeiten des Fensters basieren wie folgt auf diesen Parametern:
- Startzeit:
evaluation_time - window_duration - delay(einschließlich) - Endzeitpunkt:
evaluation_time - delay(exklusiv)
| Parameter | Constraints |
|---|---|
delay (wahlweise) |
Muss ≥ 0 sein. Verschiebt das analytische Fenster rückwärts vom Bewertungszeitstempel. Nutze SourceLateness.settling_delay sie, um eine konsistente Basislinie für die Verzögerung der Quellankunft in deinem Stream zu modellieren. |
window_duration |
Muss 0 sein > |
from databricks.feature_engineering.entities import RollingWindow
from datetime import timedelta

# Look back 7 days from evaluation time
window = RollingWindow(window_duration=timedelta(days=7))
Definieren Sie ein rollierendes Fenster mit Verzögerung unter Verwendung von Code unten.
# Compute a 7-day value as of one day before the evaluation time
window = RollingWindow(
    window_duration=timedelta(days=7),
    delay=timedelta(days=1)
)
Beispiele für rollierende Fenster
window_duration=timedelta(days=7): Dadurch wird ein 7-tägiges Lookbackfenster erstellt, das zur aktuellen Auswertungszeit endet. Für eine Veranstaltung um 2:00 Uhr am Tag 7 umfasst dies alle Ereignisse von 2:00 Uhr am Tag 0 bis (aber nicht einschließlich) 2:00 Uhr am Tag 7.window_duration=timedelta(hours=1), delay=timedelta(minutes=30): Dadurch wird ein 1-Stündiges Lookbackfenster erstellt, das 30 Minuten vor der Auswertungszeit endet. Für eine Veranstaltung um 13:00 Uhr umfasst dies alle Veranstaltungen von 1:30 bis (aber nicht einschließlich) 2:30 Uhr.
Rollierendes Fenster
Für Features, die mithilfe von Sturzfenstern definiert sind, werden Aggregationen über ein vordefiniertes Fenster mit fester Länge berechnet, das durch ein Folienintervall voranschreitet, wodurch nicht überlappende Fenster erzeugt werden, die die vollständige Partitionszeit aufweisen. Daher trägt jedes Ereignis in der Quelle zu genau einem Fenster bei. Features zur zeitaggregatieren t Daten von Fenstern, die auf oder vor t (exklusiv) enden. Windows beginnt in der Unix-Epoche.
class TumblingWindow(TimeWindow):
    window_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    offset: Optional[datetime.timedelta] = None
In der folgenden Tabelle sind die Parameter für ein Sturzfenster aufgeführt.
| Parameter | Constraints |
|---|---|
window_duration |
Muss 0 sein > |
delay (wahlweise) |
Muss ≥ 0 sein. Verschiebt das analytische Fenster rückwärts vom Bewertungszeitstempel. |
offset (wahlweise) |
Muss ≥ 0 sein und kürzer als window_duration. Verschiebt die Fenstergrenzen ab Mitternacht UTC. |
from databricks.feature_engineering.entities import TumblingWindow
from datetime import timedelta

window = TumblingWindow(
    window_duration=timedelta(days=1),
    delay=timedelta(hours=2),
    offset=timedelta(hours=22),
)
Beispiel für ein Tumbling-Fenster
-
window_duration=timedelta(days=5): Dadurch werden jeweils vordefinierte Fenster mit fester Länge von 5 Tagen erstellt. Beispiel: Fenster #1 erstreckt sich über Tag 0 bis Tag 4, Fenster #2 erstreckt sich über Tag 5 bis Tag 9, Fenster #3 erstreckt sich über Tag 10 bis Tag 14 usw. Insbesondere enthält Window #1 alle Ereignisse mit Zeitstempeln, die am00:00:00.00Tag 0 bis (aber nicht einschließlich) aller Ereignisse mit Zeitstempel00:00:00.00am Tag 5 beginnen. Jedes Ereignis gehört zu genau einem Fenster.
Gleitendes Fenster
Für Merkmale, die mit gleitenden Fenstern definiert sind, werden Aggregationen über ein Fenster berechnet, das um ein Schiebeintervall voranschreitet. Ein gleitendes Fenster kann entweder eine feste Dauer oder eine Lebensdauer haben. Fenster mit fester Dauer überlappen sich, sodass jedes Quellereignis zur Feature-Aggregation für mehrere Fenster beitragen kann. Ein Lebenszeitfenster umfasst alle Quellereignisse vor dem Ende des Fensters. Features zur zeitaggregatieren t Daten von Fenstern, die auf oder vor t (exklusiv) enden. Windows sind auf die Unix-Epoche ausgerichtet.
class SlidingWindow(TimeWindow):
    window_duration: Optional[datetime.timedelta]
    slide_duration: datetime.timedelta
    delay: Optional[datetime.timedelta] = None
    offset: Optional[datetime.timedelta] = None
In der folgenden Tabelle sind die Parameter für ein Gleitfenster aufgeführt.
| Parameter | Constraints |
|---|---|
window_duration |
Muss für ein Fenster mit fester Dauer positiv sein. Auf ein lebenslanges Zeitfenster eingestellt None . |
slide_duration |
Muss positiv sein. Für ein Fenster mit fester Dauer muss es außerdem kürzer als window_durationsein. |
delay (wahlweise) |
Muss ≥ 0 sein. Verschiebt das analytische Fenster rückwärts vom Bewertungszeitstempel. |
offset (wahlweise) |
Muss ≥ 0 sein und kürzer als slide_duration. Verschiebt die Fenstergrenzen ab Mitternacht UTC. |
from databricks.feature_engineering.entities import SlidingWindow
from datetime import timedelta

window = SlidingWindow(
    window_duration=timedelta(days=7),
    slide_duration=timedelta(days=1),
    delay=timedelta(hours=2),
    offset=timedelta(hours=22),
)
Beispiel für gleitendes Fenster
-
window_duration=timedelta(days=5), slide_duration=timedelta(days=1): Dadurch werden überlappende 5-Tage-Fenster erstellt, die jedes Mal um 1 Tag voranschreiten. Beispiel: Fenster Nr. 1 erstreckt sich über Tag 0 bis Tag 4, Fenster #2 erstreckt sich über Tag 1 bis Tag 5, Fenster #3 erstreckt sich über Tag 2 bis Tag 6 usw. Jedes Fenster enthält Ereignisse vom00:00:00.00Starttag bis zum (aber nicht einschließlich)00:00:00.00am Endtag. Da sich Fenster überlappen, kann ein einzelnes Ereignis zu mehreren Fenstern gehören (in diesem Beispiel gehört jedes Ereignis zu bis zu 5 verschiedenen Fenstern).
Lebenszeitfenster
Stellen Sie ein, window_duration=None um ein Lebenszeitfenster zu erstellen. An jeder Rutschgrenze aggregiert das Merkmal alle Quellereignisse der Entität mit Zeitstempeln vor dieser Grenze. Zum Beispiel erzeugt eine Ein-Tages-Folie einmal pro Tag einen kumulativen Wert.
Lebenszeitfenster werden nur von SlidingWindowunterstützt.
RollingWindow und TumblingWindow erfordern ein endliches window_duration.
Note
Lebenszeitfenster erfordern eine databricks-feature-engineering Client-Version, die Workspace-Enablement unterstützt window_duration=None . Frühere Client-Versionen unterstützen diese Syntax nicht.
from datetime import timedelta
from databricks.feature_engineering.entities import (
    AggregationFunction,
    DeltaTableSource,
    Feature,
    SlidingWindow,
    Sum,
)

lifetime_spend = Feature(
    source=DeltaTableSource(
        catalog_name="main",
        schema_name="store",
        table_name="transactions",
    ),
    entity=["user_id"],
    timeseries_column="transaction_time",
    function=AggregationFunction(
        Sum(input="amount"),
        SlidingWindow(
            window_duration=None,
            slide_duration=timedelta(days=1),
        ),
    ),
    name="lifetime_spend",
)
Sägezahnfenster
Important
SawtoothWindow ist in der Beta-Phase.
Ein Sägezahnfenster ist eine Aggregation, die hochgradig aktuelle Updates aktueller Ereignisse zusammen mit der täglichen Verdichtung historischer Daten unterstützt. Seine hintere (ältere) Kante schreitet in festen, täglichen Schritten voran, während die vordere (jüngste) Kante mit den neuesten Ereignissen aktuell bleibt, sodass die effektive Fensterlänge im Laufe des Tages "sägt". Der Großteil des Fensters wird aus Daten in der Aufnahmetabelle des Streams bereitgestellt, und nur die beiden letzten Tage stammen aus dem Live-Stream. Dies ist ein Kompromiss, der langfristige Fenster effizient berechnet (auf Jahre skalierend) und gleichzeitig auf frische Updates reagiert.
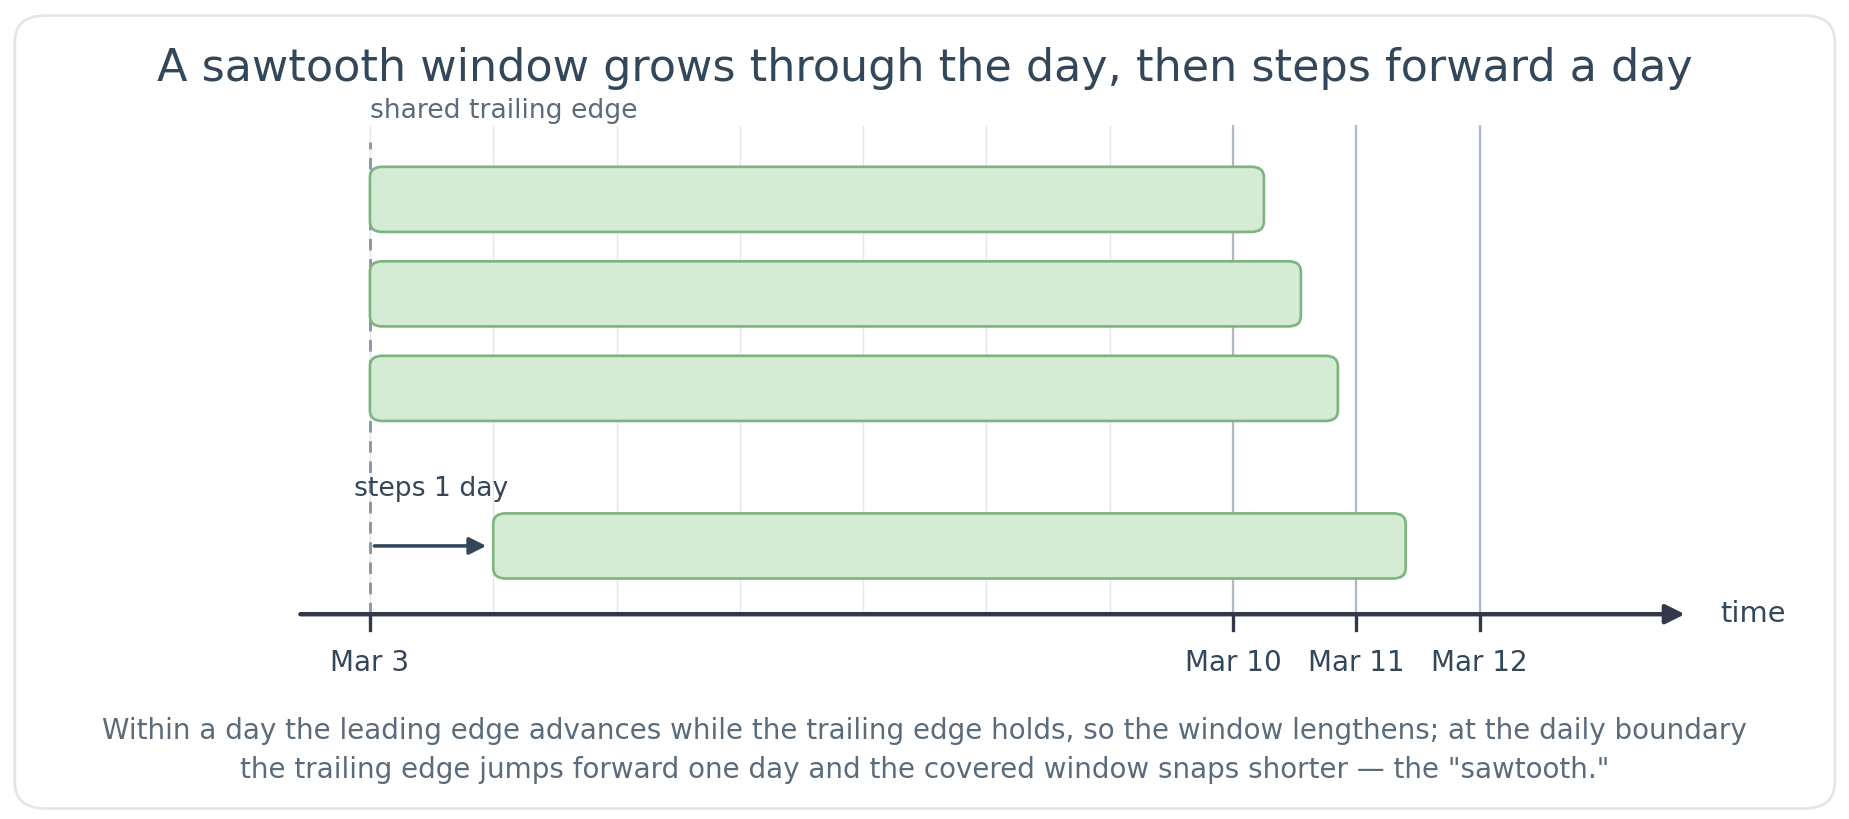
Sägezahnfenster entstehen auf einem hybriden Batch- und Strömungspfad. Eine Batch-Pipeline hält den Großteil des Fensters aufrecht, während eine Streaming-Pipeline die aktuellsten Daten in Echtzeit frisch hält. Die beiden werden beim Lesen zusammengeführt, sodass es für das Modell oder den Kunden eine einzige Funktion ist.
Da der historische Teil des Fensters durch die Batch-Pipeline berechnet wird, ist ein Sägezahn-Feature kurz nach Materialisierungsbeginn einsatzbereit, selbst wenn das Fenster Monate oder Jahre umfasst. Ein rollendes Fenster ist erst fertig, wenn die volle Fensterdauer abgelaufen ist. Das Minimum window_duration muss länger als zwei Tage betragen (die vorgeschriebene untere Grenze), aber Sägezahnfenster werden für längere Dauern als 7 Tage empfohlen; für kürzere Fenster verwenden Sie stattdessen ein Rollfenster .
Note
Ein Sägezahn-Merkmal beruht auf bereits vorhandener Geschichte. Die Aufnahmetabelle des Stroms muss Daten enthalten, die mindestens die gesamte Fensterdauer abdecken, sonst ist das berechnete Fenster unvollständig. Bevor zwei volle Tage vergangen sind, spiegelt die Funktion nur die bisher materialisierten Daten wider. Es wird nicht empfohlen, den Film in Produktion zu zeigen, bis zwei volle Tage vergangen sind. Eine Aggregation über einem leeren Fenster gibt 0 für Sum und Count, und null für Avg, Min, , FirstMax, Last, VarPop, VarSamp, StddevPop, und StddevSampzurück.
Um festzustellen, ob ein Sägezahn-Feature bereit ist, öffnen Sie die Feature-Ansicht im Katalog-Explorer. Im Bereich Materialisierte Merkmale ist das Batch-Backfill abgeschlossen, sobald die letzte Materialisierungszeit des Features voranschreitet und sein Status Erfolg zeigt. Der Strömungsteil wird durch eine deklarative Lakeflow-Pipeline materialisiert. Nachdem die Feature View die Validierung bestanden hat, wird das materialisierte Feature mit dieser Pipeline verknüpft, wo man den Laufstatus überwachen kann.
Sägezahnfenster benötigen ein StreamSource und werden mit StreamingMode.
class SawtoothWindow(TimeWindow):
    window_duration: datetime.timedelta
Die Kanten eines Sägezahnfensters bewegen sich anders als die eines rollenden Fensters: Die Vorderkante verfolgt das neueste Ereignis, während die Hinterkante einmal pro Tag statt kontinuierlich vorrückt. Jeden Tag an einem festen Cutoff um 18:00 UTC tritt die hintere Kante zur UTC-Mitternachtsgrenze des Tages vor. Dadurch ist das effektive Zeitfenster etwas länger window_duration und wächst über den Tag hinweg, bevor es an einem Tag beim nächsten Cutoff wieder zurückspringt. Training und Serving verwenden die gleiche 18:00 UTC-Grenze, sodass Offline-Training und Online-Dienst konstant bleiben.
| Parameter | Constraints |
|---|---|
window_duration |
Muss länger als zwei Tage sein. Eine Dauer, die nicht eine ganze Anzahl von Tagen beträgt (zum Beispiel timedelta(days=3, minutes=15)), ist erlaubt, aber das Fenster wird weiterhin täglich granularisiert. |
Sägezahnfenster unterstützen die Sum, Avg, Count, Min, , Max, FirstVarSampVarPopStddevPopLast, undStddevSamp die Aggregationsfunktionen.
Beispiel mit einem Sägezahnfenster
Das folgende Beispiel zeigt eine 7-tägige Zählung der Transaktionen eines Nutzers. Die Spitze verfolgt das aktuelle Ereignis, während die Hinterkante Tag für Tag vorwärts tritt. Für Veranstaltungen am 10. März reicht das Zeitfenster etwa bis zum 3. März zurück. Im Verlauf des 10. März rückt die Vorderkante weiter vor, während die Hinterkante hält, sodass die überdachte Spannweite wächst. Dann, zu Beginn des 11. März, steigt die Hinterkante etwa auf den 4. März an. Das effektive Zeitfenster ist immer etwas länger als sieben Tage. Die beiden letzten Tage werden vom Live-Stream bedient, die ersten Tage vom Aufnahmetisch des Streams.
from databricks.feature_engineering.entities import SawtoothWindow
from datetime import timedelta

# 7-day window kept continuously fresh with streaming data
window = SawtoothWindow(window_duration=timedelta(days=7))
Grenzen von Sägezahnfenstern
- Der
delayParameter wird nicht unterstützt. -
SourceLateness.settling_delaywird nicht unterstützt. - Aggregationsfunktionen außer , , , , ,
FirstMax,StddevPopVarPopLastVarSampundStddevSampwerden nicht unterstützt (zum BeispielApproxCountDistinct,ApproxPercentile,FirstN, ,LastN,FirstDistinct, und ).LastDistinctMinCountAvgSum - Sägezahnfenster benötigen ein
StreamSource. ADeltaTableSourcewird nicht unterstützt.
Materialisierungsauslöser
Löst die Steuerung aus, wenn eine Materialisierungspipeline ausgeführt wird. Der Triggertyp hängt vom Featuretyp ab.
CronSchedule
Verwendung CronSchedule für Batch-Aggregationsfunktionen. Standardmäßig leitet Azure Databricks einen Zeitplan aus dem Aggregationsfenster ab. Ein abgeleiteter Zeitplan berücksichtigt die Fensterperiode, das Fenster delay und offset, sowie die Quelle, settling_delay sodass ein Lauf kein Fenster veröffentlicht, bevor die Quelldaten voraussichtlich vollständig sind. Abgeleitete Zeitpläne unterstützen Tumbling und Sliding Windows.
Um einen abgeleiteten Zeitplan anzufordern, lassen Sie den cron-Ausdruck weg.
CronSchedule() und die explizite CronSchedule(mode=CronScheduleMode.DERIVED) Form sind äquivalent:
from databricks.feature_engineering.entities import (
    CronSchedule,
    CronScheduleMode,
)

trigger = CronSchedule(mode=CronScheduleMode.DERIVED)
Setzen quartz_cron_expression Sie nicht mit CronScheduleMode.DERIVED. Wenn Sie die materialisierte Funktion abrufen, kann der zurückgegebene Zeitplan den von Azure Databricks berechneten Cron-Ausdruck enthalten.
Um den Zeitplan direkt zu steuern, bereite einen Quarz-Cron-Ausdruck an.
CronScheduleMode.MANUAL wird abgeleitet, wenn man einen Ausdruck angibt:
from databricks.feature_engineering.entities import CronSchedule

trigger = CronSchedule(
    quartz_cron_expression="0 0 * * * ?",  # Hourly
    timezone_id="UTC",
)
TableTrigger
Verwendung TableTrigger für ColumnSelection Features oder Aggregationsfeatures (AggregationFunction) mit Unterstützung von .DeltaTableSource Die Pipeline wird ausgeführt, wenn die upstream-Delta-Tabelle einen neuen Commit empfängt.
Bei Aggregationsfunktionen wird die Pipeline gedrosselt, sodass sie nicht bei jedem Commit läuft. Die Pipeline läuft höchstens einmal pro Hälfte der Fensterlänge des Features, aber nie öfter als alle 5 Minuten. Zum Beispiel läuft ein Feature mit einem Drehfenster von einer Stunde höchstens alle 30 Minuten, oder ein Feature mit 8-Stunden-Fenster höchstens alle 4 Stunden. Die 5-Minuten-Grenze gilt, wenn die Hälfte des Fensters kleiner ist, also werden Fenster, die 10 Minuten oder weniger dauern, höchstens alle 5 Minuten geöffnet. Aggregationsfunktionen mit einem Fenster unter 5 Minuten können nicht verwendet TableTriggerwerden, verwenden Sie stattdessen einen Streaming-Trigger.
from databricks.feature_engineering.entities import TableTrigger

trigger = TableTrigger()
StreamingMode
Wird StreamingMode für Features verwendet, die von einer StreamSource. Die Pipeline wird als fortlaufende Streamingpipeline ausgeführt.
from databricks.feature_engineering import FeatureEngineeringClient
from databricks.feature_engineering.entities import (
    StreamSource, Feature, AggregationFunction, Sum,
    RollingWindow, OnlineStoreConfig, StreamingMode,
)
from datetime import timedelta

fe = FeatureEngineeringClient()

stream_source = StreamSource(full_name="my_catalog.my_schema.my_stream")

streaming_feature = fe.create_feature(
    source=stream_source,
    entity=["value.user_id"],
    timeseries_column="value.event_time",
    function=AggregationFunction(
        operator=Sum(input="value.amount"),
        time_window=RollingWindow(window_duration=timedelta(hours=1)),
    ),
    catalog_name="my_catalog",
    schema_name="my_schema",
    name="user_purchase_sum",
)

fe.materialize_features(
    features=[streaming_feature],
    online_config=OnlineStoreConfig(
        catalog_name="my_catalog",
        schema_name="my_schema",
        table_name_prefix="streaming_features_serving",
        online_store_name="feature_store_online",
    ),
    trigger=StreamingMode(),
)
Auswählen eines Triggers
Jede Funktion verwendet einen Trigger; Die Optionen nach Funktionstyp sind:
| Featuretyp | Trigger | Wenn es ausgeführt wird |
|---|---|---|
Aggregation (AggregationFunction) von DeltaTableSource |
CronSchedule |
Nach einem abgeleiteten oder manuellen Zeitplan |
Aggregation (AggregationFunction) von DeltaTableSource |
TableTrigger |
Bei jedem Quelltabellen-Commit |
ColumnSelection (von DeltaTableSource) |
TableTrigger |
Bei jedem Quelltabellen-Commit |
Features von StreamSource |
StreamingMode |
Kontinuierliches Streaming |
Features, die unterschiedliche Triggertypen in einem einzelnen materialize_features Aufruf erfordern, können nicht materialisiert werden. Führen Sie stattdessen separate Anrufe aus.