Σημείωμα
Η πρόσβαση σε αυτήν τη σελίδα απαιτεί εξουσιοδότηση. Μπορείτε να δοκιμάσετε να εισέλθετε ή να αλλάξετε καταλόγους.
Η πρόσβαση σε αυτήν τη σελίδα απαιτεί εξουσιοδότηση. Μπορείτε να δοκιμάσετε να αλλάξετε καταλόγους.
Σε αυτή την εκμάθηση, χρησιμοποιείτε σημειωματάρια με χρόνο εκτέλεσης Spark για να μετασχηματίζετε και να προετοιμάζετε ανεπεξέργαστα δεδομένα στο lakehouse σας.
Προαπαιτούμενα στοιχεία
Πριν ξεκινήσετε, πρέπει να ολοκληρώσετε τα προηγούμενα σεμινάρια αυτής της σειράς:
- Δημιουργία lakehouse
- Πρόσληψη δεδομένων στο lakehouse
- Βεβαιωθείτε ότι τα σχήματα lakehouse είναι ενεργοποιημένα στο lakehouse σας.
Προετοιμασία δεδομένων
Από τα προηγούμενα βήματα εκμάθησης, έχετε απορροφήσει ανεπεξέργαστα δεδομένα από την προέλευση στην ενότητα Αρχεία του lakehouse. Τώρα μπορείτε να μετασχηματίζετε αυτά τα δεδομένα και να τα προετοιμάζετε για τη δημιουργία πινάκων Delta.
Κάντε λήψη των σημειωματάριων από τον φάκελο Πηγαίος κώδικας εκμάθησης Lakehouse.
Στο πρόγραμμα περιήγησής σας, μεταβείτε στον χώρο εργασίας Fabric στην πύλη Fabric.
Επιλέξτε Εισαγωγή>σημειωματάριου>από αυτόν τον υπολογιστή.
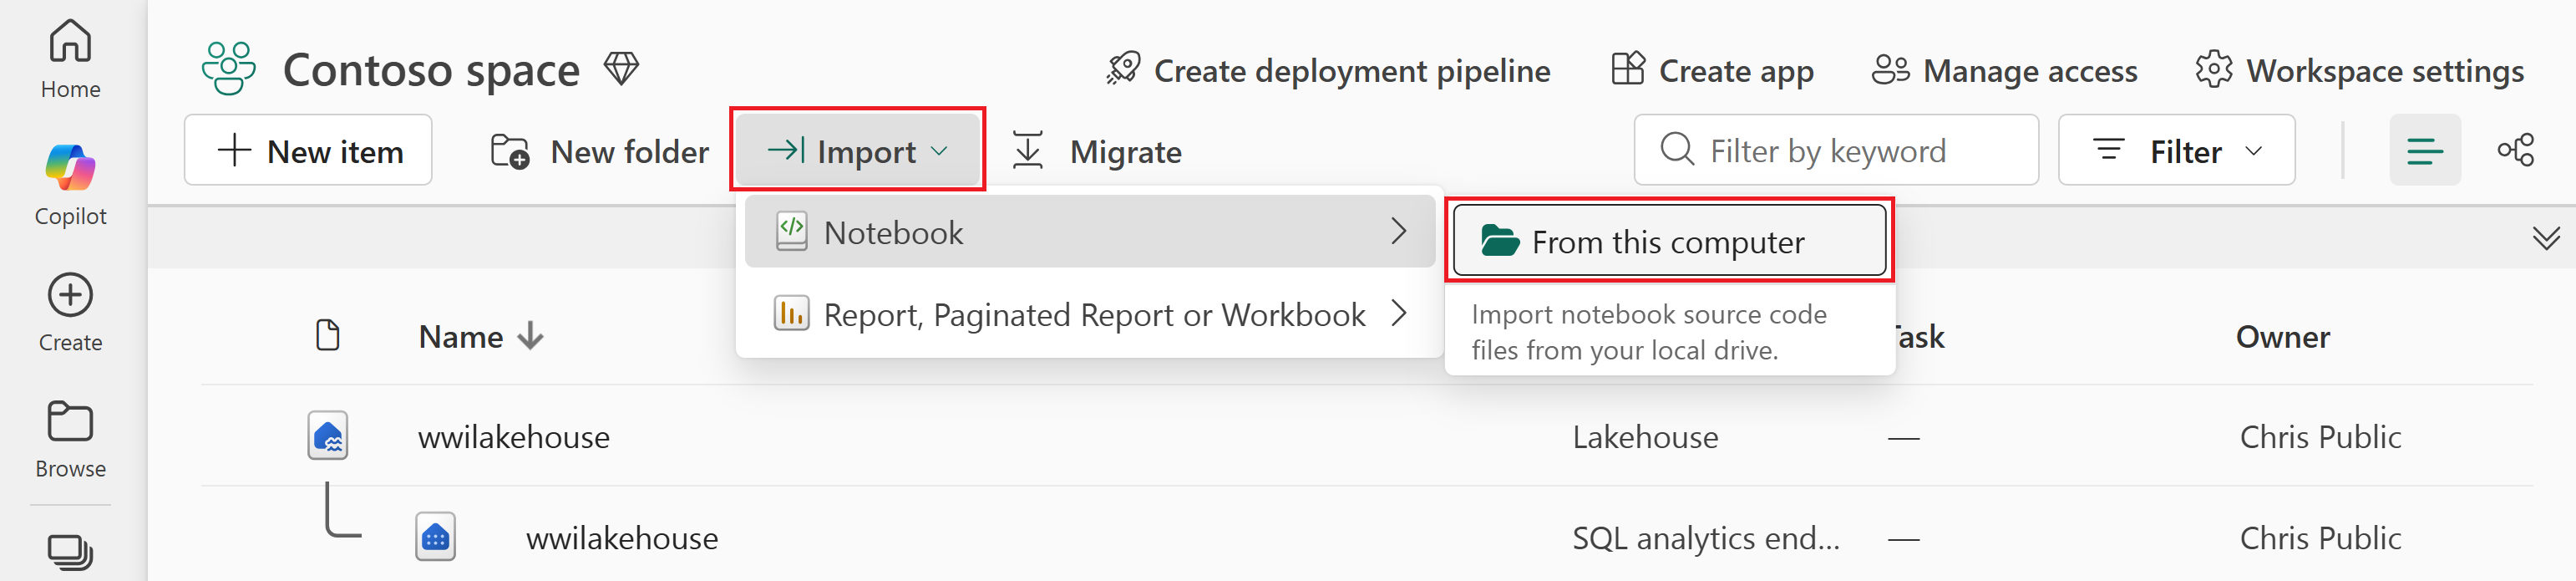
Επιλέξτε Αποστολή από το τμήμα παραθύρου Κατάσταση εισαγωγής που ανοίγει στη δεξιά πλευρά της οθόνης.
Επιλέξτε μόνο το σημειωματάριο που ταιριάζει με τη γλώσσα κωδικοποίησης που προτιμάτε.
-
PySpark (
Prepare and transform data - PySpark.ipynb) -
Spark SQL (
Prepare and transform data - Spark SQL.ipynb)
-
PySpark (
Επιλέξτε Άνοιγμα. Μια ειδοποίηση που υποδεικνύει την κατάσταση της εισαγωγής εμφανίζεται στην επάνω δεξιά γωνία του παραθύρου του προγράμματος περιήγησης.
Μετά την επιτυχή εισαγωγή, μεταβείτε στην προβολή στοιχείων του χώρου εργασίας για να επαληθεύσετε το σημειωματάριο που έχει εισαχθεί.
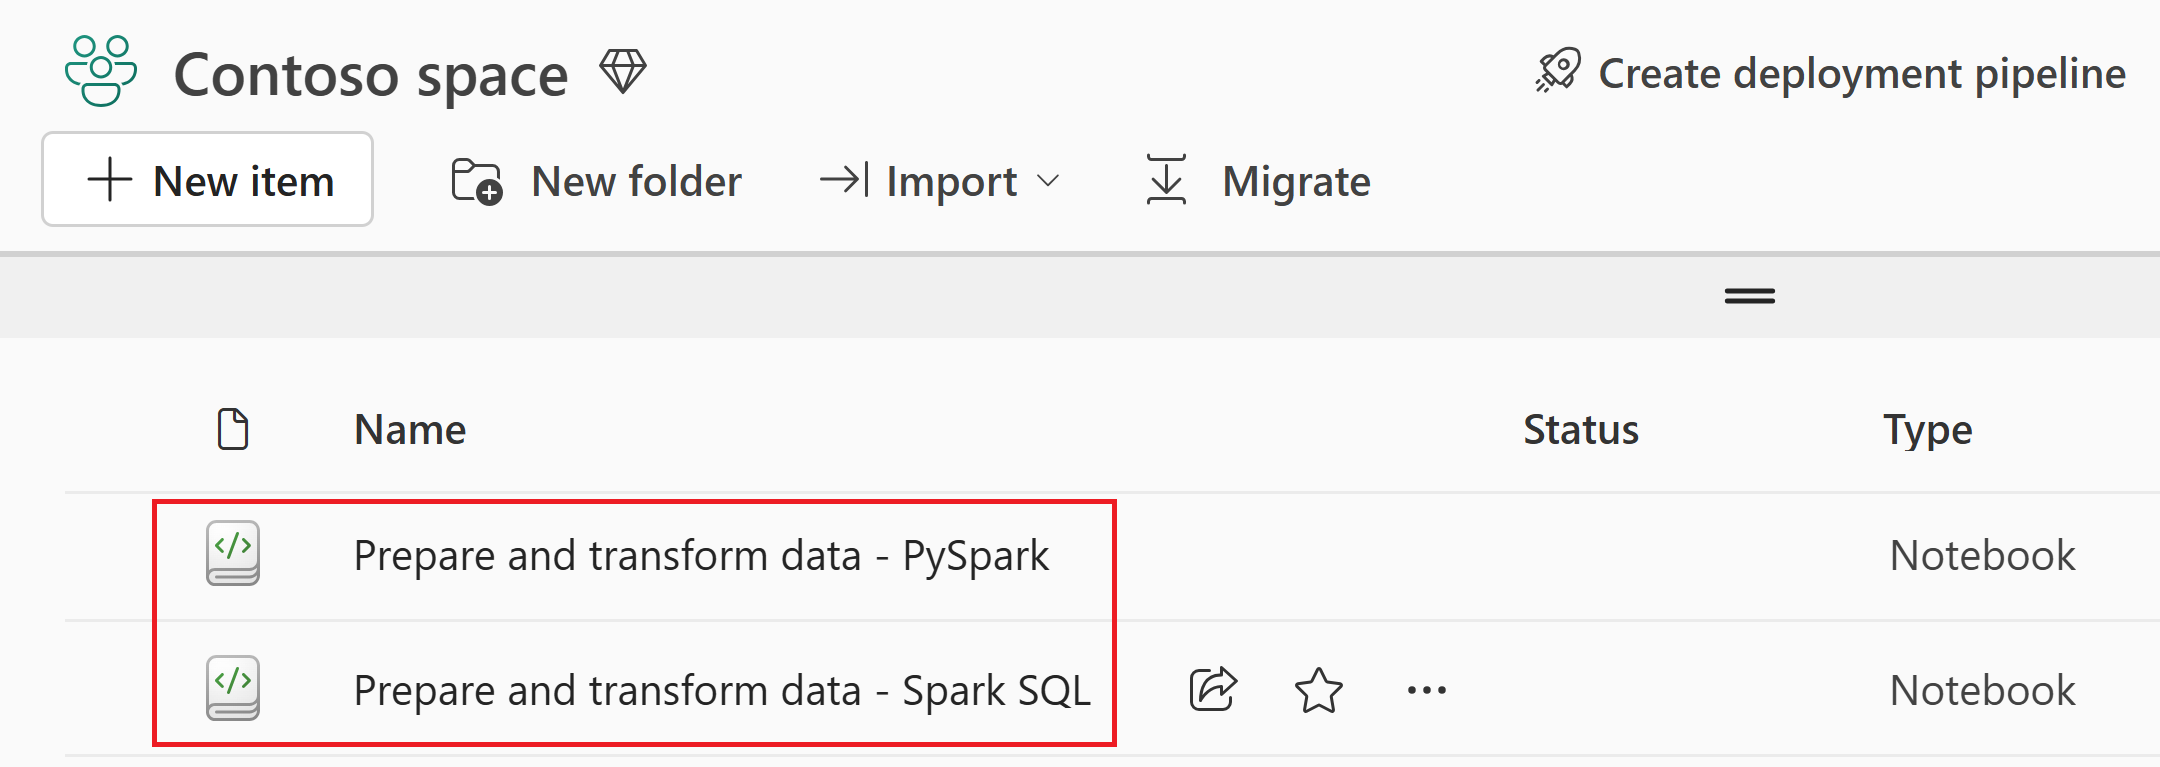
Επιλέξτε το wwilakehouse lakehouse για να το ανοίξετε, έτσι ώστε το σημειωματάριο που ανοίγετε στη συνέχεια να είναι συνδεδεμένο με αυτό.
Από το επάνω μενού περιήγησης, επιλέξτε Άνοιγμα σημειωματαρίου>Υπάρχον σημειωματάριο.
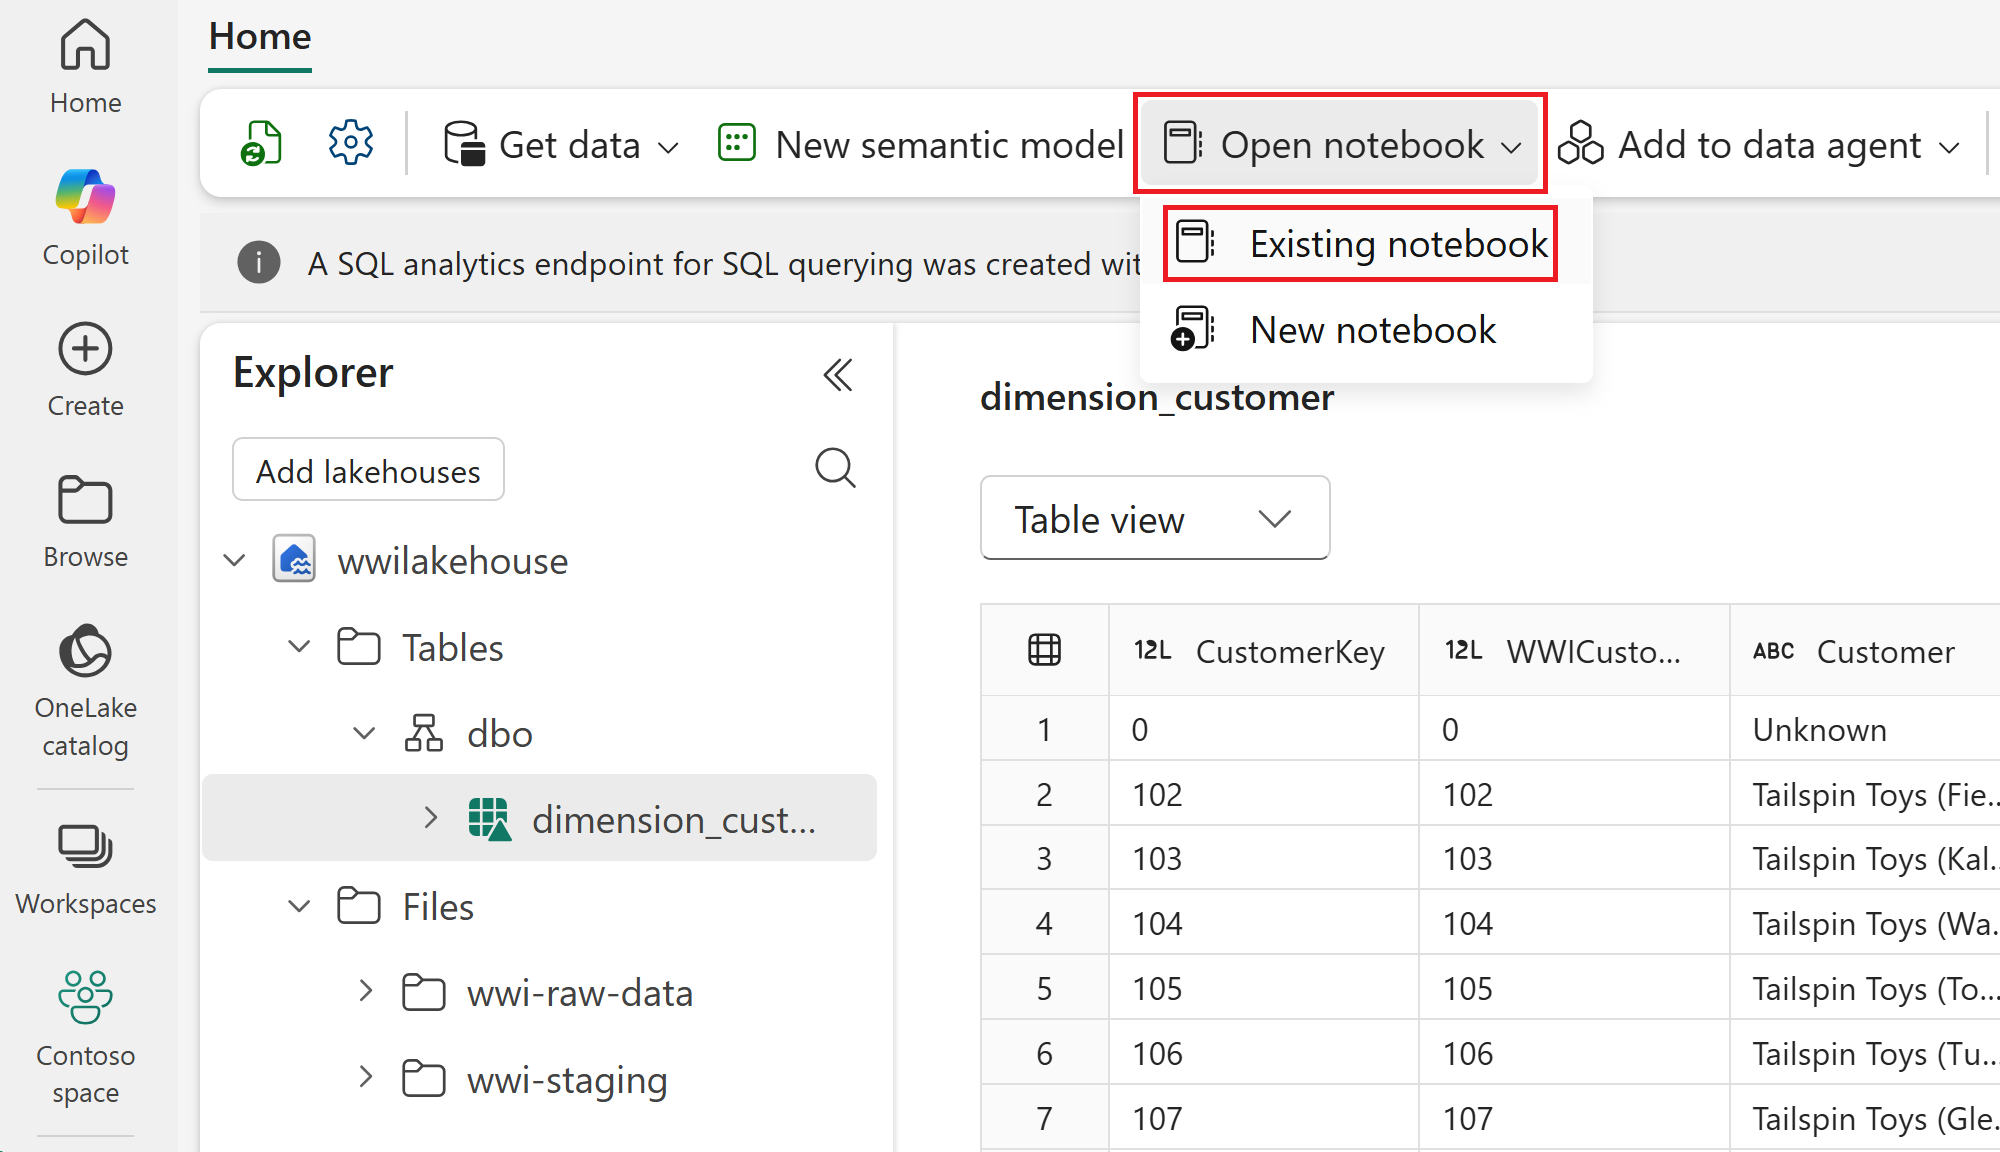
Επιλέξτε το σημειωματάριό σας που έχετε εισαγάγει για το PySpark ή το Spark SQL και επιλέξτε Άνοιγμα. Το σημειωματάριο είναι ήδη συνδεδεμένο με το ανοιχτό lakehouse σας, όπως φαίνεται στην Εξερεύνηση lakehouse.
Τώρα είστε έτοιμοι να εκτελέσετε τα κελιά σημειωματαρίου που δημιουργούν και μετασχηματίζουν τους πίνακες Delta.
Στις ακόλουθες ενότητες, εκτελέστε τα κελιά του σημειωματαρίου διαδοχικά. Για να εκτελέσετε ένα κελί, επιλέξτε το εικονίδιο Εκτέλεση που εμφανίζεται στα αριστερά του κελιού κατά την κατάδειξη. Μπορείτε επίσης να επιλέξετε Εκτέλεση όλων στην επάνω κορδέλα (Αρχική) για να εκτελέσετε όλα τα κελιά με τη σειρά.
Σημαντικό
Αυτό το εκπαιδευτικό βοήθημα απαιτεί την ενεργοποίηση των σχημάτων lakehouse. Εάν τα σχήματα δεν είναι ενεργοποιημένα, ο κώδικας σε αυτό το σεμινάριο δεν θα λειτουργεί όπως προβλέπεται.
Στο σημειωματάριο που έχει εισαχθεί, βλέπετε και τις δύο ενότητες Διαδρομή 1 και Διαδρομή 2 . Για αυτό το πρόγραμμα εκμάθησης, χρησιμοποιήστε τη Διαδρομή 1 (ενεργοποιημένα σχήματα lakehouse) και αγνοήστε τη Διαδρομή 2 (τα σχήματα lakehouse δεν είναι ενεργοποιημένα).
Δημιουργία πινάκων Delta
Σε αυτήν την ενότητα, εκτελείτε τα κελιά του σημειωματάριου για να δημιουργήσετε πίνακες Delta από τα ανεπεξέργαστα δεδομένα.
Οι πίνακες ακολουθούν ένα σχήμα αστεριού, το οποίο είναι ένα κοινό μοτίβο για την οργάνωση αναλυτικών δεδομένων:
- Ένας πίνακας γεγονότων (
fact_sale) περιέχει τα μετρήσιμα γεγονότα της επιχείρησης — σε αυτήν την περίπτωση, μεμονωμένες συναλλαγές πωλήσεων με ποσότητες, τιμές και κέρδος. -
Οι πίνακες διαστάσεων (
dimension_city,dimension_customer,dimension_date,dimension_employee,dimension_stock_item) περιέχουν τα περιγραφικά χαρακτηριστικά που δίνουν το περιβάλλον στα γεγονότα, όπως πού έγινε μια πώληση, ποιος την πραγματοποίησε και πότε.
Σε αυτήν τη σελίδα εκμάθησης, επιλέξτε την καρτέλα που ταιριάζει με το σημειωματάριο που εισαγάγατε και συνεχίστε να χρησιμοποιείτε την ίδια καρτέλα για όλα τα βήματα. Οι καρτέλες βρίσκονται σε αυτό το άρθρο, όχι στο σημειωματάριο.
Κελί 1 - Ρύθμιση παραμέτρων περιόδου λειτουργίας Spark. Αυτό το κελί ενεργοποιεί δύο δυνατότητες Fabric που βελτιστοποιούν τον τρόπο εγγραφής και ανάγνωσης δεδομένων σε επόμενα κελιά. Το V-order βελτιστοποιεί τη διάταξη του αρχείου parquet για ταχύτερες αναγνώσεις και καλύτερη συμπίεση. Το Optimize write μειώνει τον αριθμό των εγγεγραμμένων αρχείων και αυξάνει το μέγεθος του μεμονωμένου αρχείου.
Εκτελέστε αυτό το κελί και περιμένετε να τελειώσει πριν προχωρήσετε στο επόμενο βήμα.
spark.conf.set("spark.sql.parquet.vorder.enabled", "true") spark.conf.set("spark.microsoft.delta.optimizeWrite.enabled", "true") spark.conf.set("spark.microsoft.delta.optimizeWrite.binSize", "1073741824")Κελί 2 - Γεγονός - Πώληση. Αυτό το κελί διαβάζει ακατέργαστα δεδομένα παρκέ από
Files/wwi-raw-data/full/fact_sale_1y_fullτο , προσθέτει στήλες τμήματος ημερομηνίας (Έτος, Τρίμηνο και Μήνας) και γράφειfact_saleως πίνακα Δέλτα διαμερισμένο κατά Έτος και Τρίμηνο.Εκτελέστε αυτό το κελί και περιμένετε να τελειώσει πριν προχωρήσετε στο επόμενο βήμα.
from pyspark.sql.functions import col, year, month, quarter table_name = 'fact_sale' df = spark.read.format("parquet").load('Files/wwi-raw-data/full/fact_sale_1y_full') df = df.withColumn('Year', year(col("InvoiceDateKey"))) df = df.withColumn('Quarter', quarter(col("InvoiceDateKey"))) df = df.withColumn('Month', month(col("InvoiceDateKey"))) df.write.mode("overwrite").format("delta").partitionBy("Year","Quarter").save("Tables/dbo/" + table_name)Κελί 3 - Διαστάσεις. Αυτό το κελί διαβάζει τα σύνολα δεδομένων παρκέ πέντε διαστάσεων και τα γράφει ως πίνακες Delta (, , , , και ) κάτω από
dimension_citydimension_customer.dimension_datedimension_employeedimension_stock_itemTables/dbo/...Εκτελέστε αυτό το κελί και περιμένετε να τελειώσει πριν προχωρήσετε στο επόμενο βήμα.
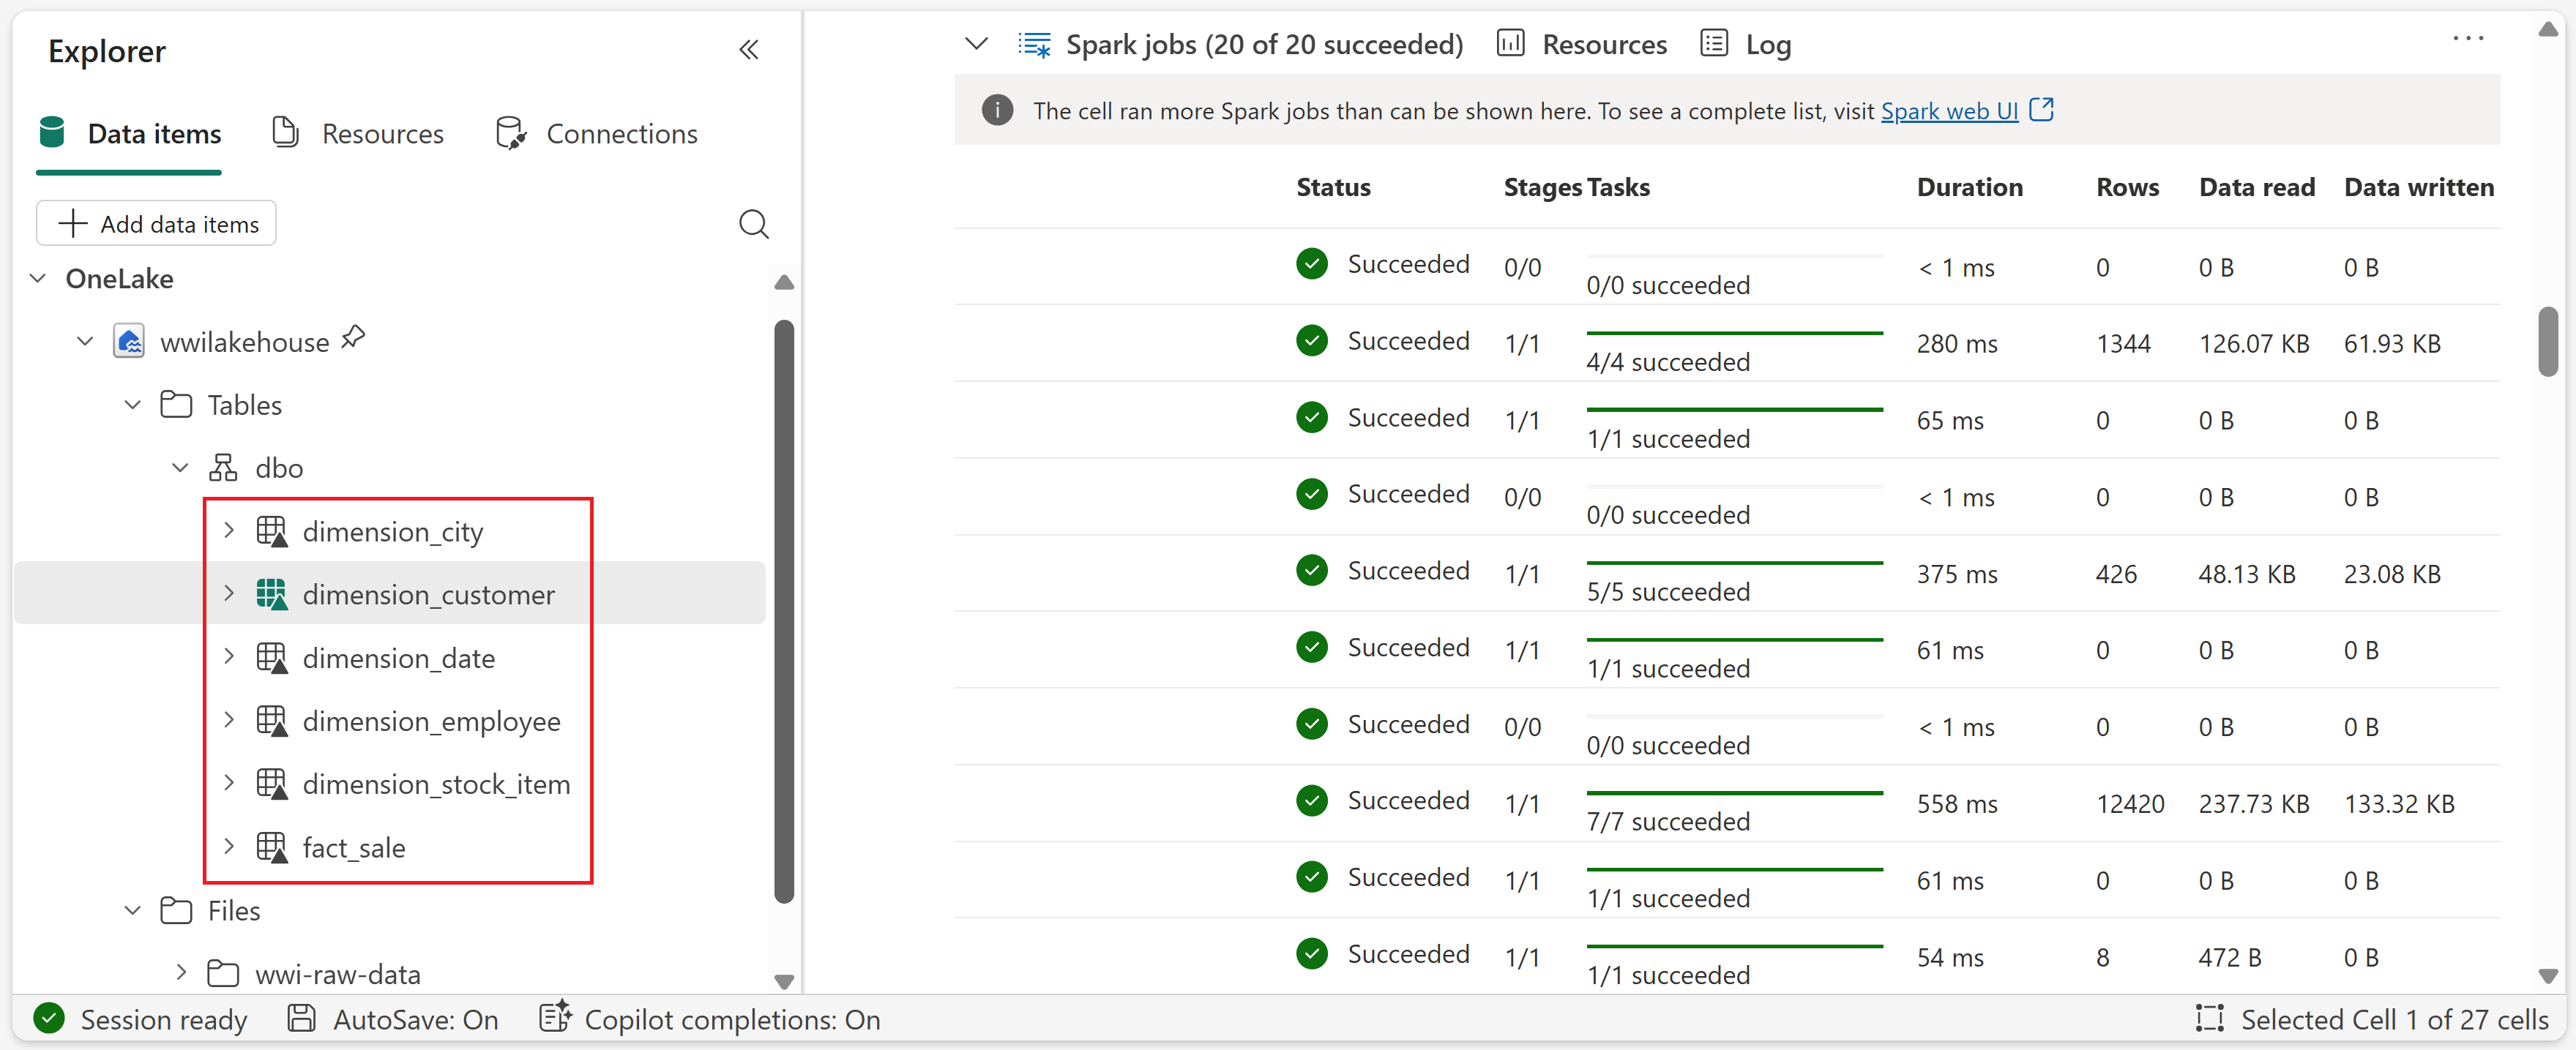
def loadFullDataFromSource(table_name): df = spark.read.format("parquet").load('Files/wwi-raw-data/full/' + table_name) df = df.drop("Photo") df.write.mode("overwrite").format("delta").save("Tables/dbo/" + table_name) full_tables = [ 'dimension_city', 'dimension_customer', 'dimension_date', 'dimension_employee', 'dimension_stock_item' ] for table in full_tables: loadFullDataFromSource(table)Για να επικυρώσετε τους πίνακες που δημιουργήθηκαν, κάντε δεξί κλικ στο wwilakehouse lakehouse στον εξερευνητή και, στη συνέχεια, επιλέξτε Ανανέωση. Εμφανίζονται οι πίνακες.
Μετασχηματισμός δεδομένων για επιχειρηματικές συγκεντρωτικές τιμές
Σε αυτήν την ενότητα, συνεχίζετε στο ίδιο σημειωματάριο και εκτελείτε τα επόμενα κελιά για να δημιουργήσετε συγκεντρωτικούς πίνακες από τους πίνακες Delta που δημιουργήσατε στην προηγούμενη ενότητα.
Βεβαιωθείτε ότι το σημειωματάριο εξακολουθεί να είναι συνδεδεμένο με το wwilakehouse.
Κελί 4 - Φόρτωση πινάκων προέλευσης για μετασχηματισμό (μόνο PySpark). Εάν χρησιμοποιείτε το σημειωματάριο PySpark, εκτελέστε αυτό το κελί για να φορτώσετε πίνακες Delta σε πλαίσια δεδομένων για τα βήματα συνάθροισης που ακολουθούν.
Εκτελέστε αυτό το κελί και περιμένετε να τελειώσει πριν προχωρήσετε στο επόμενο βήμα.
df_fact_sale = spark.read.format("delta").load("Tables/dbo/fact_sale") df_dimension_date = spark.read.format("delta").load("Tables/dbo/dimension_date") df_dimension_city = spark.read.format("delta").load("Tables/dbo/dimension_city")Κελί 5 - Δημιουργία
aggregate_sale_by_date_city. Αυτό το κελί ενώνει δεδομένα πωλήσεων, ημερομηνίας και πόλης και, στη συνέχεια, δημιουργεί τον συγκεντρωτικό πίνακα σε επίπεδο πόλης.Εκτελέστε αυτό το κελί και περιμένετε να τελειώσει πριν προχωρήσετε στο επόμενο βήμα.
sale_by_date_city = ( df_fact_sale.alias("sale") .join(df_dimension_date.alias("date"), df_fact_sale.InvoiceDateKey == df_dimension_date.Date, "inner") .join(df_dimension_city.alias("city"), df_fact_sale.CityKey == df_dimension_city.CityKey, "inner") .select("date.Date", "date.CalendarMonthLabel", "date.Day", "date.ShortMonth", "date.CalendarYear", "city.City", "city.StateProvince", "city.SalesTerritory", "sale.TotalExcludingTax", "sale.TaxAmount", "sale.TotalIncludingTax", "sale.Profit") .groupBy("date.Date", "date.CalendarMonthLabel", "date.Day", "date.ShortMonth", "date.CalendarYear", "city.City", "city.StateProvince", "city.SalesTerritory") .sum("sale.TotalExcludingTax", "sale.TaxAmount", "sale.TotalIncludingTax", "sale.Profit") .withColumnRenamed("sum(TotalExcludingTax)", "SumOfTotalExcludingTax") .withColumnRenamed("sum(TaxAmount)", "SumOfTaxAmount") .withColumnRenamed("sum(TotalIncludingTax)", "SumOfTotalIncludingTax") .withColumnRenamed("sum(Profit)", "SumOfProfit") .orderBy("date.Date", "city.StateProvince", "city.City") ) sale_by_date_city.write.mode("overwrite").format("delta").option("overwriteSchema", "true").save("Tables/dbo/aggregate_sale_by_date_city")Κελί 6 - Δημιουργία
aggregate_sale_by_date_employee. Αυτό το κελί ενώνει δεδομένα πωλήσεων, ημερομηνιών και υπαλλήλων και, στη συνέχεια, δημιουργεί τον συγκεντρωτικό πίνακα σε επίπεδο υπαλλήλου.Εκτελέστε αυτό το κελί και περιμένετε να τελειώσει πριν προχωρήσετε στο επόμενο βήμα.
spark.sql(""" CREATE OR REPLACE TEMPORARY VIEW sale_by_date_employee AS SELECT DD.Date, DD.CalendarMonthLabel , DD.Day, DD.ShortMonth Month, CalendarYear Year , DE.PreferredName, DE.Employee , SUM(FS.TotalExcludingTax) SumOfTotalExcludingTax , SUM(FS.TaxAmount) SumOfTaxAmount , SUM(FS.TotalIncludingTax) SumOfTotalIncludingTax , SUM(FS.Profit) SumOfProfit FROM delta.`Tables/dbo/fact_sale` FS INNER JOIN delta.`Tables/dbo/dimension_date` DD ON FS.InvoiceDateKey = DD.Date INNER JOIN delta.`Tables/dbo/dimension_employee` DE ON FS.SalespersonKey = DE.EmployeeKey GROUP BY DD.Date, DD.CalendarMonthLabel, DD.Day, DD.ShortMonth, DD.CalendarYear, DE.PreferredName, DE.Employee ORDER BY DD.Date ASC, DE.PreferredName ASC, DE.Employee ASC """) sale_by_date_employee = spark.sql("SELECT * FROM sale_by_date_employee") sale_by_date_employee.write.mode("overwrite").format("delta").option("overwriteSchema", "true").save("Tables/dbo/aggregate_sale_by_date_employee")Για να επικυρώσετε τους πίνακες που δημιουργήθηκαν, κάντε δεξί κλικ στο wwilakehouse lakehouse στον εξερευνητή και, στη συνέχεια, επιλέξτε Ανανέωση. Εμφανίζονται οι πίνακες συγκεντρωτικών αποτελεσμάτων.
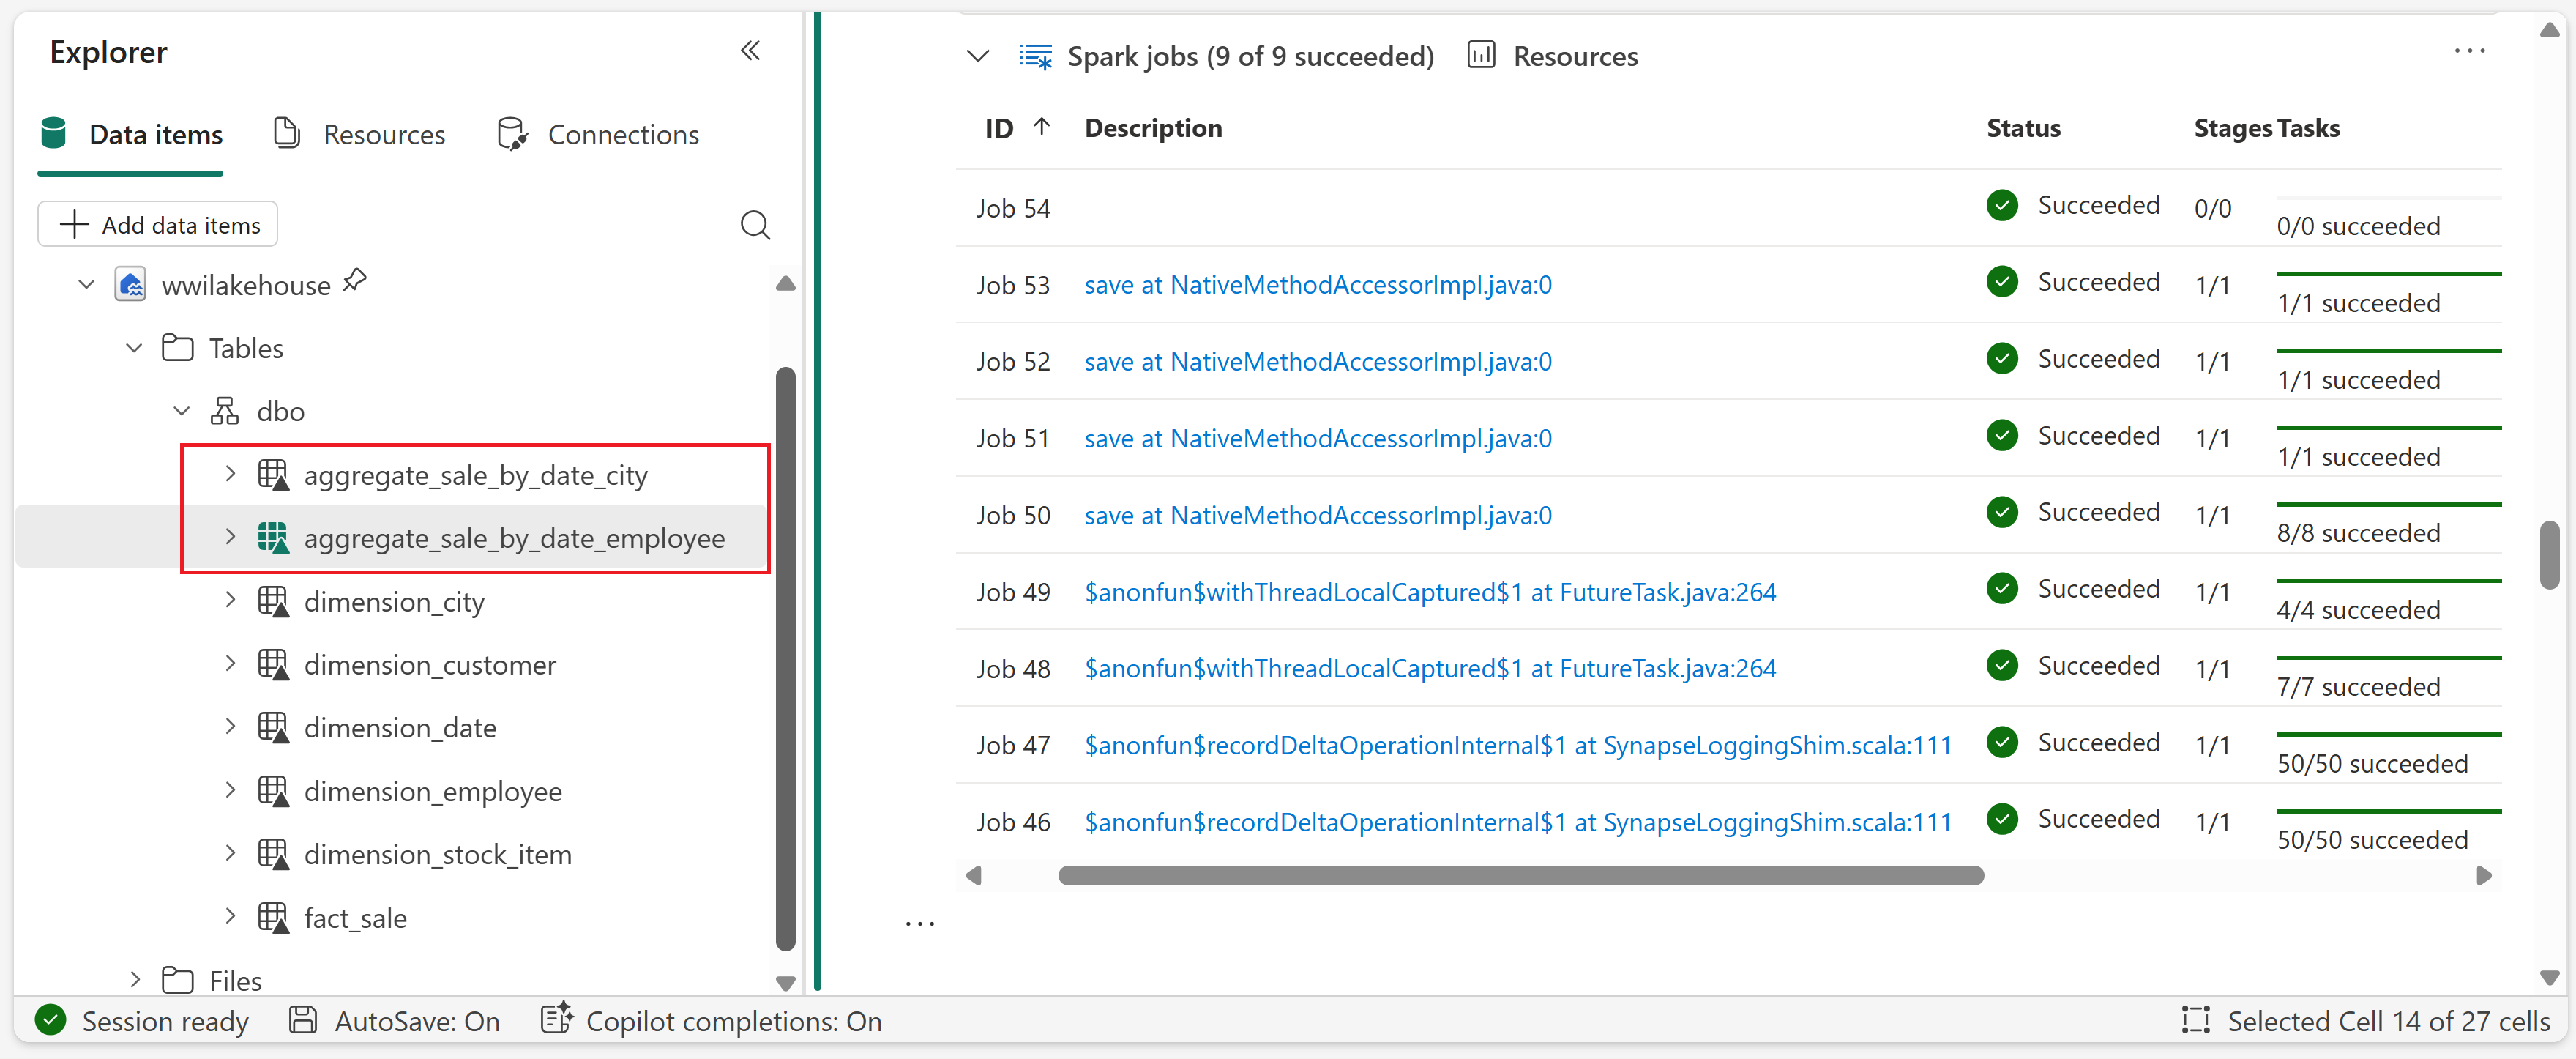
Αυτό το σεμινάριο γράφει δεδομένα ως αρχεία Delta Lake. Το Fabric εντοπίζει και καταχωρεί αυτόματα αυτούς τους πίνακες στο metastore, επομένως δεν χρειάζεται να εκτελείτε ξεχωριστές CREATE TABLE δηλώσεις.