Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
Note
Azure AI Keresés a Azure portálon, REST API-kon és Azure SDK-k keresztül érhető el. Emellett a Foundry IQ-t is támogatja, amely a vállalati tartalmakat újrafelhasználható, engedélytudatos tudásbázisokká alakítja át az Microsoft Foundry portálon található ügynökök számára.
Ebben az oktatóanyagban egy multimodális indexelő folyamatot fog létrehozni, amely az alábbi feladatokat hajtja végre:
- Szöveg és képek kinyerése és felbontása
- Szöveg és képek vektorizálása hasonlósági kereséshez
- Körülvágott képek küldése egy tudástárba az alkalmazás általi lekéréshez
Ez az oktatóanyag több készségkészletet mutat be egymás mellett, hogy bemutassa a multimodális tartalmak kinyerésének, darabolásának és vektorizálásának különböző módjait. A dokumentum kinyerési ésdokumentumelrendezési készségét használja a tartalom kinyerésére.
Jótanács
Új képességkészletek esetén a Azure Tartalomértés képesség ajánlott. Ez a képesség szemantikai adattömböket, mesterséges intelligenciával létrehozott képleírásokat és továbbfejlesztett dokumentumbe ágyazott táblázatkiemelést biztosít egyetlen képességben. A kezdéshez tekintse meg a(z) tartalom darabolása és vektorizálása az Azure Content Understanding-készséggel.
Előfeltételek
Az Azure AI Keresés alapszintű vagy magasabb tarifacsomagban, ha a mintaadatokat szeretné használni. Felügyelt identitás konfigurálása a modellekhez és adatokhoz való szerepköralapú hozzáféréshez.
Azure Storage, mintaadatok tárolására és tudástár létrehozására.
Az Microsoft Foundry-erőforrás, amely Foundry modelleket és API-kat biztosít. Ha Azure AI Képfelismerés multimodális szolgáltatást használ, válasszon egyet a Microsoft Foundry-erőforrás egyik támogatott régiójából .
Visual Studio CodeREST-ügyféllel vagy Python-bővítménnyel. Ha még nem telepítette a Python megfelelő verzióját, kövesse a VS Code Python-oktatóanyag utasításait.
A multimodális indexelés olyan készségekkel valósul meg, amelyek AI-modelleket és API-kat hívnak meg egy indexelő folyamatban. A modell előfeltételei az egyes feladatokhoz választott készségektől függően változnak.
Jótanács
Ha az ingyenes szinten szeretné elvégezni ezt az oktatóanyagot, használjon kisebb dokumentumot kevesebb képpel. Ez az oktatóanyag csak Öntödei modelleket használ, de egyéni képességeket is létrehozhat más modellek használatához.
Hozzáférés konfigurálása
Mielőtt hozzákezdene, győződjön meg arról, hogy rendelkezik hozzáféréssel a tartalomhoz és a műveletekhez az Azure AI Keresésben. Ez a rövid útmutató a Microsoft Entra-azonosítót használja hitelesítéshez és szerepköralapú hozzáféréshez az engedélyezéshez. Szerepkörök hozzárendeléséhez tulajdonosnak vagy felhasználói hozzáférés-rendszergazdának kell lennie. Ha a szerepkörök nem megvalósíthatók, használja inkább a kulcsalapú hitelesítést .
Az ajánlott szerepköralapú hozzáférés konfigurálása:
Engedélyezze a szerepköralapú hozzáférést a keresési szolgáltatáshoz.
Rendelje hozzá a következő szerepköröket a felhasználói fiókjához.
Keresési szolgáltatás közreműködője
Keresési index adatszolgáltatója
Keresési index adatolvasó
Végpont lekérése
Minden Azure AI Keresés-szolgáltatás rendelkezik egy végponttal, amely egy egyedi URL-cím, amely azonosítja és hálózati hozzáférést biztosít a szolgáltatáshoz. Egy későbbi szakaszban ezt a végpontot adja meg, hogy programozott módon csatlakozzon a keresési szolgáltatáshoz.
A végpont lekérése:
Nyissa meg a keresési szolgáltatást az Azure Portalon.
A bal oldali panelen válassza az Áttekintés lehetőséget.
Jegyezze fel a végpontot, amelynek így kell kinéznie
https://my-service.search.windows.net.
Adatok előkészítése
A mintaadatok egy 36 oldalas PDF-dokumentum, amely gazdag vizuális tartalmakat, például diagramokat, infografikákat és beolvasott oldalakat egyesít az eredeti szöveggel. Az Azure Storage biztosítja a mintaadatokat, és üzemelteti a tudástárat. A keresési szolgáltatás által felügyelt identitásnak a következőre van szüksége:
Olvassa el az Azure Storage-hoz való hozzáférést a mintaadatok lekéréséhez.
Írási jogosultság a tudásbázis létrehozásához. A keresési szolgáltatás létrehoz egy tárolót a körülvágott képekhez a képességkészlet feldolgozása során, egy környezeti változóban megadott név használatával.
Kövesse az alábbi lépéseket a mintaadatok beállításához.
Töltse le a következő PDF-mintafájlt: sustainable-ai-pdf
Jelentkezzen be a Azure portalra.
Az Azure Storage-ban hozzon létre egy sustainable-ai-pdf nevű új tárolót.
Szerepkörök hozzárendelése a keresési szolgáltatás által felügyelt identitáshoz:
Storage Blob Data Reader az adatok lekéréséhez
Storage Blob Data Contributor és Storage Table Data Contributor a tudásbázis létrehozásához.
Amíg az Azure Storage oldalai meg vannak nyitva az Azure portálon, szerezze be a környezeti változó kapcsolati láncát.
A Beállítások>végpontjai területen válassza ki az erőforrás-azonosító végpontját. A következő példához hasonlóan kell kinéznie:
/subscriptions/00000000-0000-0000-0000-00000000/resourceGroups/rg-mydemo/providers/Microsoft.Storage/storageAccounts/mydemostorage/blobServices/default.A kapcsolati sztring előtagja
ResourceId=. Használja ezt a verziót a környezeti változóhoz.ResourceId=/subscriptions/00000000-0000-0000-0000-00000000/resourceGroups/rg-mydemo/providers/Microsoft.Storage/storageAccounts/mydemostorage/blobServices/defaultFelhasználó által hozzárendelt felügyelt identitással létesített kapcsolatok esetén használja ugyanazt a kapcsolati sztringet, és adjon meg egy
identityelőre definiált, felhasználó által hozzárendelt felügyelt identitásra beállított tulajdonságot."credentials" : { "connectionString" : "ResourceId=/subscriptions/00000000-0000-0000-0000-00000000/resourceGroups/MY-DEMO-RESOURCE-GROUP/providers/Microsoft.Storage/storageAccounts/MY-DEMO-STORAGE-ACCOUNT/;" }, "identity" : { "@odata.type": "#Microsoft.Azure.Search.DataUserAssignedIdentity", "userAssignedIdentity" : "/subscriptions/00000000-0000-0000-0000-00000000/resourcegroups/MY-DEMO-RESOURCE-GROUP/providers/Microsoft.ManagedIdentity/userAssignedIdentities/MY-DEMO-USER-MANAGED-IDENTITY" }
Többmodális indexeléshez szükséges készségek kiválasztása
Az indexelési, adatforrás- és indexelődefiníciók többnyire minden forgatókönyv esetében azonosak, de a képességkészlet más képességkombinációt is tartalmazhat attól függően, hogy miként szeretné kinyerni, darabolni és vektorizálni a szöveget és a képeket.
Válassza ki a kinyerési és adattömb-készítési képességeket:
- Dokumentum kinyerése, szöveg felosztása
- Dokumentumelrendezés
Vektorizálási képességek kiválasztása:
- GenAI Prompt, Azure OpenAI-beágyazás
- Azure AI Képfelismerés multimodális beágyazás
A legtöbb ilyen képesség egy üzembe helyezett modelltől vagy egy Microsoft Foundry-erőforrástól függ. Az alábbi táblázat az egyes képességeket alátámasztó modellt, valamint a modellhozzáférést biztosító erőforrást és engedélyeket azonosítja.
| Készség | Usage | Modell | Resource | Permissions |
|---|---|---|---|---|
| Dokumentum-kinyerési képesség, szövegfelosztási képesség | Kivonás és felosztás rögzített méret alapján. A szöveg kinyerése ingyenes. A kép kinyerése számlázható. |
Nincs (beépített) | Azure AI Keresés | Lásd: Hozzáférés konfigurálása |
| Dokumentum Elrendezés képesség | Kinyerés és felosztás a dokumentum elrendezése alapján. | Dokumentumintelligencia 4.0 | Microsoft Foundry | Kognitív szolgáltatások felhasználója |
| Azure AI Képfelismerés-készség (előzetes verzió) | Szöveg- és képtartalom vektorizálása. | Azure AI Képfelismerés 4.0 multimodális | Microsoft Foundry | Kognitív szolgáltatások felhasználója |
| GenAI prompt skill | Hívjon meg egy LLM-et a képtartalom szöveges leírásának létrehozásához. | GPT-5 vagy GPT-4 | Microsoft Foundry | Kognitív szolgáltatások felhasználója |
| Azure OpenAI beágyazási készség | Szöveg vektorizálása és generált képleírások szöveges formában. | Text-embedding-3 vagy text-embedding-ada-002 | Microsoft Foundry | Kognitív szolgáltatások felhasználója |
A modellhasználat számlázható, kivéve a szöveg kinyerését és a szövegfelosztást.
A modelltelepítések bármely támogatott régióban lehetnek, ha a keresési szolgáltatás a nyilvános végponton, egy privát kapcsolaton keresztül csatlakozik, vagy ha a számlázási kapcsolat kulcs nélküli. Ellenkező esetben, ha a kapcsolat kulcsalapú, csatoljon egy Microsoft Foundry-erőforrást az Azure AI Keresésvel azonos régióból.
Saját környezet beállítása
Ebben az oktatóanyagban az Azure AI Keresés helyi REST-ügyfélkapcsolatához végpontra és API-kulcsra van szükség. Ezeket az értékeket az Azure Portalon szerezheti be. További kapcsolati módszerekért lásd: Csatlakozás keresési szolgáltatáshoz.
Az indexelő és a készségkészlet feldolgozása során előforduló hitelesített kapcsolatok esetében a keresési szolgáltatás a korábban definiált szerepkör-hozzárendeléseket használja.
Indítsa el a Visual Studio Code-ot, és hozzon létre egy új fájlt.
Adja meg a kérelemben használt változók értékeit:
 @searchUrl = PUT-YOUR-SEARCH-SERVICE-ENDPOINT-HERE
 @storageConnection = PUT-YOUR-STORAGE-CONNECTION-STRING-HERE
 @imageProjectionContainer=sustainable-ai-pdf-images
 @token = PUT-YOUR-PERSONAL-IDENTITY-TOKEN HERE
A
@storageConnectionesetén győződjön meg arról, hogy a kapcsolati sztring nem tartalmaz pontosvesszőt vagy idézőjelet. Lásd Az adatok előkészítése a kapcsolati sztring szintaxisához.Adjon meg egy egyedi tárolónevet a blob-tárolóban a
@imageProjectionContainerszámára. Az Azure AI Keresés ezt a tárolót a készségek feldolgozása során hozza létre.A hozzáférési jogkivonat beszerzéséhez lásd: Csatlakozás az Azure AI Keresés szolgáltatáshoz. Ha nem tudja használni a szerepköröket, olvassa el a Csatlakozás kulcsokkal című témakört.
Adja hozzá ezt a változót, ha a Dokumentumelrendezési vagy az Azure AI Képfelismerés-készséget használja (a modell 2023-04-15-ös verzióját használja):
@foundryUrl = PUT-YOUR-MULTISERVICE-AZURE-AI-FOUNDRY-ENDPOINT-HERE
@azureAiVisionModelVersion = 2023-04-15
Adja hozzá ezeket a változókat, ha a GenAI Prompt és az Azure OpenAI beágyazási képességet használja:
 @chatCompletionModelUri = PUT-YOUR-DEPLOYED-MODEL-URI-HERE
 @chatCompletionModelKey = PUT-YOUR-MODEL-KEY-HERE
 @textEmbeddingModelUri = PUT-YOUR-DEPLOYED-MODEL-URI-HERE
 @textEmbeddingModelKey = PUT-YOUR-MODEL-KEY-HERE
Mentse a fájlt a
.restvagy a.httpfájlkiterjesztés használatával. A REST-ügyféllel kapcsolatos segítségért tekintse meg a következő rövid útmutatót: Teljes szöveges keresés REST használatával.
Ugyanez az Foundry-erőforrás az Azure AI Képfelismeréset, a Dokumentumintelligencia-t, a csevegés befejezésének modelljét és egy szövegbeágyazási modellt is biztosít. Csak győződjön meg arról, hogy a régió támogatja a szükséges modelleket. Ha egy régió kapacitással rendelkezik, előfordulhat, hogy létre kell hoznia egy új erőforrást a szükséges modellek üzembe helyezéséhez.
Csővezeték beállítása
Az indexelő folyamat négy összetevőből áll: adatforrásból, indexből, képességkészletből és indexelőből.
- Adatforrás létrehozása
- Index létrehozása
- Képességkészlet létrehozása kinyeréshez, adattömbhöz és vektorizáláshoz
- Indexelő létrehozása (és futtatása)
REST-fájlok letöltése
Az azure-search-rest-samples GitHub-adattár tartalmaz .REST fájlokat, amelyek csővezetéket hoznak létre, és lekérdezik az indexet.
Jótanács
Egy Python-példához tekintse meg az azure-ai-search-multimodal-sample GitHub-adattárat .
Adatforrás létrehozása
Az Adatforrás létrehozása (REST) létrehoz egy adatforrás-kapcsolatot, amely meghatározza az indexelendő adatokat.
POST {{searchUrl}}/datasources?api-version=2026-08-01-preview   HTTP/1.1
  Content-Type: application/json
  Authorization: Bearer {{token}}

{
   "name":"demo-multimodal-ds",
   "description":null,
   "type":"azureblob",
   "subtype":null,
   "credentials":{
      "connectionString":"{{storageConnection}}"
   },
   "container":{
      "name":"sustainable-ai-pdf",
      "query":null
   },
   "dataChangeDetectionPolicy":null,
   "dataDeletionDetectionPolicy":null,
   "encryptionKey":null,
   "identity":null
}
Küldje el a kérést. A válasznak így kell kinéznie:
HTTP/1.1 201 Created
Transfer-Encoding: chunked
Content-Type: application/json; odata.metadata=minimal; odata.streaming=true; charset=utf-8
Location: https://<YOUR-SEARCH-SERVICE-NAME>.search.windows-int.net:443/datasources('demo-multimodal-ds')?api-version=2026-08-01-preview -Preview
Server: Microsoft-IIS/10.0
Strict-Transport-Security: max-age=2592000, max-age=15724800; includeSubDomains
Preference-Applied: odata.include-annotations="*"
OData-Version: 4.0
request-id: 4eb8bcc3-27b5-44af-834e-295ed078e8ed
elapsed-time: 346
Date: Sat, 26 Apr 2026 21:25:24 GMT
Connection: close

{
  "name": "demo-multimodal-ds",
  "description": null,
  "type": "azureblob",
  "subtype": null,
  "indexerPermissionOptions": [],
  "credentials": {
    "connectionString": null
  },
  "container": {
    "name": "sustainable-ai-pdf",
    "query": null
  },
  "dataChangeDetectionPolicy": null,
  "dataDeletionDetectionPolicy": null,
  "encryptionKey": null,
  "identity": null
}
Index létrehozása
Az Index létrehozása (REST) létrehoz egy indexet a keresési szolgáltatásban. Az index az összes készségcsoportban hasonló, az alábbi kivételekkel:
A
vectorizersszakasz azt határozza meg, hogy a lekérdezés szövegének vektorizálása hogyan történik a keresési időpontban. Ugyanazt a beágyazási szolgáltatót és modellcsaládot kell használnia, amelyet a képességkészlet (Azure AI Képfelismerés multimodális vagy Azure OpenAI szövegbeágyazása) használ, hogy a lekérdezésvektorok és az indexelt vektorok kompatibilisek legyenek.A
content_embeddingmezőértéknekdimensionspontosan meg kell egyeznie a beágyazási modell által előállított vektormérettel (például1024az Azure AI Képfelismerés multimodális vagy3072atext-embedding-3-large). Az eltérés indexelési vagy lekérdezési hibákat okozhat.Összetett típusok esetén az index beágyazott mezőneveinek pontosan meg kell egyeznie a bővítési kimenet neveivel (beleértve a burkolatot is). Az Azure AI Keresés nem tudja leképezni a beágyazott almezőket különböző nevekre. A szövegfelosztási kimeneteket
location_metadatabounding_polygonspage_numberelfogadó mezők, valamint a Dokumentumelrendezés kimeneteket elfogadó mezők használata.locationMetadataboundingPolygonspageNumber
Az egyes képességkombinációk indexdefiníciói az alábbiak.
- Dokumentumkinyerés > multimodális beágyazás
- Dokumentum kinyerése > szövegbeágyazás
- Dokumentumelrendezés és többmodális beágyazás
- Dokumentumelrendezés > szövegbeágyazás
Ez a minta a következőket használja:
A dokumentumkinyerési funkció és a szövegfelosztó funkció a kinyeréshez és a felosztáshoz.
Azure AI Képfelismerés multimodális jártasság szöveg- és képbeágyazásokhoz.
{
   "name":"demo-multimodal-1-index",
   "fields":[
      {
         "name":"content_id",
         "type":"Edm.String",
         "retrievable":true,
         "key":true,
         "analyzer":"keyword"
      },
      {
         "name":"text_document_id",
         "type":"Edm.String",
         "searchable":false,
         "filterable":true,
         "retrievable":true,
         "stored":true,
         "sortable":false,
         "facetable":false
      },
      {
         "name":"document_title",
         "type":"Edm.String",
         "searchable":true
      },
      {
         "name":"image_document_id",
         "type":"Edm.String",
         "filterable":true,
         "retrievable":true
      },
      {
         "name":"content_text",
         "type":"Edm.String",
         "searchable":true,
         "retrievable":true
      },
      {
         "name":"content_embedding",
         "type":"Collection(Edm.Single)",
         "dimensions":1024,
         "searchable":true,
         "retrievable":true,
         "vectorSearchProfile":"hnsw"
      },
      {
         "name":"content_path",
         "type":"Edm.String",
         "searchable":false,
         "retrievable":true
      },
      {
         "name":"location_metadata",
         "type":"Edm.ComplexType",
         "fields":[
            {
               "name":"page_number",
               "type":"Edm.Int32",
               "searchable":false,
               "retrievable":true
            },
            {
               "name":"bounding_polygons",
               "type":"Edm.String",
               "searchable":false,
               "retrievable":true,
               "filterable":false,
               "sortable":false,
               "facetable":false
            }
         ]
      }
   ],
   "vectorSearch":{
      "profiles":[
         {
            "name":"hnsw",
            "algorithm":"defaulthnsw",
            "vectorizer":"demo-vectorizer"
         }
      ],
      "algorithms":[
         {
            "name":"defaulthnsw",
            "kind":"hnsw",
            "hnswParameters":{
               "m":4,
               "efConstruction":400,
               "metric":"cosine"
            }
         }
      ],
      "vectorizers":[
         {
            "name":"demo-vectorizer",
            "kind":"aiServicesVision",
            "aiServicesVisionParameters":{
               "resourceUri":"{{foundryUrl}}",
               "authIdentity":null,
               "modelVersion":"{{azureAiVisionModelVersion}}"
            }
         }
      ]
   },
   "semantic":{
      "defaultConfiguration":"semanticconfig",
      "configurations":[
         {
            "name":"semanticconfig",
            "prioritizedFields":{
               "titleField":{
                  "fieldName":"document_title"
               },
               "prioritizedContentFields":[

               ],
               "prioritizedKeywordsFields":[

               ]
            }
         }
      ]
   }
}
Összefoglalás:
content_embeddingaz egyetlen vektormező, amely a szöveg- és képtartalmak vektorait tárolja. A beágyazási modellt megfelelő dimenziókkal kell konfigurálni, például3072a text-embedding-3-large modellhez és egy vektorkeresési profillal.content_patha tudástárban lévő összes kép elérési útja.location_metadatavagylocationMetadatahatároló sokszöget és oldalszám metaadatokat rögzít minden normalizált képhez, lehetővé téve a pontos térbeli keresést vagy felhasználói felületi átfedéseket. A mezőnevek az információk kinyerésétől függően változnak.A Szöveg felosztása képességen alapuló tartalomkinyeréshez: a hely metaadatai csak PDF-fájlok esetén támogatottak. A Szöveg felosztása képességhez továbbá tartalmaznia kell egy Shaper-készséget a memóriabeli hely metaadatainak rögzítéséhez és a dokumentumfában való ábrázolásához. A Shaper-képesség a tudástár tárolójának nevének hozzáadásáért is felelős a
content_path.
Képességkészlet létrehozása kinyeréshez, adattömbhöz és vektorizáláshoz
A Skillset (REST) létrehozása egy készségkészletet hoz létre a keresési szolgáltatásban. A képességkészlet határozza meg azokat a műveleteket, amelyek az indexelés előtt kinyerik, darabolják és vektorizálják a tartalmat.
Négy készségkészlet-minta létezik. Mindegyik egy vektorizációs stratégiával párosított extrakciós és adattömb-stratégiát mutat be. Két fő különbség van az egyes mintákban: a készségkészlet összetétele és indexProjections. Az előrejelzések az egyes beágyazási képességek kimenetétől függően változnak.
Mind a négy minta tartalmazza a Shaper készséget. A Shaper-képesség kimenete létrehozza a képek normalizált elérési útját a tudástárban és a hely metaadataiban (oldalszám és határoló sokszögek).
- Dokumentumkinyerés > multimodális beágyazás
- Dokumentum kinyerése > szövegbeágyazás
- Dokumentumelrendezés és többmodális beágyazás
- Dokumentumelrendezés > szövegbeágyazás
Ez a minta a következőket használja:
A dokumentumkinyerési funkció és a szövegfelosztó funkció a kinyeréshez és a felosztáshoz.
Azure AI Képfelismerés multimodális jártasság szöveg- és képbeágyazásokhoz.
A Shaper-képesség rögzíti a hely metaadatait és a tudástárban lévő képfájl elérési útjának tárolónevét. Ez a funkció egyedi a PDF-tartalmak és a dokumentumkinyerés esetében.
{
   "name":"demo-multimodal-skillset",
   "description":"A test skillset",
   "skills":[
      {
         "@odata.type":"#Microsoft.Skills.Util.DocumentExtractionSkill",
         "name":"document-extraction-skill",
         "description":"Document extraction skill to extract text and images from documents",
         "parsingMode":"default",
         "dataToExtract":"contentAndMetadata",
         "configuration":{
            "imageAction":"generateNormalizedImages",
            "normalizedImageMaxWidth":2000,
            "normalizedImageMaxHeight":2000
         },
         "context":"/document",
         "inputs":[
            {
               "name":"file_data",
               "source":"/document/file_data"
            }
         ],
         "outputs":[
            {
               "name":"content",
               "targetName":"extracted_content"
            },
            {
               "name":"normalized_images",
               "targetName":"normalized_images"
            }
         ]
      },
      {
         "@odata.type":"#Microsoft.Skills.Text.SplitSkill",
         "name":"split-skill",
         "description":"Split skill to chunk documents",
         "context":"/document",
         "defaultLanguageCode":"en",
         "textSplitMode":"pages",
         "maximumPageLength":2000,
         "pageOverlapLength":200,
         "unit":"characters",
         "inputs":[
            {
               "name":"text",
               "source":"/document/extracted_content",
               "inputs":[

               ]
            }
         ],
         "outputs":[
            {
               "name":"textItems",
               "targetName":"pages"
            }
         ]
      },
      {
         "@odata.type":"#Microsoft.Skills.Vision.VectorizeSkill",
         "name":"text-embedding-skill",
         "description":"Vision Vectorization skill for text",
         "context":"/document/pages/*",
         "modelVersion":"{{azureAiVisionModelVersion}}",
         "inputs":[
            {
               "name":"text",
               "source":"/document/pages/*"
            }
         ],
         "outputs":[
            {
               "name":"vector",
               "targetName":"text_vector"
            }
         ]
      },
      {
         "@odata.type":"#Microsoft.Skills.Vision.VectorizeSkill",
         "name":"image-embedding-skill",
         "description":"Vision Vectorization skill for images",
         "context":"/document/normalized_images/*",
         "modelVersion":"{{azureAiVisionModelVersion}}",
         "inputs":[
            {
               "name":"image",
               "source":"/document/normalized_images/*"
            }
         ],
         "outputs":[
            {
               "name":"vector",
               "targetName":"image_vector"
            }
         ]
      },
      {
         "@odata.type":"#Microsoft.Skills.Util.ShaperSkill",
         "name":"shaper-skill",
         "description":"Shaper skill to reshape the data to fit the index schema",
         "context":"/document/normalized_images/*",
         "inputs":[
            {
               "name":"normalized_images",
               "source":"/document/normalized_images/*",
               "inputs":[

               ]
            },
            {
               "name":"imagePath",
               "source":"='{{imageProjectionContainer}}/'+$(/document/normalized_images/*/imagePath)",
               "inputs":[

               ]
            },
            {
               "name":"dataUri",
               "source":"='data:image/jpeg;base64,'+$(/document/normalized_images/*/data)",
               "inputs":[

               ]
            },
            {
               "name":"location_metadata",
               "sourceContext":"/document/normalized_images/*",
               "inputs":[
                  {
                     "name":"page_number",
                     "source":"/document/normalized_images/*/page_number"
                  },
                  {
                     "name":"bounding_polygons",
                     "source":"/document/normalized_images/*/bounding_polygon"
                  }
               ]
            }
         ],
         "outputs":[
            {
               "name":"output",
               "targetName":"new_normalized_images"
            }
         ]
      }
   ],
   "cognitiveServices":{
      "@odata.type":"#Microsoft.Azure.Search.AIServicesByIdentity",
      "subdomainUrl":"{{foundryUrl}}",
      "identity":null
   },
   "indexProjections":{
      "selectors":[
         {
            "targetIndexName":"demo-multimodal-index",
            "parentKeyFieldName":"text_document_id",
            "sourceContext":"/document/pages/*",
            "mappings":[
               {
                  "name":"content_embedding",
                  "source":"/document/pages/*/text_vector"
               },
               {
                  "name":"content_text",
                  "source":"/document/pages/*"
               },
               {
                  "name":"document_title",
                  "source":"/document/document_title"
               }
            ]
         },
         {
            "targetIndexName":"demo-multimodal-index",
            "parentKeyFieldName":"image_document_id",
            "sourceContext":"/document/normalized_images/*",
            "mappings":[
               {
                  "name":"content_embedding",
                  "source":"/document/normalized_images/*/image_vector"
               },
               {
                  "name":"content_path",
                  "source":"/document/normalized_images/*/new_normalized_images/imagePath"
               },
               {
                  "name":"location_metadata",
                  "source":"/document/normalized_images/*/new_normalized_images/location_metadata"
               },
               {
                  "name":"document_title",
                  "source":"/document/document_title"
               }
            ]
         }
      ],
      "parameters":{
         "projectionMode":"skipIndexingParentDocuments"
      }
   },
   "knowledgeStore":{
      "storageConnectionString":"{{storageConnection}}",
      "identity":null,
      "projections":[
         {
            "files":[
               {
                  "storageContainer":"{{imageProjectionContainer}}",
                  "source":"/document/normalized_images/*"
               }
            ]
         }
      ]
   }
}
Az indexelő futtatása
Az Indexelő létrehozása létrehoz egy indexelőt a keresési szolgáltatásban. Az indexelő csatlakozik az adatforráshoz, betölti az adatokat, futtat egy készségkészletet, és indexeli a bővített tartalmat.
### Create and run an indexer
POST {{searchUrl}}/indexers?api-version=2026-08-01-preview   HTTP/1.1
  Content-Type: application/json
  Authorization: Bearer {{token}}

{
  "name": "demo-multimodal-indexer",
  "dataSourceName": "demo-multimodal-ds",
  "targetIndexName": "demo-multimodal-index",
  "skillsetName": "demo-multimodal-skillset",
  "parameters": {
    "maxFailedItems": -1,
    "maxFailedItemsPerBatch": 0,
    "batchSize": 1,
    "configuration": {
      "allowSkillsetToReadFileData": true
    }
  },
  "fieldMappings": [
    {
      "sourceFieldName": "metadata_storage_name",
      "targetFieldName": "document_title"
    }
  ],
  "outputFieldMappings": []
}
Lekérdezések futtatása
Az első dokumentum betöltése után azonnal megkezdheti a keresést. Ez egy meghatározatlan teljes szöveges keresési lekérdezés, amely az indexben lekérdezhetőként megjelölt mezőket és a dokumentumok számát adja vissza.
Jótanács
A content_embedding mező több mint ezer dimenziót tartalmaz.
select Az utasítással kizárhatja ezt a mezőt a válaszból az összes többi mező explicit kiválasztásával. Módosítsa a kijelölési utasítást úgy, hogy az megfeleljen az index mezőinek (location_metadata és locationMetadata)-nak. Íme egy példa: "select": "content_id, text_document_id, document_title, image_document_id, content_text,
### Query the index
POST {{searchUrl}}/indexes/demo-multimodal-index/docs/search?api-version=2026-08-01-preview   HTTP/1.1
  Content-Type: application/json
  Authorization: Bearer {{token}}

  {
    "search": "*",
    "count": true
  }
Küldje el a kérést. A válasznak így kell kinéznie:
HTTP/1.1 200 OK
Transfer-Encoding: chunked
Content-Type: application/json; odata.metadata=minimal; odata.streaming=true; charset=utf-8
Content-Encoding: gzip
Vary: Accept-Encoding
Server: Microsoft-IIS/10.0
Strict-Transport-Security: max-age=2592000, max-age=15724800; includeSubDomains
Preference-Applied: odata.include-annotations="*"
OData-Version: 4.0
request-id: 712ca003-9493-40f8-a15e-cf719734a805
elapsed-time: 198
Date: Wed, 30 Apr 2025 23:20:53 GMT
Connection: close

{
  "@odata.count": 100,
  "@search.nextPageParameters": {
    "search": "*",
    "count": true,
    "skip": 50
  },
  "value": [
  ],
  "@odata.nextLink": "https://<YOUR-SEARCH-SERVICE-NAME>.search.windows.net/indexes/demo-multimodal-index/docs/search?api-version=2026-08-01-preview "
}
A válasz 100 dokumentumot ad vissza.
Csak képtartalmak lekérdezése
Használjon szűrőt az összes nem képtartalom kizárásához. A $filter paraméter csak az index létrehozásakor szűrhetőként megjelölt mezőkön működik.
Szűrők esetén logikai operátorokat (és vagy nem) és összehasonlító operátorokat (eq, ne, gt, lt, ge, le) is használhat. A sztring-összehasonlítások megkülönböztetik a kis- és nagybetűket. További információkért és példákért lásd az egyszerű keresési lekérdezések példáit.
POST {{searchUrl}}/indexes/demo-multimodal-index/docs/search?api-version=2026-08-01-preview   HTTP/1.1
  Content-Type: application/json
  Authorization: Bearer {{token}}

  {
    "search": "*",
    "count": true,
    "filter": "image_document_id ne null"
  }
A csak képi tartalommal rendelkező keresési eredmények nem tartalmaznak szöveges tartalmat, így kizárhatja a szövegmezőket.
A content_embedding mező nagy méretű vektorokat (általában 1000–3000 dimenziót) tartalmaz az oldalszöveghez és a verbális képleírásokhoz. Zárja ki ezt a mezőt a lekérdezésből.
A content_path mező a képfájl relatív elérési útját tartalmazza a kijelölt képvetítési tárolóban. Ez a mező csak PDF-fájlokból kinyert képekhez kerül létrehozásra, ha imageAction be van állítva generateNormalizedImages, és amely a forrásmező /document/normalized_images/*/imagePath-ből származó bővített dokumentumból leképezhető.
A Szöveg felosztása képesség használatával kinyert PDF-környezet esetében az Shaper-képesség hozzáadja a tároló nevét az elérési úthoz és a hely metaadataihoz.
Az "energia" tartalom lekérdezése
Lekérdezhet szöveget vagy képeket, amelyek energia témájú tartalmakkal rendelkeznek, és visszaadja a tartalomazonosítót, a szülődokumentumot és a szöveget (csak szövegrészek esetén töltjük ki), valamint azt a tartalom útvonalát, amelyre a képet a tudásbázisban mentjük (csak képeknél van kitöltve).
Ez a lekérdezés csak teljes szöveges keresés, de a vektormezőt is lekérdezheti a hasonlóság kereséséhez.
POST {{searchUrl}}/indexes/demo-multimodal-index/docs/search?api-version=2026-08-01-preview   HTTP/1.1
  Content-Type: application/json
  Authorization: Bearer {{token}}


  {
    "search": "energy",
    "count": true
  }
Alaphelyzetbe állítás és ismételt futtatás
Az indexek alaphelyzetbe állíthatók a fennálló állapot törléséhez, ami lehetővé teszi a teljes újraépítést. A következő POST-kérések visszaállításra, majd újrafuttatásra szolgálnak.
### Reset the indexer
POST {{searchUrl}}/indexers/demo-multimodal-indexer/reset?api-version=2026-08-01-preview   HTTP/1.1
  Content-Type: application/json
  Authorization: Bearer {{token}}
### Run the indexer
POST {{searchUrl}}/indexers/demo-multimodal-indexer/run?api-version=2026-08-01-preview   HTTP/1.1
  Content-Type: application/json
  Authorization: Bearer {{token}}
### Check indexer status
GET {{searchUrl}}/indexers/demo-multimodal-indexer/status?api-version=2026-08-01-preview   HTTP/1.1
  Content-Type: application/json
  Authorization: Bearer {{token}}
Képek megtekintése a tudástárban
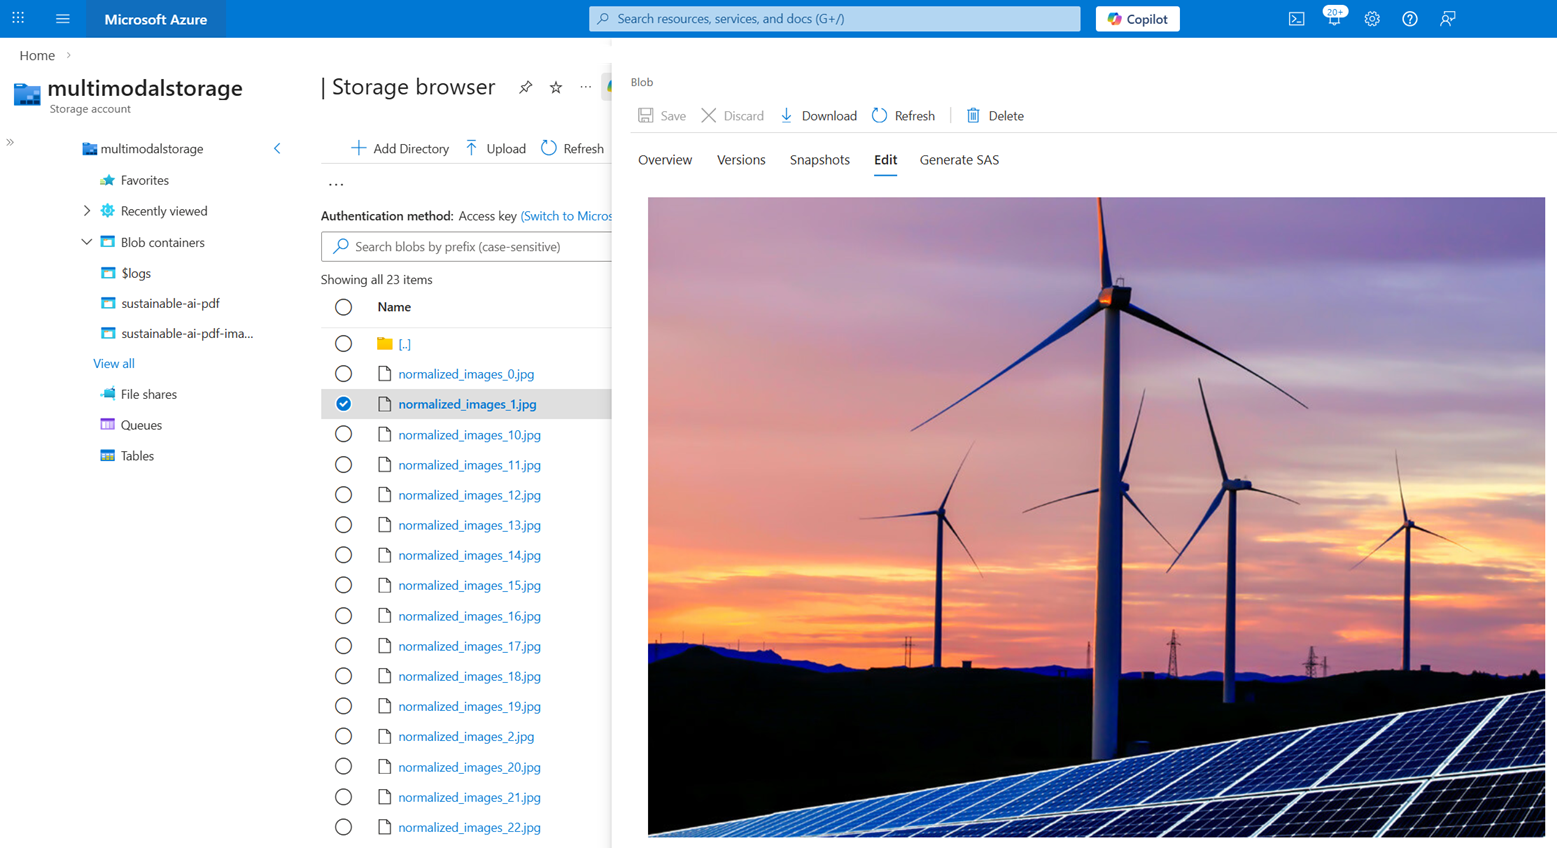
Ne feledje, hogy az oktatóanyagban szereplő képességkészlet egy tudástárat hoz létre a PDF-ből kinyert képtartalmakhoz. Az indexelő futtatása után a sustainable-ai-pdf-images tárolónak körülbelül 23 képből kell lennie.
Ezeket a képeket nem lehet visszaadni keresési lekérdezésben. Írhat azonban olyan alkalmazáskódot, amely meghívja az Azure Storage API-kat a rendszerképek lekéréséhez, ha szüksége van rájuk a felhasználói élményhez. A content_path mező az egyes képek elérési útját mutatja.
A rendszerképek megtekintése a Storage Browserben:
Jelentkezzen be az Azure Portalra, és lépjen a Storage-fiókjához.
A Storage Browserben bontsa ki a sustainable-ai-pdf-images tárolót.
Válasszon ki egy képet.
A jobb szélső menüben (...) válassza a Nézet/Szerkesztés lehetőséget.
Erőforrások tisztítása
Ha a saját előfizetésében dolgozik, érdemes befejezni egy projektet a már nem szükséges erőforrások eltávolításával. A meghagyott működő erőforrások pénzbe kerülhetnek.
Az Azure Portalon válassza az Összes erőforrás vagy erőforráscsoport lehetőséget a bal oldali panelen az erőforrások megkereséséhez és kezeléséhez. Az erőforrásokat egyenként törölheti, vagy törölheti az erőforráscsoportot az összes erőforrás egyidejű eltávolításához.