Megjegyzés
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhat bejelentkezni vagy módosítani a címtárat.
Az oldalhoz való hozzáféréshez engedély szükséges. Megpróbálhatja módosítani a címtárat.
Note
Azure AI Keresés a Azure portálon, REST API-kon és Azure SDK-k keresztül érhető el. Emellett a Foundry IQ-t is támogatja, amely a vállalati tartalmakat újrafelhasználható, engedélytudatos tudásbázisokká alakítja át az Microsoft Foundry portálon található ügynökök számára.
Az Azure AI Keresés két alapvető módszert támogat az adatok keresési indexbe való importálásához : az adatok programozott módon való leküldése az indexbe, vagy az adatok lekérése egy indexelő támogatott adatforrásra mutatásával.
Ez az oktatóanyag bemutatja, hogyan indexelheti hatékonyan az adatokat a leküldéses modell használatával a kérelmek kötegelésével és exponenciális szüneteltetéses újrapróbálkozási stratégia alkalmazásával. Letöltheti és futtathatja a mintaalkalmazást. Ez az oktatóanyag az alkalmazás főbb szempontjait és az adatok indexelése során figyelembe veendő tényezőket is ismerteti.
Ebben az oktatóanyagban a C# és az Azure.Search.Documents kódtárat használja a .NET-hez készült Azure SDK-ból a következő célokra:
- Index létrehozása
- Különböző kötegméretek tesztelése a leghatékonyabb méret meghatározásához
- Index kötegek aszinkron módon
- Több szál használata az indexelési sebesség növeléséhez
- Az exponenciális backoff stratégiát alkalmazza a sikertelen dokumentumok újrapróbálásához.
Előfeltételek
- Egy Azure-fiók, aktív előfizetéssel. Fiók létrehozása ingyenes.
- Visual Studio.
Fájlok letöltése
Az oktatóanyag forráskódja az Azure-Samples/azure-search-dotnet-scale GitHub-adattár optimize-data-indexing/v11 mappájában található.
Fő szempontok
Az alábbi tényezők befolyásolják az indexelési sebességet. További információ: Nagyméretű adathalmazok indexelése.
- Tarifacsomag és partíciók/replikák száma: A partíciók hozzáadása vagy a réteg frissítése növeli az indexelési sebességet.
- Indexséma összetettsége: A mezők és mezőtulajdonságok hozzáadása csökkenti az indexelési sebességet. A kisebb indexek gyorsabban indexelnek.
- Kötegméret: Az optimális kötegméret az indexsémától és az adatkészlettől függően változik.
- Szálak/feldolgozók száma: Egyetlen szál nem használja ki teljes mértékben az indexelési sebesség előnyeit.
- Újrapróbálkozási stratégia: Az optimális indexelés ajánlott eljárása az exponenciális visszalépési újrapróbálkozási stratégia.
- Hálózati adatátvitel sebessége: Az adatátvitel sebessége korlátozó tényező lehet. Indexelje az adatokat az Azure-környezetből az adatátviteli sebesség növelése érdekében.
Keresési szolgáltatás létrehozása
Ez az oktatóanyag egy Azure AI Keresés szolgáltatást igényel, amelyet az Azure Portalon hozhat létre. Meglévő szolgáltatást is találhat az aktuális előfizetésében. Az indexelési sebesség pontos tesztelése és optimalizálása érdekében javasoljuk, hogy ugyanazt a tarifacsomagot használja, amelyet éles környezetben szeretne használni.
Rendszergazdai kulcs és URL-cím lekérése az Azure AI Keresés szolgáltatáshoz
Ez az oktatóanyag kulcsalapú hitelesítést használ. Másolja a rendszergazdai API-kulcsot a appsettings.json fájlba való beillesztéshez.
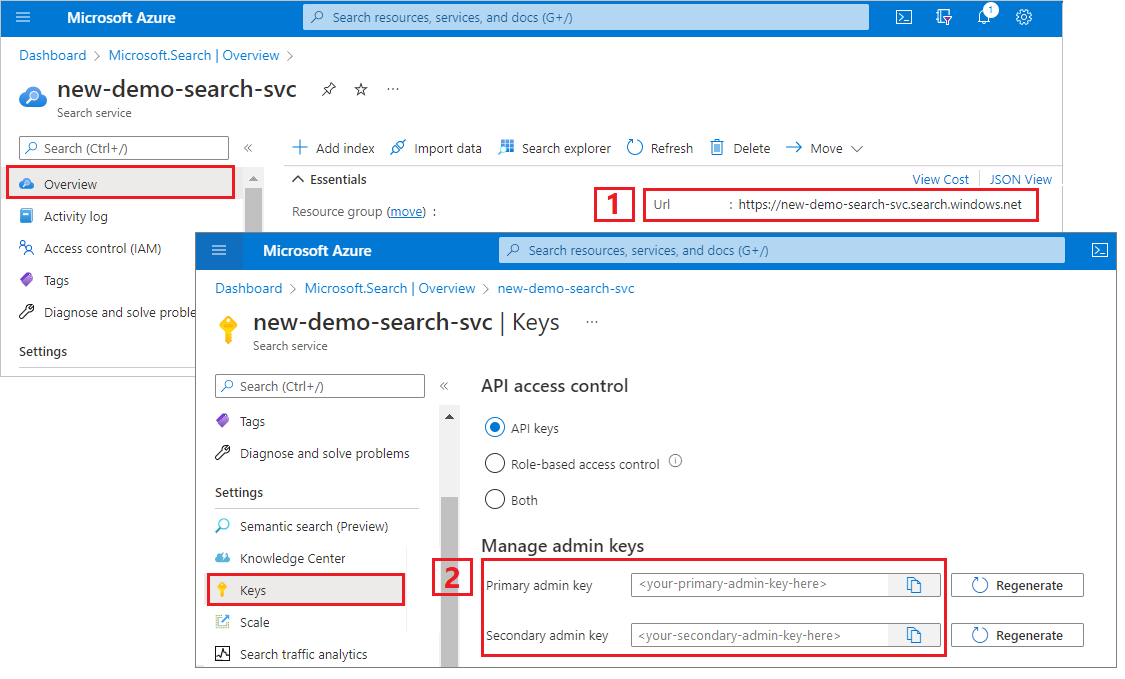
Nyissa meg a keresési szolgáltatást az Azure Portalon.
A bal oldali panelen válassza az Áttekintés lehetőséget, és másolja ki a végpontot. Ennek a formátumnak a következő formátumban kell lennie:
https://my-service.search.windows.netA bal oldali panelen válassza a Beállítások>kulcsok lehetőséget, és másolja ki a teljes jogokat tartalmazó rendszergazdai kulcsot a szolgáltatásban. Két felcserélhető rendszergazdai kulcs áll rendelkezésre az üzletmenet folytonossága érdekében, ha át kell gördítenie egyet. Az objektumok hozzáadásához, módosításához vagy törléséhez a kérelmek egyik kulcsát használhatja.
Saját környezet beállítása
Nyissa meg a
OptimizeDataIndexing.slnfájlt a Visual Studióban.A Megoldáskezelőben szerkessze a
appsettings.jsonfájlt az előző lépésben összegyűjtött kapcsolati adatokkal.{ "SearchServiceUri": "https://{service-name}.search.windows.net", "SearchServiceAdminApiKey": "", "SearchIndexName": "optimize-indexing" }
A kód megismerése
A appsettings.json frissítése után a mintaprogramnak OptimizeDataIndexing.sln készen kell állnia az összeállításra és futtatásra.
Ez a kód a rövid útmutató C# szakaszából származik : Teljes szöveges keresés, amely részletes információkat nyújt a .NET SDK használatának alapjairól.
Ez az egyszerű C#/.NET-konzolalkalmazás a következő feladatokat hajtja végre:
- Új indexet hoz létre a C#
Hotelosztály adatstruktúrája alapján (amely azAddressosztályra is hivatkozik) - Különböző kötegméreteket tesztel, hogy meghatározza a leghatékonyabb méretet.
- Az adatokat aszinkron módon indexeli
- Több szál használata az indexelési sebesség növeléséhez
- Exponenciális backoff újrapróbálkozási stratégia használata a sikertelen elemek újrapróbálkozásához
A program futtatása előtt szánjon egy percet a minta kódjának és indexdefinícióinak tanulmányozására. A megfelelő kód több fájlban található:
-
Hotel.csésAddress.cstartalmazza az indexet meghatározó sémát -
DataGenerator.csegy egyszerű osztályt tartalmaz, amely megkönnyíti a nagy mennyiségű szállodai adat létrehozását -
ExponentialBackoff.cskódot tartalmaz az indexelési folyamat optimalizálásához a jelen cikkben leírtak szerint -
Program.csOlyan függvényeket tartalmaz, amelyek létrehozzák és törlik az Azure AI Keresés-indexet, indexelik az adatkötegeket, és különböző kötegméreteket tesztelnek
Az index létrehozása
Ez a mintaprogram az Azure SDK for .NET használatával definiál és hoz létre egy Azure AI Keresés-indexet. Az osztály előnyeit kihasználva FieldBuilder indexstruktúrát hozhat létre egy C#-adatmodell-osztályból.
Az adatmodellt az Hotel osztály határozza meg, amely az Address osztályra mutató hivatkozásokat is tartalmaz.
FieldBuilder több osztálydefiníción keresztül részletezve összetett adatstruktúrát hoz létre az index számára. A metaadatcímkék az egyes mezők attribútumainak meghatározására szolgálnak, például azt, hogy kereshető vagy rendezhető-e.
A fájl alábbi Hotel.cs kódrészletei egyetlen mezőt és egy másik adatmodell-osztályra mutató hivatkozást határoznak meg.
. . .
[SearchableField(IsSortable = true)]
public string HotelName { get; set; }
. . .
public Address Address { get; set; }
. . .
Az Program.cs fájlban az index egy névvel és egy mezőgyűjteménnyel van definiálva, amelyet a FieldBuilder.Build(typeof(Hotel)) metódus generál, majd az alábbi módon kerül létrehozásra:
private static async Task CreateIndexAsync(string indexName, SearchIndexClient indexClient)
{
    // Create a new search index structure that matches the properties of the Hotel class.
    // The Address class is referenced from the Hotel class. The FieldBuilder
    // will enumerate these to create a complex data structure for the index.
    FieldBuilder builder = new FieldBuilder();
    var definition = new SearchIndex(indexName, builder.Build(typeof(Hotel)));

    await indexClient.CreateIndexAsync(definition);
}
Adatok generálása
A fájlban egy egyszerű osztály van implementálva, DataGenerator.cs amely adatokat hoz létre teszteléshez. Ennek az osztálynak az a célja, hogy megkönnyítse nagyszámú, egyedi azonosítóval rendelkező dokumentum létrehozásának megkönnyítését az indexeléshez.
100 000 egyedi azonosítóval rendelkező szálloda listájának lekéréséhez futtassa a következő kódot:
long numDocuments = 100000;
DataGenerator dg = new DataGenerator();
List<Hotel> hotels = dg.GetHotels(numDocuments, "large");
Ebben a mintában két méretben lehet tesztelni a szállodákat: kicsi és nagy.
Az index sémája befolyásolja az indexelési sebességet. Az oktatóanyag elvégzése után érdemes lehet átalakítani ezt az osztályt úgy, hogy a kívánt indexsémának leginkább megfelelő adatokat hozzon létre.
Kötegméretek tesztelése
Ha egy vagy több dokumentumot szeretne betölteni egy indexbe, az Azure AI Keresés a következő API-kat támogatja:
A dokumentumok kötegekben való indexelése jelentősen javítja az indexelési teljesítményt. Ezek a kötegek kötegenként legfeljebb 1000 dokumentumból vagy akár 16 MB-ból is lehetnek.
Az indexelési sebesség optimalizálásának kulcsfontosságú összetevője az adatok optimális kötegméretének meghatározása. Az optimális kötegméretet befolyásolni képes két elsődleges tényező:
- Az index sémája
- Az adatok mérete
Mivel az optimális kötegméret az indextől és az adatoktól függ, a legjobb módszer a különböző kötegméretek tesztelése, hogy megállapítsa, mi okozza a forgatókönyv leggyorsabb indexelési sebességét.
Az alábbi függvény egy egyszerű módszert mutat be a kötegméretek tesztelésére.
public static async Task TestBatchSizesAsync(SearchClient searchClient, int min = 100, int max = 1000, int step = 100, int numTries = 3)
{
    DataGenerator dg = new DataGenerator();

    Console.WriteLine("Batch Size \t Size in MB \t MB / Doc \t Time (ms) \t MB / Second");
    for (int numDocs = min; numDocs <= max; numDocs += step)
    {
        List<TimeSpan> durations = new List<TimeSpan>();
        double sizeInMb = 0.0;
        for (int x = 0; x < numTries; x++)
        {
            List<Hotel> hotels = dg.GetHotels(numDocs, "large");

            DateTime startTime = DateTime.Now;
            await UploadDocumentsAsync(searchClient, hotels).ConfigureAwait(false);
            DateTime endTime = DateTime.Now;
            durations.Add(endTime - startTime);

            sizeInMb = EstimateObjectSize(hotels);
        }

        var avgDuration = durations.Average(timeSpan => timeSpan.TotalMilliseconds);
        var avgDurationInSeconds = avgDuration / 1000;
        var mbPerSecond = sizeInMb / avgDurationInSeconds;

        Console.WriteLine("{0} \t\t {1} \t\t {2} \t\t {3} \t {4}", numDocs, Math.Round(sizeInMb, 3), Math.Round(sizeInMb / numDocs, 3), Math.Round(avgDuration, 3), Math.Round(mbPerSecond, 3));

        // Pausing 2 seconds to let the search service catch its breath
        Thread.Sleep(2000);
    }

    Console.WriteLine();
}
Mivel nem minden dokumentum mérete azonos (bár ebben a mintában szerepelnek), megbecsüljük a keresési szolgáltatásnak küldött adatok méretét. Ezt a következő függvénnyel teheti meg, amely először JSON-ra konvertálja az objektumot, majd bájtokban határozza meg a méretét. Ez a technika lehetővé teszi, hogy megállapítsuk, mely kötegméretek a leghatékonyabbak MB/s indexelési sebesség szempontjából.
// Returns size of object in MB
public static double EstimateObjectSize(object data)
{
    byte[] json = JsonSerializer.SerializeToUtf8Bytes(data);
    return json.Length / 1_000_000d;
}
A függvényhez meg kell adni az SearchClient értékét, valamint az egyes kötegméretekhez tartozó, tesztelni kívánt próbálkozások számát. Mivel az egyes kötegek indexelési idejének variabilitása lehet, alapértelmezés szerint háromszor próbálkozzon az egyes kötegekkel, hogy az eredmények statisztikailag szignifikánsabbak legyenek.
await TestBatchSizesAsync(searchClient, numTries: 3);
A függvény futtatásakor a konzolon az alábbi példához hasonló kimenetnek kell megjelennie:
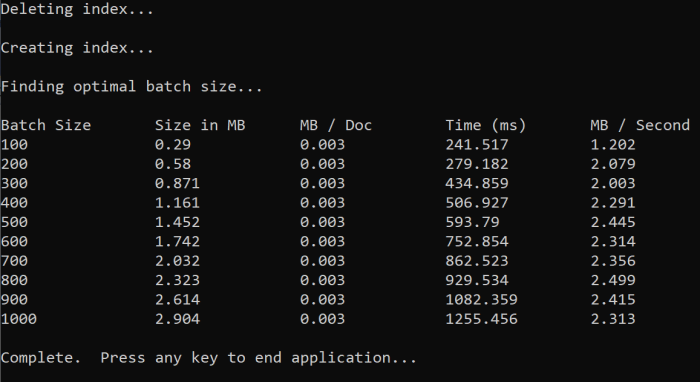
Azonosítsa a leghatékonyabb kötegméretet, és használja ezt a kötegméretet az oktatóanyag következő lépésében. Lehetséges, hogy az MB/s teljesítmény különböző kötegméreteknél kiegyenlítődik.
Az adatok indexelése
Most, hogy azonosította a használni kívánt kötegméretet, a következő lépés az adatok indexelésének megkezdése. Az adatok hatékony indexeléséhez ez a minta:
- Több szálat vagy feldolgozót használ
- Exponenciális visszavonuló újrapróbálkozási stratégia érvényesítése
Bontsa ki a 41–49. sorokat, majd futtassa újra a programot. Ebben a futtatásban a minta legfeljebb 100 000 dokumentumköteget hoz létre és küld el, ha a paraméterek módosítása nélkül futtatja a kódot.
Több szál/feldolgozó használata
Az Azure AI Keresés indexelési sebességének kihasználásához használjon több szálat a kötegelt indexelési kérések egyidejű elküldéséhez a szolgáltatásnak.
Számos fontos szempont befolyásolhatja a szálak optimális számát. Ezt a mintát módosíthatja, és különböző szálszámokkal tesztelheti a forgatókönyv optimális szálszámának meghatározásához. Mindaddig azonban, amíg több szál fut egyszerre, képesnek kell lennie arra, hogy kihasználja a hatékonyságnövekedés nagy részét.
A keresési szolgáltatásra irányuló kérések felfuttatása során HTTP-állapotkódok jelenhetnek meg, amelyek azt jelzik, hogy a kérés nem sikerült teljes mértékben. Az indexelés során két gyakori HTTP-állapotkód:
- 503 Szolgáltatás nem érhető el: Ez a hiba azt jelenti, hogy a rendszer nagy terhelés alatt áll, és a kérés jelenleg nem dolgozható fel.
- 207 Többállapotú: Ez a hiba azt jelenti, hogy egyes dokumentumok sikeresek voltak, de legalább egy sikertelen volt.
Exponenciális visszaállási késleltetést alkalmazó újrapróbálkozási stratégia megvalósítása
Ha hiba történik, a kéréseket exponenciális visszalépési újrapróbálkozási stratégiával kell újrapróbálkoznia.
Az Azure AI Keresés .NET SDK-ja automatikusan újra próbálkozik a 503-as és más sikertelen kérésekkel, de a 207-es hibakódok esetén saját logikát kell implementálnia az újrapróbálkozáshoz. Az olyan nyílt forráskódú eszközök, mint a Polly , hasznosak lehetnek az újrapróbálkozásos stratégiában.
Ebben a mintában saját exponenciális visszalépési újrapróbálkozási stratégiát valósítunk meg. Először definiálunk néhány változót, köztük a maxRetryAttempts és a sikertelen kérés kezdeti delay értékét.
// Create batch of documents for indexing
var batch = IndexDocumentsBatch.Upload(hotels);

// Create an object to hold the result
IndexDocumentsResult result = null;

// Define parameters for exponential backoff
int attempts = 0;
TimeSpan delay = TimeSpan.FromSeconds(2);
int maxRetryAttempts = 5;
Az indexelési művelet eredményeit a változó IndexDocumentResult resulttárolja. Ez a változó lehetővé teszi annak ellenőrzését, hogy a kötegben lévő dokumentumok sikertelenek-e, ahogy az alábbi példában is látható. Részleges hiba esetén egy új köteg jön létre a sikertelen dokumentumok azonosítója alapján.
RequestFailedException kivételeket is ki kell venni, mivel azt jelzik, hogy a kérés teljesen meghiúsult, és újrapróbálkozott.
// Implement exponential backoff
do
{
    try
    {
        attempts++;
        Response<IndexDocumentsResult> response = await searchClient
            .IndexDocumentsAsync(batch)
            .ConfigureAwait(false);
        result = response.Value;

        var failedDocuments = result.Results.Where(r => r.Succeeded != true).ToList();

        // handle partial failure
        if (failedDocuments.Count > 0)
        {
            if (attempts == maxRetryAttempts)
            {
                Console.WriteLine("[MAX RETRIES HIT] - Giving up on the batch starting at {0}", id);
                break;
            }
            else
            {
                Console.WriteLine("[Batch starting at doc {0} had partial failure]", id);
                Console.WriteLine("[Retrying {0} failed documents] \n", failedDocuments.Count);

                // creating a batch of failed documents to retry
                var failedDocumentKeys = failedDocuments.Select(doc => doc.Key).ToList();
                hotels = hotels.Where(h => failedDocumentKeys.Contains(h.HotelId)).ToList();
                batch = IndexDocumentsBatch.Upload(hotels);

                Task.Delay(delay).Wait();
                delay = delay * 2;
                continue;
            }
        }

        return result;
    }
    catch (RequestFailedException ex)
    {
        Console.WriteLine("[Batch starting at doc {0} failed]", id);
        Console.WriteLine("[Retrying entire batch] \n");

        if (attempts == maxRetryAttempts)
        {
            Console.WriteLine("[MAX RETRIES HIT] - Giving up on the batch starting at {0}", id);
            break;
        }

        Task.Delay(delay).Wait();
        delay = delay * 2;
    }
} while (true);
Innen csomagolja be az exponenciális visszalépési kódot egy függvénybe, hogy könnyen meghívható legyen.
Ezután létrejön egy másik függvény az aktív szálak kezeléséhez. Az egyszerűség kedvéért ez a függvény nem szerepel itt, de megtalálható a ExponentialBackoff.cs. A függvényt a következő paranccsal hívhatja meg, ahol hotels a feltölteni kívánt adatok, 1000 a köteg mérete és 8 az egyidejű szálak száma.
await ExponentialBackoff.IndexDataAsync(searchClient, hotels, 1000, 8);
A függvény futtatásakor az alábbi példához hasonló kimenetnek kell megjelennie:
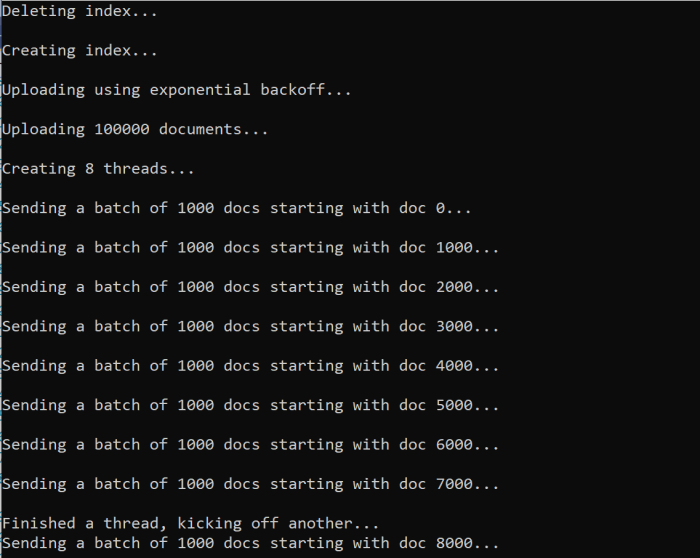
Ha egy dokumentumköteg meghibásodik, a rendszer hibát jelez, és a köteget újrapróbálkozza.
[Batch starting at doc 6000 had partial failure]
[Retrying 560 failed documents]
A függvény futtatása után ellenőrizheti, hogy az összes dokumentum hozzá lett-e adva az indexhez.
Az index felfedezése
A program futtatása után programozott módon vagy az Azure Portal Keresőböngészőjében is felfedezheti a feltöltött keresési indexet.
Programozott módon
Az indexben lévő dokumentumok számának ellenőrzésére két fő lehetőség áll rendelkezésre: a Dokumentumok száma API és az Indexstatisztikák lekérése API. Mindkét elérési úthoz időre van szükség a feldolgozáshoz, ezért ne aggódjon, ha a visszaadott dokumentumok száma kezdetben alacsonyabb a vártnál.
Dokumentumok száma
A Dokumentumok megszámlálása művelet lekéri a keresési indexben lévő dokumentumok számát.
long indexDocCount = await searchClient.GetDocumentCountAsync();
Indexstatisztikák lekérése
Az Indexstatisztikák lekérése művelet az aktuális index dokumentumszámát és a tárterület használatát adja vissza. Az indexstatisztikák frissítése hosszabb időt vesz igénybe, mint a dokumentumok száma.
var indexStats = await indexClient.GetIndexStatisticsAsync(indexName);
Azure Portal
Az Azure Portal bal oldali paneljén keresse meg az optimalizálási indexet az Indexek listában.
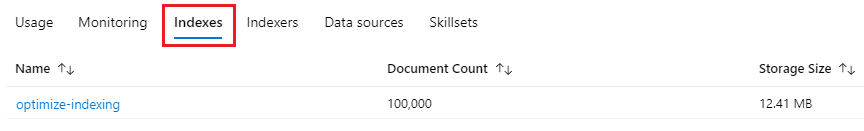
A dokumentumszám és a tárterület mérete az Indexstatisztika lekérése API-n alapul, és a frissítés eltarthat néhány percig.
Alaphelyzetbe állítás és ismételt futtatás
A fejlesztés korai kísérleti fázisaiban a tervezési iteráció legpraktikusabb módszere az objektumok törlése az Azure AI Keresésből, és a kód újraépítésének engedélyezése. Az erőforrásnevek egyediek. Egy objektum törlése révén újból létrehozhatja azt ugyanazzal a névvel.
Az oktatóanyag mintakódja ellenőrzi a meglévő indexeket, és törli őket, hogy újrafuttassa a kódot.
Az Indexek törléséhez az Azure Portalt is használhatja.
Az erőforrások rendbetétele
Ha a saját előfizetésében dolgozik, érdemes a projekt végén eltávolítani a már nem szükséges erőforrásokat. A továbbra is futó erőforrások költségekkel járhatnak. Az erőforrásokat törölheti egyesével, vagy az erőforráscsoport törlésével eltávolíthatja a benne lévő összes erőforrást is.
Az erőforrásokat az Azure Portalon, a bal oldali navigációs panel Minden erőforrás vagy erőforráscsoport hivatkozásával keresheti meg és kezelheti.
Következő lépés
A nagy mennyiségű adatok indexelésével kapcsolatos további információkért próbálja ki az alábbi oktatóanyagot: