Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
Berlaku untuk:✅ Fabric Rekayasa Data dan Sains Data
Pelajari cara mengirimkan pekerjaan sesi Spark menggunakan Livy API untuk Fabric Data Engineering.
Prasyarat
Klien jarak jauh seperti Visual Studio Code dengan Jupyter Notebooks, PySpark, dan Pustaka Autentikasi Microsoft (MSAL) untuk Python
Salah satu token aplikasi Microsoft Entra. Mendaftarkan aplikasi pada platform identitas Microsoft
Atau token SPN Microsoft Entra. Tambahkan dan kelola kredensial aplikasi di Microsoft Entra
Beberapa data di lakehouse Anda, pada contoh ini menggunakan
Komisi Taksi & Limousine NYC green_tripdata_2022_08 sebuah file parquet yang dimuat ke lakehouse
Livy API mendefinisikan titik akhir terpadu untuk operasi. Ganti placeholder {Entra_TenantID}, {Entra_ClientID}, {Fabric_WorkspaceID}, {Fabric_LakehouseID} dengan nilai yang sesuai saat Anda mengikuti contoh di artikel ini.
Mengonfigurasi Visual Studio Code untuk Sesi API Livy Anda
Pilih Pengaturan Lakehouse di Lakehouse Fabric Anda.
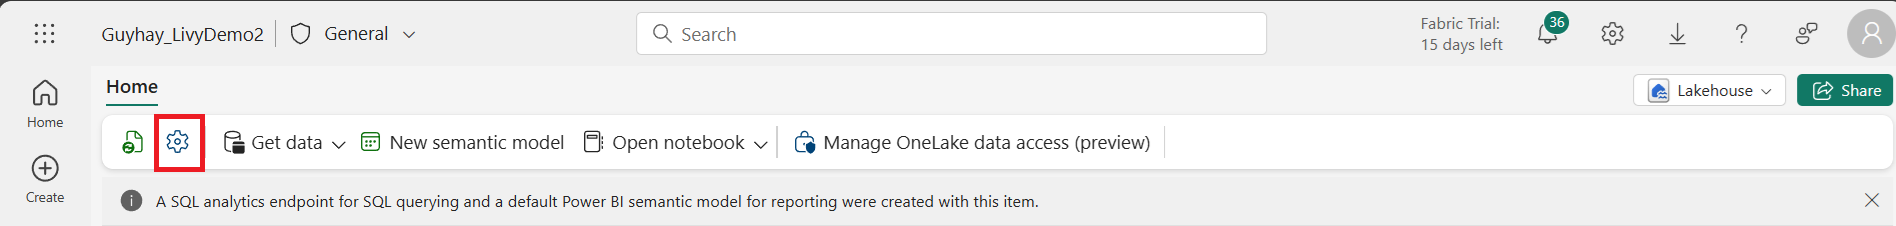
Navigasikan ke bagian titik akhir Livy.
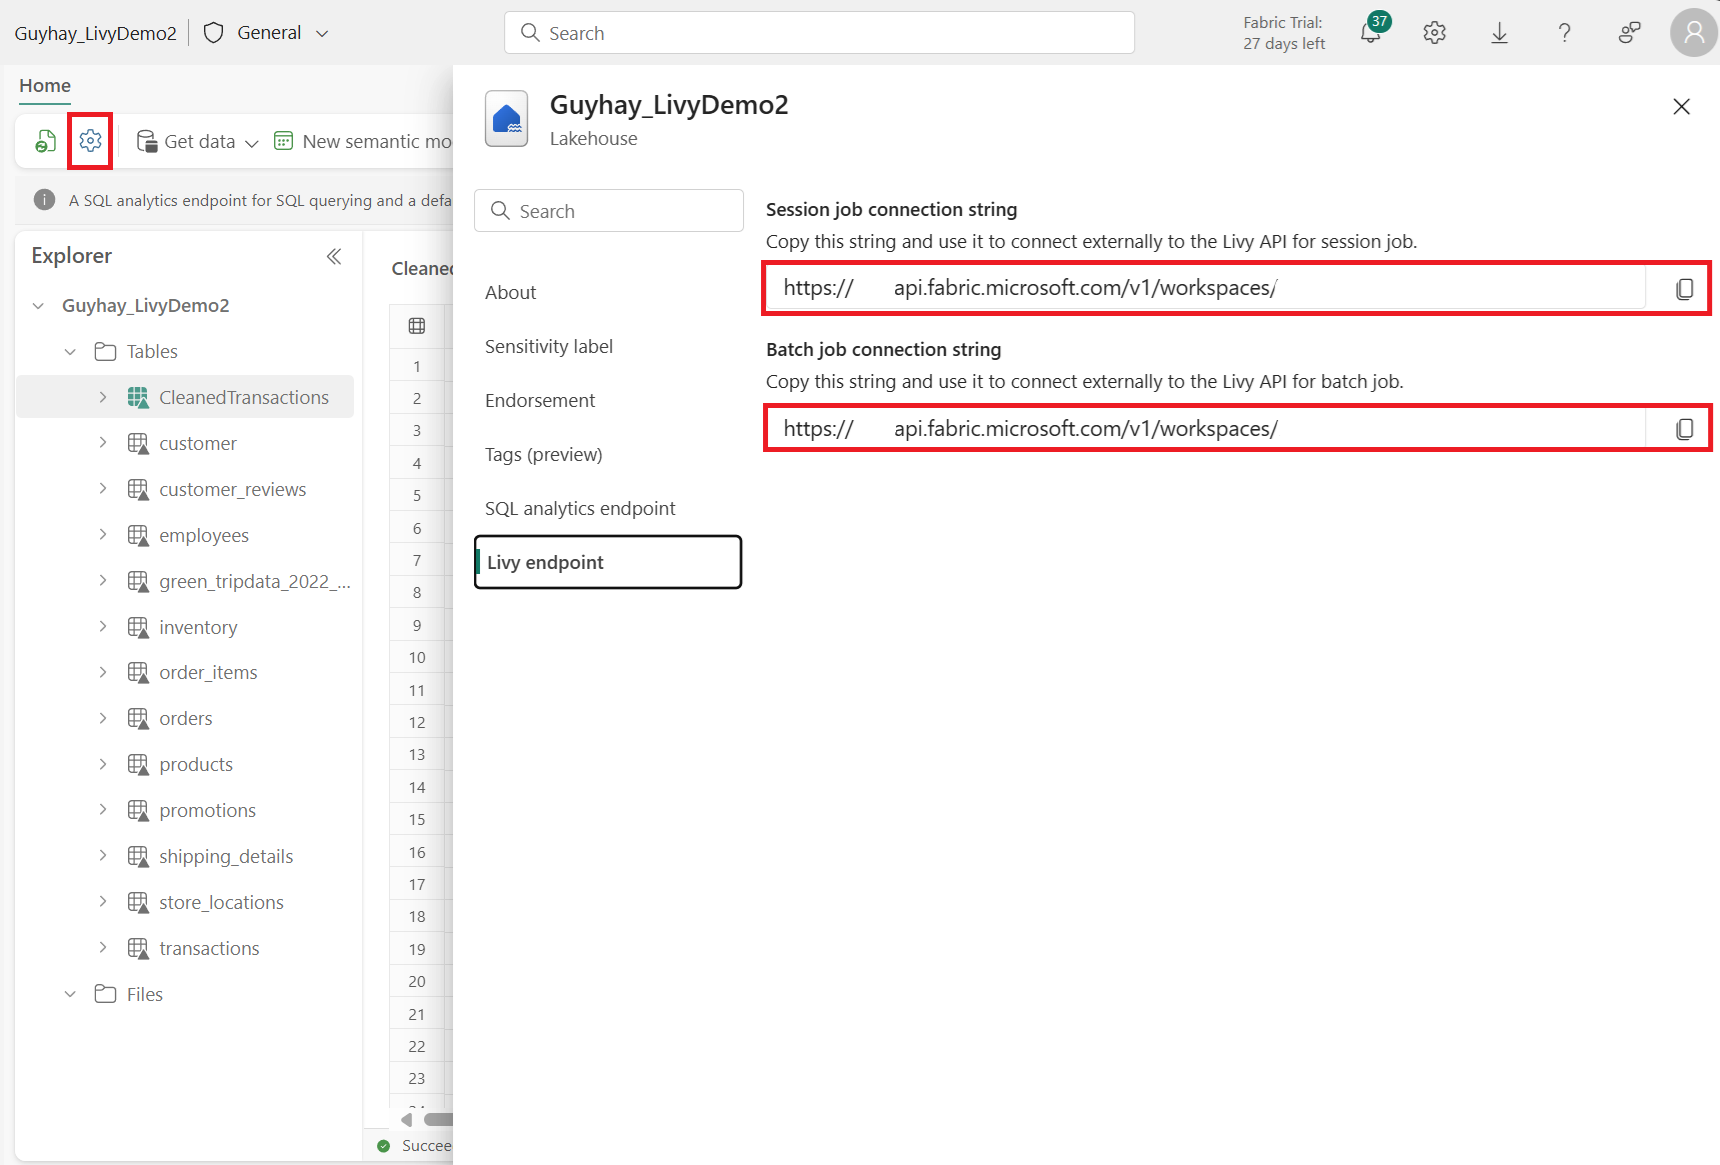
Salin job Sesi string koneksi (kotak merah pertama dalam gambar) ke dalam kode Anda.
Navigasi ke pusat admin Microsoft Entra dan salin ID Aplikasi (klien) dan ID Direktori (penyewa) ke kode Anda.
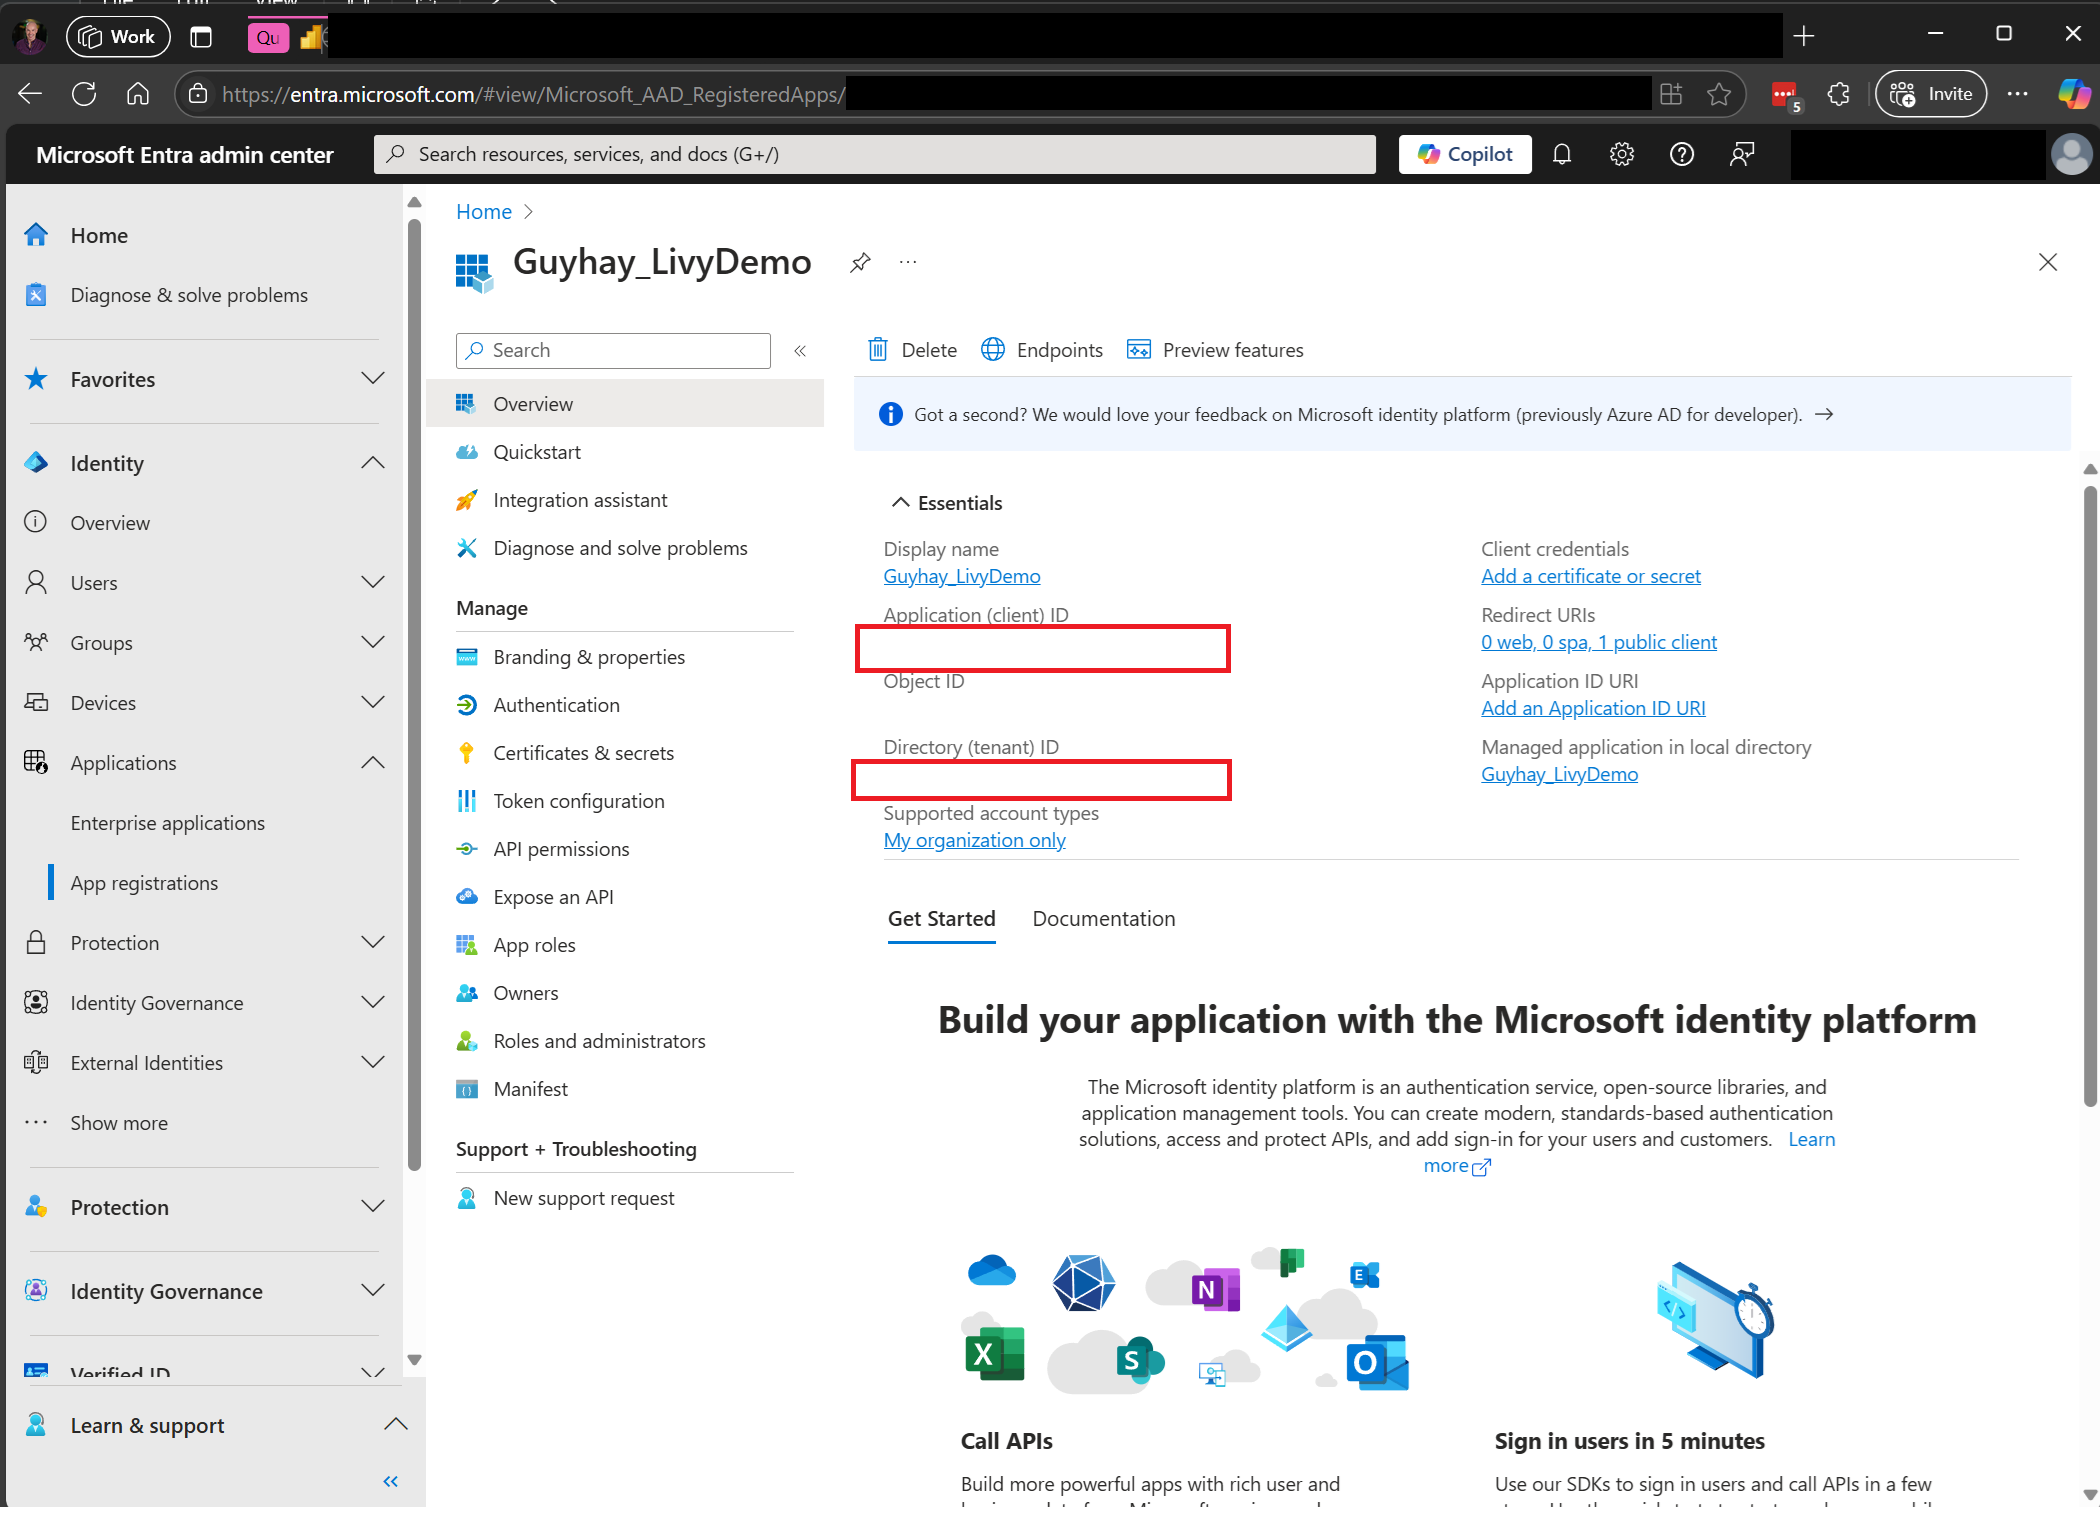
Mengautentikasi sesi Livy API Spark menggunakan token pengguna Microsoft Entra atau token SPN Microsoft Entra
Mengautentikasi sesi Livy API Spark menggunakan token SPN Microsoft Entra
Buat buku catatan
.ipynbdi Visual Studio Code dan sisipkan kode berikut.import sys from msal import ConfidentialClientApplication # Configuration - Replace with your actual values tenant_id = "Entra_TenantID" # Microsoft Entra tenant ID client_id = "Entra_ClientID" # Service Principal Application ID # Certificate paths - Update these paths to your certificate files certificate_path = "PATH_TO_YOUR_CERTIFICATE.pem" # Public certificate file private_key_path = "PATH_TO_YOUR_PRIVATE_KEY.pem" # Private key file certificate_thumbprint = "YOUR_CERTIFICATE_THUMBPRINT" # Certificate thumbprint # OAuth settings audience = "https://analysis.windows.net/powerbi/api/.default" authority = f"https://login.windows.net/{tenant_id}" def get_access_token(client_id, audience, authority, certificate_path, private_key_path, certificate_thumbprint=None): """ Get an app-only access token for a Service Principal using OAuth 2.0 client credentials flow. This function uses certificate-based authentication which is more secure than client secrets. Args: client_id (str): The Service Principal's client ID audience (str): The audience for the token (resource scope) authority (str): The OAuth authority URL certificate_path (str): Path to the certificate file (.pem format) private_key_path (str): Path to the private key file (.pem format) certificate_thumbprint (str): Certificate thumbprint (optional but recommended) Returns: str: The access token for API authentication Raises: Exception: If token acquisition fails """ try: # Read the certificate from PEM file with open(certificate_path, "r", encoding="utf-8") as f: certificate_pem = f.read() # Read the private key from PEM file with open(private_key_path, "r", encoding="utf-8") as f: private_key_pem = f.read() # Create the confidential client application app = ConfidentialClientApplication( client_id=client_id, authority=authority, client_credential={ "private_key": private_key_pem, "thumbprint": certificate_thumbprint, "certificate": certificate_pem } ) # Acquire token using client credentials flow token_response = app.acquire_token_for_client(scopes=[audience]) if "access_token" in token_response: print("Successfully acquired access token") return token_response["access_token"] else: raise Exception(f"Failed to retrieve token: {token_response.get('error_description', 'Unknown error')}") except FileNotFoundError as e: print(f"Certificate file not found: {e}") sys.exit(1) except Exception as e: print(f"Error retrieving token: {e}", file=sys.stderr) sys.exit(1) # Get the access token token = get_access_token(client_id, audience, authority, certificate_path, private_key_path, certificate_thumbprint)Jalankan sel notebook. Anda akan melihat token Microsoft Entra dikembalikan.
Mengautentikasi sesi Livy API Spark menggunakan token pengguna Microsoft Entra
Buat buku catatan
.ipynbdi Visual Studio Code dan sisipkan kode berikut.from msal import PublicClientApplication import requests import time # Configuration - Replace with your actual values tenant_id = "Entra_TenantID" # Microsoft Entra tenant ID client_id = "Entra_ClientID" # Application ID (can be the same as above or different) # Required scopes for Livy API access scopes = [ "https://api.fabric.microsoft.com/Lakehouse.Execute.All", # Required — execute operations in lakehouses "https://api.fabric.microsoft.com/Lakehouse.Read.All", # Required — read lakehouse metadata "https://api.fabric.microsoft.com/Code.AccessFabric.All", # Required — general Fabric API access from Spark Runtime "https://api.fabric.microsoft.com/Code.AccessStorage.All", # Required — access OneLake and Azure storage from Spark Runtime ] # Optional scopes — add these only if your Spark jobs need access to the corresponding services: # "https://api.fabric.microsoft.com/Code.AccessAzureKeyvault.All" # Optional — access Azure Key Vault from Spark Runtime # "https://api.fabric.microsoft.com/Code.AccessAzureDataLake.All" # Optional — access Azure Data Lake Storage Gen1 from Spark Runtime # "https://api.fabric.microsoft.com/Code.AccessAzureDataExplorer.All" # Optional — access Azure Data Explorer from Spark Runtime # "https://api.fabric.microsoft.com/Code.AccessSQL.All" # Optional — access Azure SQL audience tokens from Spark Runtime def get_access_token(tenant_id, client_id, scopes): """ Get an access token using interactive authentication. This method will open a browser window for user authentication. Args: tenant_id (str): The Microsoft Entra tenant ID client_id (str): The application client ID scopes (list): List of required permission scopes Returns: str: The access token, or None if authentication fails """ app = PublicClientApplication( client_id, authority=f"https://login.microsoftonline.com/{tenant_id}" ) print("Opening browser for interactive authentication...") token_response = app.acquire_token_interactive(scopes=scopes) if "access_token" in token_response: print("Successfully authenticated") return token_response["access_token"] else: print(f"Authentication failed: {token_response.get('error_description', 'Unknown error')}") return None # Uncomment the lines below to use interactive authentication token = get_access_token(tenant_id, client_id, scopes) print("Access token acquired via interactive login")Jalankan sel notebook. Anda akan melihat token Microsoft Entra dikembalikan.
Memahami cakupan untuk "Code.*" pada Livy API
Saat tugas Spark Anda berjalan melalui Livy API, Code.* cakupan mengontrol layanan eksternal apa yang dapat diakses oleh Spark Runtime atas nama pengguna yang diautentikasi. Dua diperlukan; sisanya bersifat opsional tergantung pada beban kerja Anda.
Cakupan Kode yang Diperlukan.*
| Ruang lingkup | Deskripsi |
|---|---|
Code.AccessFabric.All |
Memungkinkan mendapatkan token akses ke Fabric. Diperlukan untuk semua operasi Livy API. |
Code.AccessStorage.All |
Memungkinkan mendapatkan token akses ke OneLake dan penyimpanan Azure. Diperlukan untuk membaca dan menulis data di lakehouse. |
Cakupan Kode Opsional.*
Tambahkan cakupan ini hanya jika pekerjaan Spark Anda perlu mengakses layanan Azure yang sesuai saat runtime.
| Ruang lingkup | Deskripsi | Kapan digunakan |
|---|---|---|
Code.AccessAzureKeyvault.All |
Memungkinkan mendapatkan token akses ke Azure Key Vault. | Kode Spark Anda mengambil rahasia, kunci, atau sertifikat dari Azure Key Vault. |
Code.AccessAzureDataLake.All |
Memungkinkan mendapatkan token akses ke Azure Data Lake Storage Gen1. | Kode Spark Anda membaca dari atau menulis ke akun Azure Data Lake Storage Gen1. |
Code.AccessAzureDataExplorer.All |
Memungkinkan mendapatkan token akses ke Azure Data Explorer (Kusto). | Kode Spark Anda mengkueri atau menyerap data ke/dari kluster Azure Data Explorer. |
Code.AccessSQL.All |
Memungkinkan mendapatkan token akses ke Azure SQL. | Kode Spark Anda perlu tersambung ke database Azure SQL. |
Nota
Cakupan Lakehouse.Execute.All dan Lakehouse.Read.All juga diperlukan, namun tidak termasuk dalam keluarga Code.*. Mereka memberikan izin untuk menjalankan operasi serta membaca metadata dari Fabric Lakehouse masing-masing.
Membuat sesi Livy API Spark
Petunjuk / Saran
Jika beban kerja Anda memerlukan eksekusi beberapa pernyataan Spark secara bersamaan, pertimbangkan untuk menggunakan sesi konkurensi tinggi sebagai gantinya. Sesi HC menyediakan konteks eksekusi independen yang berjalan secara paralel sementara sistem mengelola penggunaan kembali sesi Livy yang mendasarinya.
Tambahkan sel buku catatan lain dan sisipkan kode ini.
import json
import requests

api_base_url = "https://api.fabric.microsoft.com/"  # Base URL for Fabric APIs

# Fabric Resource IDs - Replace with your workspace and lakehouse IDs
workspace_id = "Fabric_WorkspaceID"
lakehouse_id = "Fabric_LakehouseID"

# Construct the Livy API session URL
# URL pattern: {base_url}/v1/workspaces/{workspace_id}/lakehouses/{lakehouse_id}/livyapi/versions/{api_version}/sessions
livy_api_session_url = (f"{api_base_url}v1/workspaces/{workspace_id}/lakehouses/{lakehouse_id}/"
                       f"livyapi/versions/2023-12-01/sessions")

# Set up authentication headers
headers = {"Authorization": f"Bearer {token}"}

print(f"Livy API URL: {livy_api_session_url}")
print("Creating Livy session...")

try:
    # Create a new Livy session with default configuration
    create_livy_session = requests.post(livy_api_session_url, headers=headers, json={})

    # Check if the request was successful
    if create_livy_session.status_code == 202:
        session_info = create_livy_session.json()
        print('Livy session creation request submitted successfully')
        print(f'Session Info: {json.dumps(session_info, indent=2)}')

        # Extract session ID for future operations
        livy_session_id = session_info['id']
        livy_session_url = f"{livy_api_session_url}/{livy_session_id}"

        print(f"Session ID: {livy_session_id}")
        print(f"Session URL: {livy_session_url}")

    else:
        print(f"Failed to create session. Status code: {create_livy_session.status_code}")
        print(f"Response: {create_livy_session.text}")

except requests.exceptions.RequestException as e:
    print(f"Network error occurred: {e}")
except json.JSONDecodeError as e:
    print(f"JSON decode error: {e}")
    print(f"Response text: {create_livy_session.text}")
except Exception as e:
    print(f"Unexpected error: {e}")
Jalankan sel buku catatan, Anda akan melihat satu baris dicetak saat sesi Livy dibuat.

Anda dapat memverifikasi bahwa sesi Livy dibuat dengan menggunakan [Lihat pekerjaan Anda di hub Pemantauan](#View pekerjaan Anda di hub Pemantauan).

Integrasi dengan lingkungan Fabric
Secara bawaan, sesi Livy API ini berjalan dengan kumpulan starter bawaan untuk ruang kerja. Sebagai alternatif, Anda dapat menggunakan Fabric Environments Create, konfigurasi, dan menggunakan lingkungan di Fabric untuk menyesuaikan pool Spark yang digunakan sesi API Livy untuk pekerjaan Spark ini. Untuk menggunakan lingkungan Fabric, perbarui sel notebook sebelumnya dengan payload json ini.
create_livy_session = requests.post(livy_base_url, headers = headers, json = {
    "conf" : {
        "spark.fabric.environmentDetails" : "{\"id\" : \""EnvironmentID""}"}
        }
)
Mengirimkan pernyataan spark.sql menggunakan sesi Livy API Spark
Tambahkan sel buku catatan lain dan sisipkan kode ini.
    # call get session API
import time

table_name = "green_tripdata_2022"

print("Checking session status...")

# Get current session status
get_session_response = requests.get(livy_session_url, headers=headers)
session_status = get_session_response.json()
print(f"Current session state: {session_status['state']}")

# Wait for session to become idle (ready to accept statements)
print("Waiting for session to become idle...")
while session_status["state"] != "idle":
    print(f"   Session state: {session_status['state']} - waiting 5 seconds...")
    time.sleep(5)
    get_session_response = requests.get(livy_session_url, headers=headers)
    session_status = get_session_response.json()

print("Session is now idle and ready to accept statements")

# Execute a Spark SQL statement
execute_statement_url = f"{livy_session_url}/statements"

# Define your Spark SQL query - Replace with your actual table and query
payload_data = {
    "code": "spark.sql(\"SELECT * FROM {table_name} WHERE column_name = 'some_value' LIMIT 10\").show()",
    "kind": "spark"  # Type of code (spark, pyspark, sql, etc.)
}

print("Submitting Spark SQL statement...")
print(f"Query: {payload_data['code']}")

try:
    # Submit the statement for execution
    execute_statement_response = requests.post(execute_statement_url, headers=headers, json=payload_data)

    if execute_statement_response.status_code == 200:
        statement_info = execute_statement_response.json()
        print('Statement submitted successfully')
        print(f"Statement Info: {json.dumps(statement_info, indent=2)}")

        # Get statement ID for monitoring
        statement_id = str(statement_info['id'])
        get_statement_url = f"{livy_session_url}/statements/{statement_id}"

        print(f"Statement ID: {statement_id}")

        # Monitor statement execution
        print("Monitoring statement execution...")
        get_statement_response = requests.get(get_statement_url, headers=headers)
        statement_status = get_statement_response.json()

        while statement_status["state"] != "available":
            print(f"   Statement state: {statement_status['state']} - waiting 5 seconds...")
            time.sleep(5)
            get_statement_response = requests.get(get_statement_url, headers=headers)
            statement_status = get_statement_response.json()

        # Retrieve and display results
        print("Statement execution completed!")
        if 'output' in statement_status and 'data' in statement_status['output']:
            results = statement_status['output']['data']['text/plain']
            print("Query Results:")
            print(results)
        else:
            print("No output data available")

    else:
        print(f"Failed to submit statement. Status code: {execute_statement_response.status_code}")
        print(f"Response: {execute_statement_response.text}")

except Exception as e:
    print(f"Error executing statement: {e}")
Jalankan sel buku catatan, Anda akan melihat beberapa baris inkremental yang dicetak saat pekerjaan dikirimkan dan hasilnya dikembalikan.


Mengirimkan pernyataan spark.sql kedua menggunakan sesi Livy API Spark
Tambahkan sel buku catatan lain dan sisipkan kode ini.
print("Executing additional Spark SQL statement...")

# Wait for session to be idle again
get_session_response = requests.get(livy_session_url, headers=headers)
session_status = get_session_response.json()

while session_status["state"] != "idle":
    print(f"   Waiting for session to be idle... Current state: {session_status['state']}")
    time.sleep(5)
    get_session_response = requests.get(livy_session_url, headers=headers)
    session_status = get_session_response.json()

# Execute another statement - Replace with your actual query
payload_data = {
    "code": f"spark.sql(\"SELECT COUNT(*) as total_records FROM {table_name}\").show()",
    "kind": "spark"
}

print(f"Executing query: {payload_data['code']}")

try:
    # Submit the second statement
    execute_statement_response = requests.post(execute_statement_url, headers=headers, json=payload_data)

    if execute_statement_response.status_code == 200:
        statement_info = execute_statement_response.json()
        print('Second statement submitted successfully')

        statement_id = str(statement_info['id'])
        get_statement_url = f"{livy_session_url}/statements/{statement_id}"

        # Monitor execution
        print("Monitoring statement execution...")
        get_statement_response = requests.get(get_statement_url, headers=headers)
        statement_status = get_statement_response.json()

        while statement_status["state"] != "available":
            print(f"   Statement state: {statement_status['state']} - waiting 5 seconds...")
            time.sleep(5)
            get_statement_response = requests.get(get_statement_url, headers=headers)
            statement_status = get_statement_response.json()

        # Display results
        print("Second statement execution completed!")
        if 'output' in statement_status and 'data' in statement_status['output']:
            results = statement_status['output']['data']['text/plain']
            print("Query Results:")
            print(results)
        else:
            print("No output data available")

    else:
        print(f"Failed to submit second statement. Status code: {execute_statement_response.status_code}")

except Exception as e:
    print(f"Error executing second statement: {e}")
Jalankan sel buku catatan, Anda akan melihat beberapa baris inkremental yang dicetak saat pekerjaan dikirimkan dan hasilnya dikembalikan.


Mengakhiri sesi Livy
Tambahkan sel buku catatan lain dan sisipkan kode ini.
print("Cleaning up Livy session...")

try:
    # Check current session status before deletion
    get_session_response = requests.get(livy_session_url, headers=headers)
    if get_session_response.status_code == 200:
        session_info = get_session_response.json()
        print(f"Session state before deletion: {session_info.get('state', 'unknown')}")

    print(f"Deleting session at: {livy_session_url}")

    # Delete the session
    delete_response = requests.delete(livy_session_url, headers=headers)

    if delete_response.status_code == 200:
        print("Session deleted successfully")
    elif delete_response.status_code == 404:
        print("Session was already deleted or not found")
    else:
        print(f"Delete request completed with status code: {delete_response.status_code}")
        print(f"Response: {delete_response.text}")

    print(f"Delete response details: {delete_response}")

except requests.exceptions.RequestException as e:
    print(f"Network error during session deletion: {e}")
except Exception as e:
    print(f"Error during session cleanup: {e}")
Menampilkan pekerjaan Anda di hub Pemantauan
Anda dapat mengakses hub Pemantauan untuk melihat berbagai aktivitas Apache Spark dengan memilih Pantau di tautan navigasi sisi kiri.
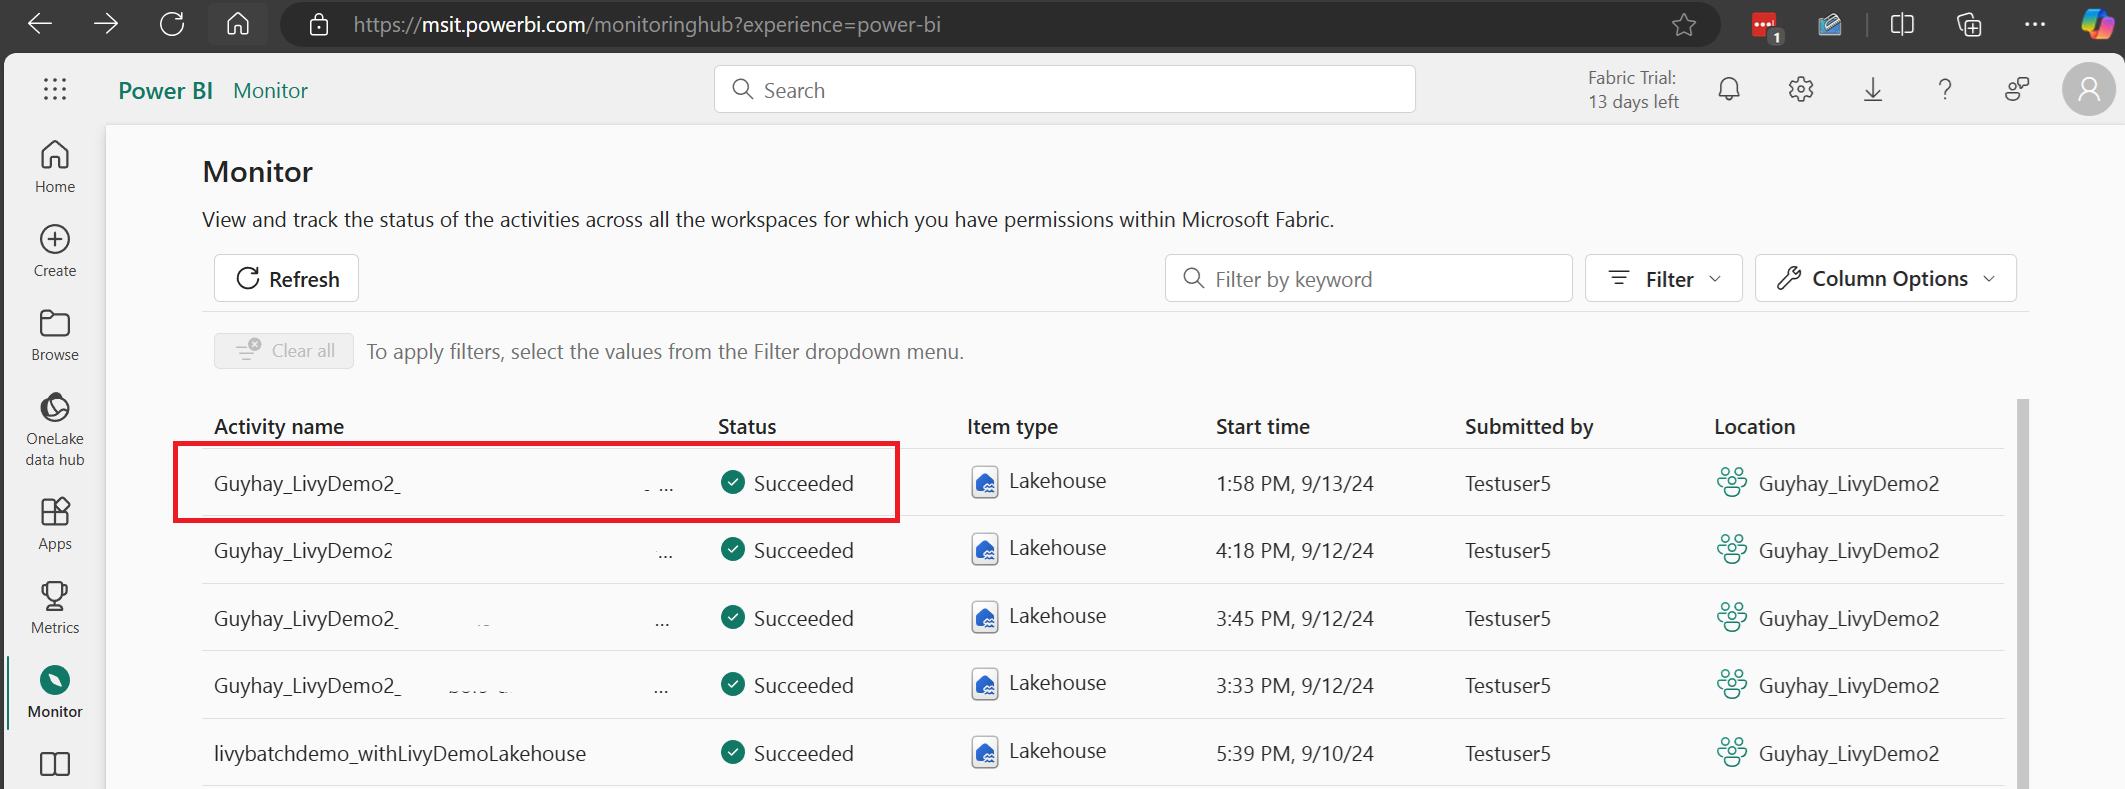
Saat sesi sedang berlangsung atau dalam status selesai, Anda dapat melihat status sesi dengan menavigasi ke Monitor.
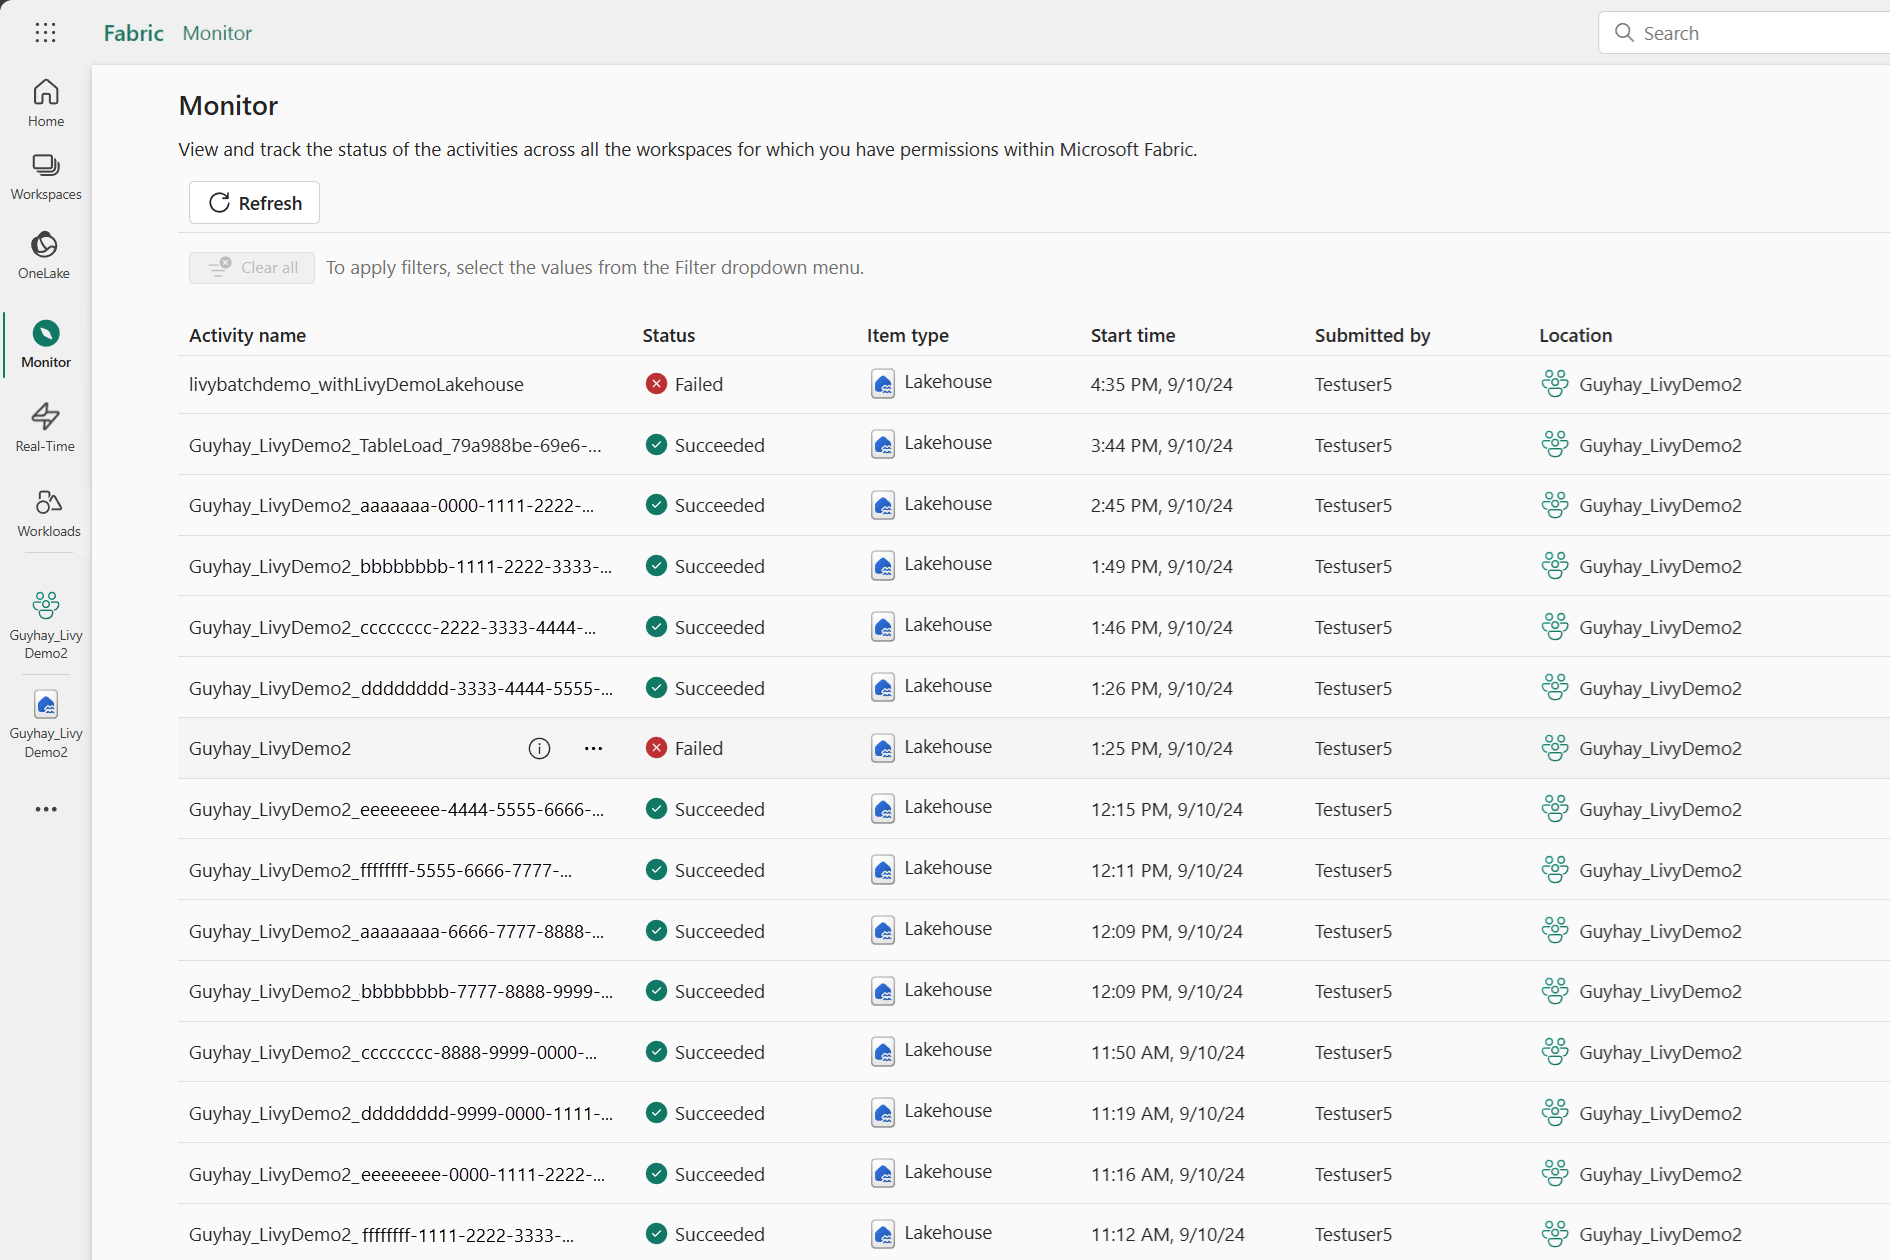
Pilih dan buka nama aktivitas terbaru.
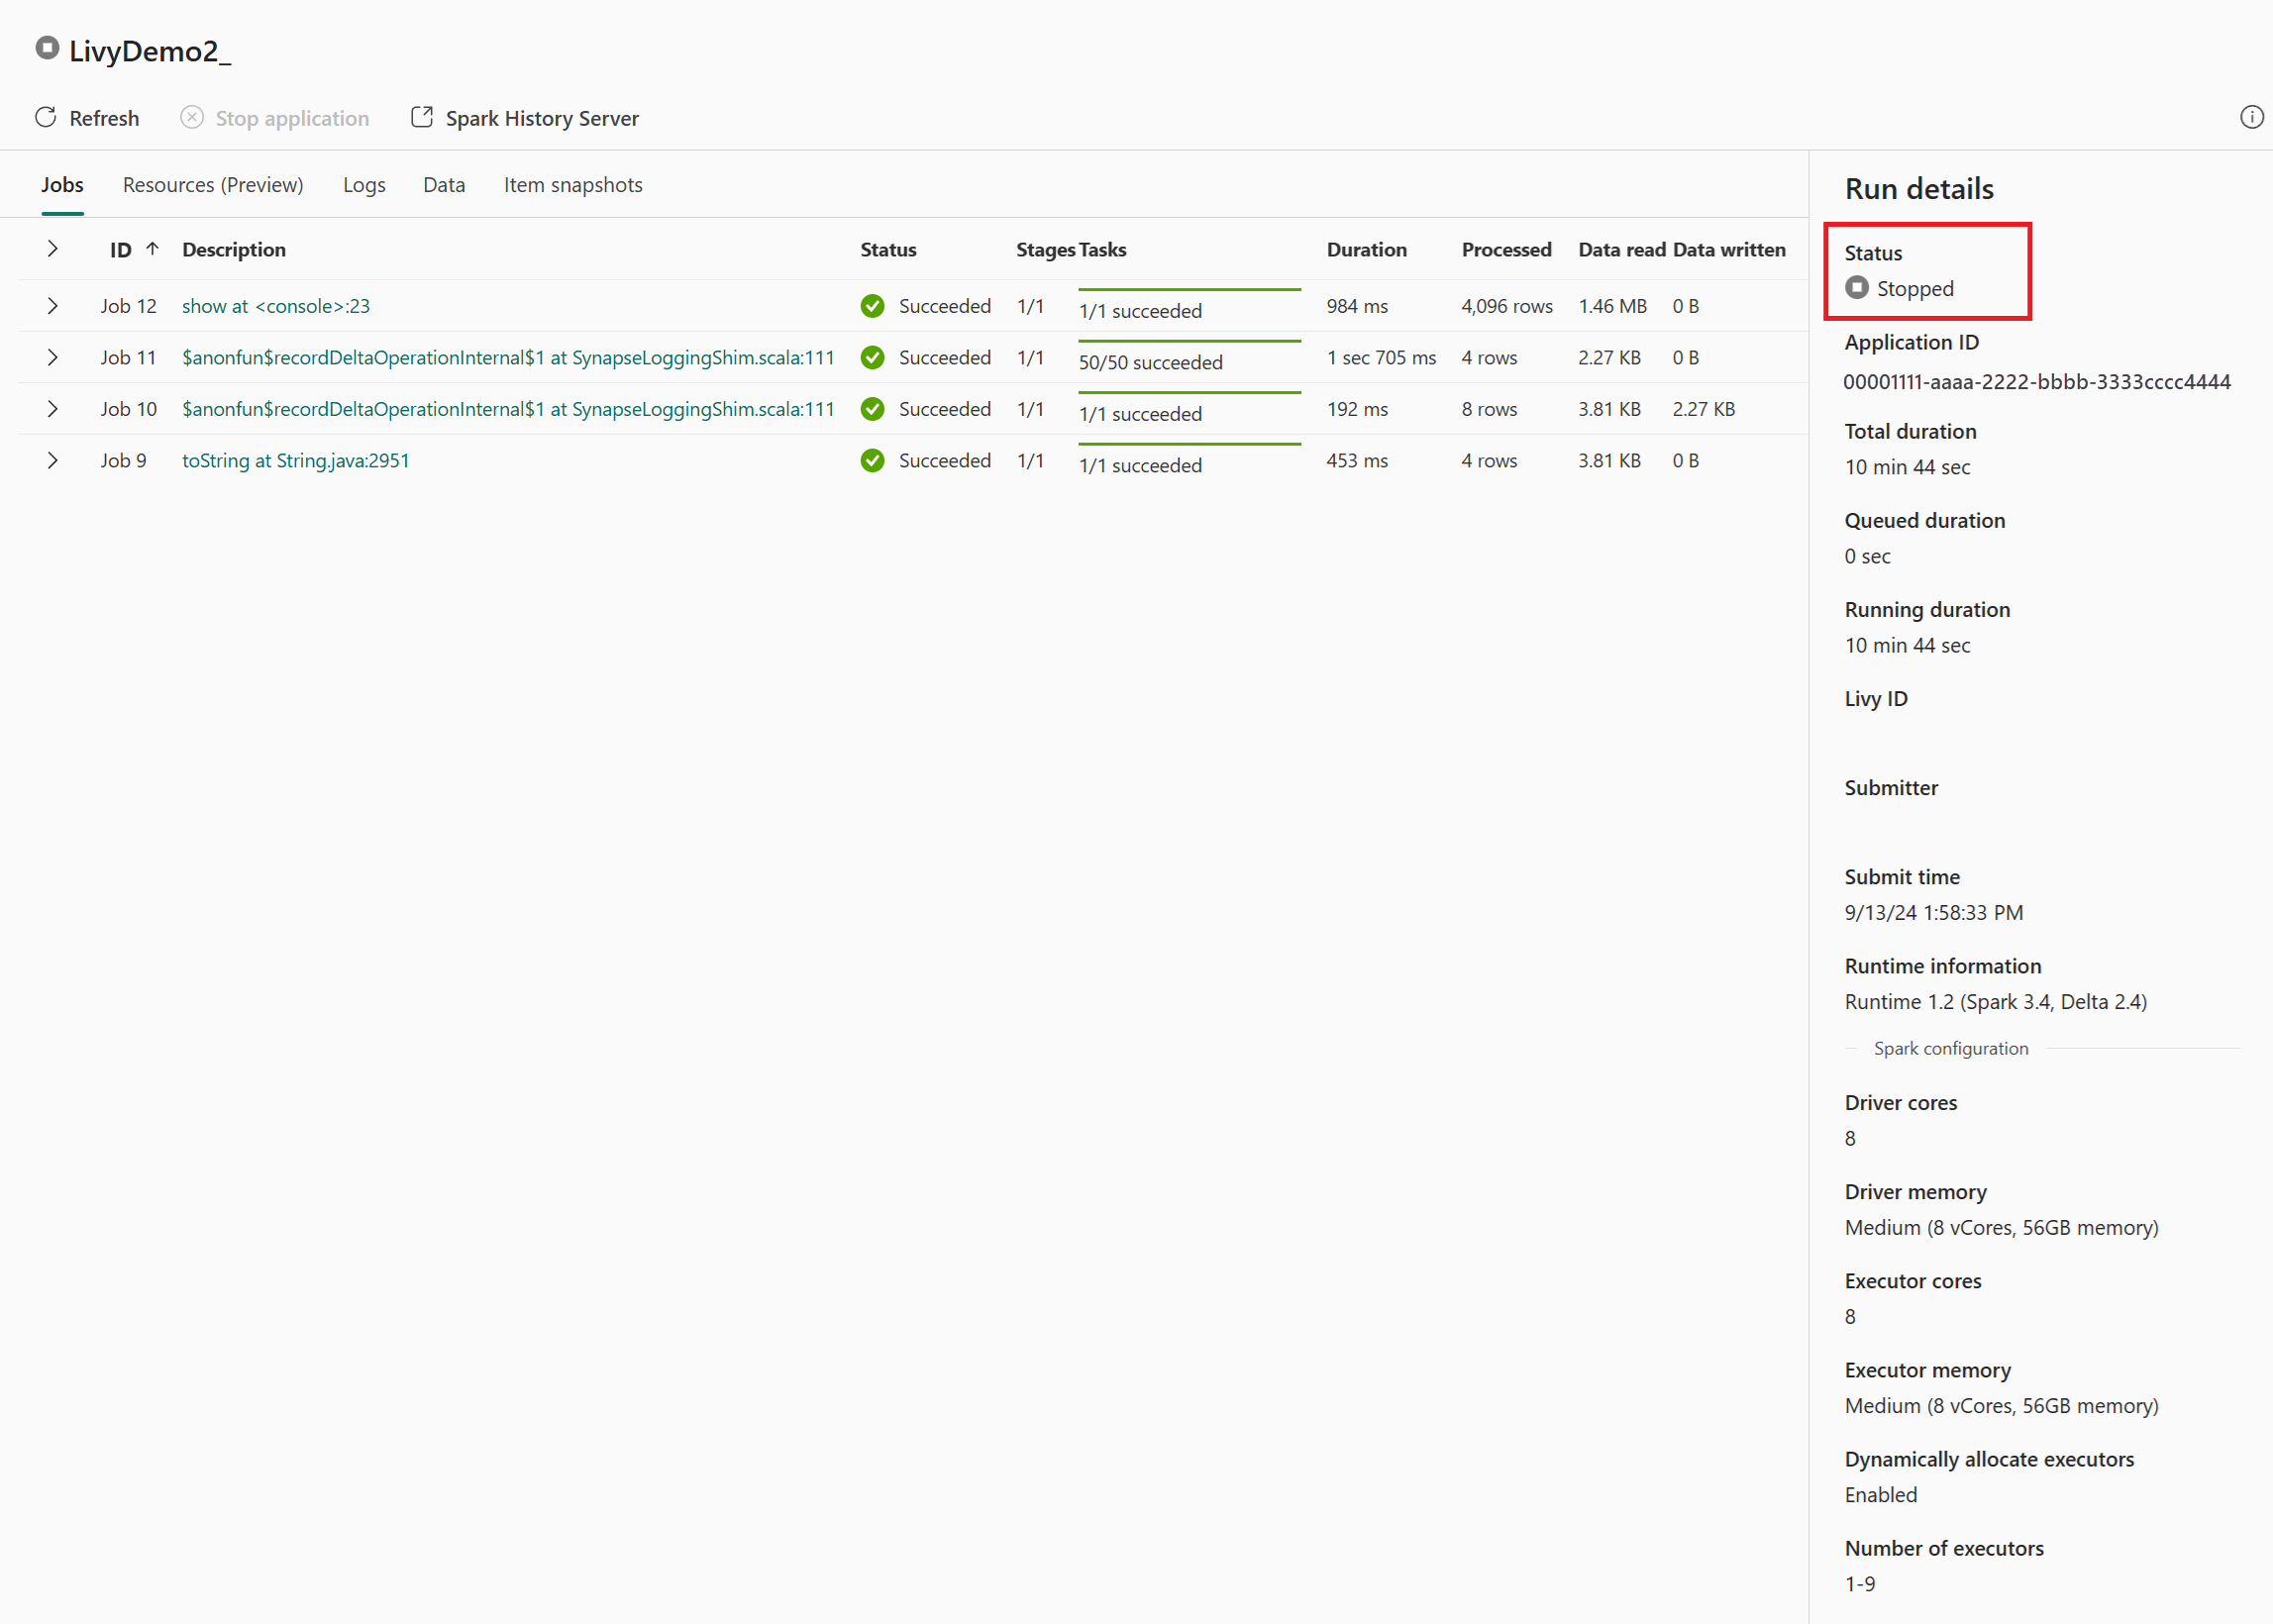
Dalam kasus sesi Livy API ini, Anda dapat melihat pengiriman sesi sebelumnya, detail eksekusi, versi Spark, dan konfigurasi. Perhatikan status berhenti di kanan atas.
Untuk merekap seluruh proses, Anda memerlukan klien jarak jauh seperti Visual Studio Code, token aplikasi/SPN Microsoft Entra, URL titik akhir LIVY API, autentikasi terhadap Lakehouse Anda, dan akhirnya API Session Livy.