Catatan
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba masuk atau mengubah direktori.
Akses ke halaman ini memerlukan otorisasi. Anda dapat mencoba mengubah direktori.
Dalam artikel ini, Anda mempelajari cara menggunakan Apache Spark MLlib untuk membuat aplikasi pembelajaran mesin yang menangani analisis prediktif pada himpunan data terbuka Azure. Spark menyediakan pustaka pembelajaran mesin bawaan. Contoh ini menggunakan klasifikasi melalui regresi logistik.
Tutorial ini mencakup langkah-langkah berikut:
- Siapkan notebook dan import
- Memuat dan mengambil sampel data taksi NYC
- Menyiapkan dan merekayasa fitur
- Menyandikan fitur kategorikal
- Melatih model regresi logistik
- Mengevaluasi dan memvisualisasikan hasil
Pustaka SparkML dan MLlib Spark inti menyediakan banyak utilitas yang berguna untuk tugas pembelajaran mesin. Utilitas ini cocok untuk:
- Klasifikasi
- Pengklusteran
- Pengujian hipotesis dan penghitungan statistik sampel
- Regresi
- Penguraian nilai tunggal (SVD) dan analisis komponen utama (PCA)
- Pemodelan topik
Prasyarat
Dapatkan langganan Microsoft Fabric. Atau, daftar untuk uji coba Microsoft Fabric gratis.
Masuk ke Microsoft Fabric.
Beralih ke Fabric dengan menggunakan pengalih pengalaman di sisi kiri bawah halaman beranda Anda.
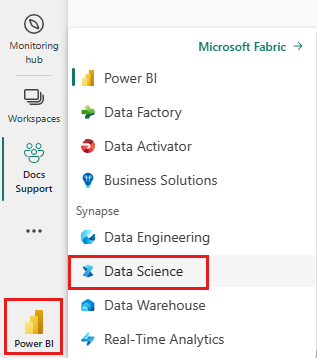
- Jika perlu, buat danau rumah Microsoft Fabric seperti yang diuraikan dalam Buat danau rumah dalam Microsoft Fabric.
- Buat buku catatan baru di ruang kerja Anda dengan memilih + lalu Notebook. Untuk informasi selengkapnya, lihat Membuat buku catatan.
Memahami klasifikasi dan regresi logistik
Klasifikasi, tugas pembelajaran mesin populer, melibatkan pengurutan data input ke dalam kategori. Algoritma klasifikasi mencari tahu cara menetapkan label ke data input yang disediakan. Misalnya, algoritma pembelajaran mesin dapat menerima informasi stok sebagai input dan membagi saham menjadi dua kategori: saham yang harus Anda jual dan saham yang harus Anda simpan.
Algoritma regresi logistik berguna untuk klasifikasi. API regresi logistik Spark berguna untuk klasifikasi biner data input ke dalam salah satu dari dua grup. Untuk informasi selengkapnya tentang regresi logistik, lihat Wikipedia.
Regresi logistik menghasilkan fungsi logistik yang memprediksi probabilitas bahwa vektor input termasuk dalam satu grup atau yang lain.
Contoh analisis prediktif data taksi NYC
Data tersedia melalui sumber daya Azure Open Datasets . Subset himpunan data ini menghosting informasi tentang perjalanan taksi kuning, termasuk waktu mulai, waktu akhir, lokasi mulai, lokasi akhir, biaya perjalanan, dan atribut lainnya.
Tutorial ini menggunakan Apache Spark untuk melakukan analisis pada data tip taksi-perjalanan NYC dan mengembangkan model untuk memprediksi apakah perjalanan tertentu menyertakan tip.
Buat model pembelajaran mesin Apache Spark
Buat buku catatan PySpark. Untuk informasi selengkapnya, lihat Membuat buku catatan.
Setelah Anda membuat notebook, hubungkan notebook tersebut ke lakehouse dengan memilih Tambahkan lakehouse di panel kiri.
Impor tipe yang diperlukan untuk buku catatan ini. Tempelkan kode berikut ke sel pertama dan jalankan.
import matplotlib.pyplot as plt from pyspark.sql.functions import unix_timestamp, date_format, col, when from pyspark.ml import Pipeline from pyspark.ml.feature import RFormula from pyspark.ml.feature import OneHotEncoder, StringIndexer from pyspark.ml.classification import LogisticRegression from pyspark.ml.evaluation import BinaryClassificationEvaluatorVerifikasi: Sel selesai tanpa
ImportError. Jika Anda melihat kesalahan, konfirmasikan buku catatan Anda menggunakan runtime PySpark.Gunakan MLflow untuk melacak eksperimen pembelajaran mesin dan eksekusi yang sesuai. Jika Microsoft Fabric Autologging diaktifkan, metrik dan parameter yang sesuai akan diambil secara otomatis.
import mlflowVerifikasi: Sel selesai tanpa kesalahan. Jalankan
print(mlflow.__version__)untuk mengonfirmasi bahwa MLflow tersedia.
Menyusun DataFrame input
Contoh ini memuat data dari penyimpanan Azure Open Datasets ke dalam Apache Spark DataFrame. Kemudian, Anda menerapkan operasi Spark untuk membersihkan dan memfilter himpunan data.
Tempelkan kode berikut ke sel baru dan jalankan untuk membuat Spark DataFrame. Langkah ini mengambil data taksi kuning NYC yang difilter hingga Mei 2018.
blob_account_name = "azureopendatastorage" blob_container_name = "nyctlc" blob_relative_path = "yellow" wasbs_path = f"wasbs://{blob_container_name}@{blob_account_name}.blob.core.windows.net/{blob_relative_path}" nyc_tlc_df = spark.read.parquet(wasbs_path) \ .filter((col("tpepPickupDateTime") >= "2018-05-01") & (col("tpepPickupDateTime") < "2018-06-01")) \ .repartition(20)Verifikasi: Jalankan sel berikut untuk mengonfirmasi pemuatan data dengan sukses.
print(f"Loaded {nyc_tlc_df.count()} rows")
# Expected output: Loaded approximately 9,000,000+ rows
Sampel himpunan data untuk mempercepat pengembangan dan pelatihan.
# Sample without replacement to avoid duplicates sampled_taxi_df = nyc_tlc_df.sample(False, 0.001, seed=1234)Verifikasi: Pastikan ukuran sampel dapat dikelola.
print(f"Sampled {sampled_taxi_df.count()} rows")
# Expected output: Sampled approximately 9,000-10,000 rows
Lihat data dengan menggunakan perintah bawaan
display()untuk menjelajahi sampel data.display(sampled_taxi_df.limit(10))Verifikasi: Tabel dengan 10 baris muncul memperlihatkan kolom seperti
tpepPickupDateTime, ,fareAmounttipAmount, dantripDistance.
Menyiapkan data
Persiapan data adalah langkah penting dalam proses pembelajaran mesin. Ini melibatkan pembersihan, transformasi, dan pengorganisasian data mentah agar cocok untuk analisis dan pemodelan. Di bagian ini, lakukan beberapa langkah persiapan data:
- Filter himpunan data untuk menghapus outlier dan nilai yang salah.
- Hapus kolom yang tidak diperlukan untuk pelatihan model.
- Buat kolom baru dari data mentah.
- Buat label untuk menentukan apakah perjalanan taksi tertentu melibatkan tip.
Jalankan kode berikut untuk memilih kolom yang relevan, menghitung fitur turunan, dan memfilter outlier:
taxi_df = sampled_taxi_df.select('totalAmount', 'fareAmount', 'tipAmount', 'paymentType', 'rateCodeId', 'passengerCount',
                    'tripDistance', 'tpepPickupDateTime', 'tpepDropoffDateTime',
                    date_format('tpepPickupDateTime', 'HH').cast('integer').alias('pickupHour'),
                    date_format('tpepPickupDateTime', 'EEEE').alias('weekdayString'),
                    (unix_timestamp(col('tpepDropoffDateTime')) - unix_timestamp(col('tpepPickupDateTime'))).alias('tripTimeSecs'),
                    (when(col('tipAmount') > 0, 1).otherwise(0)).alias('tipped')
                    ) \
            .filter((sampled_taxi_df.passengerCount > 0) & (sampled_taxi_df.passengerCount < 8)
                    & (sampled_taxi_df.tipAmount >= 0) & (sampled_taxi_df.tipAmount <= 25)
                    & (sampled_taxi_df.fareAmount >= 1) & (sampled_taxi_df.fareAmount <= 250)
                    & (sampled_taxi_df.tipAmount < sampled_taxi_df.fareAmount)
                    & (sampled_taxi_df.tripDistance > 0) & (sampled_taxi_df.tripDistance <= 100)
                    & (sampled_taxi_df.rateCodeId <= 5)
                    & (sampled_taxi_df.paymentType.isin({"1", "2"}))
                    )
Important
Fungsi ini date_format menggunakan pola 'HH' (format 24 jam, nilai 0-23) daripada 'hh' (format 12 jam, nilai 1-12). Format 24 jam diperlukan untuk logika pengelompokan waktu dalam sehari berikut.
Selanjutnya, tambahkan fitur pengelompokan waktu lalu lintas berdasarkan jam dalam sehari:
taxi_featurised_df = taxi_df.select('totalAmount', 'fareAmount', 'tipAmount', 'paymentType', 'passengerCount',
                                    'tripDistance', 'weekdayString', 'pickupHour', 'tripTimeSecs', 'tipped',
                                    when((col('pickupHour') <= 6) | (col('pickupHour') >= 20), "Night")
                                    .when((col('pickupHour') >= 7) & (col('pickupHour') <= 10), "AMRush")
                                    .when((col('pickupHour') >= 11) & (col('pickupHour') <= 15), "Afternoon")
                                    .when((col('pickupHour') >= 16) & (col('pickupHour') <= 19), "PMRush")
                                    .otherwise("Other").alias('trafficTimeBins')
                                    ) \
                            .filter((taxi_df.tripTimeSecs >= 30) & (taxi_df.tripTimeSecs <= 7200))
Verifikasi: Pastikan interval waktu lalu lintas terdistribusi dengan benar.
taxi_featurised_df.groupBy('trafficTimeBins').count().show()
# Expected output: Shows counts for Night, AMRush, Afternoon, PMRush categories
Membuat model regresi logistik
Tugas akhir mengonversi data berlabel menjadi format yang dapat ditangani oleh regresi logistik. Input ke algoritma regresi logistik harus memiliki struktur pasangan vektor label/fitur, di mana vektor fitur tersebut adalah sekumpulan angka yang mewakili titik input.
Konversi kolom kategoris trafficTimeBins dan weekdayString menjadi representasi bilangan bulat dengan menggunakan OneHotEncoder pendekatan :
# Convert categorical features into numeric representations
sI1 = StringIndexer(inputCol="trafficTimeBins", outputCol="trafficTimeBinsIndex")
en1 = OneHotEncoder(inputCol="trafficTimeBinsIndex", outputCol="trafficTimeBinsVec")
sI2 = StringIndexer(inputCol="weekdayString", outputCol="weekdayIndex")
en2 = OneHotEncoder(inputCol="weekdayIndex", outputCol="weekdayVec")

# Apply the encodings to create a new DataFrame
encoded_final_df = Pipeline(stages=[sI1, en1, sI2, en2]).fit(taxi_featurised_df).transform(taxi_featurised_df)
Verifikasi: Konfirmasikan DataFrame yang dikodekan memiliki kolom baru yang diharapkan.
print("Columns:", encoded_final_df.columns)
print(f"Row count: {encoded_final_df.count()}")
# Expected output: Columns list includes 'trafficTimeBinsVec' and 'weekdayVec'
Melatih model regresi logistik
Pisahkan himpunan data menjadi set pelatihan (70%) dan set pengujian (30%):
# Split the DataFrame into training and test sets
trainingFraction = 0.7
testingFraction = (1 - trainingFraction)
seed = 1234

train_data_df, test_data_df = encoded_final_df.randomSplit([trainingFraction, testingFraction], seed=seed)
Verifikasi: Pastikan pembagian menghasilkan ukuran yang wajar.
print(f"Training rows: {train_data_df.count()}, Test rows: {test_data_df.count()}")
# Expected output: Approximately 70%/30% split of the encoded data
Buat rumus model, latih model regresi logistik, dan evaluasi dengan menggunakan Kurva Area Di Bawah ROC (Karakteristik Operasi Penerima):
# Create a logistic regression model
logReg = LogisticRegression(maxIter=10, regParam=0.3, labelCol='label')

# Define the formula: 'tipped' is the response variable, right-hand side are predictors
classFormula = RFormula(formula="tipped ~ pickupHour + weekdayVec + passengerCount + tripTimeSecs + tripDistance + fareAmount + paymentType + trafficTimeBinsVec")

# Train the model using a pipeline
lrModel = Pipeline(stages=[classFormula, logReg]).fit(train_data_df)

# Generate predictions on the test dataset
predictions = lrModel.transform(test_data_df)

# Evaluate using Area Under ROC
evaluator = BinaryClassificationEvaluator(rawPredictionCol="rawPrediction", metricName="areaUnderROC")
auc = evaluator.evaluate(predictions)
print(f"Area under ROC = {auc}")
Verifikasi: Hasil menunjukkan bahwa ada nilai AUC. Model berkinerja baik menghasilkan nilai mendekati 1,0.
Area under ROC = 0.97 (approximately)
Note
Nilai AUC yang tepat bervariasi tergantung pada sampel data. Nilai di atas 0,90 menunjukkan performa prediktif yang kuat untuk himpunan data ini.
Membuat representasi visual dari prediksi
Buat visualisasi akhir untuk menginterpretasikan hasil model. Kurva ROC menyajikan tradeoff antara tingkat positif sejati dan tingkat positif palsu.
# Plot the ROC curve from the model training summary
modelSummary = lrModel.stages[-1].summary

# Extract FPR and TPR values as plain lists
roc_data = modelSummary.roc.select('FPR', 'TPR').toPandas()

plt.figure(figsize=(8, 6))
plt.plot([0, 1], [0, 1], 'r--', label='Random classifier')
plt.plot(roc_data['FPR'], roc_data['TPR'], label=f'Logistic Regression (AUC = {auc:.4f})')
plt.xlabel('False Positive Rate')
plt.ylabel('True Positive Rate')
plt.title('ROC Curve - NYC Taxi Tip Prediction')
plt.legend(loc='lower right')
plt.show()
Verifikasi: Sebuah plot muncul yang menampilkan kurva ROC di atas garis diagonal putus-putus berwarna merah. Kurva harus melengkung ke arah sudut kiri atas, yang menunjukkan kinerja klasifikasi yang kuat.

Membersihkan sumber daya
Setelah Anda menyelesaikan tutorial ini, hapus notebook dan lakehouse untuk membebaskan kapasitas ruang kerja:
- Di ruang kerja Anda, klik kanan buku catatan dan pilih Hapus.
- Jika Anda membuat lakehouse khusus untuk tutorial ini, klik kanan dan pilih Hapus.
Untuk menyimpan model yang telah dilatih untuk penggunaan di masa mendatang, tambahkan kode berikut sebelum proses pembersihan:
# Save the model to the lakehouse
model_path = "abfss://<your-workspace>@onelake.dfs.fabric.microsoft.com/<your-lakehouse>.Lakehouse/Files/models/taxi_tip_model"
lrModel.write().overwrite().save(model_path)
print(f"Model saved to: {model_path}")
Troubleshooting
| Masalah | Penyebab | Solusi |
|---|---|---|
Py4JJavaError saat membaca Parquet |
Konektivitas jaringan ke penyimpanan blob Azure | Verifikasi ruang kerja Fabric Anda memiliki akses internet keluar. Coba mulai ulang sesi Spark. |
AnalysisException: cannot resolve column |
Kesalahan ketik nama kolom atau ketidakcocokan skema | Jalankan nyc_tlc_df.printSchema() untuk memeriksa kolom yang tersedia. Skema himpunan data taksi NYC dapat berubah antara tahun. |
| DataFrame Kosong setelah pemfilteran | Kondisi filter terlalu ketat untuk jendela data | Tingkatkan rentang tanggal atau periksa sampled_taxi_df.count() sebelum pemfilteran. |
IllegalArgumentException di StringIndexer |
Label yang belum pernah terlihat selama transformasi | Tambahkan handleInvalid="skip" ke panggilan Anda StringIndexer : StringIndexer(inputCol="...", outputCol="...", handleInvalid="skip") |
| AUC rendah (di bawah 0,6) | Data tidak cukup atau rekayasa fitur yang salah | Tingkatkan fraksi sampel (misalnya, 0.01 alih-alih 0.001) dan pastikan kategori trafficTimeBins seimbang. |
OutOfMemoryError |
Himpunan data terlalu besar untuk kapasitas yang tersedia | Kurangi fraksi sampel atau tingkatkan tingkat kapasitas Fabric Anda. |
| Grafik ROC tidak tampil | Masalah backend Matplotlib di notebook | Tambahkan %matplotlib inline di bagian atas buku catatan. |
Konten terkait
- Menggunakan sampel AI untuk membangun model pembelajaran mesin: Menggunakan sampel AI
- Melacak eksekusi pembelajaran mesin menggunakan Eksperimen: Eksperimen pembelajaran mesin