Nota
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare ad accedere o modificare le directory.
L'accesso a questa pagina richiede l'autorizzazione. È possibile provare a modificare le directory.
Azure NetApp Files
Microsoft Fabric
Azure AI Search
Microsoft Foundry
Azure Machine Learning
Idee per soluzioni
In questo articolo viene descritta un'idea di soluzione. Il cloud architect può usare queste linee guida per visualizzare i componenti principali di un'implementazione tipica di questa architettura. Usa questo articolo come punto di partenza per progettare una soluzione ben architettata in linea con i requisiti specifici del tuo carico di lavoro.
Questa soluzione descrive in che modo l'API REST dell'oggetto Azure NetApp Files consente alle organizzazioni di usare i dati dei file aziendali esistenti per l'analisi e l'intelligenza artificiale senza prima copiarli in un archivio oggetti separato. Le applicazioni compatibili con Amazon S3 possono supportare la ricerca di documenti e l'analisi assistita dall'intelligenza artificiale, mentre i flussi di lavoro NFS e SMB esistenti continuano ad accedere a tali dati. Evitare una copia separata dei dati di origine può ridurre il tempo necessario per eseguire l'onboarding dei carichi di lavoro di analisi, ridurre i costi di archiviazione duplicati e rimuovere le pipeline di sincronizzazione che i team potrebbero altrimenti compilare, monitorare e risolvere i problemi. Un minor numero di repository di dati di origine significa anche un minor numero di copie da gestire e proteggere. Questo approccio supporta la modernizzazione incrementale senza richiedere alle organizzazioni di sostituire le applicazioni basate su file esistenti.
Architecture
Questa architettura è incentrata sull'integrazione Microsoft Fabric con Azure NetApp Files tramite l'API REST Object. Il diagramma mostra anche Azure Databricks come consumer di analisi alternativo degli stessi dati Azure NetApp Files. Non è necessario distribuire entrambe le piattaforme. Le applicazioni esistenti continuano ad accedere ai dati tramite NFS o SMB, a seconda dei requisiti di configurazione del volume e client.
Azure Databricks di calcolo accede all'endpoint DELL'API REST dell'oggetto Azure NetApp Files tramite richieste compatibili con S3 usando il connettore Hadoop S3A. Questo percorso di analisi alternativa non usa il gateway dati locale o Microsoft OneLake.
I servizi di intelligenza artificiale downstream nel diagramma sono illustrativi. L'integrazione dell'inserimento non viene visualizzata.
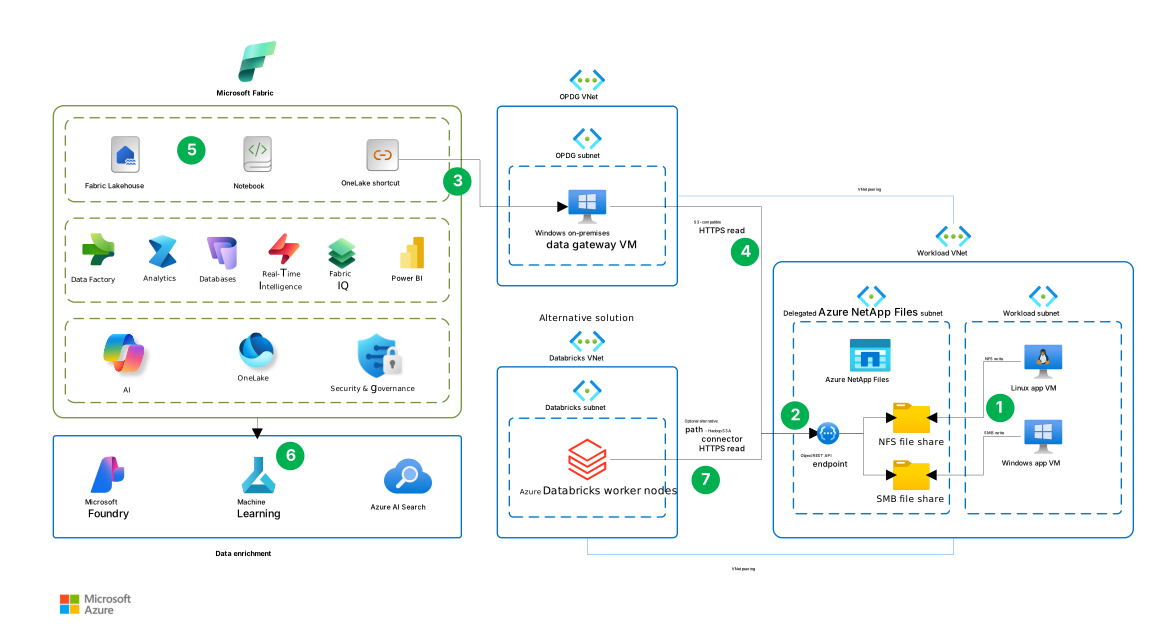
Scaricare un file di Visio di questa architettura.
Flusso di dati
Le interazioni numerate seguenti descrivono il diagramma dell'architettura. I passaggi da 1 a 5 descrivono il percorso Microsoft Fabric primario. Il passaggio 6 rappresenta l'arricchimento facoltativo dei dati downstream. Il passaggio 7 è un percorso di analisi alternativo, non una continuazione del flusso di Fabric. Le frecce con etichetta HTTPS read mostrano le richieste verso l'endpoint DELL'API REST object; i dati richiesti vengono restituiti al consumer.
Le applicazioni scrivono dati di file. Nella subnet Workload la macchina virtuale dell'applicazione Linux scrive nella condivisione file NFS e la macchina virtuale dell'applicazione Windows scrive nella condivisione file SMB. Azure NetApp Files ospita entrambe le condivisioni nella subnet delegata.
L'API REST Object espone i dati del file. L'endpoint nella subnet ANF delegata fornisce l'accesso compatibile con S3 alle directory configurate nei volumi Azure NetApp Files. Le connessioni dall'endpoint alle condivisioni NFS e SMB rappresentano l'accesso ai dati esistenti, non una copia in un archivio oggetti separato.
Fabric accede ai dati tramite un collegamento OneLake. Il collegamento fa riferimento ai dati Azure NetApp Files tramite una connessione che usa la macchina virtuale del gateway dati locale Windows nella subnet OPDG (gateway dati locale). Il collegamento OneLake è connesso a questo gateway.
Il gateway legge dall'API REST Object. Il gateway usa il peering tra la rete virtuale OPDG e la rete virtuale del carico di lavoro per raggiungere l'endpoint. Il percorso di lettura HTTPS compatibile con S3 connette il gateway all'endpoint, che accede ai dati del file di riferimento per Fabric. Per i requisiti di connessione, vedere Connettere OneLake a un volume Azure NetApp Files.
Fabric elabora e analizza i dati. I carichi di lavoro supportati Fabric utilizzano i dati tramite il collegamento. Ad esempio, i notebook leggono i file di riferimento e scrivono i risultati derivati nelle tabelle lakehouse per l'analisi e la creazione di report Power BI. La casella Fabric nel diagramma mostra queste funzionalità di elaborazione e analisi.
I servizi downstream facoltativi arricchiscono i dati. La freccia sotto Fabric conduce al gruppo di arricchimento dei dati, che contiene Microsoft Foundry, Azure Machine Learning e Azure AI Search. Questo passaggio rappresenta l'elaborazione downstream facoltativa. Il diagramma non mostra l'inserimento o l'orchestrazione necessaria per connettere questi servizi e il collegamento OneLake non stabilisce tali integrazioni.
In alternativa, Azure Databricks legge direttamente i dati del file. I nodi di lavoro nella subnet Databricks usano il connettore Hadoop S3A per inviare richieste di lettura HTTPS allo stesso endpoint DELL'API REST object sulle reti virtuali con peering. Questo percorso sostituisce il percorso di accesso e elaborazione Fabric nei passaggi da 3 a 5. Non passa attraverso il gateway dati locale o OneLake.
Scegliere il percorso di scelta rapida in base alla modalità di utilizzo dei dati:
- Tabelle Delta compatibili esistenti. Creare un collegamento a una tabella nella sezione Tabelle del lakehouse, destinata alla tabella Delta completa, incluso il log delle transazioni. Fabric riconosce la destinazione come tabella su cui è possibile eseguire query tramite Spark e l'endpoint di analisi SQL, mentre i dati di origine rimangono in Azure NetApp Files.
- File per l'accesso diretto o l'elaborazione. Creare collegamenti nella sezione File del lakehouse. I carichi di lavoro compatibili possono leggere file Parquet, CSV e JSON autonomi, oltre ai documenti, senza prima copiare i file di origine in OneLake. Quando l'analisi downstream richiede tabelle lakehouse, trasformare o caricare i dati di origine in tabelle Delta derivate in OneLake.
I file Parquet autonomi non sono automaticamente tabelle Delta. Un collegamento in File non registra automaticamente la destinazione come tabella. Per altre informazioni, vedere Dove posizionare i tasti di scelta rapida in una lakehouse.
Components
I componenti seguenti supportano l'architettura incentrata sul Fabric e l'alternativa facoltativa Azure Databricks.
Azure NetApp Files è un servizio di archiviazione file completamente gestito basato sulla tecnologia NetApp. In questa architettura archivia il set di dati aziendale e fornisce l'accesso a oggetti compatibili con NFS, SMB e S3 tramite l'API REST Object. Offre anche funzionalità di snapshot e replica.
Azure NetApp Files'API REST object espone i dati dei file esistenti tramite un'interfaccia compatibile con S3. In questa architettura consente alle applicazioni di analisi e intelligenza artificiale compatibili di accedere ai dati senza prima creare una copia separata di archiviazione degli oggetti. L'interfaccia supporta un subset di operazioni amazon S3. Verificare che le operazioni supportate soddisfino i requisiti dell'applicazione prima di scegliere questa integrazione.
Microsoft Fabric è una piattaforma di analisi che unifica lo spostamento dei dati, l'elaborazione dei dati, l'inserimento, la trasformazione, l'elaborazione dei flussi tramite Real-Time Intelligence e la creazione di report. In questa architettura, fornisce la piattaforma di analisi per l'elaborazione e l'analisi dei dati da Azure NetApp Files tramite collegamenti OneLake.
OneLake è il data lake logico unificato per Fabric. In questa architettura, i collegamenti a OneLake rendono disponibili i dati di Azure NetApp Files a cui si fa riferimento per i carichi di lavoro Fabric supportati.
Rete virtuale di Azure fornisce connettività privata tra le risorse Azure in questa architettura. Il peering di rete virtuale consente alla macchina virtuale gateway e alle risorse di calcolo facoltative Azure Databricks di raggiungere l'endpoint DELL'API REST dell'oggetto Azure NetApp Files.
Un gateway dati locale connette i collegamenti OneLake all'endpoint del bucket Azure NetApp Files. Nonostante il nome, in questa architettura, il gateway viene eseguito in modalità standard in una macchina virtuale Azure con un sistema operativo Windows supportato. Scegliere un'immagine che soddisfi i requisiti di installazione del gateway. Le installazioni dei componenti di base del server e i contenitori Windows non sono supportati. Il gateway avvia le connessioni in uscita tramite Inoltro di Azure per comunicare con Fabric. Non sono necessarie connessioni in ingresso da Fabric. Configurare il firewall o il proxy per consentire gli endpoint in uscita descritti in Modificare le impostazioni di comunicazione per il gateway dati locale.
Azure Databricks è una piattaforma di analisi alternativa facoltativa per i carichi di lavoro di ingegneria dei dati e machine learning. I processi Spark usano il connettore Hadoop S3A configurato per l'endpoint dell'API REST Object per accedere al set di dati Azure NetApp Files anziché usare il percorso di integrazione Fabric.
Alternative
Questa architettura include più componenti che è possibile sostituire con altri servizi o approcci di Azure, a seconda dei requisiti funzionali e non funzionali del carico di lavoro. Prendere in considerazione le alternative seguenti e i relativi compromessi.
Storage
Prendere in considerazione i requisiti del protocollo delle applicazioni e le prestazioni misurate quando si sceglie tra Archiviazione BLOB di Azure e Azure NetApp Files:
Scegliere gestione rete virtuale di Azure quando i client possono usare l'API REST gestione rete virtuale di Azure o NFS 3.0 e non richiedono SMB o NFS 4.1. Entrambe le interfacce possono accedere agli stessi dati. Il percorso di accesso NFS 3.0 gestione rete virtuale di Azure è ottimizzato per carichi di lavoro sequenziali con velocità effettiva elevata e con un numero elevato di operazioni di lettura in cui la velocità effettiva è più importante della bassa latenza.
Scegliere Azure NetApp Files quando le applicazioni e i carichi di lavoro di analisi devono accedere agli stessi file tramite SMB o NFS 4.1 e l'API REST dell'oggetto compatibile con S3 o quando le applicazioni file richiedono operazioni di I/O casuali a bassa latenza. Per i dati già in Azure NetApp Files, l'API REST Object aggiunge l'accesso alle analisi senza eseguire la migrazione di applicazioni o dati di origine.
Per entrambe le opzioni, misurare la latenza end-to-end e la velocità effettiva con il carico simultaneo di applicazioni di origine e analisi. Le prestazioni NFS o SMB non stabiliscono l'API REST object o le prestazioni Fabric, quindi testare il percorso di accesso previsto in base ai requisiti del carico di lavoro. Confrontare i costi totali, incluse le modifiche dell'applicazione, la migrazione e qualsiasi duplicazione e sincronizzazione in corso. Per un confronto tra protocolli e carichi di lavoro, vedere Confrontare Azure servizi di archiviazione.
Integration
Azure Databricks processi possono usare il connettore Hadoop S3A per leggere Azure NetApp Files dati tramite l'API REST Object, senza OneLake o il gateway dati locale. Configurare l'attendibilità TLS e le credenziali archiviate in modo sicuro e convalidare le operazioni di scrittura necessarie prima di basarsi sul writeback. Se sono necessari script di inizializzazione, usare gli script con ambito cluster archiviati nei volumi del catalogo Unity nelle risorse di calcolo supportate, seguendo le indicazioni correnti Azure Databricks init-script.
Dettagli dello scenario
Usare questo modello quando lo stesso set di dati deve servire applicazioni che prevedono un file system montato e un'analisi o servizi di intelligenza artificiale che prevedono un'interfaccia oggetto compatibile con S3.
Le applicazioni in esecuzione in macchine virtuali o in contenitori possono continuare a usare Azure NetApp Files tramite NFS o SMB. Ad esempio, possono usare il codice di accesso ai file, le condivisioni montate e le strutture di directory esistenti. L'API REST dell'oggetto Azure NetApp Files esegue il mapping della directory radice di un volume o di una sottodirectory a un bucket compatibile con S3 in modo che i client di oggetti compatibili possano accedere agli stessi file sottostanti.
Questo approccio è utile quando si vogliono aggiungere funzionalità di analisi o intelligenza artificiale ai carichi di lavoro esistenti basati su file senza modificare le applicazioni di origine per l'uso dell'archiviazione oggetti. I flussi di lavoro downstream possono comunque creare dati derivati, ad esempio set di dati trasformati, indici, incorporamenti e cache, in base alle esigenze.
Quando i client di file e oggetti accedono agli stessi dati, tenere conto delle differenze nei requisiti di identità, autorizzazioni, blocco e coerenza dell'applicazione. Definire il modo in cui i producer segnalano che un file o un batch viene completato prima che i consumer di oggetti lo eselaborino. I produttori devono terminare la scrittura e chiudere i file prima di segnalare la conformità e lasciare invariati i file durante l'elaborazione dei file. Testare questo handoff per le scritture interrotte e i tentativi di elaborazione.
I modelli di identità e autorizzazione differiscono anche tra i metodi di accesso. Le autorizzazioni originali per ogni file utente non vengono inserite automaticamente in Fabric. Configurare Fabric autorizzazioni per i consumer desiderati e assicurarsi che l'identità usata dall'API REST Object abbia accesso solo ai dati di origine necessari. Per altre informazioni, vedere Security.
Eseguire il mapping delle directory a bucket separati quando i consumer richiedono livelli di accesso diversi. La classificazione, la conservazione, l'autorizzazione downstream e la governance dei dati derivati rimangono responsabilità del carico di lavoro. Per altre informazioni, vedere Creare un bucket.
Casi d'uso potenziali
Questa architettura può supportare i carichi di lavoro che devono analizzare i dati strutturati o non strutturati già archiviati in Azure NetApp Files. Gli esempi seguenti illustrano diversi modi in cui Fabric possono utilizzare tali dati.
Documento in fase di elaborazione
Le applicazioni possono salvare documenti, immagini o altri file non strutturati in Azure NetApp Files usando NFS o SMB. Un notebook Fabric può leggere i file completati usando un collegamento OneLake e inviare il contenuto a un servizio di elaborazione documenti, ad esempio Azure Document Intelligence, per l'estrazione. Archiviare i dati strutturati risultanti nelle tabelle lakehouse per la convalida, l'analisi e la creazione di report.
Per indicazioni sull'integrazione, vedere Integrazione di Document Intelligence tramite SynapseML.
Analisi dei dati
Le applicazioni possono scrivere dati strutturati, ad esempio file CSV o Parquet, in una condivisione Azure NetApp Files. Fabric notebook possono leggere i file completati usando il collegamento OneLake, combinarli con altri dati lakehouse e scrivere risultati derivati nelle tabelle lakehouse.
Questo modello può supportare scenari come l'ingegneria e l'analisi della qualità, l'analisi dei dati dei sensori e la creazione di report operativi senza richiedere alle applicazioni di origine di modificare la modalità di archiviazione dei file.
Per i set di dati Delta compatibili esistenti, creare un collegamento OneLake nella sezione Tabelle del lakehouse destinata alla tabella Delta completa, incluso il log delle transazioni. Fabric può quindi riconoscere la destinazione come tabella e i dati di origine possono rimanere in Azure NetApp Files. Per altre informazioni, vedere Dove posizionare i tasti di scelta rapida in una lakehouse.
Ricerca e recupero di intelligenza artificiale
I documenti archiviati in Azure NetApp Files possono fungere anche da contenuto di origine per i carichi di lavoro di intelligenza artificiale. Ad esempio, un flusso di lavoro di elaborazione può leggere i documenti tramite il collegamento OneLake e usarli per compilare un indice Azure AI Search per la generazione aumentata di recupero (RAG).
L'indice di ricerca e gli eventuali incorporamenti sono dati derivati e vengono archiviati separatamente dai file di origine. Progettare il flusso di lavoro per mantenere sincronizzato il contenuto indicizzato con gli aggiornamenti, le ridenominazione e le eliminazioni di origine. Applicare anche i controlli di accesso appropriati durante il recupero del contenuto indicizzato perché le autorizzazioni SMB e NFS originali non diventano automaticamente autorizzazioni di ricerca per utente.
Lo stesso modello può essere esteso ad altri carichi di lavoro di intelligenza artificiale. Ad esempio, Fabric notebook possono preparare i set di dati dai file di origine e archiviare i dati preparati in OneLake per l'utilizzo da parte di Azure Machine Learning. Per le opzioni di integrazione e le limitazioni, vedere Integrare OneLake con Azure Machine Learning.
Considerations
Queste considerazioni implementano i pilastri di Azure Well-Architected Framework, che è un set di principi guida che possono essere usati per migliorare la qualità di un carico di lavoro. Per altre informazioni, vedere Well-Architected Framework. Per altre indicazioni, vedere Well-Architected Framework recommendations for Azure NetApp Files (Consigli diWell-Architected Framework per Azure NetApp Files).
Reliability
L'affidabilità garantisce che l'applicazione possa soddisfare gli impegni assunti dai clienti. Per maggiori informazioni, consultare la sezione Elenco di controllo per la revisione della progettazione per l'affidabilità.
Azure NetApp Files viene eseguito su una flotta bare metal a tolleranza di errore con tecnologia ONTAP e offre un contratto di servizio a disponibilità elevata. Per una protezione aggiuntiva dalle interruzioni della zona o dell'area di disponibilità, è possibile configurare facoltativamente la replica tra zone o tra aree. Questa replica è asincrona e richiede il failover avviato dal cliente nel volume di destinazione. Scegliere l'opzione di replica e pianificare in base agli obiettivi di ripristino del carico di lavoro. Per altre informazioni, vedere Azure NetApp Files affidabilità.
La condivisione di un set di dati rende anche la disponibilità dell'archiviazione una dipendenza comune per le applicazioni e l'analisi dei file. Queste funzionalità di archiviazione non stabiliscono la disponibilità end-to-end per il gateway, la pipeline di indicizzazione o l'utilizzo di applicazioni. Allineare gli obiettivi di ripristino con il carico di lavoro completo, inclusi il gateway, l'elaborazione downstream e i dati derivati.
Una singola macchina virtuale gateway è un singolo punto di errore per il percorso di integrazione Fabric. Per i carichi di lavoro business critical, distribuire almeno due membri del gateway in macchine virtuali separate in un cluster gateway. Assicurarsi che ogni membro possa raggiungere l'endpoint dell'API REST object e stabilire le connessioni in uscita necessarie. Testare il comportamento del carico di lavoro quando un membro del gateway non è più disponibile.
- Il recupero di file e volumi è supportato tramite snapshot temporizzato efficienti nello spazio. Teams può ripristinare un singolo file, ripristinare un volume completo o creare un nuovo volume da un punto di ripristino dopo l'eliminazione accidentale, il danneggiamento o un processo di analisi non riuscito. Per le operazioni di ripristino disponibili, vedere Azure NetApp Files protezione dei dati basata su snapshot.
Security
La sicurezza offre garanzie contro attacchi intenzionali e l'uso improprio dei dati e dei sistemi preziosi. Per maggiori informazioni, consultare la sezione Elenco di controllo per la revisione della progettazione per la sicurezza.
La gestione di un minor numero di copie dei dati di origine può ridurre il numero di repository da proteggere. Azure NetApp Files crittografa i dati inattivi e l'API REST Object usa TLS per proteggere i dati in transito. Le autorizzazioni di accesso ai file dipendono dal protocollo:
I client SMB e NFS continuano a usare i modelli di autenticazione e autorizzazione esistenti. Gli elenchi di controllo di accesso NTFS esistenti (ACL), le autorizzazioni NFS e le regole di mapping delle identità rimangono effettive per tali client.
I client DELL'API REST oggetto eseguono l'autenticazione usando una chiave di accesso S3. Le autorizzazioni del bucket definiscono se il client ha accesso in sola lettura o in lettura/scrittura all'interno della directory mappata. Le richieste di oggetti non includono l'identità del singolo utente SMB, NFS o downstream. Azure NetApp Files esegue ogni operazione di oggetto come identità del file system rappresentata del bucket configurata. Le autorizzazioni e gli ACL dei file esistenti vengono valutati solo rispetto a tale identità.
L'identità del file system rappresentato è un ID utente (UID) e un ID gruppo (GID) per i volumi NFS o un account utente per i volumi SMB. I volumi a doppio protocollo usano il tipo di identità che corrisponde al relativo stile di sicurezza configurato. Questa identità determina le autorizzazioni di accesso ai file. La chiave di accesso S3 autentica il client dell'oggetto. Per altre informazioni, vedere Sicurezza e autorizzazioni dell'API REST dell'oggetto.
Un collegamento compatibile con OneLake S3 esegue l'autenticazione al bucket usando un ID chiave di accesso e una chiave di accesso privata. Gli ACL NTFS di origine, le autorizzazioni NFS e le singole identità del proprietario del file non vengono copiati o mappati in OneLake. Fabric gli utenti sono autorizzati tramite OneLake e le autorizzazioni di Fabric. Possono accedere solo al contenuto esposto al collegamento tramite il bucket e la relativa identità rappresentata, ma OneLake non applica le autorizzazioni originali per ogni file utente. Microsoft Entra OAuth, le entità servizio e RoleArn non sono supportati per questo tipo di collegamento.
Ad esempio, un utente Fabric potrebbe essere in grado di leggere un documento usando il collegamento anche quando l'account SMB personale non può leggerlo direttamente, se Fabric autorizzazioni consentono l'accesso e l'identità rappresentata del bucket può leggere il documento. Prima di esporre una directory, verificare che il gruppo di destinatari Fabric previsto sia autorizzato ad accedere al contenuto.
Configurare l'identità rappresentata del bucket con solo le autorizzazioni di origine richieste dal carico di lavoro. Limitare l'accesso al collegamento e al lakehouse. Usare il flusso di lavoro del certificato basato su Azure Key Vault e l'archiviazione delle credenziali per gestire i certificati TLS e le chiavi di accesso S3. Definire e testare una procedura di rotazione che coordina le modifiche del certificato e delle credenziali con gli aggiornamenti alle connessioni Fabric e ad altri consumer. La generazione di nuove credenziali del bucket invalida immediatamente la coppia esistente, quindi pianificare l'interruzione mentre si aggiornano i consumer e si verifica l'accesso dopo la rotazione.
Se si usa un certificato TLS autofirmato, assicurarsi che ogni host del gateway lo consideri attendibile. Per altre informazioni, vedere Prerequisiti del gateway OneLake.
La sicurezza e la conformità dipendono dalla configurazione dei servizi di archiviazione, accesso e downstream. Includere l'elaborazione downstream e i dati derivati nell'ambito di governance e conformità. I requisiti, ad esempio GDPR e HIPAA, si applicano al carico di lavoro completo, se applicabile. Per altre informazioni, vedere Sicurezza e autorizzazioni dell'API REST degli oggetti eCreare un collegamento compatibile con Amazon S3 in OneLake.
Ottimizzazione dei costi
L'ottimizzazione dei costi è incentrata sui modi per ridurre le spese non necessarie e migliorare l'efficienza operativa. Per altre informazioni, vedere Elenco di controllo per la revisione della progettazione per l'ottimizzazione dei costi.
Evitare una copia separata dei dati di origine può ridurre i costi di archiviazione e sincronizzazione duplicati. Bilanciare questi risparmi rispetto ai costi di capacità e prestazioni Azure NetApp Files, al calcolo del gateway, alla capacità di Fabric e all'elaborazione e all'archiviazione downstream.
Questa stima dei prezzi di esempio include un pool di capacità standard Azure NetApp Files 1 TiB, una macchina virtuale Windows D8s_v5 per il gateway dati locale, due dischi gestiti da 128 GiB P10, un gateway NAT con un indirizzo IP pubblico e l'elaborazione dei dati in uscita, Fabric capacità F2 e 100 GB di archiviazione OneLake nativa.
La configurazione a gateway singolo non è a disponibilità elevata. Sono esclusi i costi facoltativi di ricerca di intelligenza artificiale, servizi di incorporamento e Azure Databricks. Modificare le risorse per i requisiti di capacità, rete e disponibilità del carico di lavoro.
Accesso sporadico: Bloccare i dati inattivi, inclusi i dati dello snapshot, per ridurre i costi di archiviazione mantenendo l'accesso ai file e agli oggetti. Valutare i costi di recupero, la latenza e le modifiche della velocità effettiva specifiche del livello di servizio rispetto al modello di accesso del carico di lavoro.
Livelli di servizio e ridimensionamento a destra: Scegliere un livello di servizio Azure NetApp Files che corrisponda ai requisiti di capacità e velocità effettiva del set di dati. Il livello di servizio Flessibile consente di effettuare il provisioning della capacità del pool e della velocità effettiva in modo indipendente. Esaminare la capacità e la velocità effettiva del pool fatturabili man mano che la domanda cambia per evitare il provisioning eccessivo permanente.
Eccellenza operativa
L'eccellenza operativa copre i processi operativi che distribuiscono un'applicazione e la mantengono in esecuzione nell'ambiente di produzione. Per ulteriori informazioni, vedere Lista di controllo per la revisione del design per l'Eccellenza Operativa.
I collegamenti OneLake riducono la complessità operativa evitando una pipeline che gestisce una copia separata dei dati di origine per l'analisi. Senza una pipeline di copia separata, i team non devono pianificare processi di copia, recuperare da errori di trasferimento o riconciliare l'origine e i dati copiati come parte delle operazioni di routine.
I team di analisi e applicazione di origine devono coordinare le modifiche e la risposta agli eventi imprevisti per il set di dati di Azure NetApp Files condiviso. Stabilire la proprietà per il monitoraggio, l'elaborazione degli errori e la gestione delle credenziali e delle credenziali dell'API REST object.
Monitorare le prestazioni di archiviazione, gateway e Fabric per identificare i vincoli e regolare la capacità o la velocità effettiva:
Usare Monitoraggio di Azure per tenere traccia della velocità effettiva di lettura e scrittura del volume, operazioni di I/O al secondo in lettura e scrittura, altre operazioni di I/O al secondo, latenza media di lettura e scrittura, il consumo di capacità e l'indicatore raggiunto dal limite di velocità effettiva. Avviso in caso di aumento della latenza sostenuta, limitazione QoS ripetuta e soglie di capacità anziché picchi isolati; Azure NetApp Files metriche vengono aggregate a intervalli e la latenza di archiviazione non include tutti i componenti REST lato client.
Correlare le metriche di archiviazione con misurazioni lato client, ad esempio percentili di latenza delle richieste, dimensioni degli oggetti, concorrenza, tentativi, codici di stato HTTP, CPU, memoria e velocità effettiva di rete. In questo modo si distingue un limite di velocità effettiva del volume da un client di calcolo sottodimensionato, dalle impostazioni inefficienti dell'SDK, dall'overhead di oggetti di piccole dimensioni o dalla distanza di rete.
Monitorare la CPU, la memoria, lo spazio su disco disponibile e la velocità effettiva di rete di ogni macchina virtuale del gateway insieme agli errori del gateway e ai tempi di completamento del carico di lavoro. Configurare gli avvisi per la pressione prolungata delle risorse e lo spazio su disco insufficiente, usando le soglie stabilite durante i test rappresentativi del carico di lavoro. Usare i log di diagnostica del gateway per la risoluzione degli errori o il rallentamento dell'accesso. Monitorare separatamente la macchina virtuale e la rete perché la diagnostica del gateway non fornisce una copertura completa dell'infrastruttura.
Monitorare Fabric l'utilizzo della capacità e la limitazione con l'app Fabric Capacity Metrics. Configurare le notifiche di utilizzo della capacità per gli amministratori responsabili. Correlare l'utilizzo della capacità con le misurazioni del gateway e dell'archiviazione per identificare se i ritardi hanno origine nell'accesso all'origine o Fabric l'elaborazione prima di modificare la capacità.
Efficienza prestazionale
L'efficienza delle prestazioni si riferisce alla capacità del carico di lavoro di ridimensionarsi per soddisfare in modo efficiente le esigenze degli utenti. Per maggiori informazioni, consultare la sezione Elenco di controllo per la revisione della progettazione per l'efficienza delle prestazioni.
Azure NetApp Files può supportare applicazioni NFS o SMB sensibili alla latenza e analisi compatibili con S3 o consumer di intelligenza artificiale usando lo stesso set di dati. Mantenere i dati di origine in un volume può rimuovere la fase di copia che altrimenti ritarderebbe l'indicizzazione, il training o l'elaborazione batch e utilizzare la larghezza di banda client, di rete e di archiviazione di destinazione.
La latenza di archiviazione di sub millisecondi nei livelli di servizio supportati Azure NetApp Files è più rilevante per i carichi di lavoro NFS e SMB. Non garantisce la latenza end-to-end per le richieste dell'API REST dell'oggetto HTTPS. Eseguire il benchmark del percorso di accesso compatibile con S3 con oggetti rappresentativi e concorrenza prima di impostare un obiettivo di latenza.
Ridimensionamento dello spazio di archiviazione: Dimensioni della velocità effettiva per la domanda combinata di applicazioni file e consumer di oggetti. La velocità effettiva automatica del volume viene associata alla quota del volume. QoS manuale consente l'allocazione separata all'interno del budget di velocità effettiva del pool. Carichi di lavoro rappresentativi del benchmark prima di regolare le prestazioni.
Ridimensionamento del gateway: Ridimensionare le macchine virtuali del gateway per la domanda combinata di carichi di lavoro che accedono Azure NetApp Files tramite collegamenti a OneLake. Usare le linee guida per il ridimensionamento e il ridimensionamento del gateway come punto di partenza. Convalidare il ridimensionamento con volumi di dati rappresentativi e l'accesso simultaneo tramite i collegamenti. Misurare la CPU, la memoria e la velocità effettiva della rete del gateway insieme ai tempi di completamento del carico di lavoro per determinare se aumentare le risorse della macchina virtuale o aggiungere membri del gateway.
Fabric dimensionamento della capacità: dimensioni Fabric capacità per il carico di lavoro combinato di elaborazione e creazione di report, tra cui Power BI. Seguire le indicazioni riportate nella guida alla pianificazione della capacità Fabric per stimare la capacità iniziale, testare con un progetto pilota rappresentativo e regolare la capacità in base all'utilizzo misurato e alla limitazione.
Posizionare il calcolo vicino al volume, ridimensionare la rete client in modo appropriato e testare con il carico di lavoro reale. Aumentare il parallelismo e usare richieste adeguatamente elevate per l'analisi sequenziale, ma limitare la concorrenza quando aumenta la latenza o gli errori. Per NFS o SMB, convalidare le impostazioni di montaggio, protocollo e applicazione. Per REST, verificare il supporto per le operazioni API necessarie del client e testare il riutilizzo della connessione, il comportamento di caricamento, i tentativi e l'elenco di oggetti.
Convalidare la velocità effettiva e la latenza end-to-end con carico simultaneo e bilanciare la domanda di analisi con i requisiti di prestazioni dell'applicazione di origine.
Contributors
Microsoft gestisce questo articolo. I seguenti collaboratori hanno scritto questo articolo.
Autori principali:
- Dan Jackson | Cloud Solutions Architect, NetApp
- Anthony Mashford | Cloud Solutions Architect, NetApp
- Daniel Söderholm | Senior Solution Engineer, Cloud + AI Platforms, Microsoft
Altri contributori:
- Heather Grandy | Senior Solution Engineer, Data Platforms, Microsoft
Per visualizzare i profili LinkedIn non pubblici, accedere a LinkedIn.
Passaggi successivi
- Introduzione all'API REST degli oggetti per Azure NetApp Files
- Connettere OneLake a un volume Azure NetApp Files
- Script Init in Azure Databricks
- Integrare OneLake con Azure Machine Learning