クラシック コンピューティングからサーバーレス コンピューティングにワークロードを移行します。 サーバーレス コンピューティングは、プロビジョニング、スケーリング、ランタイムアップグレード、最適化を自動的に処理します。
ほとんどのクラシック ワークロードは、コードの変更を最小限に抑えるか、まったく変更なしで移行できます。 例えば、 df.cache() や df.persist() を使うワークロードは、ほとんどの場合コード変更なしで移行します。 このページでは、これらのワークロードに焦点を当てます。 RやScalaノートブックに依存する特定のワークロードはクラシックコンピュートを必要とし、サーバーレスへの移行ができません。 現在の制限事項の完全な一覧については、「 サーバーレス コンピューティングの制限事項」を参照してください。
Genie Migrate for Serverless による移行
Important
この機能は ベータ版です。 ワークスペース管理者は、Previews ページで Compute Agent プレビューにオプトインすることで、これを有効にできます。 Manage Azure Databricks プレビューを参照してください。
Genie Migrate for Serverless は、単一のノートブックやジョブをサーバーレスコンピュートへ移行するエージェントです。 エージェントはワークロードの環境、ライブラリ、Sparkの設定、タグ、コードをレビューし、各変更を個別の提案として提案し、あなたに受け入れるか拒否するかを選びます。 承認された変更はその場で適用され、ロールバック可能です。
Genie Code を使用してノートブックやジョブをインタラクティブに移行するか、Databricks CLI を使用してスクリプトからの多くのジョブを含め、バックグラウンドでジョブを移行できます。 Databricks CLIによるジョブの移行を参照してください。
エージェントがレビューし変更する内容
| Area | エージェントの機能 |
|---|---|
| 環境とライブラリ | ライブラリのインストールをサーバーレス環境仕様に変換し、 %pip インストール、クラスターinitスクリプト、ジョブ上のクラスタライブラリ、プライベートパッケージインデックスへの参照などが含まれます。 |
| 環境変数 | クラスタ環境変数をサーバーレスの変数に変換し、ワークスペースの秘密参照を保持し、プラットフォーム管理の値を省略します。 |
| データとストレージアクセス | ローカルディスク、 dbfs:/、マウントパスなどのサーバーレス互換性のないパスをUnity Catalogボリュームに書き換えます。 エージェントは自動的に明確な書き換えを適用し、ターゲットが曖昧な場合はボリュームの選択を求めます。 |
| Spark の構成 | 各Spark構成を分類し、削除しても安全な構成をコメントアウトし、サーバーレスがサポートしない設定をフラグ付け・削除します。 クラスターアタッチ型とノートブック内型の両方の構成に対応しています。 |
| ワークロードコード | サーバーレスがサポートしないコードを、RDD操作をDataFrame操作に書き換えるなど、互換性のある同等物に書き換えたり、サーバーレス上でANSIモードSQLの動作に合わせてコードを調整します。 |
| Tags | コストセンタータグなどのカスタムクラスタタグをサーバーレス版に変換します。 |
| パフォーマンスモード | クラスタの設定に基づくパフォーマンスモードを提案します。 パフォーマンス モードの選択を参照してください。 |
Requirements
完全な移行を確実にするために、ワークスペース管理者権限の確保が推奨されます。 これは、エージェントがターゲットワークロードを超えたワークスペースレベルのグローバルinitスクリプトも検査するためです。 ワークロードに権限があれば
CAN MANAGE移行は可能かもしれませんが、管理者権限がなければライブラリや環境設定、タグが抜けてしまうことがあります。エージェントにアクセスできるか確認してください。 ジーニーコードで入力
/compute。/computeオートコンプリートメニューに表示されるはずです。 表示されない場合は、ワークスペース管理者があなたのワークスペースでプレビューを有効にする必要があります。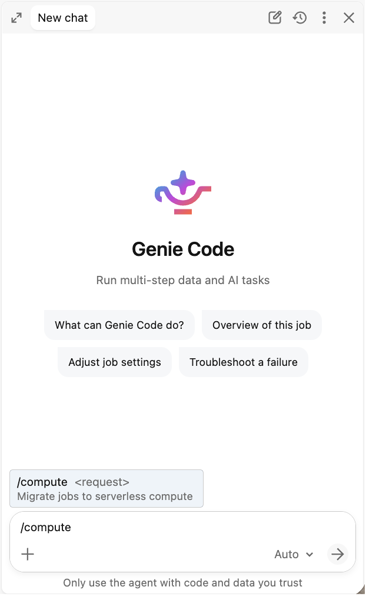
ノートブックを移行する
- 移行したいノートを開いてください。
- Genie Codeを開いて、
/コマンドパレットから/compute migrate to serverlessを実行します。 - エージェントの調査結果を確認しましょう。 エージェントはノートブックの環境、ライブラリ、コードをスキャンし、必要な項目ごとに変更を提案します。例えば、ライブラリのインストールを環境仕様に移行したり、サーバーレスで動作するコードセルの書き換えなどです。
- 提案された変更を受け入れるか拒否するかを判断してください。
- 受け入れた変更を適用してください。 それらはノートブックに直接書き込まれます。
- ノートブックをサーバーレスに接続して実行し、期待通りに動作するか確認してください。 「 移行されたワークロードの検証」を参照してください。
ジョブを移行する
- 移行したい仕事を募集しましょう。
- Genie Codeを開いて、
/コマンドパレットから/compute migrate to serverlessを実行します。 - エージェントはあなたのジョブを複製し、複製したジョブのサーバーレスへの移行を試みます。
- エージェントの調査結果を確認しましょう。 マルチタスクジョブの場合、エージェントはすべてのタスクとそのタスクごとのクラスタ構成を列挙し、ジョブのスケジュールを保持しながら各タスクの変更を提案します。
- 移行サーフェス全体で提案された変更(環境やライブラリ、Sparkの設定、変更が必要なワークロードコード)を受け入れるか拒否するかを決めます。
- 受け入れた変更を適用してください。 ジョブのコンピュートはサーバーレスに切り替わります。
- サーバーレスでジョブを実行し、結果を確認してください。 移行されたワークロードを確認するを参照してください。
- オプションとして、最終ステップとしてエージェントは移行したクローンをプロモートします。 クローンの設定やノートブックを元のジョブにコピーし(同じジョブID、スケジュール、権限は保持)、その後クローンを削除します。 昇格をスキップしても、元のジョブはスケジュール通りにクラシックコンピュートで動作します。 クローンにはスケジュールやトリガーがないため、起動したときだけ実行されます。
Databricks CLI を使用してジョブを移行する
Databricks CLI の compute-migrations コマンドグループを使用して、Genie Code セッションを開かずにバックグラウンドで Genie Migrate for Serverless を実行します。 スクリプトから多くのジョブの移行を開始し、準備が整った各ジョブをレビューできます。
Databricks の CLI パスには以下の要件があります:
- ワークスペース管理者が Compute Agent プレビューを有効にしました。 これがなければ、
compute-migrationsコマンドはすべてPERMISSION_DENIEDで失敗します。 - Databricks CLIバージョン1.24.0以上です。 「Databricks CLI のインストールまたは更新」を参照してください。
-
CAN MANAGE移行する各ジョブに対する権限が必要です。
エージェントはジョブをバックアップし、サーバーレスの作業用コピーを作成します。 作業用コピーは、ジョブのノートブックやファイルのコピーを実行する新しいジョブ [Serverless Migration - <timestamp>] <job name> です。 スケジュールやトリガーがないため、起動時かAzure Databricksが検証のために実行した時のみ実行されます。 移行が承認されるまで、元のジョブは変更されません。
Warnung
検証実行は孤立していません。 作業用コピーは、元のジョブと同じテーブル、ボリューム、チェックポイント、および外部システムに対して実行されます。 ジョブが本番テーブルに書き込み、通知を送信し、外部 API を呼び出し、またはストリーミングチェックポイントを進める場合、検証実行でも同様のことが行われます。 安全に追加実行できるジョブにのみ run_validation を設定してください。 移行を作成した後は、この設定を変更することはできません。
移行中は元のジョブや作業コピーを編集しないでください。 移行を承認すると、元のジョブの設定とファイルが作業コピーのものに置き換えられます。
ジョブの移行を開始する:
databricks compute-migrations create -o json --request-id "<uuid>" --json '{
  "asset_type": "JOB",
  "asset_uri": "jobs/<job-id>",
  "auto_approve": false,
  "run_validation": false
}'
応答には移行 ID が含まれます。 各ジョブごとに新しい
request-idを使用し、タイムアウト後に再試行した場合はそのを再利用して、重複した移行を避けてください。 移行を作成した後はauto_approveやrun_validationを変更することはできません。databricks compute-migrations get <migration-id> -o jsonで移行の状態を確認してください。 作業用のコピーを計画し作成するには、通常数分かかります。 多くの移行を確認するにはlistを使い、実行する前にそれぞれの移行をgetで確認してください。移行が
TRANSLATION_READYに達したら、作業コピーを確認してください。migration_report.primary_asset.idは動作コピーのジョブIDです。 元のジョブと設定やコードを比較し、最新のgetの--etagでapprove-migration-translationまたはreject-migration-translationを実行します。run_validationを設定すると、作業用コピー Azure Databricks一度実行し、結果をvalidation_reportに記録します。 実行が成功するか失敗するかをMIGRATION_REVIEWするよう移行が進むため、承認する前にvalidation_report.passedを確認してください。移行が
MIGRATION_REVIEWに達したら、作業用コピーと検証結果を確認し、最新のreject-migration-executionのapprove-migration-executionを使用してgetまたは--etagを実行します。 承認は、作業用コピーの設定とファイルを元のジョブに適用し、ジョブ ID、スケジュール、および権限を保持します。移行が
MIGRATION_COMPLETEに達すると、元のジョブが変更されました。 すぐに確認してください。 移行されたワークロードの検証 を参照してください。元のジョブを確認した後、ワーキングコピーのジョブを削除してください。
migration_report.secondary_assetsワーキングコピーが実行するノートブックを一覧表示します。 元のジョブがそれらを参照していないことを確認してから削除してください。
各拒否コマンドには拒否理由が必要で、マイグレーションIDの後にそれを渡します。 例:
databricks compute-migrations reject-migration-translation <migration-id> "Keep the existing output table names." --etag <etag>
具体的な理由を挙げてください。 エージェントは作業用コピーを修正し、レビューのために返送します。 マイグレーションを繰り返し拒否すると失敗します。
以下の表は compute-migrations コマンドを示しています:
| Command | Description |
|---|---|
create |
ジョブの移行を開始する。 ジョブに進行中の移行がある場合、またはすでに成功した移行がある場合には ALREADY_EXISTS で失敗します。 |
get、list |
1つの移行またはすべての移行の状態、レポート、および etag を返します。 |
approve-migration-translation、reject-migration-translation |
TRANSLATION_READY状態で作業コピーを承認または却下します。 作成時に auto_approve 設定するとこのレビューは飛ばされます。 |
approve-migration-execution、reject-migration-execution |
MIGRATION_REVIEW 状態での移行を承認または拒否します。 承認すると元のジョブが変わります。 |
cancel-migration |
移行を停止します。 キャンセルは、元のジョブに既に適用された変更や検証実行の副作用を元に戻すことはできません。 |
delete |
移行レコードを削除します。 変更をロールバックしたり、作業コピーやバックアップを削除したりしません。 失敗またはキャンセルされた移行はすでにジョブを解放するため、新しい移行を開始する前にジョブを削除する必要はありません。 |
承認、拒否、またはキャンセルの各コマンドとともに、最新の--etagからgetを渡します。 もしあなたが読み取った後に移行が変更された場合、そのコマンドはレビューしていない状態に対して動作するのではなく、 ABORTED で失敗します。 エージェントがジョブを移行できない場合は、移行は NOT_SUPPORTED または FAILED の状態になり、その理由は state_history で説明されています。
移行されたワークロードの検証
エージェントは変更を提案し適用しますが、ワークロードの出力を検証しません。 Databricks CLI を使用した検証実行は、実行が成功したかどうかのみを確認します。 移行したワークロードは必ずサーバーレス上で実行し、結果を確認してから依存してください。特に本番テーブルに書き込みするワークロードの場合はなおさらです。 もしエージェントが提案した変更がおかしければ、それを却下し、フィードバックを送ってエージェントの改善を図ってください。 製品フィードバックの送信を参照してください。
Tip
移行したワークロードを検証する間は、パフォーマンス最適化モードで実行してください。 標準モードよりも早く始まるので、結果を確認するとフィードバックが早く受け取れます。 本番環境で実行する前に、ワークロードに最も合ったモードに切り替えてください。 パフォーマンス モードの選択を参照してください。
エージェントが安全に移行できないものを見つけた場合、ブロッカーを報告し、デフォルトで停止します。 明示的に互換性や依存関係のブロッカーを通過するように指示することはできますが、そうすると依存関係やコスト帰属、ランタイム動作が引き継がれず、サーバーレスでワークロードが失敗するリスクを受け入れることになります。
移行の変更をロールバックする
エージェントが適用する変化は可逆的です。
ノートの場合は、移行直前の修正を開いて復元してください。 Databricks ノートブックのバージョン履歴を参照してください。
ジョブの場合、Genie Codeで移行されたクローンを昇格しなかったか、Databricks CLIで移行を承認していない場合、元のジョブは変更されていません。 前と同じように実行し、クローンまたは作業コピーを削除してください。 そうでない場合は、エージェントが変更を加える前に書き込んだバックアップから復元してください:
- バックアップフォルダを開く:
/Workspace/Users/<username>/serverless-migration/backups/job-<job-id>/<timestamp>/。 バックアップは移行を実行したユーザーのホームフォルダーにあり、Databricks CLI ではそのバックアップは作成したユーザーのものです。 Genie Codeでは、エージェントも移行中にこの経路を表示します。 複数のタイムスタンプがある場合は、移行直前のものを選びましょう。 - 移行前のジョブ設定が保存されている
job.yamlを開き、POST /api/2.2/jobs/resetリクエストを使用して、それらの設定を同じジョブに再適用します。このリクエストは、指定した設定でそのジョブの設定を上書きします。 また、UIのジョブのJSON定義に貼り付けることもできます。 これにより、ジョブがクラシック コンピュートに戻されます。 -
mapping.yamlを開くと、バックアップ済みファイルとその元の経路が一覧表示されます。 各バックアップファイルを元のパスにコピーしてコードの書き換えを解除します。 - ジョブを実行して、移行前と同じ動作をしているか確認してください。
移行ではこのバックアップは削除されません。 エージェントが変更していないタスク(git-sourced、SQL、dbtなど)は job.yaml に記録されますが、そのファイルはバックアップにコピーされません。必要に応じてソースから復元してください。
既知の制限
- 以下はブロッカーとして報告されています:カスタムイメージ、MLランタイムのバリアント、13以前のDatabricksランタイムバージョン、サーバーレスで安全に無視できないSpark構成、そしてeggs、JAR、Mavenライブラリなどの依存関係です。 ブロッカーとは、エージェントがそのアイテムを移動せずに停止することを意味します。 自分で解決して再度移行を実行するか、エージェントに移行を指示しても、その項目は解決されず、サーバーレスでワークロードが失敗する可能性があります。
- エージェントはワークスペースファイルやUnity Catalogボリュームに保存されたinitスクリプトを読み込みます。 ABFSSまたはDBFSに保存されたinitスクリプトは読み取れず、ブロッカーとして報告されます。
- エージェントはすべてのクラシックな計算属性を検査するわけではありません。 クラスターログの配信やSSHキーはモデル化されておらず、ワークロードコードから多くのDBFSマウント依存関係を検出しますが、すべてのマウントを列挙または解決するわけではありません。
- キャッシュおよびチェックポイントAPI、グローバル一時ビュー、DBFSのマウント管理コール、ScalaやRコードはデフォルトでハードブロッカーです。 エージェントに指示はできますが、未解決機能は変更されず、サーバーレスでは失敗する可能性があります。
- 10を超える移行可能なタスクを持つジョブは移行できません。
- Genie Code のエージェントは、1 つのワークロードを一度に移行します。 複数のジョブを移行するには、 Databricks CLI を使ってジョブごとに 1 つの移行を作成します。 フリート全体でのディスカバリーや管理者による承認ワークフローはありません。
- Databricks CLI を使用すると、エージェントはジョブのみを移行します。 リモート Git リポジトリから取得したノートブックまたは Python タスクを持つジョブは、移行に失敗します。
- エージェントは変更を提案し、あなたが受け入れた変更を適用しますが、出力の正確性は検証しません。 本番データに依存する前に、移行したワークロードを必ず確認してください。
- もしあなたのワークロードの真実のソースがDatabricksのAsset BundleやGitフォルダであれば、エージェントはワークスペースオブジェクトに変更を適用します。 これらの変更をバンドルやリポジトリと照合し、後のデプロイで移行が上書きされないようにしましょう。
手動でサーバーレスへ移行する
クラシック コンピューティングからサーバーレス コンピューティングにワークロードを移行するには、次の手順に従います。
- 前提条件を確認してください:ワークスペース、ネットワーク、クラウドストレージへのアクセスが要件を満たしていることを確認してください。 「前提条件」を参照してください。
- コード更新:必要なコードや設定の変更を行います。 「 コードを更新する」を参照してください。
- ワークロードをテストする:カットオーバー前に互換性と正確性を検証しましょう。 ワークロードのテストを参照してください。
- パフォーマンス モードを選択してください: ワークロード要件に最も合ったパフォーマンス モードを選択してください。 パフォーマンス モードの選択を参照してください。
- 段階的に移行: サーバーレスを段階的に導入し、新規かつ低リスクのワークロードから始めます。 段階的な移行を参照してください。
- コストの監視:サーバーレスのDBU消費状況を追跡し、アラートを設定します。 コストの監視を参照してください。
Prerequisites
移行を開始する前に、ワークスペース内のいくつかのレガシ構成を更新することが必要になる場合があります。
| 前提条件 | アクション | 詳細情報 |
|---|---|---|
| Unity カタログでワークスペースが有効になっている | 必要に応じて Hive Metastore から移行する | Azure Databricks ワークスペースを Unity カタログにアップグレードする |
| 構成されたネットワーク | VPC ピアリングを NCC、Private Link、またはファイアウォール規則に置き換える | サーバーレス コンピューティング プレーン ネットワーク |
| クラウド ストレージ へのアクセス | 従来のデータ アクセス パターンを Unity カタログの外部の場所に置き換える | Unity Catalogを使用してクラウドオブジェクトストレージに接続する |
ワークスペースが サポートされているリージョンであることを確認します。
コードを更新する
次のセクションでは、ワークロードをサーバーレスと互換性させるために必要なコードと構成の変更を示します。
データアクセス
従来のデータ アクセス パターンは、サーバーレスではサポートされていません。 代わりに Unity カタログを使用するようにコードを更新します。
| クラシック パターン | サーバーレス置換 | 詳細情報 |
|---|---|---|
DBFS パス (dbfs:/...) |
Unity のカタログボリューム | Unity Catalog ボリュームとは? |
| Hive メタストア テーブル | Unity カタログ テーブル (または HMS フェデレーション) | Azure Databricks ワークスペースを Unity カタログにアップグレードする |
| ストレージ アカウントの資格情報 | Unity カタログの外部の場所 | Unity Catalogを使用してクラウドオブジェクトストレージに接続する |
| カスタム JDBC JAR | レイクハウスフェデレーション | クエリフェデレーションとは何ですか? |
Warnung
DBFS アクセスはサーバーレスで制限されます。 移行する前に、すべての dbfs:/ パスを Unity カタログ ボリュームに更新します。 詳細については、「 DBFS に格納されているファイルを移行する」を参照してください。
例: DBFS パスおよび Hive メタストア参照を置き換える
# Classic
df = spark.read.csv("dbfs:/mnt/datalake/data.csv", header=True)
df.write.parquet("dbfs:/mnt/output/results")
df = spark.table("my_database.my_table")

# Serverless
df = spark.read.csv("/Volumes/main/sales/raw_data/data.csv", header=True)
df.write.parquet("/Volumes/main/analytics/output/results")
df = spark.table("main.my_database.my_table")  # three-level namespace
API とコード
特定の API とコード パターンは、サーバーレスではサポートされていません。 コードを更新する必要があるかどうかを確認するには、この表を参照してください。
| クラシック パターン | サーバーレス置換 | 詳細情報 |
|---|---|---|
RDD API (sc.parallelize、 rdd.map) |
DataFrame API | Spark ConnectとSpark Classicを比較する |
spark.sparkContext、sqlContext |
spark (SparkSession) を直接使用する |
Spark ConnectとSpark Classicを比較する |
Hive 変数 (${var}) |
SQL DECLARE VARIABLE または Pythonのf文字列 |
DECLARE VARIABLE |
| サポートされていない Spark 構成 | サポートされていない構成を削除します。 サーバーレスでは、ほとんどの設定が自動チューニングされます。 | サーバーレスノートブックおよびジョブ用の Spark プロパティを構成する |
例:RDD 操作を DataFrame を使った処理に置き換える
from pyspark.sql import functions as F

# sc.parallelize + rdd.map
# Classic:  rdd = sc.parallelize([1, 2, 3]); rdd.map(lambda x: x * 2).collect()
df = spark.createDataFrame([(1,), (2,), (3,)], ["value"])
result = df.select((F.col("value") * 2).alias("value")).collect()

# rdd.flatMap
# Classic:  sc.parallelize(["hello world"]).flatMap(lambda l: l.split(" ")).collect()
df = spark.createDataFrame([("hello world",)], ["line"])
words = df.select(F.explode(F.split("line", " ")).alias("word")).collect()

# rdd.groupByKey
# Classic:  rdd.groupByKey().mapValues(list).collect()
df = spark.createDataFrame([("a", 1), ("b", 2), ("a", 3)], ["key", "value"])
grouped = df.groupBy("key").agg(F.collect_list("value").alias("values")).collect()

# rdd.mapPartitions → applyInPandas
import pandas as pd
def process_group(pdf: pd.DataFrame) -> pd.DataFrame:
    return pd.DataFrame({"total": [pdf["id"].sum()]})
result = (spark.range(100).repartition(4)
    .groupBy(F.spark_partition_id())
    .applyInPandas(process_group, schema="total long").collect())

# sc.textFile → spark.read.text
df = spark.read.text("/Volumes/catalog/schema/volume/file.txt")
例: SparkContext API を置き換える
from pyspark.sql.functions import broadcast

# sc.broadcast → broadcast join
result = main_df.join(broadcast(lookup_df), "key")

# sc.accumulator → DataFrame aggregation
total = df.agg(F.sum("amount")).collect()[0][0]

# sqlContext.sql → spark.sql
result = spark.sql("SELECT * FROM main.db.table")
SQL 動作の違い
サーバーレスコンピュートはデフォルトでANSIモードを有効にします。 Databricks Runtimeはバージョン17.0以降でANSIモードをデフォルトで有効化します。 従来のコンピューティングで以前のバージョンが実行されている場合、そちらでは正常に実行される一部のクエリが、サーバーレス環境では実行時エラーを引き起こすことがあります。
Genie Migrate for Serverless は、ANSI モードの動作に合わせてコードを自動的に調整します。 手動で移行する場合は、動作が変わることが最も多い以下の処理を確認してください:
| Operation | ANSIモードを無効にしたクラシックコンピュート | サーバーレス コンピューティング |
|---|---|---|
たとえば CAST('abc' AS INT) のような無効なキャスト |
NULL を返します。 |
CAST_INVALID_INPUT が発生します |
| 整数の算術オーバーフロー | ラップします。 たとえば、2147483647 + 1 は -2147483648を返します。 |
ARITHMETIC_OVERFLOW が発生します |
| 十進算術オーバーフロー |
NULL を返します。 |
NUMERIC_VALUE_OUT_OF_RANGE を発生させる |
| 0 で除算しました |
NULL を返します。 |
DIVIDE_BY_ZERO が発生します |
| parse_url内の不正なURL |
NULL を返します。 |
昇給 INVALID_URL |
エラーを発生させる代わりに NULL を返すには、その操作を 相当の操作 (たとえば try_cast、try_add、try_parse_url、または try_*) に置き換えます。 Databricks は、ANSI モードを無効にするのではなく、このアプローチを推奨しています。ANSI モードでは、NULL をサイレントに実行した場合には隠れてしまうデータ品質の問題が明らかになります。
キャスト、算術、解析で ANSI モードを無効にするには、spark.sql.ansi.enabled を false に設定してください。 サーバーレス計算は、この設定に関わらずテーブル挿入の暗黙のキャストにANSIルールを適用します。なぜなら、サーバーレス計算では spark.sql.storeAssignmentPolicy 変更できないからです。 ANSIの動作の詳細については、 Databricks RuntimeのANSI準拠を参照してください。
ライブラリと環境
ライブラリと環境は、 基本 環境を使用してワークスペース レベルで管理し、ノートブックの サーバーレス環境を使用してノートブック レベルで管理できます。
| クラシック パターン | サーバーレス置換 | 詳細情報 |
|---|---|---|
| 初期化スクリプト | サーバーレス環境 | サーバーレス環境を構成する |
| クラスター-スコープ ライブラリ | ノートブック スコープまたは環境ライブラリ | サーバーレス環境を構成する |
| Maven/JAR ライブラリ | ジョブ向けの JAR タスクサポート、ノートブック用 PyPI | ジョブ用JARタスク |
| Docker コンテナー | ライブラリのニーズに対応するサーバーレス環境 | サーバーレス環境を構成する |
Python パッケージを requirements.txt にピン留めして、再現可能な環境に対応します。
Specify Python パッケージのバージョンを参照してください。
ストリーミング
ストリーミング ワークロードはサーバーレスでサポートされていますが、特定のトリガーはサポートされていません。 サポートされているトリガーを使用するようにコードを更新します。
| スパーク トリガー | サポートされている | メモ |
|---|---|---|
Trigger.AvailableNow() |
はい | 推奨 |
Trigger.Once() |
はい | 非推奨です。
Trigger.AvailableNow() を代わりに使用します。 |
Trigger.ProcessingTime(interval) |
いいえ |
INFINITE_STREAMING_TRIGGER_NOT_SUPPORTED を返します。 |
Trigger.Continuous(interval) |
いいえ | 代わりに Lakeflow パイプラインの連続モードを使用する |
既定値 ( .trigger()を設定しない) |
いいえ |
.trigger()省略すると、既定で ProcessingTime("0 seconds") になります。サーバーレスではサポートされていません。
.trigger(availableNow=True)は常に明示的に設定してください。 |
継続的ストリーミングの場合は、継続的モードで Spark 宣言パイプラインに移行するか、でAvailableNowを使用します。 大きなソースの場合は、メモリ不足エラーを防ぐために maxFilesPerTrigger または maxBytesPerTrigger を設定します。
例:ストリーミングトリガーの修正
# Classic (not supported on serverless — default trigger is ProcessingTime)
query = df.writeStream.format("delta").outputMode("append").start()

# Serverless (explicit AvailableNow trigger)
query = (df.writeStream.format("delta").outputMode("append")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
query.awaitTermination()

# With OOM prevention for large sources
query = (spark.readStream.format("delta")
    .option("maxFilesPerTrigger", 100)
    .option("maxBytesPerTrigger", "10g")
    .load(input_path)
    .writeStream.format("delta")
    .trigger(availableNow=True)
    .option("checkpointLocation", checkpoint_path)
    .start(output_path))
ワークロードをテストする
- クイック互換性テスト: Standard access mode と Databricks Runtime 14.3 以上の Classicコンピュートでワークロードを実行します。 実行が成功した場合、ワークロードはコードを変更することなくサーバーレスに移行できます。
- A/B 比較 (本番環境で推奨):同じワークロードを Classic (コントロール)と serverless (実験)で実行します。 出力テーブルを差分し、正確性を確認します。 出力が一致するまで反復処理します。
- 一時的な設定: テスト中にサポートされる Spark 設定を一時的に設定できます。 安定したら削除します。
パフォーマンス モードを選択する
サーバーレス ジョブとパイプラインでは、標準とパフォーマンス最適化の 2 つのパフォーマンス モードがサポートされます。 選択するパフォーマンス モードは、ワークロードの要件によって異なります。
| モード | 在庫状況 | Startup | 最適な用途 |
|---|---|---|---|
| Standard | ジョブ、Lakeflow パイプライン | 通常4〜6分 | コストセンシティブなバッチ |
| パフォーマンス最適化 | ジョブ、Lakeflow パイプライン | 通常は1分未満です | 対話型、待機時間の影響を受けやすい |
標準モードはパフォーマンス最適化モードよりも使用するDBUが少ないため、コストが低くなります。 移行されたジョブまたはパイプラインのモードを比較し、そのモードを設定するには、「 サーバーレスジョブおよびパイプラインのパフォーマンスモードの選択」を参照してください。
段階的に移行する
- 新しいワークロード:すべての新しいノートブックとジョブをサーバーレス上で開始します。
- 低リスクのワークロード: すでに標準アクセスモードと Databricks Runtime 14.3 以上で実行している PySpark/SQL ワークロードを移行します。
- 複雑なワークロード:コード変更が必要なワークロード(RDDの書き直し、DBFSの更新、トリガー修正)を移行します。
- 残りのワークロード: 機能の拡大に応じて定期的にレビューしてください。
コストを監視する
サーバーレス課金は、クラスターのアップタイムではなく、DBU の使用量に基づいています。 大規模に移行する前に、代表的なワークロードでコストの期待を検証します。 サーバーレス コストを監視するためのツールと戦略については、「 サーバーレス コンピューティングのコストの監視」を参照してください。
その他のリソース
- サーバーレス計算のベストプラクティス:サーバーレスワークロードの最適化のヒント
- サーバーレス計算の制限:現在の制限事項およびサポートされていない機能の完全な一覧
- サーバーレス環境の設定:ライブラリと依存関係を管理する
- サポートされている Spark 構成:サーバーレスで Spark 設定が利用可能
- Spark Connect vs. クラシック Spark:サーバーレスアーキテクチャにおける挙動の違い
-
サーバーレス計算におけるデータフレームのキャッシュ:
df.cache()とdf.persist()を使用してデータフレームをキャッシュ - サーバーレスネットワークセキュリティ:NCC、Private Link、ファイアウォール構成
- サーバーレスコンピュートリリースノート:新機能のリリースを追跡
- Unity カタログアップグレードガイド: Hive Metastore から Unity Catalog への移行
詳細については、次のブログ記事を参照することもできます。
- サーバーレスコンピューティングとは何か?:サーバーレス機能の概要と顧客成果
- データエンジニアリングの進化:サーバーレスコンピューティングがノートブックとLakeflowジョブを変革する方法:サーバーレスがLakeflowジョブとパイプラインを支える仕組み