Notitie
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen u aan te melden of de directory te wijzigen.
Voor toegang tot deze pagina is autorisatie vereist. U kunt proberen de mappen te wijzigen.
In dit artikel wordt een proces met zes fasen beschreven voor het migreren van een door LLM aangedreven workload van het ene basismodel naar het andere: wat u in elke fase moet overwegen, welke Microsoft Foundry-functies van toepassing zijn en hoe het werk verandert voor verschillende soorten teams.
Wat modelmigratie betekent
Elk model dat u in productie uitvoert, heeft een buitengebruikstellingsdatum. Wanneer een model dat u afhankelijk bent, wordt vervangen of wanneer een nieuwer model uw workload beter zou leveren, migreert u. Het wisselen van een model is geen wijziging in één regel: een ander model kan de toon, opmaak, JSON-vorm, latentie, kosten of gedrag bij het aanroepen van hulpprogramma's stil verschuiven en downstreamcode verbreken die afhankelijk is van het oude gedrag.
Een geslaagde migratie behoudt het gedrag van de toepassing of verbetert het op meetbare manieren. Succes vereist een herhaalbaar proces om drift te detecteren, veilig aan te passen en kwaliteit te bewijzen vóór de brede implementatie.
Wanneer moet worden gemigreerd
Een migratie begint meestal om een van de vier redenen:
- Een model wordt buiten gebruik gesteld. Op Foundry heeft elk algemeen beschikbaar model een uitfaseringsdatum en worden oudere modelfamilies in de loop van de tijd vervangen. Zie voor pensioenbeleid en datums de levenscyclus van Foundry Models en het ondersteuningsbeleid en model buitengebruikstellingsschema.
- Er is een beter model beschikbaar. Een nieuwer model biedt een hogere kwaliteit, lagere kosten, betere latentie of een mogelijkheid (zoals gestructureerde uitvoer of verbeterde aanroepen van hulpprogramma's) die uw workload nodig heeft.
- Een probleem met kosten of latentie dwingt een wijziging af. De latentie of eenheidskosten van het huidige model voldoen niet meer aan uw behoeften.
- Ontbrekende functionaliteit houdt het product tegen. Het huidige model kan nu niet iets doen wat uw product nodig heeft.
Wat gebeurt er op de pensioendatum?
Wat Azure doet wanneer een model buiten gebruik wordt gesteld, is afhankelijk van hoe u capaciteit koopt, en Foundry gebruikt verschillende terminologie voor elk pad:
-
Standard-, Global Standard- en Data Zone Standard-implementaties (betalen per gebruik) worden automatisch geüpgraded volgens een doorlopend schema voor regio's. U bepaalt de timing door
versionUpgradeOptionin te stellen op een van de volgende opties:OnceNewDefaultVersionAvailable,OnceCurrentVersionExpiredofNoAutoUpgrade(wat betekent dat de implementatie niet meer werkt wanneer deze buiten gebruik wordt gesteld). Prioriteitsverwerking volgt hetzelfde pad. - Gereserveerde (PTU)-implementaties worden niet automatisch bijgewerkt. U migreert deze zelf, ofwel in-place (het verkeer wordt binnen 20–30 minuten omgeleid zonder onderbreking) ofwel side-by-side (de nieuwe implementatie opzetten, testen, verkeer omleiden, de oude verwijderen).
- Batch-deployments volgen de side-by-side-aanpak: het nieuwe model implementeren, taken opnieuw indienen, de oude implementatie buiten gebruik stellen.
Ongeacht welk pad van toepassing is, de uitdaging voor ontwikkelaars is hetzelfde: op een vaste datum begint uw verkeer een ander model te bereiken. Een eindpunt dat nog steeds reageert, betekent niet dat uw app zich nog steeds correct gedraagt, dus zowel automatisch geüpgradede als handmatig gemigreerde workloads profiteren van de evaluatie en validatie die in dit artikel worden beschreven.
Migreren vóór de buitengebruikstellingsdatum
Automatische upgrade is alleen een veiligheidsnet voor implementaties met betalen per gebruik, niet een migratieplan. Ingerichte implementaties hebben geen veiligheidsnet. In beide gevallen is het geen vervanging voor een migratieplan. Twee beleidstoezeggingen bieden u ruimte om te migreren volgens uw eigen planning in plaats van te wachten op de deadline:
- Het vervangingsmodel komt in Global Standard ongeveer 90 dagen beschikbaar voordat het buiten gebruik wordt gesteld, en in geconfigureerde regio’s waar het voorgaande model buiten gebruik wordt gesteld ongeveer 30 dagen daarvoor. Gebruik dit venster om het nieuwe model te evalueren en handmatig te migreren.
- Pensioendatums kunnen niet worden verlengd. Er is geen uitzonderingsprocedure, dus een datum waar u geen rekening mee had gehouden, geldt nog steeds voor u.
U hebt geen verouderingswaarschuwing nodig om aan de slag te gaan. Als een nieuwer model goedkoper, sneller of beter geschikt is, voert u het nu door het proces. Door bewust te migreren wordt de uitfaseringsdatum een formaliteit. Omdat migraties opnieuw worden uitgevoerd, is het de moeite waard om het proces herhaalbaar te maken.
Wie moet het migratieproces gebruiken
Het migratieproces past het beste wanneer uw team een door LLM aangedreven functie bouwt binnen een groter product of platform, op ongeveer driemaandelijkse frequentie migreert en een duidelijke eigenaar (zoals een centraal platformteam of het app-team) heeft die elke migratie opzettelijk uitvoert.
Dit proces past ook bij AI-native teams, waarbij het model het product is. De fasen zijn hetzelfde, maar ze worden sneller en vaak parallel uitgevoerd in plaats van in strikte volgorde.
Dit proces gaat ervan uit dat u wisselt tussen basismodellen, dat wil zeggen modellen die u implementeert zoals gepubliceerd in de modelcatalogus, zonder aanpassingen op het niveau van de gewichten. Nauwkeurig afgestemde workloads vallen buiten het bereik. Ze kunnen niet automatisch worden geüpgraded, omdat ze hun eigen uitfaseringsschema voor training en implementatie hebben. Het aanpassen van nauwkeurig afgestemde werkbelastingen betekent distillatie of hertraining in plaats van prompts en schemawijzigingen. Als u goed afgestemde implementaties uitvoert, bent u van plan om het vervangende basismodel vroeg opnieuw af te stemmen.
Migratiefasen
Een migratie doorloopt zes fasen. Elke fase produceert een uitvoer die in de volgende fase wordt gebruikt. De migratiefasen zijn:
Ontdekken → Beoordelen → Aanpassen → Valideren → Uitrollen → Buiten gebruik stellen
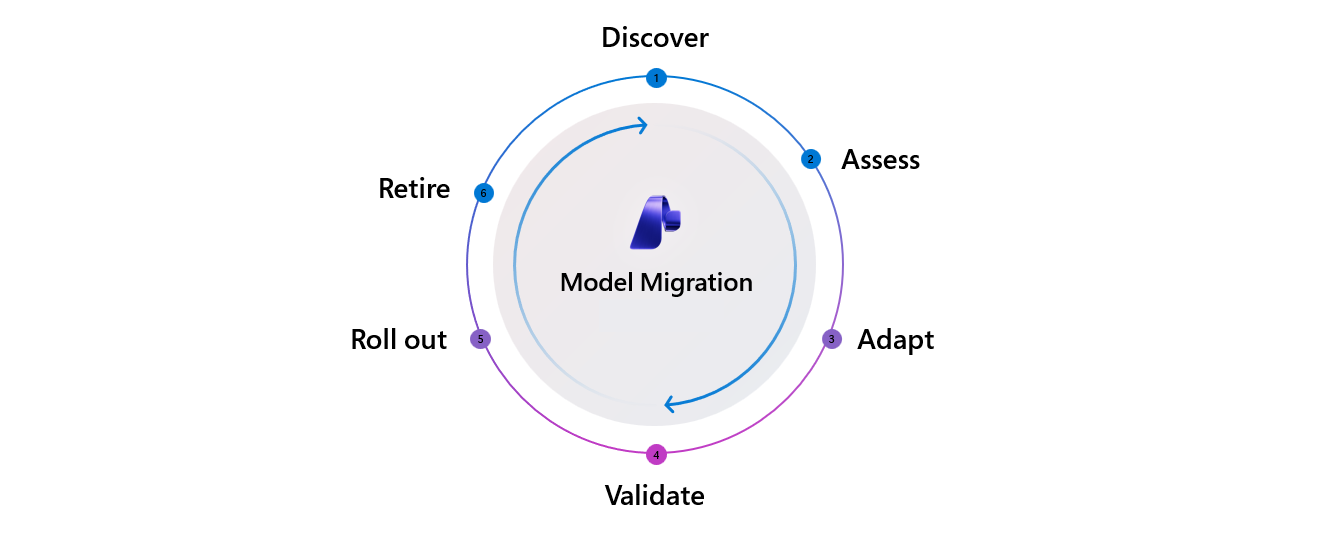
In de volgende tabel worden elke fase en de Foundry-functies en -hulpprogramma's beschreven die deze ondersteunen. Functies zijn beschikbaar in zowel Microsoft Foundry als Azure OpenAI, tenzij alleen is gemarkeerd als Foundry, wat betekent dat Azure OpenAI geen equivalent heeft.
In de secties per fase verderop in dit artikel wordt uitgelegd waarom elke fase bestaat, hoe een geslaagd resultaat eruitziet, wat u moet overwegen, wanneer u elke functie moet gebruiken en waar de fase doorgaans wordt verbroken.
| Phase | Description | Functies en hulpmiddelen |
|---|---|---|
| Ontdekken | Leer dat een modelwijziging binnenkort of nodig is en bepaal of er actie moet worden uitgevoerd. |
|
| Beoordelen | Kies het doelmodel en bevestig dat het operationeel beschikbaar is. |
|
| Aanpassen | De huidige workload op het nieuwe model opnieuw afspelen, gedragswijzigingen diagnosticeren en prompts, parameters, hulpprogrammadefinities, uitvoerschema's en de aanroepende code eromheen opnieuw ontwerpen. |
|
| Valideren | Score de aangepaste werkbelasting op basis van een kwaliteitsrubriek om te bepalen of het veilig is om te verzenden. |
|
| Uitrollen | Niveau verhogen naar productie door middel van gefaseerde blootstelling, livegedrag bewaken en doorvoeren of terugdraaien. |
|
| Uit gebruik nemen | Neem de oude implementatie uit gebruik, maak capaciteit vrij, archiveer evals en werk de downstreamdocumentatie bij. |
|
Voordat u migreert: Een testgegevensset voorbereiden
Deze voorbereidingsstap stelt een set representatieve invoer, verwachte uitvoer en overeengekomen succescriteria samen voordat het migratiewerk begint. Deze set is een blokkerende afhankelijkheid voor het middendeel van het proces: u kunt in de fase Aanpassen niet opnieuw uitvoeren zonder invoergegevens, en u kunt in de fase Valideren niet scoren zonder ground truth en criteria.
Wat u moet overwegen
- Bouw de gegevensset voordat u een doel kiest. De gegevensset beschrijft uw workload, niet het kandidaatmodel, zodat u deze parallel met Discover kunt samenstellen.
- Verzamel invoer uit echte of synthetische bronnen. Gebruik vastgelegd productieverkeer of gecureerde domeinvoorbeelden als CSV of JSONL. Als u nog geen representatieve gegevens hebt, genereert u synthetische en adversariele invoer met de simulator.
- Leg instrumentgegevens vast voordat u ze nodig hebt. Het vastleggen van productiecontent moet expliciet worden ingeschakeld en werkt nooit met terugwerkende kracht, dus u kunt geen verkeer analyseren dat u niet hebt vastgelegd. Begin nu met het registreren van prompts, antwoorden, latentie en tokenaantallen.
- De gegevensset bevriezen. Houd de invoer, grondwaarheden en succescriteria vast voor de hele migratie. Als een van deze wijzigingen verandert, kunt u de bron- en doelresultaten niet meer vergelijken.
U hebt ook een inventaris nodig van de modelimplementaties die uw workload gebruikt, inclusief de implementatietypen (Standaard, Ingericht of Batch). Noteer voor elk bronmodel de buitengebruikstellingsdatum en voorgestelde vervanging van het schema voor buitengebruikstelling van het model.
Fase 1: Ontdekken
Het doel van de Discover-fase is te herkennen dat een modelwijziging komt of de moeite waard is en om te bepalen of er actie moet worden ondernemen. De uitvoer is een go/no-go beslissing en het huidige model blijft een geldige keuze. Een geslaagd resultaat is een vroeg gestructureerd signaal dat u de afschaffingsdatum, het vervangingsmodel en het migratievenster geeft, of een weloverwogen beslissing om op het huidige model te blijven.
Wat u moet overwegen
- Wat is de pensioendatum en hoeveel landingsbaan heb je eigenlijk? Beschouw de uitfaseringsdatum, verminderd met de validatie- en uitroltijd, als de werkelijke deadline.
- Is er een benoemde voorgestelde vervanging, of moet u zelf kandidaten in de lijst opnemen?
- Heeft de wijziging nalevings- of regionale beperkingen (voor gereguleerde workloads, beschikbaarheid en certificering is vaak belangrijk voordat de kwaliteit dat doet)?
Waar het meestal misgaat
Teams horen op inconsistente wijze over uitfaseringen, via een e-mail, een portaalbanner of een interne melding, en merken het signaal te laat op. Die vertraging verkort een toch al krap tijdvenster. Zelfstandige ontwikkelaars en kleine teams ontdekken vaak pas dat iets is uitgefaseerd door een fout in productie, in plaats van via een aankondiging.
Wat u meebrengt
Het schema voor buitengebruikstelling en de Models API stellen de gegevens beschikbaar via een stabiel contract. Volwassen organisaties voegen daar bovenop een dunne interne notificatielaag toe om dit naar de juiste verantwoordelijken door te sturen.
Fase 2: Evalueren
Het doel van de evaluatiefase is om het kandidaatdoelmodel te kiezen en te bevestigen dat u het kunt uitvoeren: de juiste regio, het juiste implementatietype, voldoende quotum en beschikbaarheid naast het huidige model, zodat terugdraaien mogelijk blijft. Een succesvol resultaat is een duidelijke keuze uit de kandidaatmodellen, waarbij regio, SKU, quotum en kosten zijn bevestigd voordat de fine-tuning begint.
Wat u moet overwegen
- Kwaliteit en positionering tussen kandidaten. Wanneer er meerdere modellen beschikbaar zijn, bepaal dan welk model op basis van kwaliteit het beste bij uw workload past, en niet alleen welk model het hoogst scoort op een openbare benchmark.
- Kosten voor uw eigen verkeer. Prijsstructuur verschuift tussen modelgeneraties. Reasoning-tokens, gecachete invoer en overhead van gestructureerde output kunnen de kostenefficiëntie per eenheid met een factor 2 of meer doen schommelen, dus baseer de maandelijkse kostenraming op historische verkeersgegevens en niet alleen op de lijstprijs.
- Operationele beschikbaarheid. Bevestig de regio, de SKU en het quotum en of het doel naast de bron kan worden uitgevoerd, zodat u een terugdraaipad behoudt.
- Nalevingscontrole Voor gereguleerde workloads kunnen certificering en regionale beschikbaarheid de kandidatenlijst al filteren voordat kwaliteit überhaupt ter sprake komt.
Waar het meestal misgaat
Keuzestress ontstaat wanneer meerdere kandidaten een onduidelijke positionering hebben. Teams ontdekken pas halverwege dat het gekozen model niet beschikbaar is in hun regio of voor hun SKU. Of een kostenprojectie laat zien dat het nieuwe model materieel duurder is voor echt verkeer.
Wat u meebrengt
Benchmarks worden berekend op openbare gegevenssets, dus behandel het leaderboard als een filter in plaats van de finishlijn en bevestig de shortlist voor uw eigen workload. Kostenprojectie is hetzelfde verhaal: de maandelijkse weergave komt uit uw eigen tokenlogboeken, wat eenvoudig is zodra u de verkeersgegevens hebt.
Fase 3: Aanpassen
Het doel van de aanpassingsfase is om de workload goed te laten functioneren op het nieuwe model. Herhaal eerst de bestaande workload ongewijzigd (om modelgestuurde gedragswijzigingen te isoleren), diagnose te stellen wat er is verschoven en vervolgens iteratief opnieuw te engineeren. Een geslaagd resultaat is een vergelijking van het gedrag naast elkaar ten opzichte van echt of representatief verkeer, waarbij elke wijziging wordt bijgehouden.
Adapt is meer dan het bewerken van prompts
Prompts zijn het meest zichtbare oppervlak, maar een migratie raakt meestal vier andere:
-
Parameters.
temperature,top_p,max_tokensen instellingen voor redeneercapaciteit komen niet één-op-één overeen tussen generaties, en nieuwere modelfamilies ondersteunen mogelijk bepaalde parameters niet. - Definities van hulpmiddelen. Mogelijk moet u argumentnamen, beschrijvingen en vereiste velden die het oude model betrouwbaar hebben geleid, opnieuw verwoorden of verscherpen.
- Uitvoerschema's. Modellen verschillen in hoe ze voldoen aan gestructureerde uitvoer. Mogelijk moet u expliciete beperkingen toevoegen aan een schema waaraan het oude model losjes is voldaan, of misschien kunt u eindelijk een schema afdwingen.
- Aanroepende code. Verschillen in API en SDK (Chat Completions versus Responses, de streamingstructuur en nieuwe of hernoemde verzoekvelden). Mogelijk moet u ook downstreamparsering bijwerken waarbij wordt uitgegaan van de oude antwoordshape.
Voor agentische en workflowworkloads is werk aan schema’s en toolcalls vaak belangrijker dan promptwerk.
Wat u moet overwegen
- Speel zonder wijzigingen opnieuw af voordat u afstemt. Voer uw huidige configuratie uit op het doelmodel zonder wijzigingen. Deze aanpak helpt u het gedrag te onderscheiden dat door het model is veranderd van de wijzigingen die u introduceert, en geeft u een referentiepunt.
- Kijk wat er werkelijk verschuift. Woordrijkheid, de diepgang van de redenering, naleving van gestructureerde uitvoer, de structuur van toolaanroepen, weigeringsgedrag en variatie in latentie veranderen allemaal vaak.
- Speel echte traces opnieuw af om regressies in toolaanroepen op te sporen. Extra velden, hernoemde argumenten en gewijzigde sequentiërende oppervlakte alleen in echte traceringen, niet in benchmarks met één draai.
- Houd uw wijzigingen bij. Het herontwerpen van prompts is eenvoudig uit te voeren en gaat ook weer gemakkelijk verloren. Bewaar het origineel en noteer wat er is gewijzigd en waarom.
Foundry-functies
Drie Foundry-functies ondersteunen deze fase:
- Prompt Optimizer is de knop Optimaliseren direct onder het veld systeeminstructies in de speeltuin Agent. Het herstructureert uw instructies met best practices voor prompt-engineering, toont redenering per alinea voor elke wijziging en ondersteunt een herhalingslus: voeg een suggestie toe, zoals 'het JSON-schema exact behouden' en optimaliseer opnieuw. Alleen beschikbaar in Foundry, niet Azure OpenAI.
- Optimalisatie van agents stemt instructies, hulpprogramma's en modelselectie gezamenlijk af voor agentworkloads. Alleen beschikbaar in Foundry, niet Azure OpenAI.
- Simulator genereert synthetische en adversariële invoerdata wanneer u geen productiegegevens hebt om te herhalen.
Waar het meestal misgaat
Voor ingesloten, productgerichte workloads duurt deze fase meestal het meest omdat de diagnoselus handmatig is: teams vragen opnieuw uitvoeren, de verschillen vergelijken en zelden vastleggen wat ze hebben gewijzigd of waarom.
Wat u meebrengt
- Begin met de optimalisatiefuncties en controleer vervolgens. Ze passen algemene aanbevolen procedures in één pas toe in plaats van aan uw gegevensset te passen en ze stemmen instructietekst af in plaats van hulpprogrammadefinities of uitvoerschema's. Behandel de uitvoer als een goede eerste versie: kopieer eerst je oorspronkelijke prompt (er is geen versiegeschiedenis) en beoordeel die wijziging daarna opnieuw aan de hand van je bevroren dataset voordat je die vertrouwt.
- Plan extra praktische werkzaamheden voor verplaatsingen tussen gezinnen. Er is geen proces om te 'optimaliseren voor specifiek model X', dus overstappen tussen modelfamilies vereist een bewuste vertaling van prompts en schema's.
- Noteer verkeer voordat u het nodig hebt. Opnieuw afspelen is alleen zo goed als uw opname en inhoudsopname is opt-in en nooit met terugwerkende kracht.
Fase 4: Valideren
Het doel van de fase Valideren is om te bepalen of de aangepaste workload veilig kan worden verzonden door deze te scoren op basis van een kwaliteitsrubriek op een gecureerde gegevensset. De rubriek kan gebaseerd zijn op regels, verwijzingen, een LLM-as-judge, menselijke beoordeling of een domeinspecifiek framework. Een succesvol resultaat is het opleveren van een betrouwbare evaluatiesuite, uitgevoerd op een vastgezette dataset, waarin zowel het app-team als eventuele beoordelaars vertrouwen hebben.
Valideren is één fase, maar het heeft twee contactpunten, dus beschouw het niet als één afsluitend moment aan het einde van de lijn:
- Bereid je vroeg voor. Bevriezen van de gegevensset en succescriteria in Voordat u migreert, voordat u zich aanpast. Zodra die veranderen, zijn je bron en doel niet langer vergelijkbaar.
- Poort laat, in twee passen. Voer eerst het huidige model uit op de vaste dataset om een startbaseline vast te stellen, de waarde die u moet overtreffen. Beoordeel vervolgens het target aan de hand van dezelfde set en beslis.
Wat u moet overwegen
- Houd de gegevensset en criteria geblokkeerd. Dit is de enige belangrijkste discipline in het proces om resultaten vergelijkbaar te houden.
- Meet de drie dimensies die relevant zijn voor goedkeuring: kwaliteit (scores van beoordelaars of reviewers), latentie (tijd-tot-eerste-token en doorvoer, afzonderlijk gemeten voor de aanroep die u migreert) en kosten (de kosten van invoer- en uitvoertokens per aanvraag).
- Koppel de rubriek aan de werkbelasting. Een klinische samenvattingsrubriek, een voorwaarde voor de volgorde van toolaanroepen door agenten, of reeds aanwezige signalen uit gebruikersfeedback kunnen betekenisvoller zijn dan een algemene score.
- Beschouw dit als een signaal voor teams die van nature met AI werken. In plaats van een eenmalige geslaagd/gezakt-beoordeling vindt de evaluatie continu plaats, bij elke commit, en wordt deze geïntegreerd met Roll out.
Foundry-functies
Twee Foundry-functies ondersteunen deze fase:
- Azure AI Evaluation SDK bevat meer dan 30 ingebouwde evaluatoren voor feitelijke onderbouwing, relevantie, informatieophaling, coherentie, vloeiendheid, referentiegebaseerde metrieken (F1, BLEU en ROUGE), veiligheid, agent- en Azure OpenAI-beoordelaars. Het bevat ook een aangepaste LLM-as-judge voor taakspecifieke rubrieken.
- Portalevaluatie past dezelfde evaluatoren toe op model-, agent-, dataset- en tracedoelen.
Pas dezelfde reeks evaluatoren toe op zowel bron als doel in de bevroren dataset, zodat de cijfers vergelijkbaar zijn.
| Dimensie | Wat te meten | Waar |
|---|---|---|
| Quality | Evaluatorscores op bron versus doel | Azure AI Evaluation SDK, portalevaluatie |
| Wachttijd | Tijd tot het eerste token en doorvoer | Benchmark leaderboard, operationele metrische gegevens |
| Cost | Kosten van invoer- en uitvoertoken per aanvraag | Evaluatie-uitvoer, modelprijzen |
Waar het meestal misgaat
De meeste teams hebben geen evaluatiesuite, en de teams die er wel een hebben, hebben die vaak zelf gebouwd. Voor gereguleerde workloads zit een verplichte beoordeling voor menselijk of kwaliteitsbeheer bovenaan en wordt het knelpunt. Deze migraties staan vast bij Validate, niet Adapt.
Wat u meebrengt
De evaluators zijn klaar voor gebruik, maar het samenstellen van een domeinrelevante testset op basis van uw eigen productieverkeer is handmatig werk voor modelworkloads (geen agents). Deze behoefte is waarom de voorbereidingsstap zichzelf terugverdient.
Fase 5: Uitrollen
Het doel van deze fase is het bevorderen van de gevalideerde configuratie naar productie in fasen: niet-productie eerst, vervolgens een kanarie of gewogen percentage en vervolgens een bredere blootstelling. Houd voortdurend de latentie, fouten en, bij voorkeur, de kwaliteit in de gaten ten opzichte van de basislijn van vóór de migratie. Voer vervolgens door of draai terug. Een geslaagd resultaat is een geleidelijke blootstelling via kanarie, gewogen of schaduwverkeer, een livekwaliteitssignaal buiten latentie en fouten en een behouden terugdraaipad.
Wat u moet overwegen
- Ken uw implementatietype. Uw implementatietype bepaalt de mechanica: Implementaties van de standaardfamilie kunnen automatisch upgraden volgens een schema dat u beheert. Geprovisioneerde, batch- en fijnafgestelde implementaties moeten handmatig worden gemigreerd. De volgende tabel toont de mechanismen per type.
- Bewaar een terugdraaigang. Houd de oude implementatie bereikbaar totdat u er zeker van bent. Terugdraaibeslissingen die worden afgedwongen door een uitfaseringsdeadline in plaats van op basis van bewijs, zijn een waarschuwingssignaal dat u te laat bent gestart.
- Gebruik de shadow- of mirrormodus als u geen canary-deployment kunt uitvoeren. Gereguleerde stromen (PHI, financiële transacties) kunnen vaak geen nieuw model blootstellen aan echt klantverkeer. Het equivalent voert het nieuwe model uit op productie-invoer offline en vergelijkt de uitvoer met het oude model zonder dat dit van invloed is op gebruikers.
- Let op regressies die bij de offline-evaluatie zijn gemist. De latentie van echte gebruikers en gedrag in uitzonderingssituaties kunnen pas onder productiebelasting aan het licht komen.
Migratiemechanica per implementatietype
| Implementatietype | Migratiebenadering | Quota |
|---|---|---|
| Standard, Globale standaard, Standaard voor gegevenszone | Automatische upgrade volgens een doorlopend schema. Tijdsinstellingen beheren met versionUpgradeOption (OnceNewDefaultVersionAvailable, OnceCurrentVersionExpiredof NoAutoUpgrade). Prioriteitsverwerking volgt hetzelfde pad. |
Wordt automatisch overgedragen |
| Geconfigureerd | Handmatig: in-place (verkeer wordt verplaatst over een venster van 20-30 minuten) of naast elkaar (nieuwe implementatie, verkeer verplaatsen, het oude verplaatsen). | Zorg ervoor dat het quotum van het doelmodel eerst wordt gegarandeerd |
| Batch | Naast elkaar: het nieuwe model implementeren, taken opnieuw indienen en de oude implementatie buiten gebruik stellen. | Quota voor doelmodel garanderen |
| Nauwkeurig afgestemd (buiten het bereik van dit artikel) | Niet automatisch geüpgraded; afzonderlijke uitfaseringsperiode voor training en deployment. Stem opnieuw af of distilleer naar het vervangende basismodel. | Quota voor doelmodel garanderen |
Nadat het verkeer is verplaatst, configureert u doorlopende evaluatie om een steekproef van het productie-verkeer te beoordelen op het Foundry Observability-dashboard, gekoppeld aan traceringen voor een hoofdoorzaakanalyse, en Azure Monitor-waarschuwingen wanneer de kwaliteit terugloopt.
Waar het meestal misgaat
Kwaliteitsregressies die tijdens de offline-evaluatie zijn gemist, komen bij productiebelasting aan het licht. Beslissingen om terug te draaien worden vaak eerder ingegeven door een deadline voor uitfasering dan door feitelijk bewijs, wat erop wijst dat de migratie te laat is gestart.
Wat u meebrengt
Gewogen routering tussen twee uitrolversies wordt in uw eigen gateway of toepassingslaag geïmplementeerd, en de rollbackperiode is een bewuste keuze om de oude uitrolversie gedurende een bepaalde periode warm te houden (embedded-teams willen doorgaans ongeveer 30 dagen). Beide zijn het waard om één keer te ontwerpen en voor elke migratie te hergebruiken.
Fase 6: Buiten gebruik stellen
Het doel van de Retire-fase is om de oude uitrol buiten gebruik te stellen, capaciteit vrij te maken, evaluatieartefacten te archiveren en de wijziging verderop in de keten door te voeren in klantgerichte documentatie, marketingpagina's, supportdraaiboeken en auditlogboeken waarvoor bewaring vereist is. Aan het einde is de oude uitrol verdwenen, neemt het aantal uitrols af en worden de geleerde lessen meegenomen naar de volgende cyclus.
Wat u moet overwegen
- Beschouw uitfasering als een governancevraagstuk, niet alleen als opschoning. Voor gereguleerde workloads kunnen bewaarverplichtingen vereisen dat artefacten jarenlang worden bewaard.
- Controleer of de bron daadwerkelijk is verdwenen. Controleer of de oude versie buiten gebruik is gesteld en verwijder vervolgens de implementatie, zodat de capaciteit niet meer wordt verbruikt.
- Gebruik opgedane inzichten in het vervolg. Vouw nieuwe productietraceringen terug naar uw gouden gegevensset, zodat de volgende migratie goedkoper begint.
Waar het meestal misgaat
Teams slaan de uitfasering over, waardoor zombie-implementaties zich opstapelen. Teams die verouderde implementaties niet actief uitfaseren, hebben veel meer productie-implementaties live dan vergelijkbare teams, en het grootste deel daarvan bestaat uit structurele restanten van eerdere migraties. Een veelvoorkomende gemiste substap is communicatie: marketing- en productdocumentatie verwijzen nog steeds naar het oude model na de wissel.
Wat u meebrengt
Het waarneembaarheidsdashboard toont het aantal implementaties dat omlaag loopt, maar het bepalen welke implementaties nog steeds de belasting dragen, is een beoordelingsgesprek dat uw team doet. Maak van uitfasering een taak die expliciet wordt bijgehouden, in plaats van iets waar je alleen maar op hoopt.
Migratie is zelden binair
Echte migraties zijn vaak gesplitst: een deel van een workload wordt uitgevoerd op het nieuwe model, terwijl een latentiegevoelig of hoger risicopad op de oude blijft staan, soms gedurende weken. Plan voor een gedeeltelijke uitrol en een gedeeltelijke terugdraaiing in plaats van één enkele overstap van het oude model naar het nieuwe model. De uitfasering loopt vaak weken of maanden achter op de uitrol, en die oude implementaties die blijven bestaan, worden zichtbaar als wildgroei.
Verwante onderwerpen
- Inzicht in verouderings- en ondersteuningstermijnen in het levenscyclus- en ondersteuningsbeleid van Foundry Models
- Datums en vervangingen controleren in het schema voor buitengebruikstelling van het model
- Bekijk wat er al buiten gebruik is gesteld in buiten gebruik gestelde Microsoft Foundry-modellen
- Kandidaatmodellen vergelijken met modelbenchmarks en leaderboards
- Prompts aanpassen aan een nieuw model met prompts optimaliseren met Prompt Optimizer
- Kwaliteit valideren voordat u overschakelt door evaluaties uit te voeren vanuit de Foundry-portal
- Bewaak de gemigreerde workload met Observability in generatieve AI