Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Ważna
Ta funkcja jest dostępna w wersji beta. Aby z niego korzystać, administrator przestrzeni roboczej musi włączyć Sesje pamięci Agenta na stronie Podglądów . Zobacz Zarządzanie wersjami zapoznawczami usługi Azure Databricks.
Pamięć agenta daje agentowi pamięć długoterminową, która utrzymuje się między rozmowami. Azure Databricks przechowuje pamięć w Lakebase i zarządza przechowywaniem, indeksowaniem oraz wyszukiwaniem za Ciebie, dzięki czemu Twoi agenci mogą pamiętać preferencje użytkownika, wcześniejsze decyzje i zgromadzony kontekst bez konieczności korzystania z bazy danych.
Note
W okresie wersji zapoznawczej są naliczane opłaty za bazową instancję Lakebase, która przechowuje Twoje wpisy w pamięci. Nie nalicza się dodatkowych opłat za samą pamięć agenta. Ceny mogą ulec zmianie w miarę postępu zapowiedzi.
Używaj pamięci agenta, gdy chcesz, aby twoi agenci:
- Pamiętaj o preferencjach użytkowników, faktach i decyzjach w różnych rozmowach.
- Personalizuj odpowiedzi na podstawie tego, czego agent nauczył się podczas wcześniejszych sesji.
- Dziel się zgromadzoną wiedzą między agentami i projektami.
- Zwiększaj dokładność i wydajność z czasem.
Pamięć agenta działa z agentami opartymi na dowolnym frameworku. Aby zachować krótkotrwałą historię rozmów w ramach jednej interakcji, użyj sesji agenta. Aby zapoznać się z tym, jak sesje, pamięć i potoki pamięci ze sobą współgrają, zobacz Pamięć agenta i sesje.
Aby przechowywać pamięć w bazie danych Lakebase, którą zarządzasz samodzielnie, zobacz podejście Self-managed agent memory (Lakebase).
Requirements
- Zainstaluj Python 3.10 lub nowszy, aby korzystać z SDK AgentKit. AgentKit SDK to klient Databricks Python dla API agentów, którego używają poniższe przykłady. Możesz też wywołać REST API bezpośrednio z dowolnego języka, bez konieczności używania Python.
- Aby użyć
memory_store.put()lubmemory_store.list(path=...), zainstalujdatabricks-agentbrickswersję 0.6.0 i wyższą.
Jak działa pamięć agenta
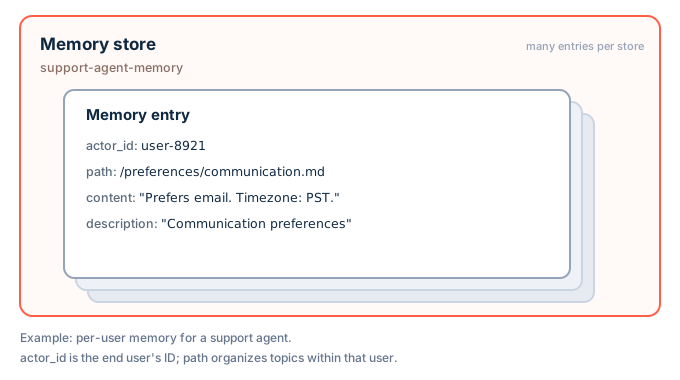
Pamięć agenta ma dwa poziomy:
- Magazyn pamięci to kontener w obrębie obszaru roboczego na wspomnienia agenta. Tworzenie sklepu automatycznie zapewnia pamięć Lakebase wspierającą. Do sklepu odwołujesz się za pomocą jego identyfikatora sklepu, który wybierasz podczas tworzenia sklepu.
-
Wpis pamięci to pojedynczy element w magazynie danych. Każdy wpis zawiera tekst
contentw formie swobodnej , skrótdescriptionużywany do wyszukiwania oraz zestaw pól organizujących i dzielących go:-
actor_id(wymagane): do kogo należy pamięć, na przykład do użytkownika końcowego lub innego agenta. -
session_id(opcjonalnie): sesja, do której należy pamięć. Zostaw to nieustawione dla pamięci obowiązującej we wszystkich sesjach aktora. -
path(wymagane): ścieżka podobna do systemu plików, która organizuje wpisy w aktorze, taka jak/preferences/response-style.md.
-
Element jest jednoznacznie identyfikowany przez kombinację actor_id, session_id, oraz path. Ta sama ścieżka w dwóch różnych sesjach lub w ramach sesji i poza nią zawiera dwa oddzielne wpisy.
Wpisy trafiają do repozytorium na dwa sposoby: agent lub aplikacja zapisuje je bezpośrednio albo potok pamięci wyodrębnia je z rozmów w repozytorium sesji.
Odzyskiwanie
Przywołaj pamięć na dwa sposoby:
-
Wyświetl wpisy dla aktora, opcjonalnie filtrowane przez
session_id, prefikspathlub dokładnypath. Użyj tego do przeglądania lub renderowania indeksu tego, co agent wie. - Wyszukaj wpisy dotyczące aktora za pomocą zapytania w języku naturalnym. Wyszukiwanie zwraca najbardziej trafne wpisy uporządkowane według oceny trafności.
Filtr session_id w dowolnej z operacji zwraca tylko wpisy zapisane w tej sesji. Nie zwraca zapisów zapisanych bez sesji.
Wprowadzenie
Przykłady AgentKit SDK i REST API konfigurują pamięć agenta dla agenta wsparcia: tworzą oni magazyn pamięci, zapisują preferencje użytkownika i przywołują je w późniejszej rozmowie. Przykład CLI Agent Bricks łączy magazyn pamięci z agentem, którego tworzysz i wdrażasz za pomocą CLI. Wybierz klienta, który pasuje do Twojego projektu. Identyfikator magazynu pamięci musi mieć od 3 do 56 znaków, zaczynać się od małej litery, kończyć na literę lub cyfrę i zawierać jedynie małe litery, cyfry i łączniki.
AgentKit SDK
AgentKit SDK to klient Databricks Python dla API agentów, dystrybuowany w databricks-agentbricks pakiecie. Uwierzytelnia się przy użyciu zestawu SDK Databricks WorkspaceClient.
Zainstaluj AgentKit SDK:
pip install databricks-agentbricksStwórz magazyn pamięci dla swojego agenta.
AgentKitClientuwierzytelnia się za pomocą TwoichWorkspaceClientdanych uwierzytelniających:from databricks.sdk import WorkspaceClient from databricks_agentkit import AgentKitClient client = AgentKitClient(WorkspaceClient()) memory_store = client.memory_stores.create("support-agent-memory")create()Nie powiedzie się, jeśli magazyn już istnieje. W późniejszych sesjach otwórz zamiast tego istniejący magazyn:memory_store = client.memory_stores.get("support-agent-memory")Zapisz wspomnienie po tym, jak agent dowiaduje się czegoś trwałego o użytkowniku.
actor_idokreśla, czyja to pamięć,pathorganizuje ją w obrębie tego aktora, adescriptionpoprawia jej wyszukiwanie:memory_store.add( actor_id="user-123", path="/preferences/communication.md", content="Prefers email over phone. Timezone: PST. Enterprise subscription.", description="User 123 communication preferences", )add()kończy się błędemALREADY_EXISTS, jeśli wpis już istnieje na tej ścieżce. Aby utworzyć wpis lub zaktualizować istniejący, wywołajmemory_store.put()z tymi samymi argumentami.Przypomnij sobie wspomnienia użytkownika w późniejszej rozmowie za pomocą wyszukiwania w języku naturalnym:
results = memory_store.search(actor_id="user-123", query="communication preferences", limit=10)Usuń wspomnienia zapisane na tej ścieżce, gdy nie będą już potrzebne:
for memory in memory_store.list(actor_id="user-123", path="/preferences/communication.md"):
    memory.delete()
interfejs API REST
Klienci wywołują interfejs API REST pod adresem /api/2.0/agents/memory-stores. Wywołuj ją bezpośrednio w językach innych niż Python.
Ustaw nazwę hosta swojej przestrzeni roboczej, bez
https://, i wygeneruj token OAuth za pomocą Databricks CLI:export DATABRICKS_HOST=<workspace-hostname> databricks auth login --host https://${DATABRICKS_HOST} export DATABRICKS_TOKEN=$(databricks auth token | jq -r .access_token)Stwórz magazyn pamięci dla swojego agenta:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores?managed_memory_store_id=support-agent-memory" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"description": "Support agent memory"}'
Zapisz wpis w pamięci dla użytkownika.
actor_idokreśla, czyja to pamięć,pathorganizuje ją, adescriptionpoprawia wyszukiwanie:curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \ -d '{"actor_id": "user-123", "path": "/preferences/communication.md", "content": "Prefers email over phone.", "description": "Communication preferences"}'Jeśli wpis już istnieje na tej ścieżce, żądanie kończy się niepowodzeniem z błędem
ALREADY_EXISTS(HTTP 409). Aby zamiast tego zaktualizować istniejący wpis, wyszukaj go po ścieżce. Wyszukiwanie zwraca wpisy ścieżki dla każdej sesji w tablicymanaged_memory_entries:{ "managed_memory_entries": [ { "name": "memory-stores/support-agent-memory/entries/<entry-id>", "actor_id": "user-123", "path": "/preferences/communication.md", "content": "Prefers email over phone.", "description": "Communication preferences", "create_time": "2026-11-08T01:20:05Z", "update_time": "2026-11-08T01:20:05Z" } ] }Aby dopasować sesję, porównaj
session_id. Wpis zapisany bez sesji nie ma polasession_id, więc wybierz wpis, który nie ma takiego pola. Ostatni segmentnamewpisu to ID wpisu. Poniższe polecenie wyszukuje wpis zapisany bez udziału sesji i zapisuje jego identyfikator wEID:EID=$(curl -s -G "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" \ --data-urlencode "actor_id=user-123" --data-urlencode "path=/preferences/communication.md" \ | jq -r '.managed_memory_entries[] | select(.session_id == null) | .name | split("/") | last')Następnie zaktualizuj zawartość wpisu według jego ID:
curl -X PATCH "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries/${EID}?update_mask=content" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \ -d '{"content": "Prefers email over phone. Timezone: PST."}'Przywołaj wspomnienia użytkownika za pomocą wyszukiwania w języku naturalnym:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries:search" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \ -d '{"actor_id": "user-123", "query": "communication preferences"}'Uszeregowane wyniki są w
results, od najbardziej trafnych. Każdy wynik mamanaged_memory_entryi trafnośćscore, gdzie wyższy wynik jest bardziej istotny. Odpowiedź powtarza również te same wpisy, w tej samej kolejności i bez ocen, w tablicy najwyższego poziomumanaged_memory_entries. Ta tablica jest przestarzała, więc przeczytajresults:{ "results": [ { "managed_memory_entry": { "name": "memory-stores/support-agent-memory/entries/<entry-id>", "actor_id": "user-123", "path": "/preferences/communication.md", "content": "Prefers email over phone. Timezone: PST.", "description": "Communication preferences" }, "score": 0.87 } ], "managed_memory_entries": [ { "name": "memory-stores/support-agent-memory/entries/<entry-id>", "actor_id": "user-123", "path": "/preferences/communication.md", "content": "Prefers email over phone. Timezone: PST.", "description": "Communication preferences" } ] }Usuń wpis, gdy już go nie potrzebujesz. Wyszukaj to ponownie według ścieżki, a następnie usuń według ID:
EID=$(curl -s -G "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" \ --data-urlencode "actor_id=user-123" --data-urlencode "path=/preferences/communication.md" \ | jq -r '.managed_memory_entries[] | select(.session_id == null) | .name | split("/") | last') curl -X DELETE "https://${DATABRICKS_HOST}/api/2.0/agents/memory-stores/support-agent-memory/entries/${EID}" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}"
Agent Bricks
Jeśli zbudujesz swojego agenta za pomocą Agent Bricks CLI, magazyn pamięci jest deklarowany w agent.toml przez agentbricks init.
agentbricks deploy tworzy magazyn danych, jeśli jeszcze nie istnieje, i przyznaje wdrożonemu agentowi dostęp do niego.
Wybierz ścieżkę:
Zacznij od pustego (większość agentów): Wdróż agenta.
agentbricks deploytworzy magazyn pamięci zadeklarowany przezagentbricks init. Aby wdrożyć agenta o nazwiemy-agent, wykonaj następujące czynności:agentbricks deploy my-agentZacznij od pamięci już znajdujących się w magazynie: najpierw utwórz magazyn, dodaj wpisy, następnie powiąż magazyn z agentem i wdroż.
Aby utworzyć sklep o nazwie
my-agent-memory, uruchom poniższe polecenie. Wynik zawiera identyfikator sklepu, wygenerowany identyfikator oddzielny od nazwy sklepu:agentbricks memory stores create --name my-agent-memoryAby dodać wpis, wykonaj poniższe polecenie, zastępując
<store-id>identyfikatorem sklepu z poprzedniego kroku:agentbricks memory entries create --store <store-id> --actor-id you@example.com \ --path /preferences/style.md --content "Prefers Python and concise answers with code examples."Aby połączyć sklep i wdrożyć agenta, wykonaj poniższe.
agentbricks memory bindzastępuje nazwę sklepu wagent.toml, aagentbricks deployznajduje istniejący sklep według nazwy i używa go zamiast tworzyć nowy:agentbricks memory bind my-agent-memory agentbricks deploy my-agent
--path to klucz wpisu znajdujący się w magazynie, a nie plik na twoim komputerze.
--actor-id jest użytkownikiem, do którego należy pamięć. Wdrożony agent używa adresu e-mail zalogowanego użytkownika jako identyfikatora aktora, więc dodaj do każdego wpisu adres e-mail użytkownika, który rozmawia z agentem.
W CLI Agent Bricks memory bind i agentbricks deploy odnoszą się do sklepu po jego nazwie. Polecenia działające na pojedynczym magazynie, takie jak memory entries create, przyjmują wygenerowany identyfikator magazynu.
Daj agentowi narzędzia do pamięci
Aby agent mógł zdecydować, kiedy zapisywać i odczytywać pamięć, opakuj operacje klienta w narzędzia i poinstruuj agenta w jego monicie systemowym, kiedy ma ich używać. Ustaw actor_id w zaufanym kodzie aplikacji na podstawie zweryfikowanej tożsamości użytkownika końcowego. Nigdy nie pozwól modelowi wybierać, czyją pamięć odczytać lub zapisać.
Poniższy przykład obejmuje AgentKit SDK memory_store z Get Start jako narzędzia dla OpenAI Agents SDK.
from agents import Agent, function_tool

def make_memory_tools(memory_store, actor_id: str):
    @function_tool
    def search_memory(query: str) -> str:
        """Search long-term memory for relevant facts about the user."""
        results = memory_store.search(actor_id=actor_id, query=query, limit=10)
        return "\n\n".join(f"{r.memory.path}: {r.memory.content}" for r in results) or "No memory found."

    @function_tool
    def save_memory(path: str, content: str, description: str = "") -> str:
        """Save a durable, long-term memory about the user, replacing any memory at the same path."""
        memory_store.put(actor_id=actor_id, path=path, content=content, description=description or None)
        return f"Saved memory at {path}"

    @function_tool
    def list_memories() -> str:
        """List the paths and descriptions of the user's long-term memories."""
        memories = memory_store.list(actor_id=actor_id)
        return "\n".join(f"{m.path}: {m.description}" if m.description else m.path for m in memories) or "No memory found."

    @function_tool
    def forget_memory(path: str) -> str:
        """Delete the long-term memory at a path, such as when the user asks you to forget it."""
        memories = list(memory_store.list(actor_id=actor_id, path=path))
        for memory in memories:
            memory.delete()
        return f"Forgot memory at {path}" if memories else f"No memory at {path}"

    return [search_memory, save_memory, list_memories, forget_memory]

agent = Agent(
    name="Support agent",
    instructions="Save durable user preferences, recall them when relevant, and forget them when the user asks.",
    tools=make_memory_tools(memory_store, actor_id="user-123"),
)
put() Tworzy wpis lub zastępuje zawartość wpisu już znajdującego się na tej ścieżce. Aby zamiast tego dodać treść jako nowe linie, należy przekazać append=True.
put() nie jest atomowe, więc współbieżne zapisy na tej samej ścieżce mogą się wzajemnie nadpisać.
list(path=...) zwraca wpisy pod tą dokładną ścieżką w każdej sesji, więc forget_memory usuwa również wszelkie wpisy zapisane pod tą ścieżką w danej sesji.
Ten sam schemat działa w Claude Agent SDK i innych frameworkach: opakowanie operacji wyszukiwania, wstawiania, listowania i usuwania magazynu jako typu narzędzia frameworka.
Jeśli uruchamiasz także potok pamięci na tym samym magazynie, potok może przepisywać, scalać, dzielić lub usuwać wpisy, które agent zapisuje dla każdego aktora, którego przetwarza.
Partycjonowanie i zabezpieczona pamięć
W sklepie actor_id służy do rozróżniania, które wspomnienia należą do kogo. Każda lista i wyszukiwanie są ograniczone do jednego actor_id, więc wybierz strategię odpowiadającą temu, co Twój agent powinien zapamiętać:
-
Pamięć prywatna dla każdego użytkownika: Ustaw
actor_idna zweryfikowaną tożsamość użytkownika końcowego. Każdy użytkownik otrzymuje własną partycję, a agent pamięta tylko wpisy tego użytkownika.- Przykład: Agent wsparcia zapamiętuje preferencje komunikacyjne jednego użytkownika oraz wcześniejsze zgłoszenia.
-
Współdzielona pamięć dla grupy: Ustaw
actor_idna wybrany przez siebie klucz stały, taki jak identyfikator zespołu, projektu lub organizacji. Wszyscy czytają i zapisują te same wspomnienia.- Przykład: Agent zespołu zapamiętuje wspólny słownik terminów firmowych i wewnętrznych konwencji.
-
Pamięć dzielona według innego kryterium: Buduj
actor_idna podstawie własnych wartości, takich jak identyfikator dzierżawy lub złożona wartośćuser:project.-
Przykład: Aplikacja wielodzierżawna ustawia
actor_idna{tenant}:{user}, aby użytkownicy każdego klienta pozostawali odizolowani od siebie nawzajem.
-
Przykład: Aplikacja wielodzierżawna ustawia
Ustaw actor_id w kodzie aplikacji w kontekście zaufanego wywołującego: zweryfikowaną tożsamość użytkownika końcowego dla pamięci przypisanej do użytkownika lub zaufany klucz zespołu albo projektu dla pamięci współdzielonej. Nigdy nie pozwól, by modelka go wybrała. Jeśli twoja strategia opiera się na tożsamości użytkownika końcowego, odrzucaj żądania, które jej nie posiadają, zamiast wracać do współdzielonej actor_id.
Warning
actor_id oddziela pamięci, ale nie jest kontrolą dostępu. Magazyny pamięci są ograniczone do przestrzeni roboczej, więc każdy principal, który może uzyskać dostęp do magazynu, może odczytywać i zapisywać każdy wpis we wszystkich aktorach. Sklep, a nie aktor, jest granicą bezpieczeństwa. Aby zapewnić ścisłą izolację między tenantami lub użytkownikami, utwórz oddzielny magazyn pamięci dla każdej granicy.
Aby umożliwić innemu podmiotowi, na przykład przedstawicielowi usługowym Twojego agenta, korzystanie z magazynu, przyznaj mu dostęp za pomocą operacji przyzwolenia sklepu (memory_store.grant_permission(principal_id) w AgentKit SDK). Dostęp może przyznać tylko twórca sklepu lub administrator przestrzeni roboczej. Zobacz Zarządzanie uprawnieniami dla pamięci agenta i magazynów sesji , aby uzyskać poziomy uprawnień, obsługiwane operacje i przykłady.
Limitations
- Pamięć agenta zapewnia wyłącznie pamięć długoterminową. Krótkoterminową historię rozmów można znaleźć w sesjach agentów.
- Wyszukiwanie klasyfikuje wpisy według trafności, łącząc pełny tekst (BM25) i dopasowywanie semantyczne na podstawie treści i opisu każdego wpisu. Zwraca do 100 wpisów i nie obsługuje paginacji.
- Kontrola dostępu jest egzekwowana na poziomie sklepu. Kontrola dostępu na poziomie poszczególnych wpisów i aktorów nie jest dostępna.
- Kontrola dostępu do sklepu obejmuje wejścia do sklepu. Każdy użytkownik przestrzeni roboczej może wyświetlać listę i pobierać magazyny pamięci, w tym ich ID i opisy.
- Nie możesz zmienić identyfikatora sklepu po jego utworzeniu. Tylko
descriptionmożna zaktualizować. - Przestrzeń robocza może mieć maksymalnie 50 magazynów pamięci. Aby zwiększyć ten limit, skontaktuj się ze swoim przedstawicielem Databricks.
Następne kroki
- Pamięć agenta i sesje: Dowiedz się, kiedy używać sesji, pamięci lub obu tych elementów.
- Sesje agenta: Przechowuj krótkoterminową historię rozmów w ramach jednej interakcji.
- Potoki pamięci agenta: Automatycznie destylują wspomnienia z rozmów w magazynie sesji.
- Zarządzaj uprawnieniami do pamięci agenta i magazynów sesji: Nadaj jednostce usługi wdrożonego agenta dostęp do magazynu pamięci.
- Odwołanie do API agenta: Wywołaj REST API magazynu pamięci.
- Pamięć agenta zarządzana samodzielnie (Lakebase): (Legacy) Przechowuj pamięć w bazie danych Lakebase, którą zarządzasz samodzielnie.