Notatka
Dostęp do tej strony wymaga autoryzacji. Może spróbować zalogować się lub zmienić katalogi.
Dostęp do tej strony wymaga autoryzacji. Możesz spróbować zmienić katalogi.
Ważna
Ta funkcja jest dostępna w wersji beta.
Zarządzane sesje agenta zapewniają agentom trwałe, niezależne od używanego frameworka repozytorium stanu sesji: stanu, który agent lub framework utrzymuje w ramach pojedynczej interakcji. Najczęściej jest to historia konwersacji — uporządkowany chronologicznie zapis wiadomości, wywołań narzędzi i wyników, który agent odczytuje na początku tury i uzupełnia w trakcie działania. Może to być również dowolny inny stan, który framework utrzymuje na potrzeby interakcji, na przykład graf LangGraph. Azure Databricks przechowuje je w Lakebase i zarządza pamięcią za ciebie, więc nie budujesz ani nie obsługujesz bazy danych.
Note
W okresie wersji zapoznawczej opłaty są naliczane za bazową instancję Lakebase, która przechowuje Twoje sesje. Za same sesje zarządzanych agentów nie naliczają żadnych dodatkowych opłat. Ceny mogą ulec zmianie w miarę postępu zapowiedzi.
Korzystaj z zarządzanych sesji, gdy chcesz:
- Utrzymuj historię rozmów agenta, aby przetrwała restarty i mogła być wznowiona później.
- Odtwórz pełny kontekst (w tym wywołania narzędzi i rozumowanie) w kolejnej wiadomości.
- Wyświetlaj, wznawiaj i twórz odgałęzienia wcześniejszych rozmów we własnym interfejsie.
Sesje zarządzane przechowują stan pojedynczej interakcji (stan krótkotrwały, w trakcie sesji). Aby uzyskać trwałą pamięć długoterminową, która utrzymuje się między rozmowami, użyj zarządzanej pamięci agenta.
Jak działają sesje zarządzane
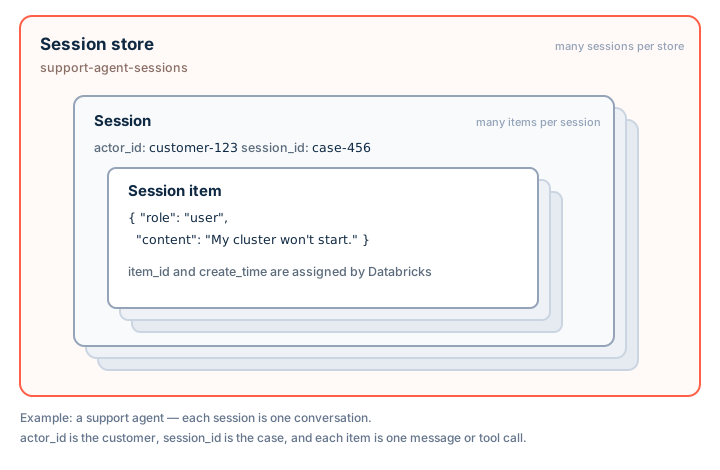
Sesje zarządzane mają trzy poziomy:
-
Repozytorium sesji to kontener ograniczony do obszaru roboczego na sesje agenta. Tworzenie sklepu automatycznie zapewnia pamięć Lakebase wspierającą. Wybierasz unikalną
session_store_nameprzestrzeń roboczą. -
Sesja to jedna trwała interakcja (zazwyczaj wątek rozmowy) w sklepie. Sesję identyfikuje się po:
-
actor_id(wymagane): do kogo należy sesja, na przykład do użytkownika końcowego lub innego agenta. Grupuje wszystkie sesje jednego obiektu, dzięki czemu możesz je razem wyświetlać na liście i filtrować. Gdy tworzysz aplikację przypisaną do użytkownika, ustawactor_idna identyfikator użytkownika (na przykład zweryfikowaną tożsamość użytkownika końcowego z mechanizmu uwierzytelniania w aplikacji), aby sesje każdego użytkownika były grupowane razem. Ustaw ją w zaufanym kontekście aplikacji, nigdy na podstawie wartości dostarczonej przez model ani przez użytkownika. -
session_id(opcjonalnie): ID wybrane przez dzwoniącego do interakcji. Usługa generuje jeden, gdy go pominiesz. -
parent_session_id(opcjonalnie): łączy sesję z sesją, z której została rozgałęziona, aby odzwierciedlić rozgałęzione rozmowy.
-
-
Element sesji to jeden wpis w historii uporządkowanej sesji. Każdy element zawiera nieprzejrzystą, zgodną
dataz JSON wartość, taką jak wiadomość, wywołanie narzędzia, wynik narzędzia lub blok rozumowania. Azure Databricks przypisuje każdemu elementowi znacznikiitem_idicreate_timeoraz nie sprawdza ani nie weryfikuje jego zawartości. Przedmioty są niezmienne po ich dodaniu.
Usługa zachowuje deterministyczną kolejność elementów danej sesji i autoryzuje każdą operację w magazynie sesji.
Wymagania
- Zainstaluj Python 3.10 lub nowszy, aby korzystać z SDK AgentKit. AgentKit SDK to klient Databricks Python dla API agentów, którego używają poniższe przykłady. Możesz też wywołać REST API bezpośrednio z dowolnego języka, bez konieczności używania Python.
Wprowadzenie
Te przykłady konfigurują zarządzane sesje dla agenta wsparcia: tworzą magazyn sesji, uruchamiają sesję dla jednej rozmowy, dodają kolejne wypowiedzi w rozmowie i odczytują historię podczas późniejszego żądania. Wybierz klienta, który pasuje do Twojego projektu.
AgentKit SDK
AgentKit SDK to klient Databricks Python dla API agentów, dystrybuowany w databricks-agentbricks pakiecie. Uwierzytelnia się przy użyciu zestawu SDK Databricks WorkspaceClient.
Zainstaluj AgentKit SDK:
pip install databricks-agentbricksUtwórz magazyn danych sesji, a następnie rozpocznij sesję na potrzeby jednej rozmowy.
actor_idjest tym, do kogo należy rozmowa; opcjonalnesession_idjednoznacznie identyfikuje tę rozmowę:from databricks.sdk import WorkspaceClient from databricks_agentkit import AgentKitClient client = AgentKitClient(WorkspaceClient()) session_store = client.session_stores.create("support-agent-sessions") session = session_store.add(actor_id="customer-123", session_id="case-456")Dodawaj wypowiedzi w rozmowie podczas działania agenta. Każdy element to dowolna wartość zgodna z JSON:
session.append_items(
    [
        {"type": "message", "role": "user", "content": "I need help with my cluster."},
        {"type": "message", "role": "assistant", "content": "Let's take a look."},
    ]
)
W przypadku kolejnego żądania załaduj sesję i przeczytaj jej pełną historię, aby odbudować kontekst:
session = session_store.get("case-456")
# Request chronological order; list_items defaults to newest-first and auto-pages.
history = [item.data for item in session.list_items(order_by="create_time asc")]
interfejs API REST
Klienci wywołują interfejs API REST pod adresem /api/2.0/agents/session-stores. Wywołuj ją bezpośrednio w językach innych niż Python.
Wygeneruj token OAuth za pomocą Databricks CLI:
databricks auth login --host ${DATABRICKS_HOST}
export DATABRICKS_TOKEN=$(databricks auth token | jq -r .access_token)
Stwórz magazyn sesji dla swojego agenta:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores?session_store_name=support-agent-sessions" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"description": "Support agent conversation history"}'
Rozpocznij sesję na jedną rozmowę.
actor_idjest tym, do kogosession_idnależy; unikalnie identyfikuje tę rozmowę:curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores/support-agent-sessions/sessions?session_id=case-456" \ -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \ -d '{"actor_id": "customer-123"}'Dodaj turę rozmowy podczas działania agenta:
curl -X POST "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores/support-agent-sessions/sessions/case-456/items:append" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" -H "Content-Type: application/json" \
  -d '{"items": [{"data": {"type": "message", "role": "user", "content": "I need help with my cluster."}}]}'
Przeczytaj historię w kolejności chronologicznej, aby odbudować kontekst:
curl -G "https://${DATABRICKS_HOST}/api/2.0/agents/session-stores/support-agent-sessions/sessions/case-456/items" \
  -H "Authorization: Bearer ${DATABRICKS_TOKEN}" --data-urlencode "order_by=create_time asc"
Klienci obsługują także usunięcie najnowszego elementu, wyczyszczenie elementów sesji oraz utworzenie niezależnej kopii rozmowy (opcjonalnie do określonego elementu). Usunięcie sesji, która ma sesje potomne, wymaga użycia opcji force, aby kaskadowo usunąć również te sesje (na przykład session.delete(force=True)).
Wspieraj sesję frameworka agenta sesjami zarządzanymi
Frameworki agentów, takie jak OpenAI Agents SDK i Claude Agent SDK, odczytują historię rozmów na początku przebiegu i dodają nowe elementy na końcu. Magazyn sesji bezpośrednio odpowiada temu wzorcowi:
| Działanie ramowe | Połączenie z magazynem sesji |
|---|---|
| Przeczytaj historię |
list_items w kolejności chronologicznej (order_by="create_time asc") |
| Dodaj elementy obrotu |
append Nowe przedmioty |
| Cofnij ostatni element |
pop Najnowszy przedmiot |
| Oczyść wątek |
clear Elementy sesji |
Zakres i dostęp
Sesje zarządzane przechowują elementy sesji jako niejawne wartości zgodne z formatem JSON: usługa zapisuje i zwraca wszystko, co doda agent lub aplikacja oparta na frameworku, nie interpretując tych danych. Nie dodaje zasobów sterowania wykonaniem, takich jak uruchomienia, punkty kontrolne czy zatwierdzenia, jako podstawowych pojęć, chociaż struktura serializująca taki stan może trwale przechowywać je jako elementy.
Magazyny sesyjne są przypisane do obszaru roboczego, a dostęp jest przyznawany na poziomie magazynu. Pola metadata i actor_id obsługują tylko grupowanie i filtrowanie; nie przyznają ani nie ograniczają dostępu. Ustaw actor_id na podstawie zaufanego kontekstu aplikacji, a nie wartości dostarczonej przez model lub użytkownika.
Aby umożliwić innemu podmiotowi, na przykład przedstawicielowi usługowym Twojego agenta, korzystanie z magazynu, przyznaj mu dostęp za pomocą operacji przyzwolenia sklepu (session_store.grant_permission(principal_id) w AgentKit SDK).
Sesje zarządzane i pamięć zarządzana są niezależne. Usunięcie sesji lub magazynu sesji nie usuwa pamięci przechowywanej w magazynie pamięci.